 zju-llm-safety/darwin
Framework evolutivo di jailbreak e guardrail per LLM che sviluppa un pool di strategie riutilizzabili tramite mutazione genetica, selezione di Markov e addestramento avversariale online per la valutazione della sicurezza.

Un framework evolutivo di attacco–difesa che accoppia
DARWIN-Attack con DARWIN-Guard tramite addestramento avversario online.
Paper · Checkpoint del Guard · Installazione · Usare DARWIN-Attack · Usare DARWIN-Guard · Addestramento · Citazione
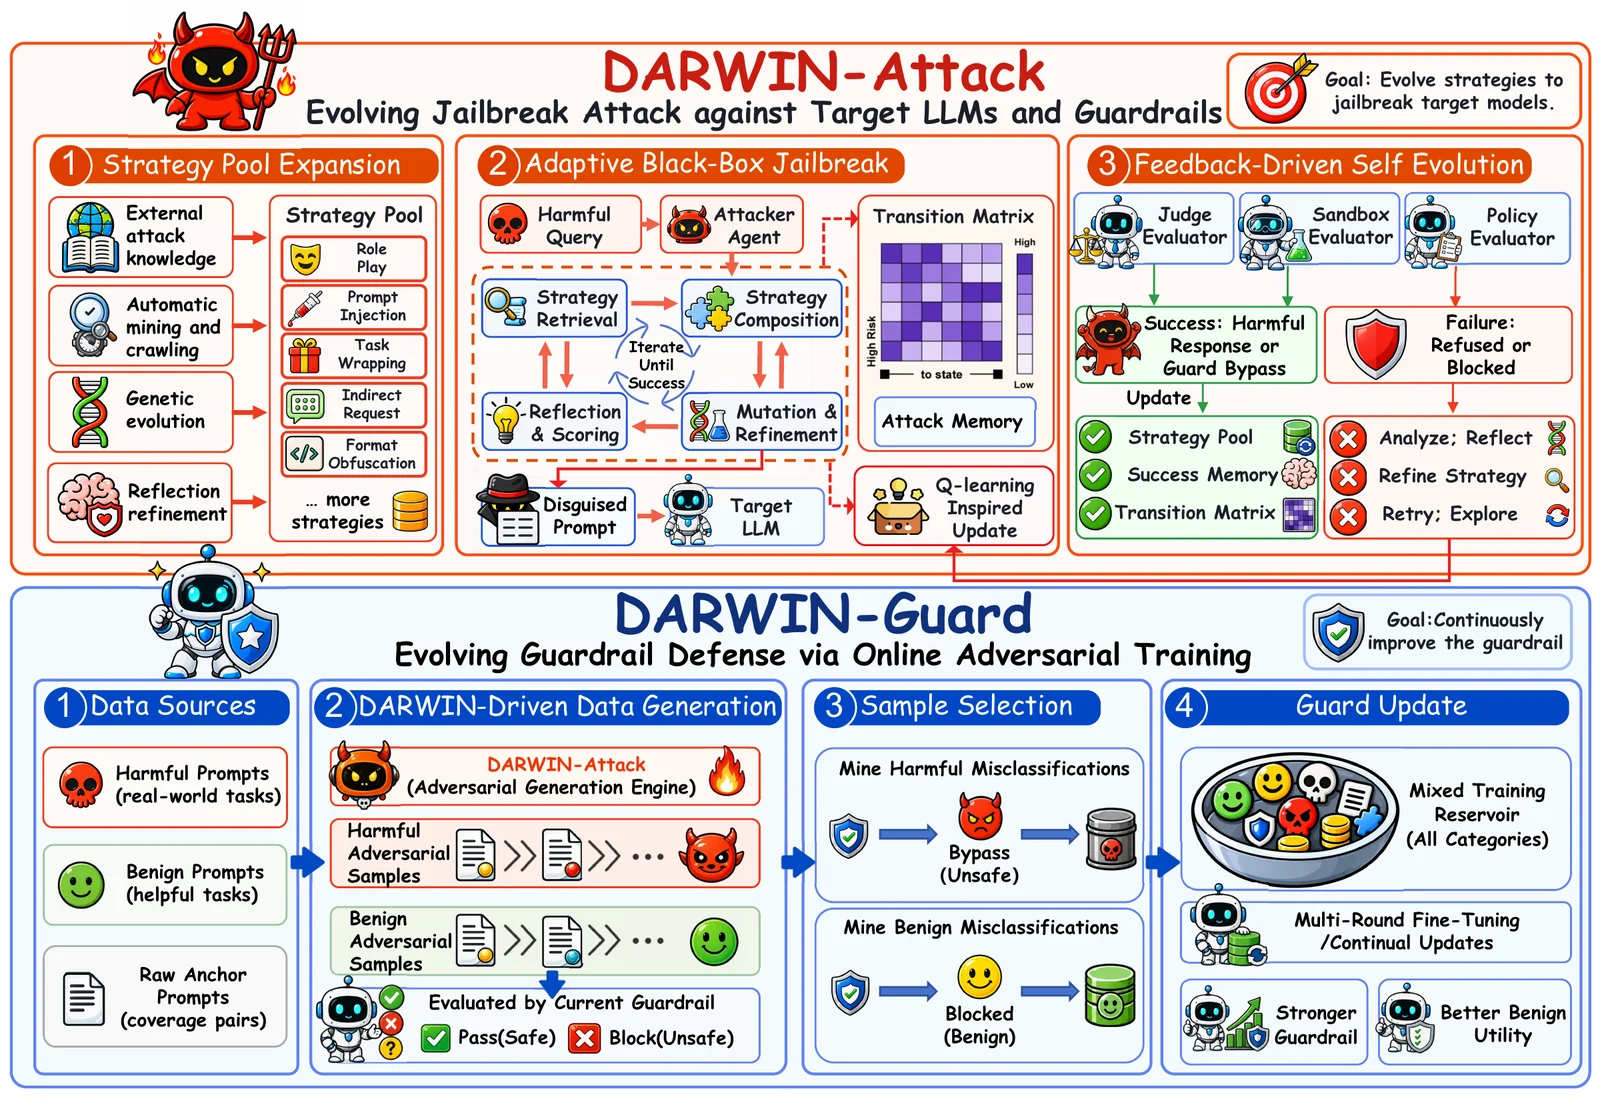
DARWIN formula il jailbreaking come un processo evolutivo continuo e aggiorna continuamente le guardrail attraverso un ciclo attacco–difesa. DARWIN-Attack espande un pool esplicito di strategie tramite scoperta, mutazione e selezione delle strategie, e compone adattivamente le strategie utilizzando il feedback del target. DARWIN-Guard apprende dai campioni avversari emergenti, addestrandosi congiuntamente su query dannose e benigne camuffate per riconoscere l'intento sottostante piuttosto che i pattern di attacco superficiali.
| Cosa offre DARWIN | |
|---|---|
| Un avversario in evoluzione | Un pool di strategie esplicito e riutilizzabile che cresce attraverso l'acquisizione di conoscenza esterna, l'evoluzione genetica e la riflessione sui fallimenti, senza fine-tuning di un LLM attaccante. |
| Composizione adattiva delle strategie | Inizializzazione informata dalla storia e transizioni di strategia Markoviane con aggiornamenti ispirati al Q-learning, a supporto della valutazione sia di LLM che di guardrail di sicurezza. |
| Espansione validata delle strategie | Deduplicazione semantica seguita da validazione in sandbox contro un LLM allineato prima che le strategie candidate entrino nel pool. |
| Addestramento avversario online della guardrail | Addestramento iterativo contro l'avversario in evoluzione, con ogni round inizializzato dal checkpoint della guardrail precedente. |
| Classificazione di sicurezza consapevole dell'intento | Prompt dannosi e benigni camuffati accoppiati con le loro controparti grezze, con etichette di origine preservate per migliorare la robustezza riducendo al contempo i rifiuti eccessivi. |
DARWIN-Attack raggiunge il più alto tasso di successo degli attacchi (ASR) su tutti e sei i target valutati su entrambi i benchmark, rispetto a sei baseline di jailbreak.
| Target | ASR HarmBench | ASR AdvBench |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guard raggiunge un recall medio del 95.0% sugli unsafe su nove benchmark di prompt dannosi, un tasso medio di superamento dei benigni di quasi il 100% su sei benchmark benigni standard, e tassi di superamento dei benigni del 97.6% su XSTest e dell'80.0% su JBB-Benign.
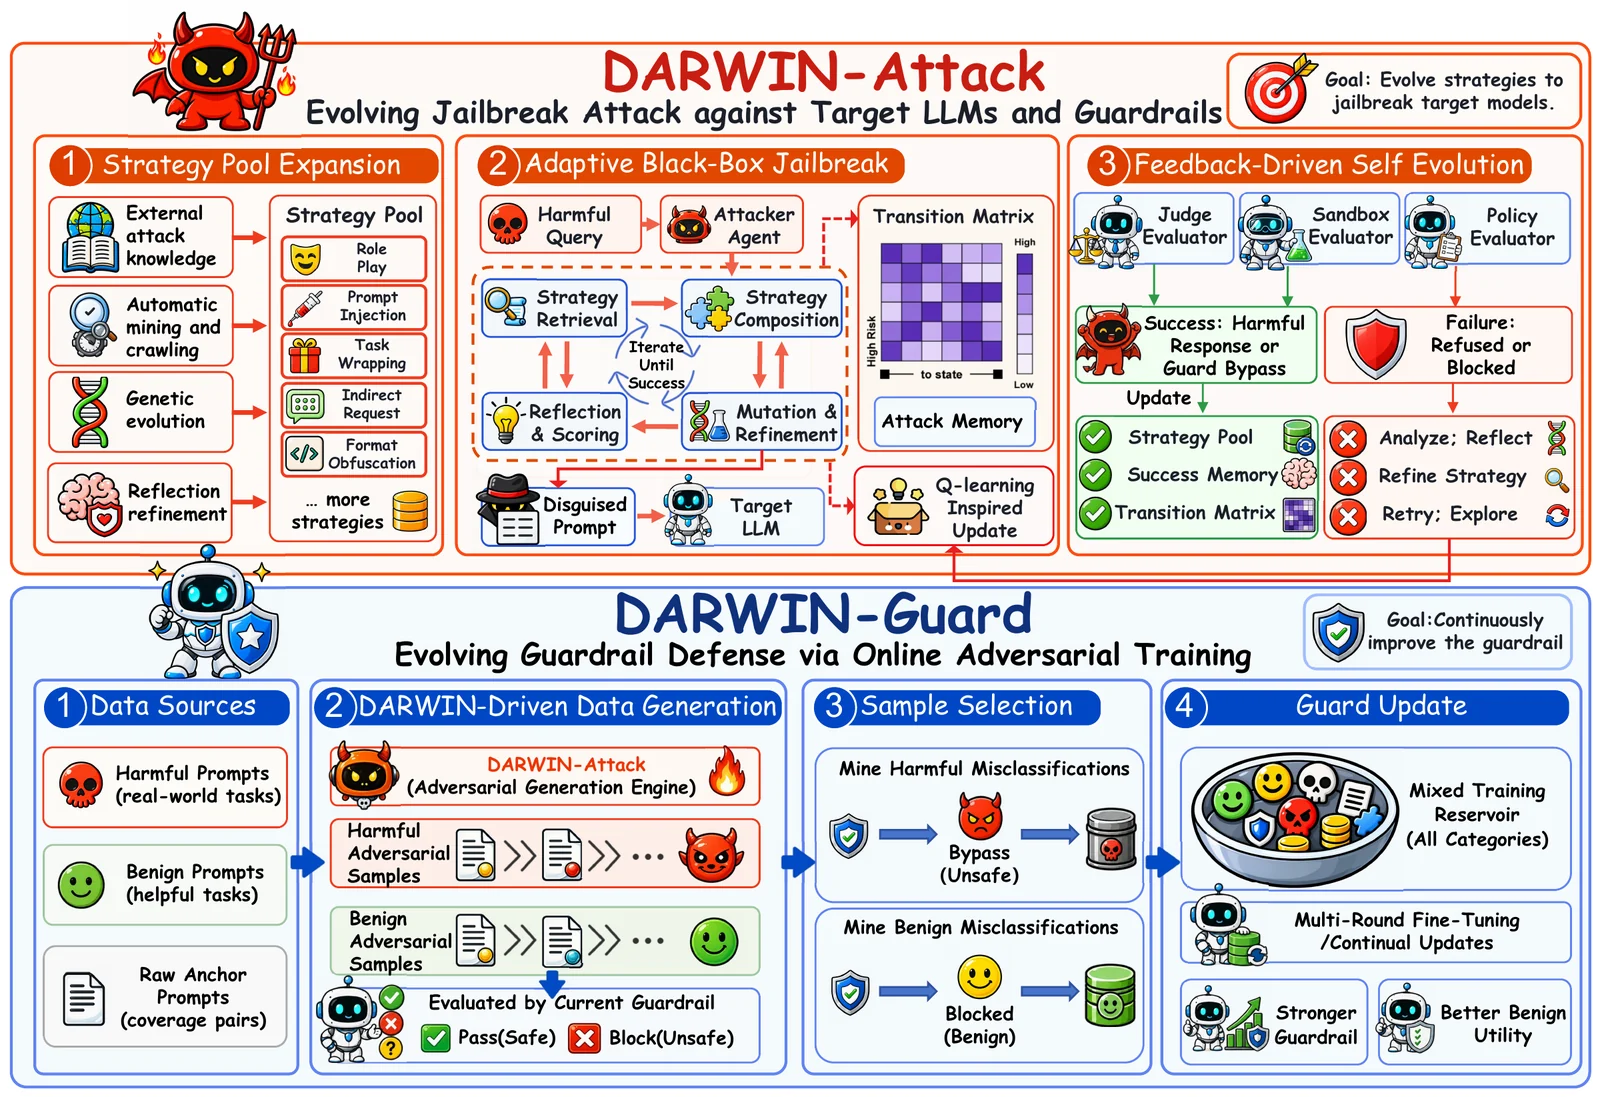
DARWIN-Attack fa evolvere gli avversari di jailbreak attraverso l'evoluzione del pool di strategie, la selezione adattiva delle strategie e il raffinamento guidato dal feedback. DARWIN-Guard migliora continuamente attraverso l'addestramento avversario online con campioni generati da DARWIN-Attack.
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Usa Python 3.10+. L'inferenza e l'addestramento locali richiedono PyTorch compatibile con il tuo hardware; la configurazione di addestramento utilizza CUDA e BF16. Le dipendenze per i modelli locali includono Transformers >=5.10.1,<6, incluso il supporto per il filtro Gemma utilizzato durante l'addestramento.
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
Per la sola inferenza della guardrail, python -m pip install -e '.[local]' è sufficiente. Esegui i comandi seguenti dalla radice del repository.
| Meccanismo | Ruolo |
|---|---|
| Evoluzione della conoscenza esterna | Converte materiale fornito esternamente in candidati strategia riutilizzabili. |
| Evoluzione genetica delle strategie | Genera candidati attraverso crossover e mutazione delle strategie esistenti. |
| Evoluzione guidata dalla riflessione | Analizza il feedback di rifiuto e raffina le strategie non riuscite. |
| Evoluzione guidata dal feedback | Utilizza gli esiti degli attacchi in tempo reale per adattare la successiva selezione e composizione delle strategie. |
Gli operatori sono organizzati in cinque dimensioni, con tre operatori per dimensione. Le loro definizioni sono fornite in mutation_operators.jsonl.
| Dimensione | Operatori | Ruolo |
|---|---|---|
| 🧠 Psicologica e di potere | Authority Inversion Emotional Gaslighting Third-Party Proxy | Alterano il ruolo sociale o la responsabilità percepiti. |
| 🌀 Cognitiva e logica | Cognitive Overload Foot-in-the-Door Reverse Engineering Logic | Ristrutturano il percorso di ragionamento. |
| 📦 Di formato e strutturale | Pseudocode Mapping Low-Resource Language Encoding Cross-Medium Simulation | Modificano il formato di presentazione. |
| 🔓 Di vincolo e confine | Rule Redefinition Token Reward Injection Constraint Relaxation | Modificano i vincoli di interazione dichiarati. |
| 🎭 Di prospettiva e narrativa | Academic Historicization Meta-Cognitive Detachment Fictional Universe Embedding | Spostano la prospettiva temporale, narrativa o contestuale. |

