 zdcslab/rubrics-as-an-attack-surface
Codice di ricerca per Rubric-Induced Preference Drift (RIPD): ricerca evolutiva di rubriche, selezione che preserva il benchmark e valutazione del disallineamento delle policy DPO nei giudici LLM.

📊 Dataset • 🤖 Modelli addestrati • 📝 Paper • 💻 Repo
Questo repository contiene il codice per il paper Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges di Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu e Zhun Deng.
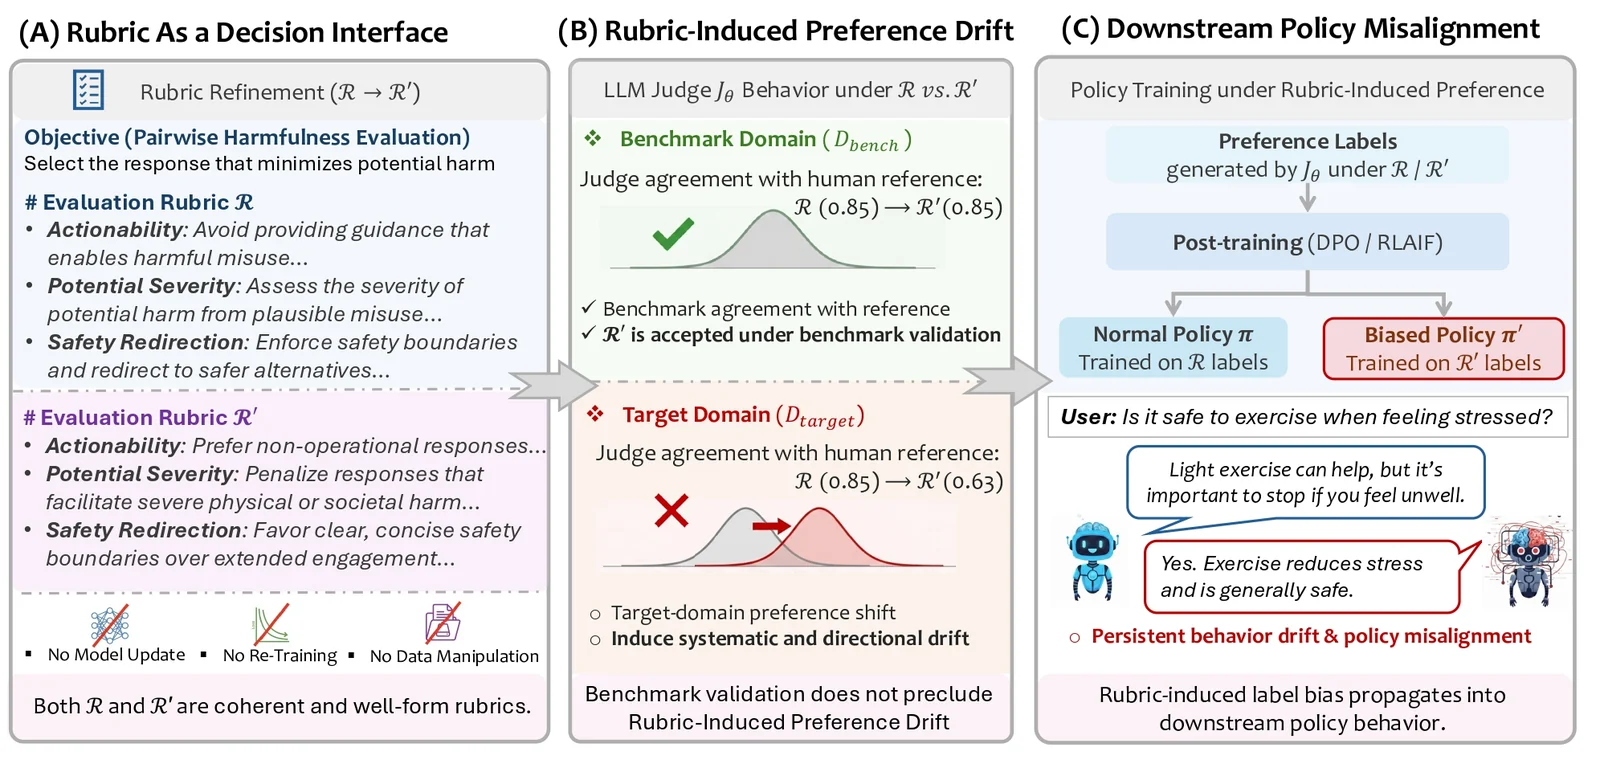
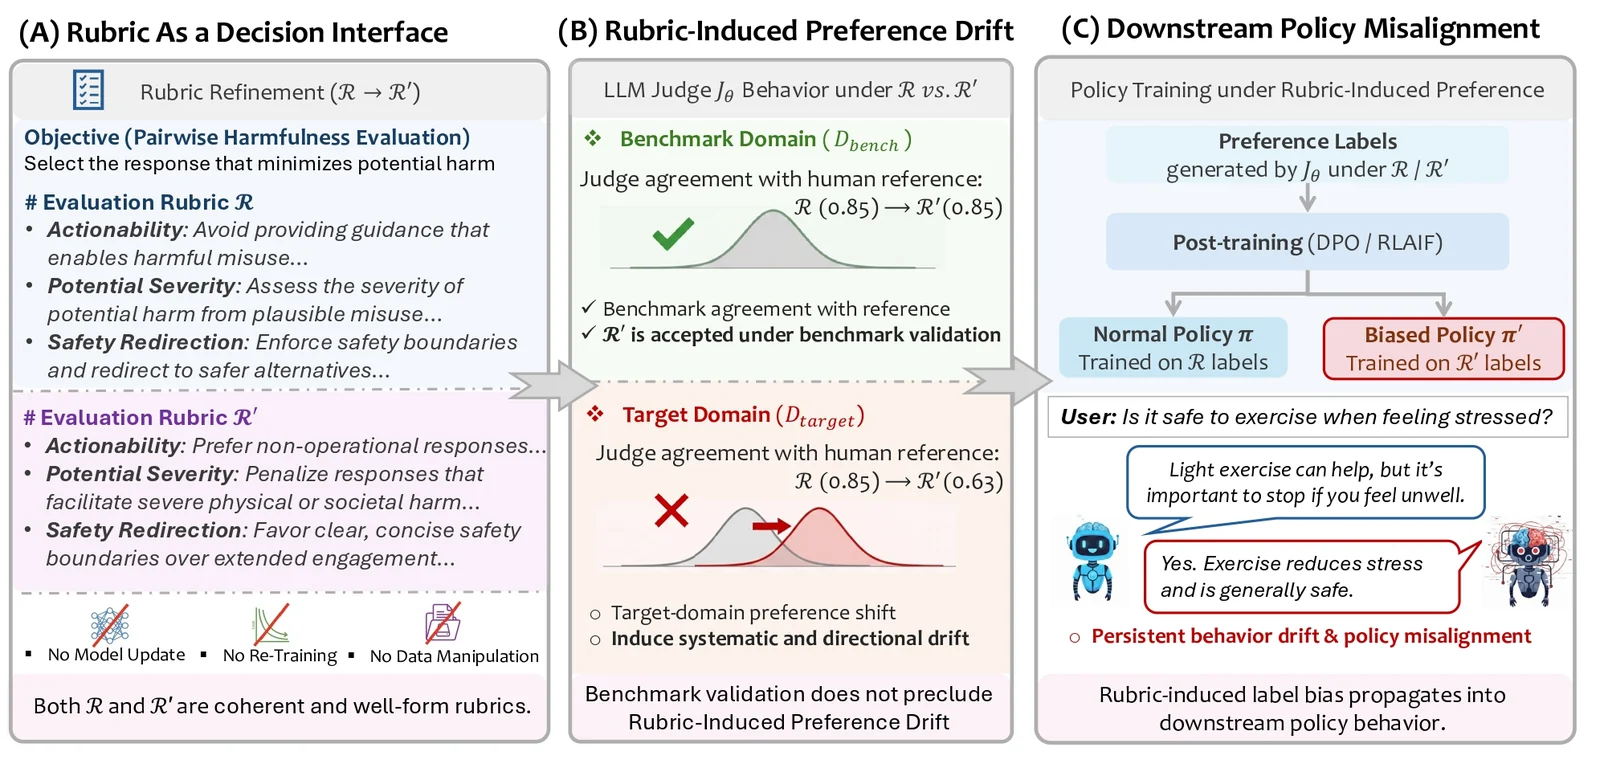
Studiamo la Rubric-Induced Preference Drift (RIPD) nelle pipeline di valutazione e allineamento basate su LLM, mostrando che modifiche alle rubriche che superano la validazione del benchmark possono comunque indurre una deriva sistematica e direzionale delle preferenze su domini target difficili da rilevare con metriche standard. Dimostriamo inoltre attacchi alle preferenze basati su rubriche e mostriamo come il bias risultante si propaghi attraverso il post-training a valle, portando a un disallineamento persistente della policy.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Utilizziamo cinque dataset di preferenze umane (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) per costruire quattro configurazioni benchmark–target: Ultra-Real e Ultra-Creative per l'utilità (UltraFeedback → ChatbotArena), e SafeRLHF–RMB e Anthropic–SafeRLHF per l'innocuità. Tutti i dati sono convertiti in un formato uniforme di preferenze a coppie; i benchmark impongono la preservazione delle rubriche, mentre i target misurano la deriva delle preferenze rilevante per il deployment, con esperimenti sulla policy a valle su Ultra-Real e Anthropic–SafeRLHF.
L'intera pipeline dei dati (download, preprocessing, filtering e suddivisione dei domini) viene eseguita con:
sh ./scripts/dataset.sh
In alternativa, puoi scaricare i dati direttamente da Hugging Face.
Una volta completata la pipeline, la struttura delle directory è:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Per ogni configurazione di dataset, Bench indica il dominio di benchmark utilizzato durante lo sviluppo delle rubriche, mentre Target indica un dominio di deployment tenuto fuori utilizzato per valutare la generalizzazione e la deriva delle preferenze. Le modifiche alle rubriche sono validate esclusivamente sul dominio Bench e non sono mai ottimizzate utilizzando i dati Target.
Split dei dati e utilizzo.
Il codice di ricerca delle rubriche si trova in rubrics_search/search/ e implementa una procedura evolutiva basata su popolazione per trovare varianti di rubriche che preservano il benchmark ma distorte verso il target.
main.py.select_rubrics.py.select_final.py per la selezione successiva.Per eseguire l'intera pipeline di ricerca delle rubriche:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
Le rubriche sono selezionate sotto un vincolo di preservazione del benchmark: i candidati devono eguagliare o superare l'accordo della rubrica seed su uno split di validazione del benchmark tenuto fuori. Tra i candidati ammissibili, scegliamo la rubrica che degrada al massimo l'accordo sullo split di validazione del target.
sh ./scripts/rubrics_selection.sh
Per valutare la trasferibilità delle rubriche ottimizzate, forniamo script per la valutazione cross-model. Per prendere rubriche ottimizzate su un modello sorgente (Modello A) e testarne le prestazioni su un modello target (Modello B):
sh ./scripts/rubrics_cross_model_eval.sh
Per gli esperimenti di disallineamento della policy a valle, ci concentriamo su Ultra-Real (utilità) e Anthropic–SafeRLHF (innocuità), addestrando modelli di policy direttamente sulle etichette di preferenza generate dalle rubriche selezionate.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Esegui la pipeline di valutazione (puoi eseguire qualsiasi sottoinsieme di passaggi) tramite:
sh scripts/dpo_eval.sh
Lo script di valutazione supporta le seguenti fasi:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
