 ut-security/cve-2023-5217-poc
Una PoC per innescare CVE-2023-5217 dall'interfaccia WebCodecs o MediaRecorder del browser.

CVE-2023-5217 è una vulnerabilità di libvpx sfruttata in the wild che è stata trovata da Clément Lecigne del Threat Analysis Group di Google mentre prendeva di mira Chrome.
Questo repository mostra come innescare CVE-2023-5217 nel browser usando le API WebCodecs e MediaRecorder. CVE-2023-5217 consente un heap buffer overflow con una lunghezza dell'overflow controllata e la sovrascrittura di un piccolo valore ripetuto di 4 byte. Al momento non è noto come CVE-2023-5217 sia stata sfruttata in the wild.
Al momento della divulgazione pubblica, c'erano due patch in libvpx e una in Chromium che hanno corretto CVE-2023-5217. Le patch di libvpx includevano la disabilitazione delle modifiche al numero di thread VP8 e un test per la codifica multithread. La patch di Chromium ha disabilitato la regolazione del numero di thread in WebCodecs.
libvpx è una libreria che gestisce la codifica e la decodifica VP8/VP9.
Il problema chiave in CVE-2023-5217 è che ridurre il numero di thread mentre si aumenta l'altezza del frame in una sessione di codifica VP8 di libvpx causa un heap overflow lineare di lunghezza controllata e la sovrascrittura controllata di un piccolo valore ripetuto di 4 byte. La differenza nell'altezza del frame controlla la lunghezza della sovrascrittura, e la nuova larghezza del frame controlla il valore a 4 byte che viene scritto ripetutamente. Questa vulnerabilità può essere sfruttata più volte per scrivere continuamente diversi piccoli valori a 4 byte riducendo l'altezza in ogni configurazione successiva.
L'encoder VP8 di libvpx mantiene un array chiamato mt_current_mb_col che memorizza la colonna corrente su cui sta lavorando un thread dell'encoder. Questo array viene allocato solo se c'è più di un thread, e la sua dimensione è una funzione di mb_rows, dove mb_rows = frame_height >> 4 e frame_height viene arrotondato per eccesso al multiplo di 16 più vicino.
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/common/alloccommon.c#L85
// The width and height are rounded up to a multiple of 16 and then assigned to `mb_rows` and `mb_cols`
int vp8_alloc_frame_buffers(VP8_COMMON *oci, int width, int height) {
    ...
    // Round up the width/height up to the nearest multiple of 16
    if ((width & 0xf) != 0) width += 16 - (width & 0xf);
    if ((height & 0xf) != 0) height += 16 - (height & 0xf);
    ...
    oci->mb_rows = height >> 4;
    oci->mb_cols = width >> 4;
    ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1232
// This snippet shows the allocation of `mt_current_mb_col`
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
  ...
  // Only allocate if we have more than 1 thread
  if (cpi->oxcf.multi_threaded > 1) {
    int i;

    vpx_free(cpi->mt_current_mb_col);
    // sizeof(*cpi->mt_current_mb_col) is 4
    CHECK_MEM_ERROR(&cpi->common.error, cpi->mt_current_mb_col,
                    vpx_malloc(sizeof(*cpi->mt_current_mb_col) * cm->mb_rows));
    for (i = 0; i < cm->mb_rows; ++i)
      vpx_atomic_init(&cpi->mt_current_mb_col[i], 0);
  }
  ...
}
Quando libvpx termina la codifica di un frame, memorizza il numero di colonne codificate più mt_sync_range in mt_current_mb_col.
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1212
// Snippet where the mt_sync_range value is set, based on the width.
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
    ...
#if CONFIG_MULTITHREAD
  if (width < 640) {
    cpi->mt_sync_range = 1;
  } else if (width <= 1280) {
    cpi->mt_sync_range = 4;
  } else if (width <= 2560) {
    cpi->mt_sync_range = 8;
  } else {
    cpi->mt_sync_range = 16;
  }
#endif
  ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/encodeframe.c#L560
// Function where the attacker chosen value is written
static void encode_mb_row(...) {
  ...
  const int nsync = cpi->mt_sync_range; // This value is set in vp8_alloc_compressor_data
  vpx_atomic_int rightmost_col = VPX_ATOMIC_INIT(cm->mb_cols + nsync);
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    current_mb_col = &cpi->mt_current_mb_col[mb_row];
  }
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    // current_mb_col is a reference to mt_current_mb_col
    vpx_atomic_store_release(current_mb_col,
                             vpx_atomic_load_acquire(&rightmost_col));
  }
  ...
}
Per far overflow di mt_current_mb_col, servono tre configurazioni di codifica:
mt_current_mb_col basandosi su configvuln.height. Questa nuova altezza deve essere minore di configinit.initial_height, altrimenti si ottiene un errore.mt_current_mb_col, lasciandolo in uno stato vulnerabile. libvpx scriverà ripetutamente il valore (configattack.width >> 4) + 1 (dove 1 è la variabile mt_sync_range e la larghezza è arrotondata per eccesso al multiplo di 16 più vicino) oltre i limiti precedentemente allocati, quando vale la seguente condizione:\text{ceil}(\text{config}_{\text{init}}.\text{height}/16) \geq \text{ceil}(\text{config}_{\text{attack}}.\text{height}/16) \gt \text{ceil}(\text{config}_{\text{vuln}}.\text{height}/16)$$
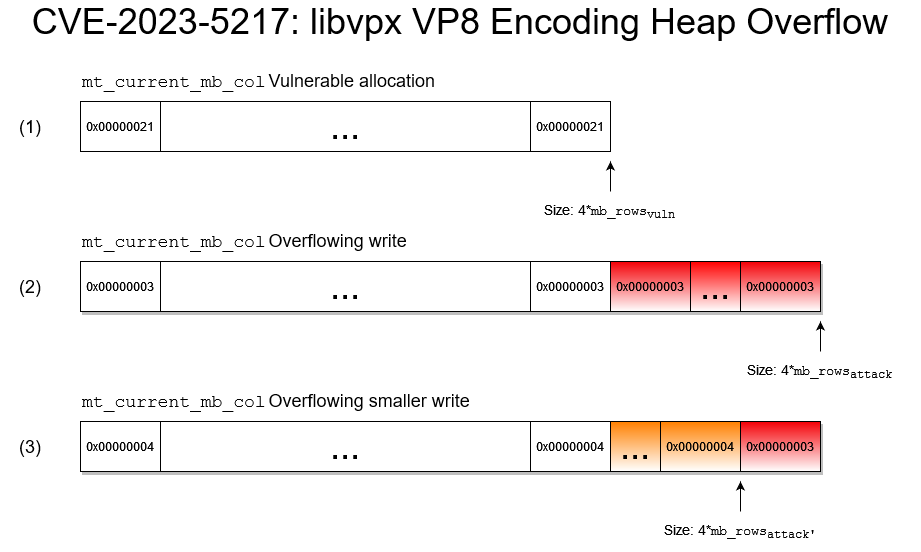
Più concretamente, supponiamo di inizializzare una configurazione di codifica VP8 con configinit con larghezza = 1200, altezza = 1200, thread = 4. L'attacco è il seguente:
