 ucsb-mlsec/vulnllm-r
LLM di ragionamento specializzato per il rilevamento di vulnerabilità nel codice sorgente in C/C++ e Python, con costruzione di dataset, training SFT/DPO e script per la riproduzione dei risultati.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
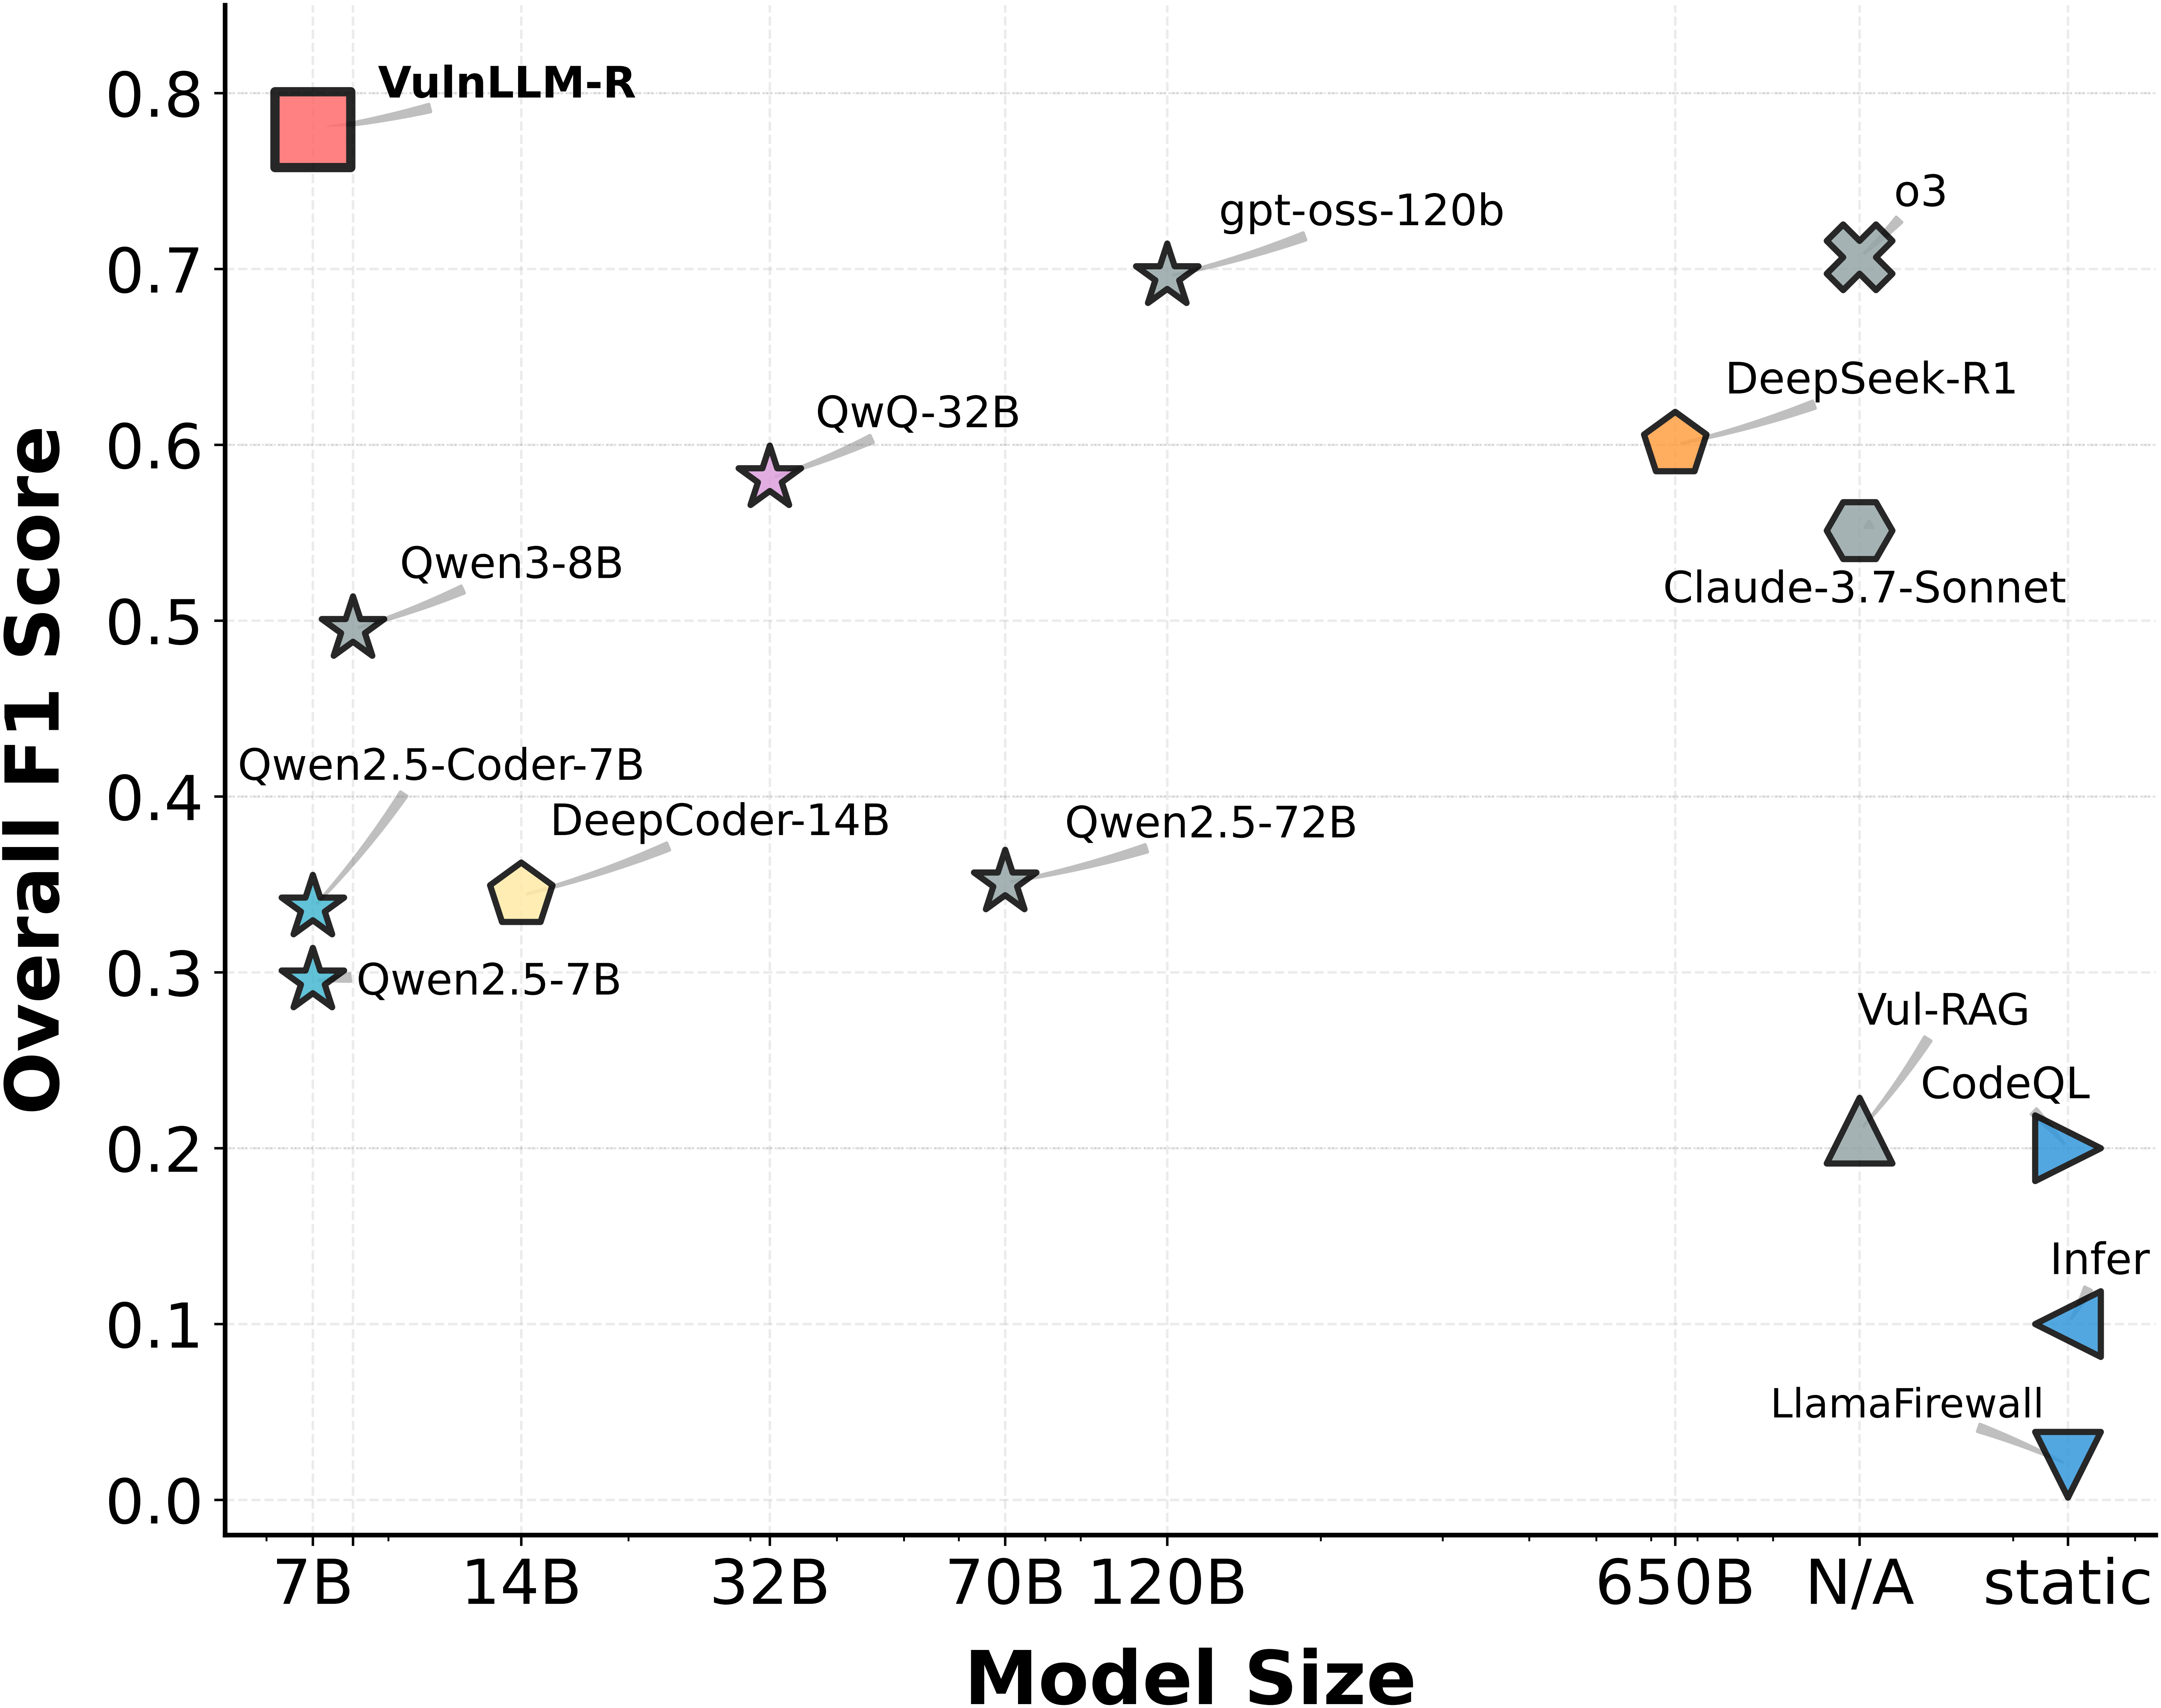
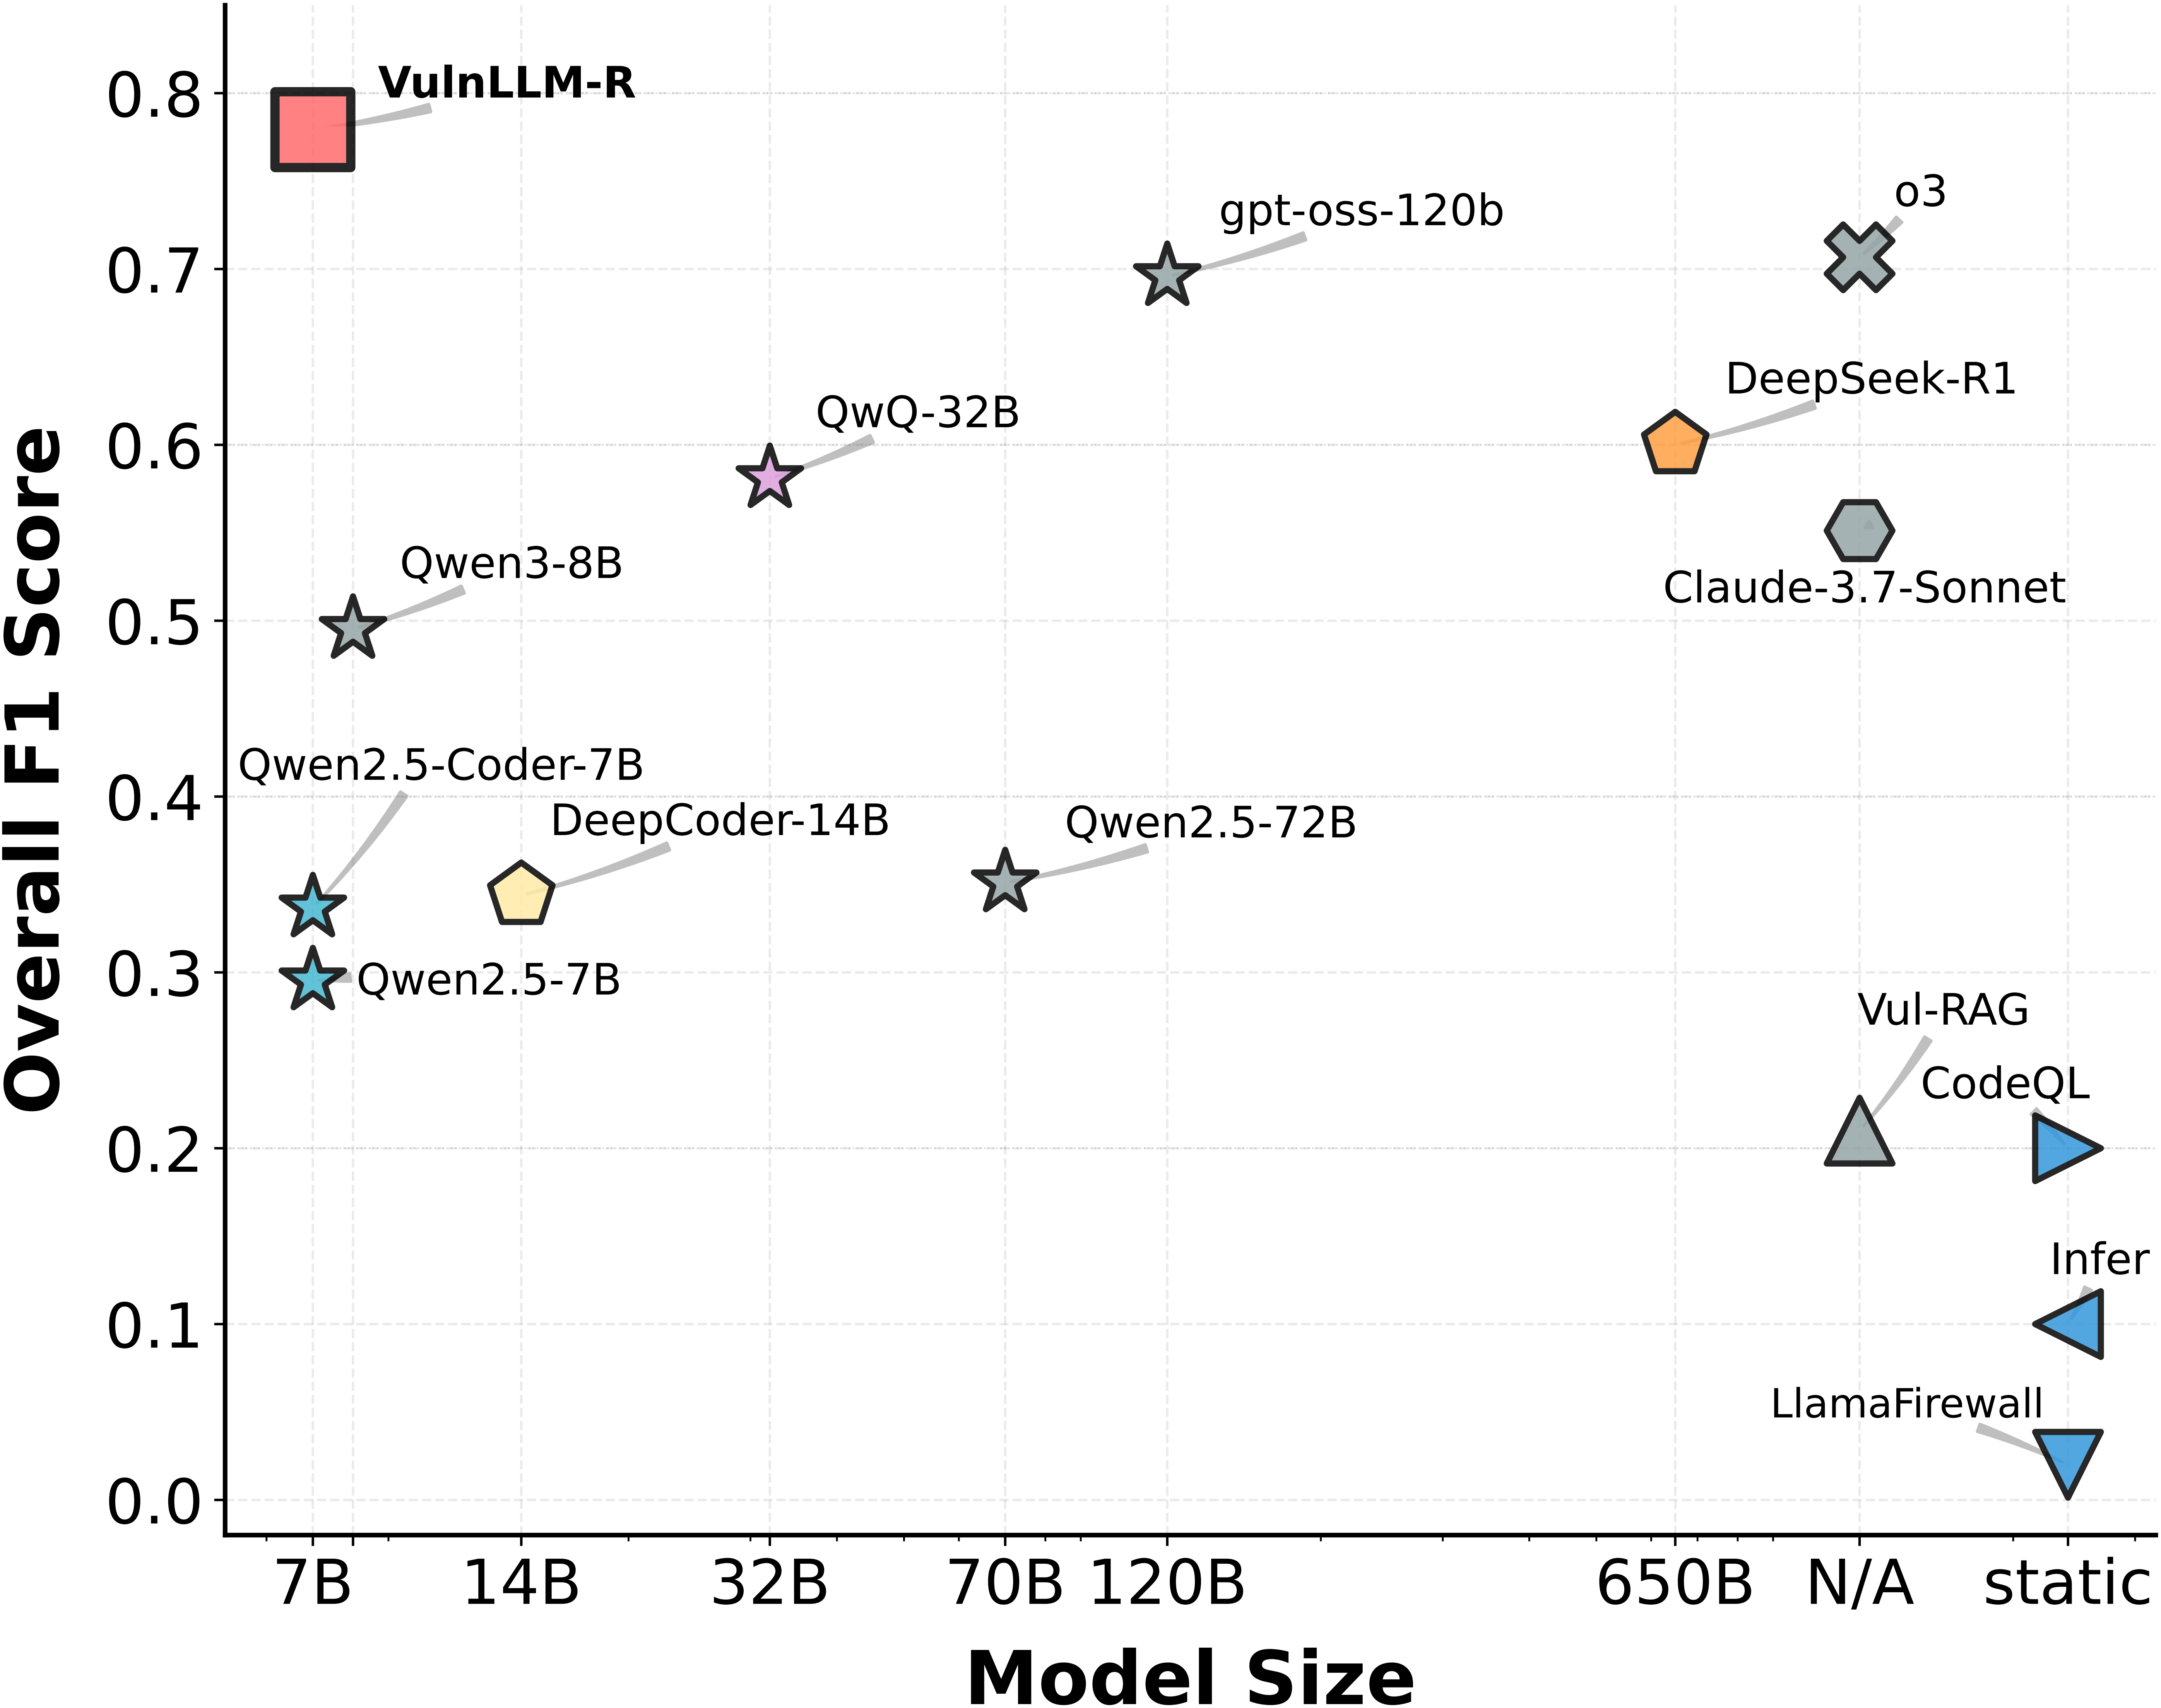
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
Forniamo anche la versione con ragionamento ridotto dei dataset distillati:
Unire i dataset esistenti di rilevamento di vulnerabilità a livello di funzione: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], e Arvo [5]. In questi dataset, PrimeVul contiene le funzioni più complesse. Creiamo due set di addestramento: pulito (senza PrimeVul) e rumoroso (con PrimeVul), così possiamo addestrare su dataset relativamente semplici e testare sul complesso dataset PrimeVul. Nota: chiamiamo "rumoroso" il set di addestramento con PrimeVul non perché il dataset sia rumoroso. È un nome relativamente arbitrario che abbiamo usato all'inizio.
vulscan/data_process/data_utils contiene una serie di script per elaborare e unire i
dataset.
raw_to_us.py: Unisce i dati grezzi nel nostro dataset e rimuove i dati ridondanticheck_cwe_correct.py: Calcola l'accuratezza per ciascuna categoria CWEgenerate_arvo_raw_data.py: Genera dati grezzi strutturati dal dataset arvoarvo_to_us.py: Riformatta i dati grezzi strutturati di arvo nel formato del nostro datasetsplit_good_bad_for_juliet.py: Estrae i dati dal dataset grezzo Juliet 1.3 e li converte nel formato richiesto,
che costituisce parte del nostro dataset pulito cadd_sven_to_clean_dataset.py: Estrae i dati dal dataset Sven, costituendo parte del nostro dataset pulito Csync_large_small.py: Sincronizza le modifiche di noisy_dataset/large_train/c
in noisy_dataset/small_train/cremove_testing_from_training.py: Aggiunge il tag human a ciascun dato, indicando che il punto è stato verificato da
un essere umano e utilizzato come dato di test
-data_utils.py: Aggiunge il campo related_cwe al dataset.datasets/clean_dataset: i dati di addestramento senza PrimeVul
datasets/clean_dataset/python contiene i dati da SVEN e SecCodePLTdatasets/clean_dataset/c contiene i dati da Juliet e SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train: Contiene i dati di addestramento da PrimeVul e SVEN con CWE selezionate (
usiamo i dati PrimeVul in questo dataset come addestramento)datasets/noisy_dataset/large_train: Contiene i dati di addestramento da PrimeVul, SVEN e SecCodePLT con
più CWE (questo dataset può essere usato in seguito per addestrare modelli più grandi)datasets/noisy_dataset/test: Un piccolo set di test da PrimeVul verificato da esseri umanidatasets/test
datasets/test/test_clean: I dati di test da SVEN, SecCodePLT e Juliet; con CWE fuori distribuzione (OOD) che non fanno
parte del set di addestramentodatasets/test/test_primevul_pair: I dati di test originali di PrimeVulvulscan/data_process/data_utils/get_cwe_stat.py per ottenere l'istogramma del dataset| Dataset | Linguaggio | Train/test | CWE | # Benigni | # Vulnerab. | lunghezza media |
|---|---|---|---|---|---|---|
| Clean (seccodeplt) | Python | Train | 20 | 1281 | 1281 | 741 |
| Clean (juliet) | C/C++ | Train | 22 | 1716 | 1653 | 3689 |
| Hard (primevul filtered) | C/C++ | Train | 26 | 2717 | 2952 | 4689 |
| Long Context (Oss-fuzz) | C/C++ | Train | 3 | 475 | 604 | 12761 |
| Simple (seccodeplt) | Python | Test | 24 (6 ood) | 74 | 74 | 814 |
| Simple (juliet) | C/C++ | Test | 38 (14 ood) | 358 | 376 | 2575 |
| Hard (PrimeVul, SecLLMHolmes) | C/C++ | Test | 13 (5 ood) | 145 | 152 | 4545 |
| Long Context (Oss-fuzz) | C/C++ | Test | 3 (0 ood) | 0 | 320 | 18929 |
| primevul test (noisy) | C/C++ | Test | 56 (34 ood) | 421 | 422 | 5341 |
