 suraj-ranganath/stealthrl
StealthRL: framework di RL per parafrasare in modo avversariale testi AI per testare la robustezza dei rilevatori.

Articolo (arXiv)
Demo
Modello (Hugging Face)
Dataset di benchmark (Hugging Face)
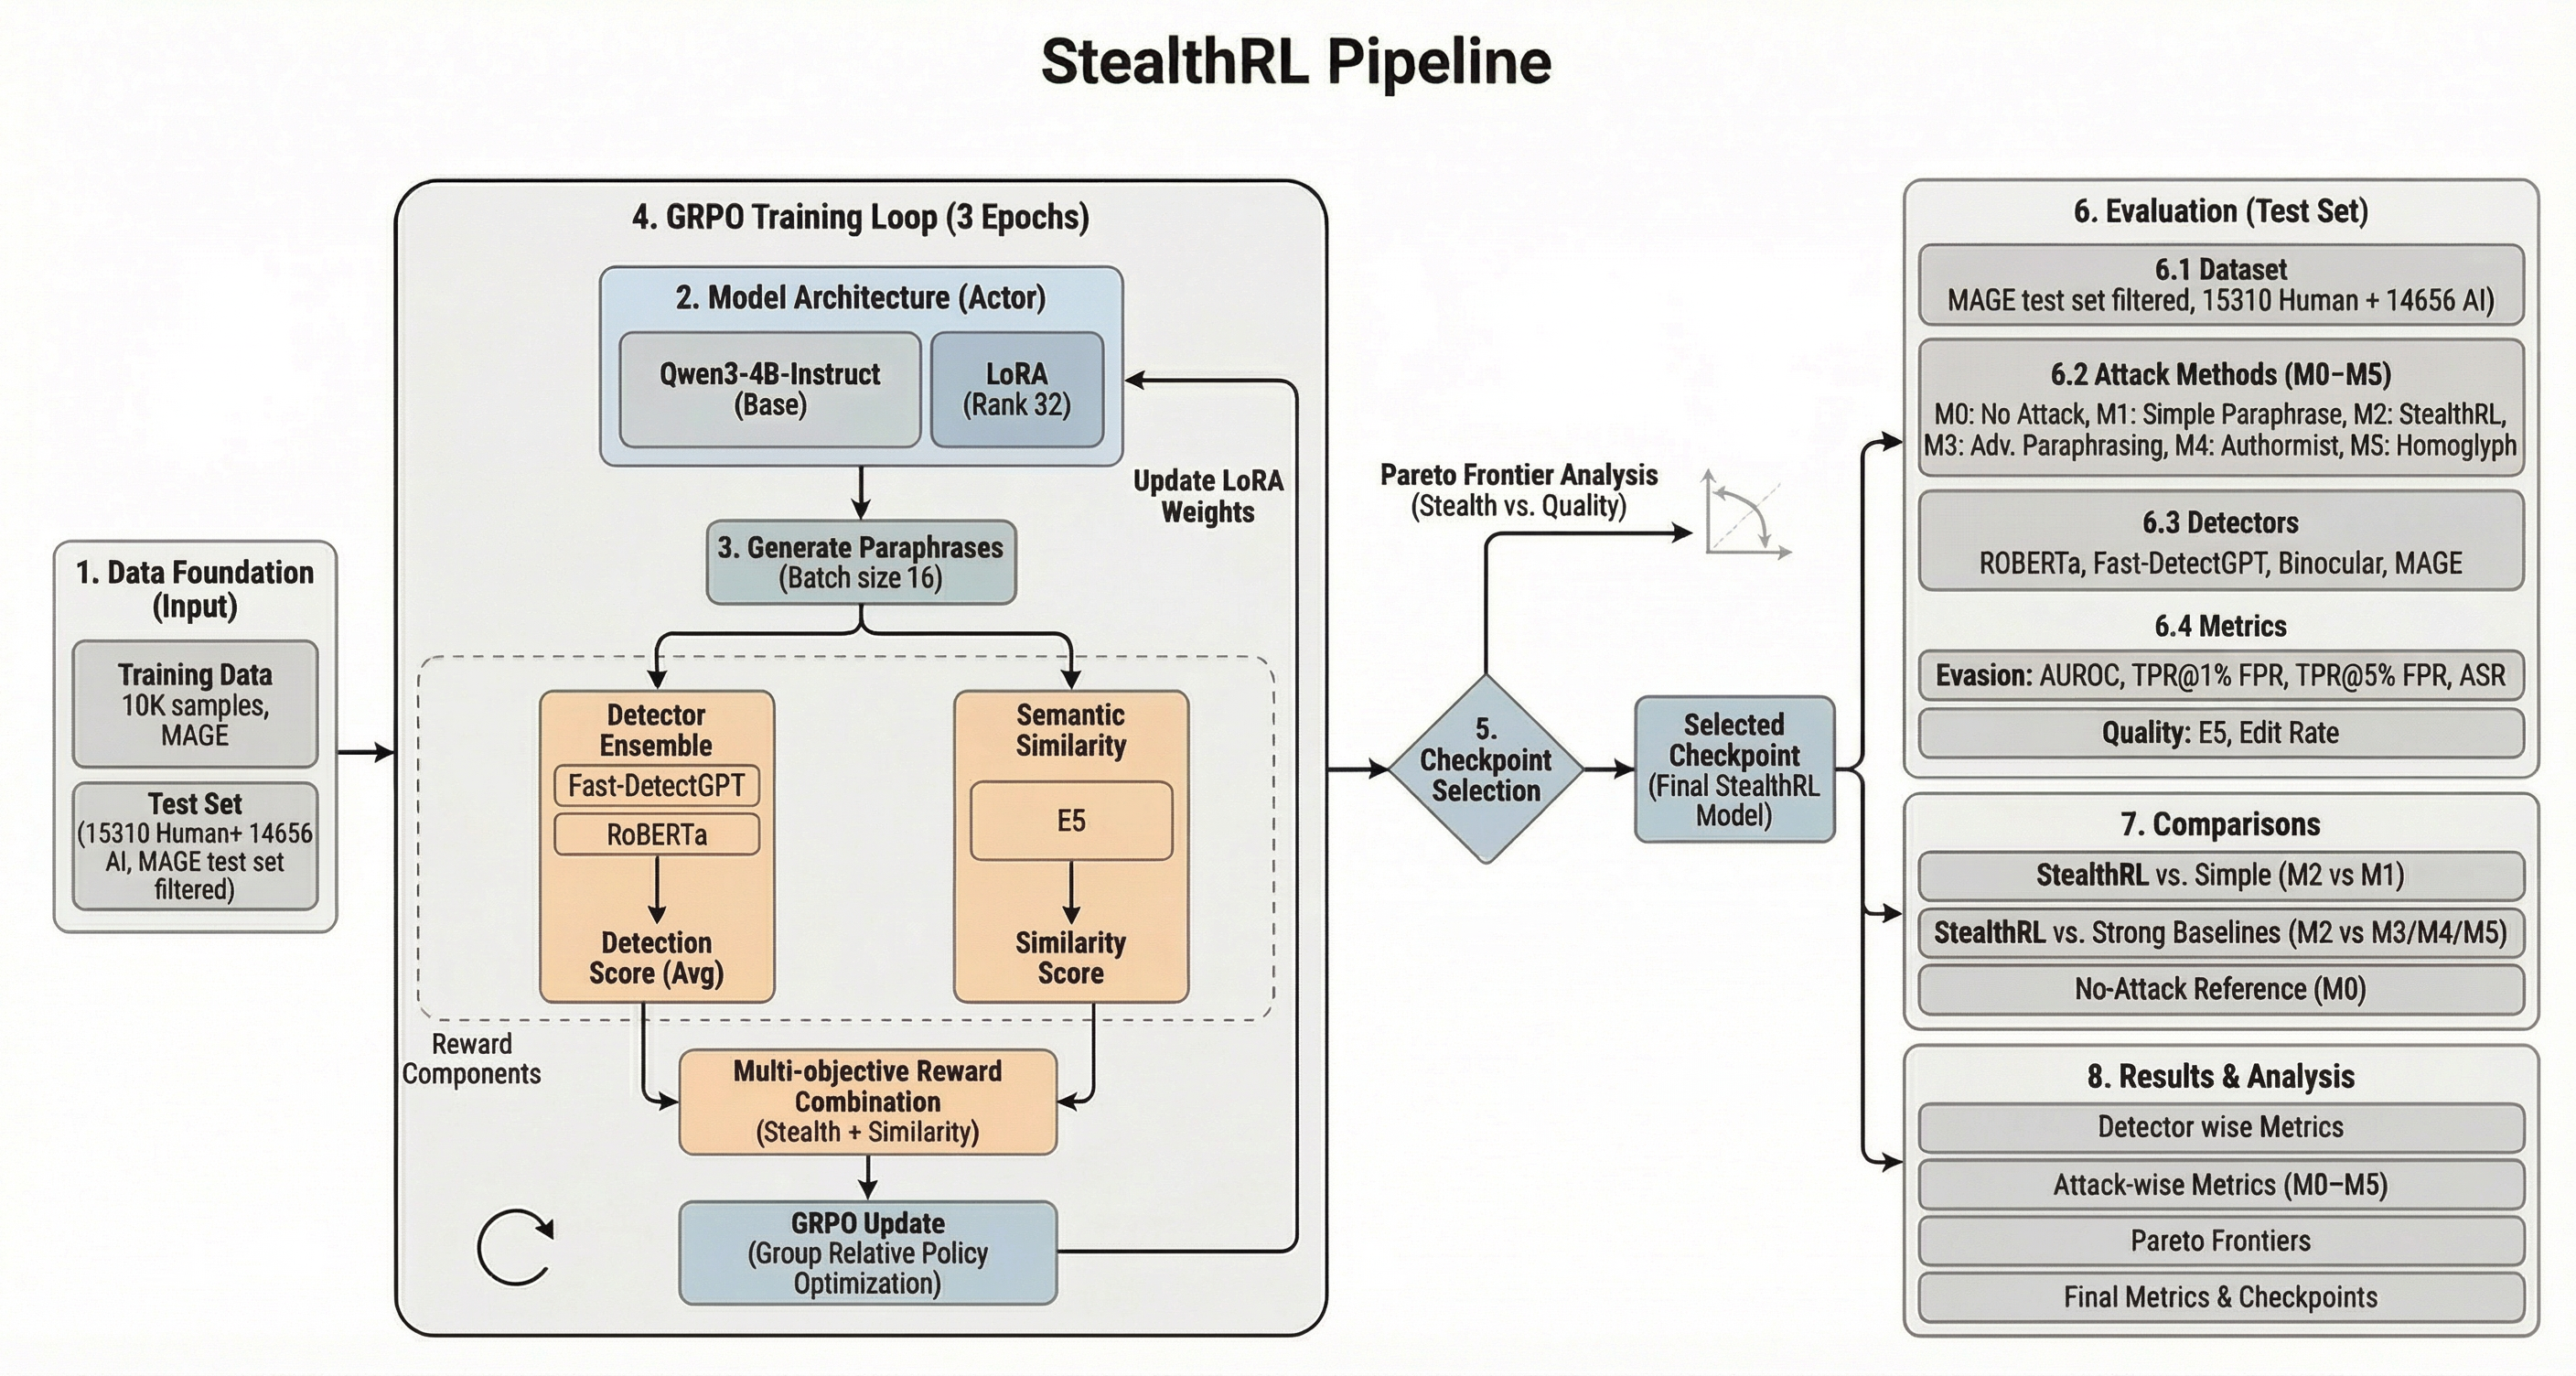
I rilevatori di testo AI sono sempre più utilizzati in contesti ad alto rischio, eppure la loro robustezza rispetto a riscritture avversarie che preservano il significato rimane incerta. Presentiamo StealthRL, un framework di apprendimento per rinforzo per stress-testare i rilevatori di testo AI con attacchi di parafrasi adattivi. StealthRL addestra una policy di parafrasi contro un ensemble di rilevatori preservando il contenuto semantico, quindi valuta il trasferimento a famiglie di rilevatori escluse dall'addestramento. Sul pool di test MAGE filtrato completo (15.310 umani / 14.656 AI), StealthRL riduce l'AUROC medio da 0,79 a 0,43 e raggiunge un TPR@1%FPR medio di 0,024 su RoBERTa, Fast-DetectGPT, Binoculars e MAGE. L'attacco si trasferisce a due rilevatori non utilizzati durante l'addestramento, esponendo vulnerabilità condivise piuttosto che il guasto di un singolo rilevatore. Analizziamo inoltre le distribuzioni dei punteggi dei rilevatori e valutiamo la qualità con E5, BERTScore e valutazioni Likert basate su LLM. I nostri risultati mostrano che gli attuali rilevatori di testo AI rimangono fragili sotto una pressione realistica di parafrasi e forniscono un protocollo riproducibile per la valutazione della robustezza avversaria.
Questo repository è la codebase di ricerca e ingegneria alla base di StealthRL. Contiene:
Il repository intende essere un utile punto di partenza per i ricercatori che vogliono:
stealthrl/: codice di addestramento, wrapper dei rilevatori, reward, utility per i dati e il pacchetto StealthBench originaleeval/: harness di valutazione di livello ricerca utilizzato per i risultati dell'articoloscripts/: punti di ingresso eseguibili per addestramento, valutazione, orchestrazione, grafici e utilityconfigs/: configurazioni YAML per addestramento, valutazione e ablazionifigures/: diagrammi della pipeline e asset staticitests/: test di integrazione e controlli di sanitàanalysis/: helper di analisi ad hoc e utility monousopython -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install -r requirements.txt
A seconda delle parti del progetto che vuoi eseguire, potresti aver bisogno anche di:
pip install tinker
pip install openai
pip install vllm
Note:
tinker è richiesto per il percorso di inferenza del checkpoint StealthRL basato su cloud utilizzato da M2.openai è richiesto solo per il passaggio di valutazione della qualità GPT/Likert.vllm è consigliato per la generazione locale veloce nei baseline dell'articolo.Variabili d'ambiente tipiche utilizzate dal repository:
export HF_HOME=$HOME/.cache/huggingface
export TRANSFORMERS_CACHE=$HF_HOME
export OPENAI_API_KEY=...
export TINKER_API_KEY=...
Per la pipeline di valutazione a fasi dell'articolo, abbiamo utilizzato un file env più un JSON descrittore del checkpoint. Gli script pubblici consentono di sovrascrivere esplicitamente entrambi i percorsi:
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_eval.py --quick
python scripts/run_stealthbench.py --config configs/stealthbench.yaml
Ora carica i file di testo configurati, esegue i rilevatori configurati, salva gli output CSV e genera i grafici di confronto. Il vecchio stub con solo TODO è stato rimosso.
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_public \
  --gpus 0 1 2 3
Il repository include un sito web demo basato su FastAPI in demo/. Fornisce un'interfaccia statica curata ed espone POST /api/paraphrase con supporto per chiavi API e una quota pubblica di 20 richieste al giorno per gli utenti non autenticati.
pip install -r demo/requirements.txt
uvicorn demo.stealthrl_demo.app:app --reload --port 8080
Di default la demo funziona in modalità mock a costo zero per testare l'interfaccia. Per usare il vero sampler di StealthRL, imposta STEALTHRL_DEMO_INFERENCE_BACKEND=tinker, STEALTHRL_DEMO_CHECKPOINT_JSON e TINKER_API_KEY. Consulta demo/README.md per le note su chiavi API, quota, Docker e deployment su AWS.
L'articolo riporta i risultati sull'intero pool di valutazione MAGE filtrato:
La pipeline di valutazione di livello ricerca è implementata nel modulo eval/ e negli script a fasi in scripts/.
Prepara le credenziali e i metadati del checkpoint.
Crea un file env contenente OPENAI_API_KEY e TINKER_API_KEY, e un JSON del checkpoint che descrive il percorso del sampler Tinker di StealthRL.
Esegui il preflight.
python scripts/preflight_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json
python scripts/run_full_mage_research_eval.py \
  --env-file ~/.config/stealthrl/eval.env \
  --checkpoint-json ~/.config/stealthrl/m2_checkpoint.json \
  --run-root outputs/eval_runs/full_mage_repro \
  --gpus 0 1 2 3
Ispeziona gli output dei metodi generati, i punteggi dei rilevatori, le metriche e i grafici nella directory di esecuzione scelta.
Se devi solo rieseguire la valutazione della qualità basata su GPT sugli output in cache:
python scripts/run_gpt_quality_only.py \
  --run-root outputs/eval_runs/full_mage_repro \
  --env-file ~/.config/stealthrl/eval.env
python scripts/compute_bertscore_for_run.py \
  --run-dir outputs/eval_runs/full_mage_repro/assembled \
  --device cuda:0 \
  --batch-size 16 \
  --chunk-size 512
Lo script BERTScore aggiorna quality.parquet e quality.csv in place dopo ogni chunk, quindi le esecuzioni interrotte possono essere riprese senza ricalcolare le righe già completate. Usa --limit-per-method per un piccolo smoke test e --force solo quando intendi ricalcolare deliberatamente le colonne BERTScore esistenti.
