
 s0md3v/photon
Crawler incredibilmente veloce progettato per OSINT.


Photon Wiki • Come Usarlo • Compatibilità • Photon Library • Contributi • Roadmap
Photon può estrarre i seguenti dati durante il crawling:
example.com/gallery.php?id=2)Le informazioni estratte vengono salvate in modo organizzato o possono essere esportate come json.

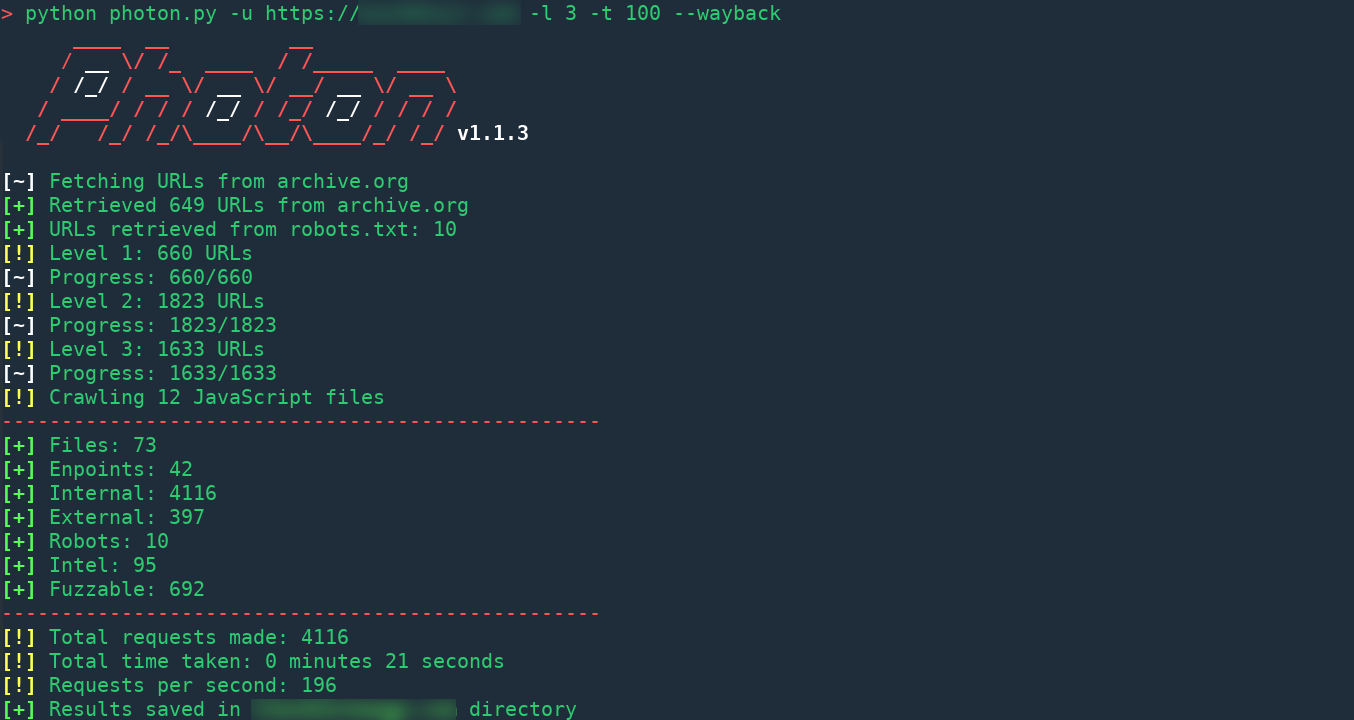
Controlla timeout, ritardo, aggiungi seed, escludi URL che corrispondono a un pattern regex e altre cose interessanti. L'ampia gamma di opzioni fornita da Photon ti consente di fare crawling del web esattamente come vuoi.
La gestione intelligente dei thread e la logica raffinata di Photon ti offrono prestazioni di prim'ordine.
Tuttavia, il crawling può richiedere molte risorse, ma Photon ha qualche asso nella manica. Puoi recuperare gli URL archiviati da archive.org da usare come seed utilizzando l'opzione --wayback.
Photon può essere avviato utilizzando un'immagine Docker leggera Python-Alpine (103 MB).
$ git clone https://github.com/s0md3v/Photon.git
$ cd Photon
$ docker build -t photon .
$ docker run -it --name photon photon:latest -u google.com
Per visualizzare i risultati, puoi recarti nel volume Docker locale, che puoi trovare eseguendo docker inspect photon, oppure montando la cartella loot del target:
$ docker run -it --name photon -v "$PWD:/Photon/google.com" photon:latest -u google.com
Photon è in fase di sviluppo intenso e vengono rilasciati regolarmente aggiornamenti per la correzione di bug, l'ottimizzazione delle prestazioni e nuove funzionalità.
Se vuoi vedere le funzionalità e i problemi su cui si sta lavorando, puoi farlo nella bacheca del progetto Development.
Gli aggiornamenti possono essere installati e verificati con l'opzione --update. Photon ha capacità di aggiornamento senza interruzioni, il che significa che puoi aggiornare Photon senza perdere alcun dato salvato.
Usa Control + Shift + m per attivare/disattivare lo spostamento del focus con il tasto Tab. In alternativa, usa esc e poi tab per passare all'elemento interattivo successivo sulla pagina.
Allega file trascinandoli e rilasciandoli, selezionandoli o incollandoli.
(https://www.thordata.com/?ls=github&lk=Photon)

Photon Wiki • Come Usarlo • Compatibilità • Photon Library • Contributi • Roadmap
Photon può estrarre i seguenti dati durante il crawling:
example.com/gallery.php?id=2)Le informazioni estratte vengono salvate in modo organizzato o possono essere esportate come json.
Controlla timeout, ritardo, aggiungi seed, escludi URL che corrispondono a un pattern regex e altre cose interessanti. L'ampia gamma di opzioni fornita da Photon ti consente di fare crawling del web esattamente come vuoi.
La gestione intelligente dei thread e la logica raffinata di Photon ti offrono prestazioni di prim'ordine.
Tuttavia, il crawling può richiedere molte risorse, ma Photon ha qualche asso nella manica. Puoi recuperare gli URL archiviati da archive.org da usare come seed utilizzando l'opzione --wayback.
Photon può essere avviato utilizzando un'immagine Docker leggera Python-Alpine (103 MB).
$ git clone https://github.com/s0md3v/Photon.git
$ cd Photon
$ docker build -t photon .
$ docker run -it --name photon photon:latest -u google.com
Per visualizzare i risultati, puoi recarti nel volume Docker locale, che puoi trovare eseguendo docker inspect photon, oppure montando la cartella loot del target:
$ docker run -it --name photon -v "$PWD:/Photon/google.com" photon:latest -u google.com
Photon è in fase di sviluppo intenso e vengono rilasciati regolarmente aggiornamenti per la correzione di bug, l'ottimizzazione delle prestazioni e nuove funzionalità.
Se vuoi vedere le funzionalità e i problemi su cui si sta lavorando, puoi farlo nella bacheca del progetto Development.
