 rodricios/wxpath
wxpath - web crawling dichiarativo con XPath; un linguaggio di query Web (WQL)


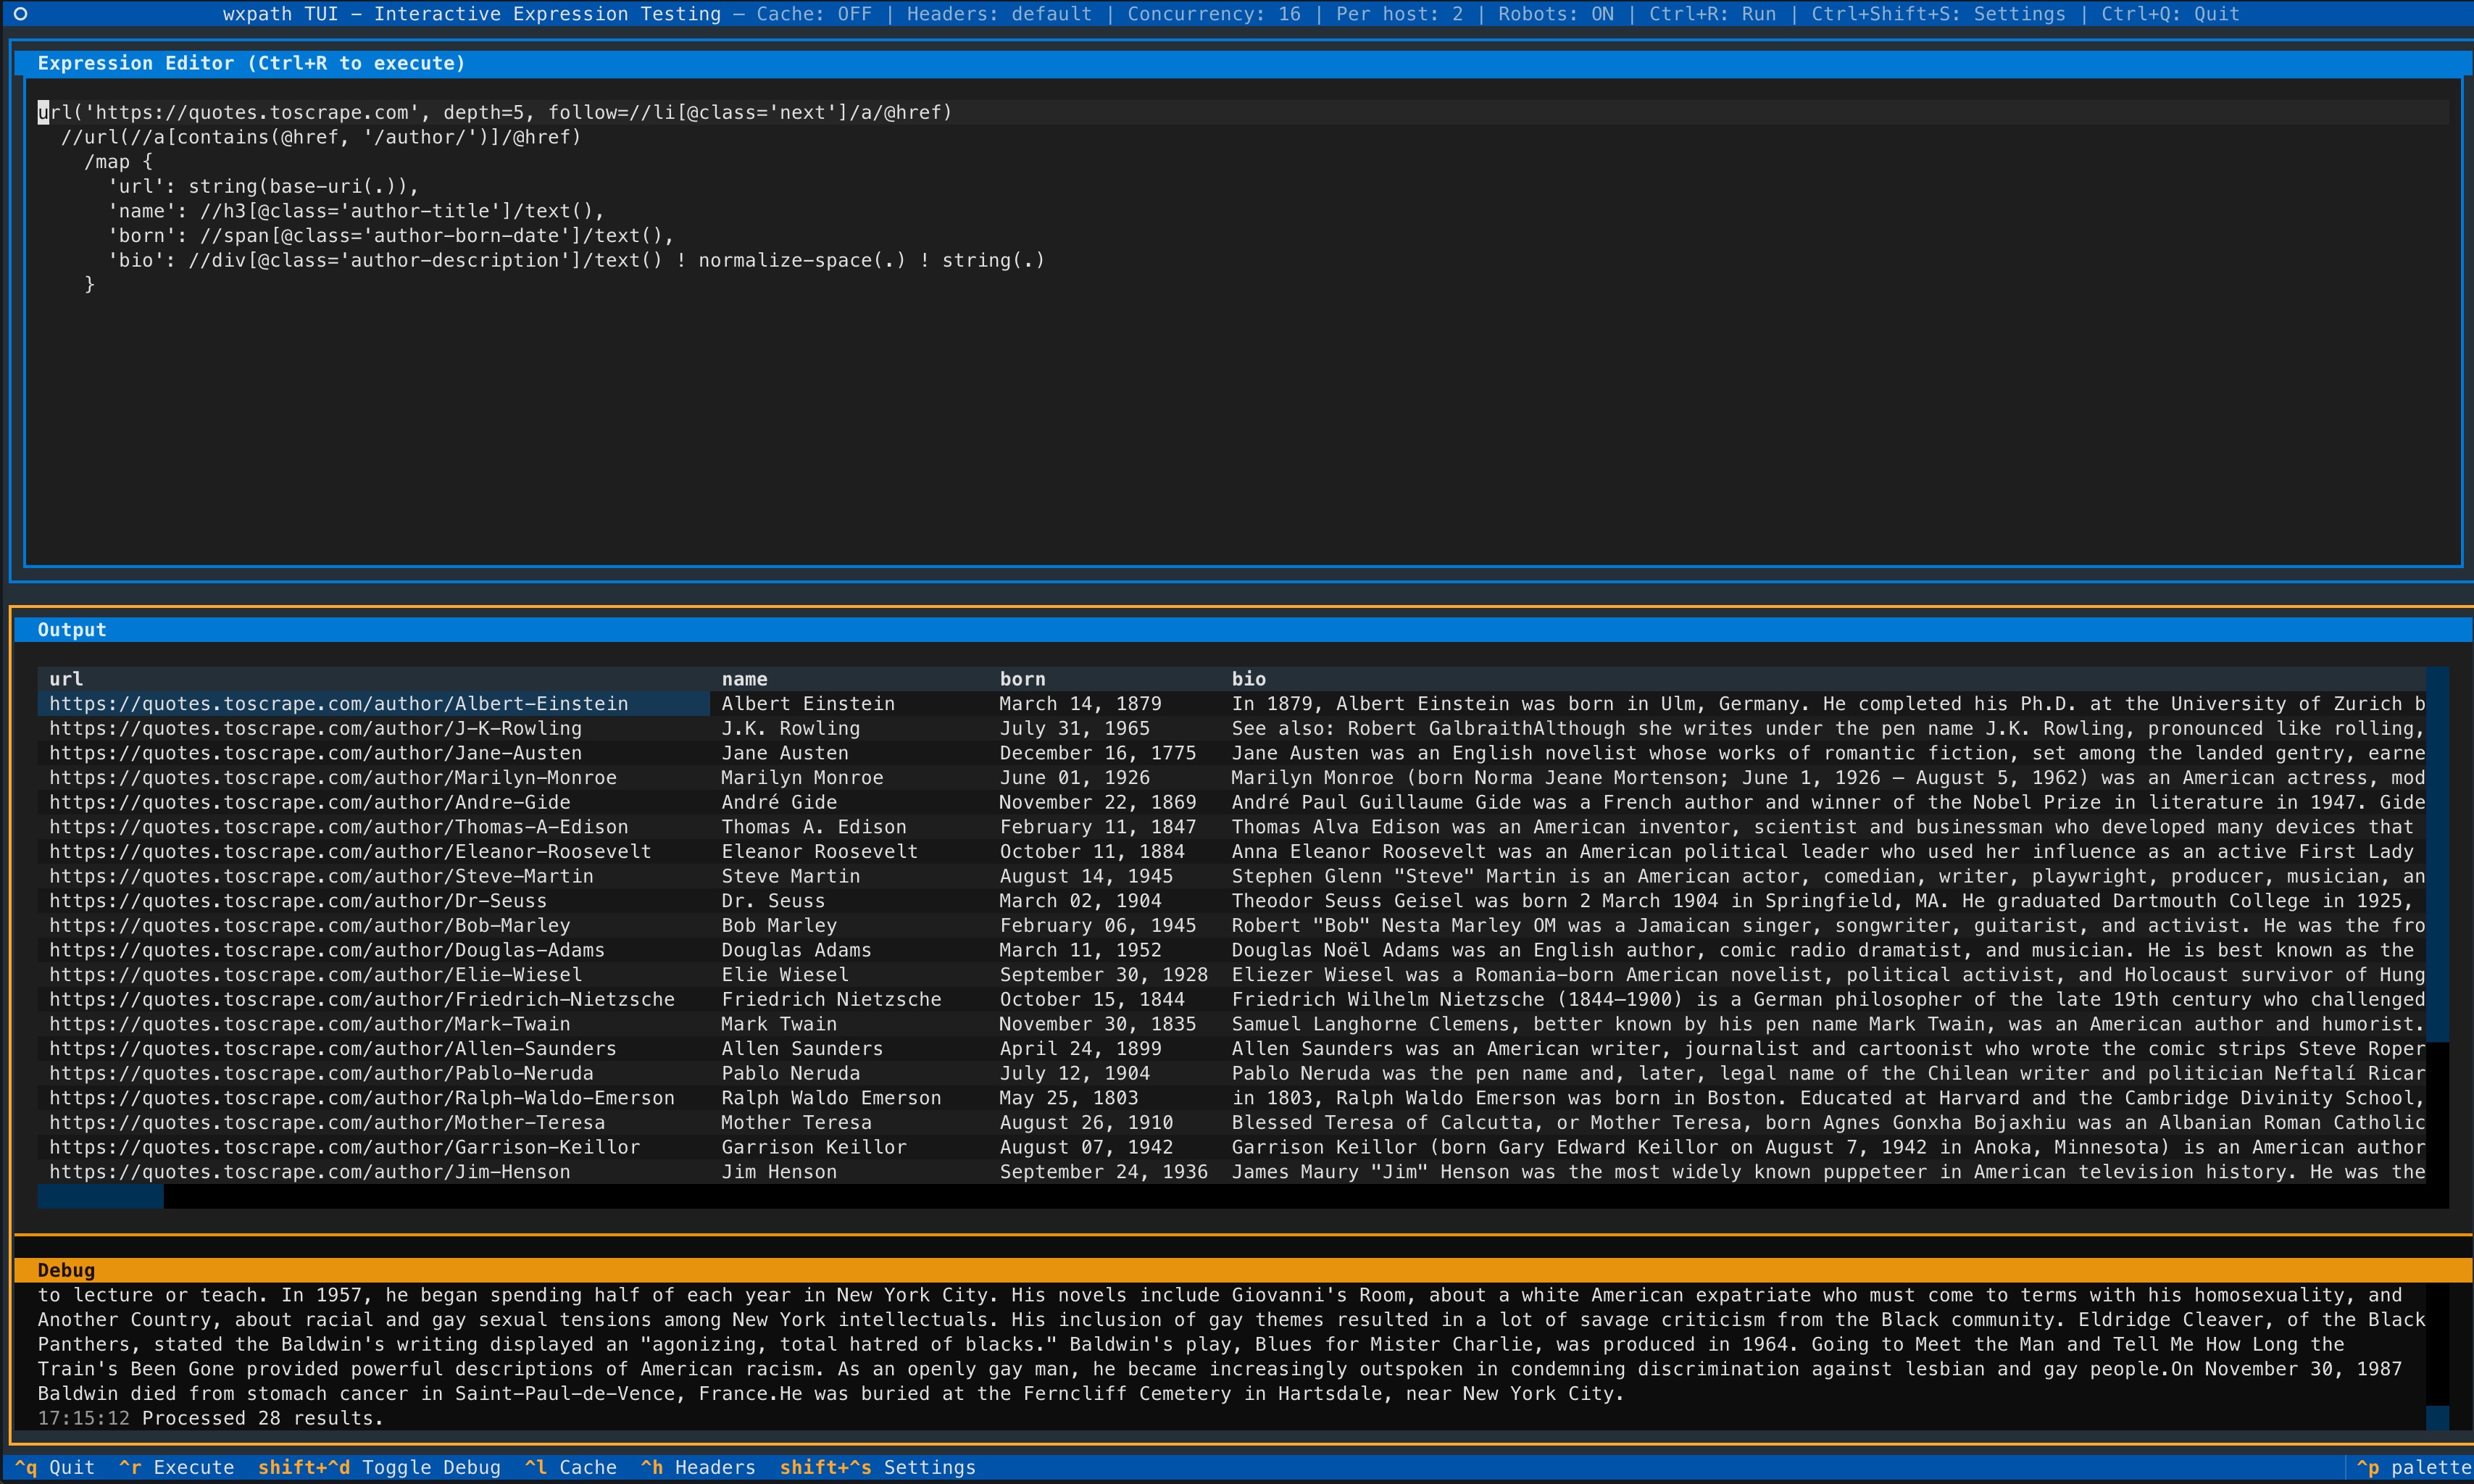
NOVITÀ: TUI - Interfaccia terminale interattiva (basata su Textual) per testare espressioni wxpath ed esportare dati.
Richiede Python 3.10+.
pip install wxpath
# Per supporto TUI:
pip install "wxpath[tui]"
# Avvia immediatamente la TUI tramite uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpath è un crawler web dichiarativo in cui la navigazione è espressa direttamente in XPath. Invece di scrivere cicli di crawling imperativi, wxpath ti permette di descrivere cosa seguire e cosa estrarre in una singola espressione. wxpath esegue quell'espressione contemporaneamente, in modo simile alla breadth-first, e trasmette i risultati man mano che vengono scoperti.
Questa espressione recupera una pagina, estrae i link e li trasmette contemporaneamente - nessun ciclo di crawling necessario:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
Introducendo l'operatore url(...) e la sintassi ///, il motore di wxpath è in grado di eseguire crawling ed estrazione ricorsivi (o paginati):
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
La maggior parte degli scraper web ti obbliga a scrivere prima il flusso di controllo del crawling e solo dopo l'estrazione.
wxpath unisce questi due passaggi in uno:
Estrai gerarchie JSON strutturate e pulite direttamente dal grafo - alimenta i tuoi LLM con segnale, non rumore. Consulta Integrazione LangChain per maggiori dettagli.
wxpath è deterministico (leggi: non basato su LLM). Non possiamo garantire che la rete sia stabile, ma possiamo garantire che la navigazione lo sia.
La documentazione è ora disponibile qui.
url(...) e ///url(...) spiegatiimport wxpath
from wxpath.settings import CRAWLER_SETTINGS
# Intestazioni personalizzate per correttezza; necessarie per alcuni siti (es. Wikipedia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contatto: [email protected])'}
# Crawl, estrai campi, costruisci un grafo di conoscenza
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Nota: Alcuni siti (inclusa Wikipedia) potrebbero bloccare richieste senza intestazioni appropriate.
Vedi Avanzato: Configurazione del motore e del crawler per impostare un User-Agent personalizzato.
L'espressione sopra fa quanto segue:
https://en.wikipedia.org/wiki/Expression_language.<main> che iniziano con /wiki/ e non contengono due punti (:).url(...) e ///url(...) spiegatiurl(...) è un operatore personalizzato che recupera il contenuto dell'URL specificato dall'utente o generato internamente e lo restituisce come lxml.html.HtmlElement per ulteriori elaborazioni XPath.///url(...) indica un crawl approfondito. Dice al motore runtime di continuare a seguire i link fino alla max_depth specificata. A differenza dei salti ripetuti con url(), permette a una singola espressione di descrivere un'esplorazione più profonda del grafo. ATTENZIONE: Usare con cautela e con vincoli (tramite max_depth o predicati XPath) per evitare un'esplosione della navigazione.Vedi DESIGN.md per i dettagli della progettazione del linguaggio. Vedrai i concetti fondamentali e progetterai il linguaggio da zero.
wxpath valuta un'espressione come una lista di passaggi di navigazione ed estrazione (internamente chiamati Segment).
url(...) crea attività di crawl sia staticamente (tramite un URL fisso) che dinamicamente (tramite un URL derivato dall'espressione XPath). Gli URL vengono deduplicati globalmente, su base best-effort - non per profondità.
I segmenti XPath operano sui documenti recuperati (recuperati tramite le operazioni url(...) immediatamente precedenti).
///url(...) indica il crawl approfondito: procede in modo simile alla breadth-first fino a max_depth.
I risultati vengono restituiti non appena sono pronti.
wxpath è basato su asyncio/aiohttp, fornendo un'API asincrona per il crawling e l'estrazione dei dati.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath fornisce anche un'API asyncio-in-sync, permettendoti di eseguire il crawling di più pagine contemporaneamente mantenendo la semplicità del codice sincrono. Questo è particolarmente utile per crawl in ambienti di esecuzione strettamente sincroni (cioè non all'interno di un ciclo di eventi asyncio) dove le prestazioni sono importanti.
from wxpath import wxpath_async_blocking_iter
