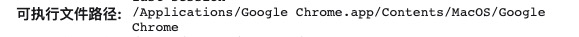
 qianlitp/crawlergo
Un potente crawler browser per scanner di vulnerabilità web


Un potente crawler per browser per scanner di vulnerabilità web
Documento in inglese | 中文文档
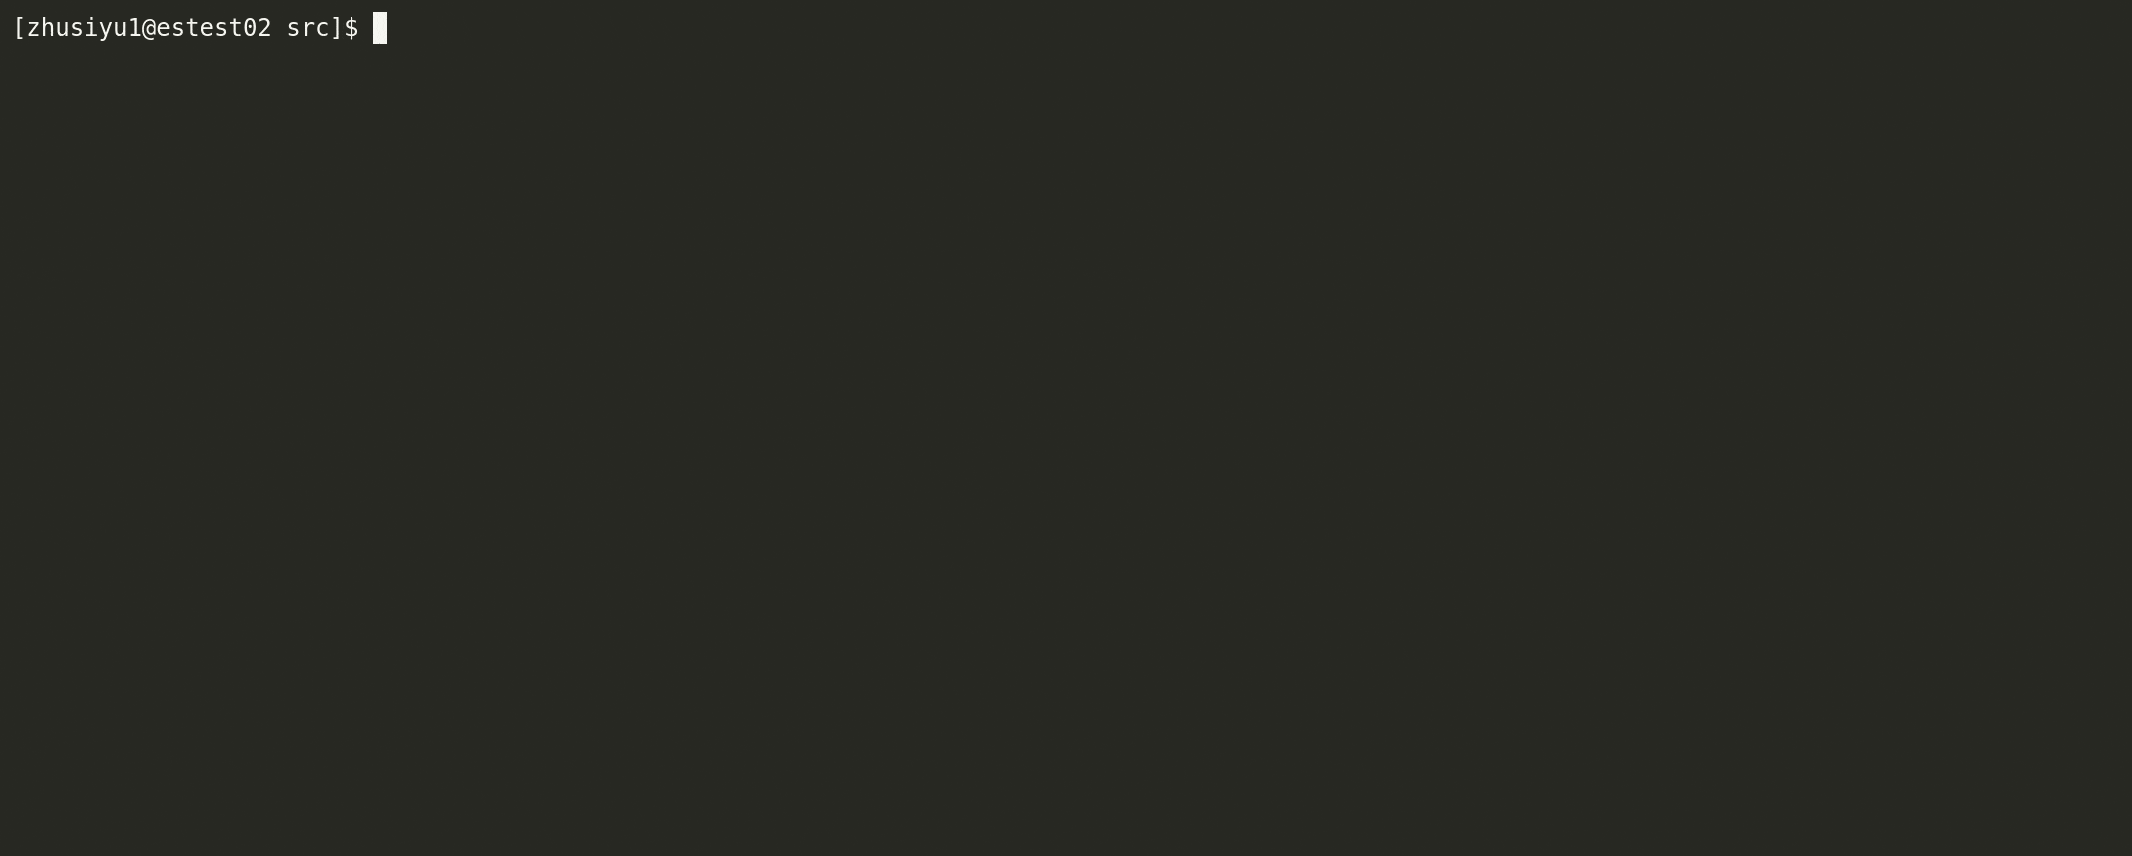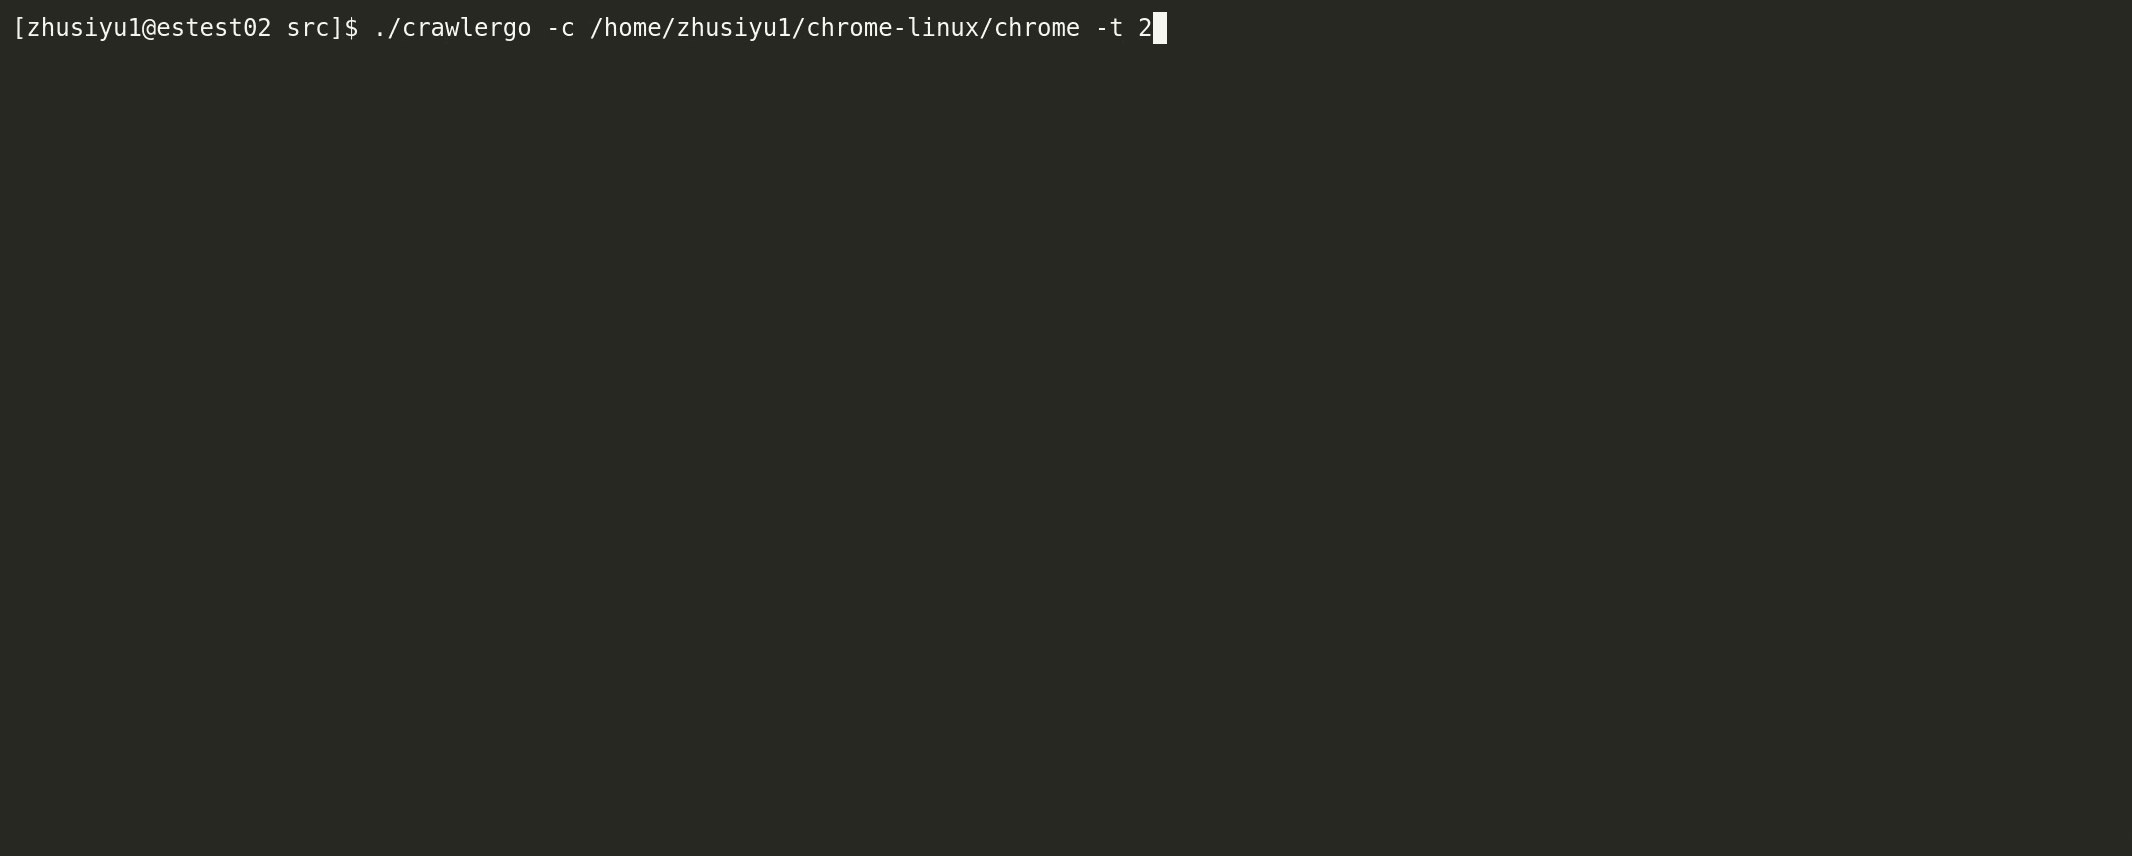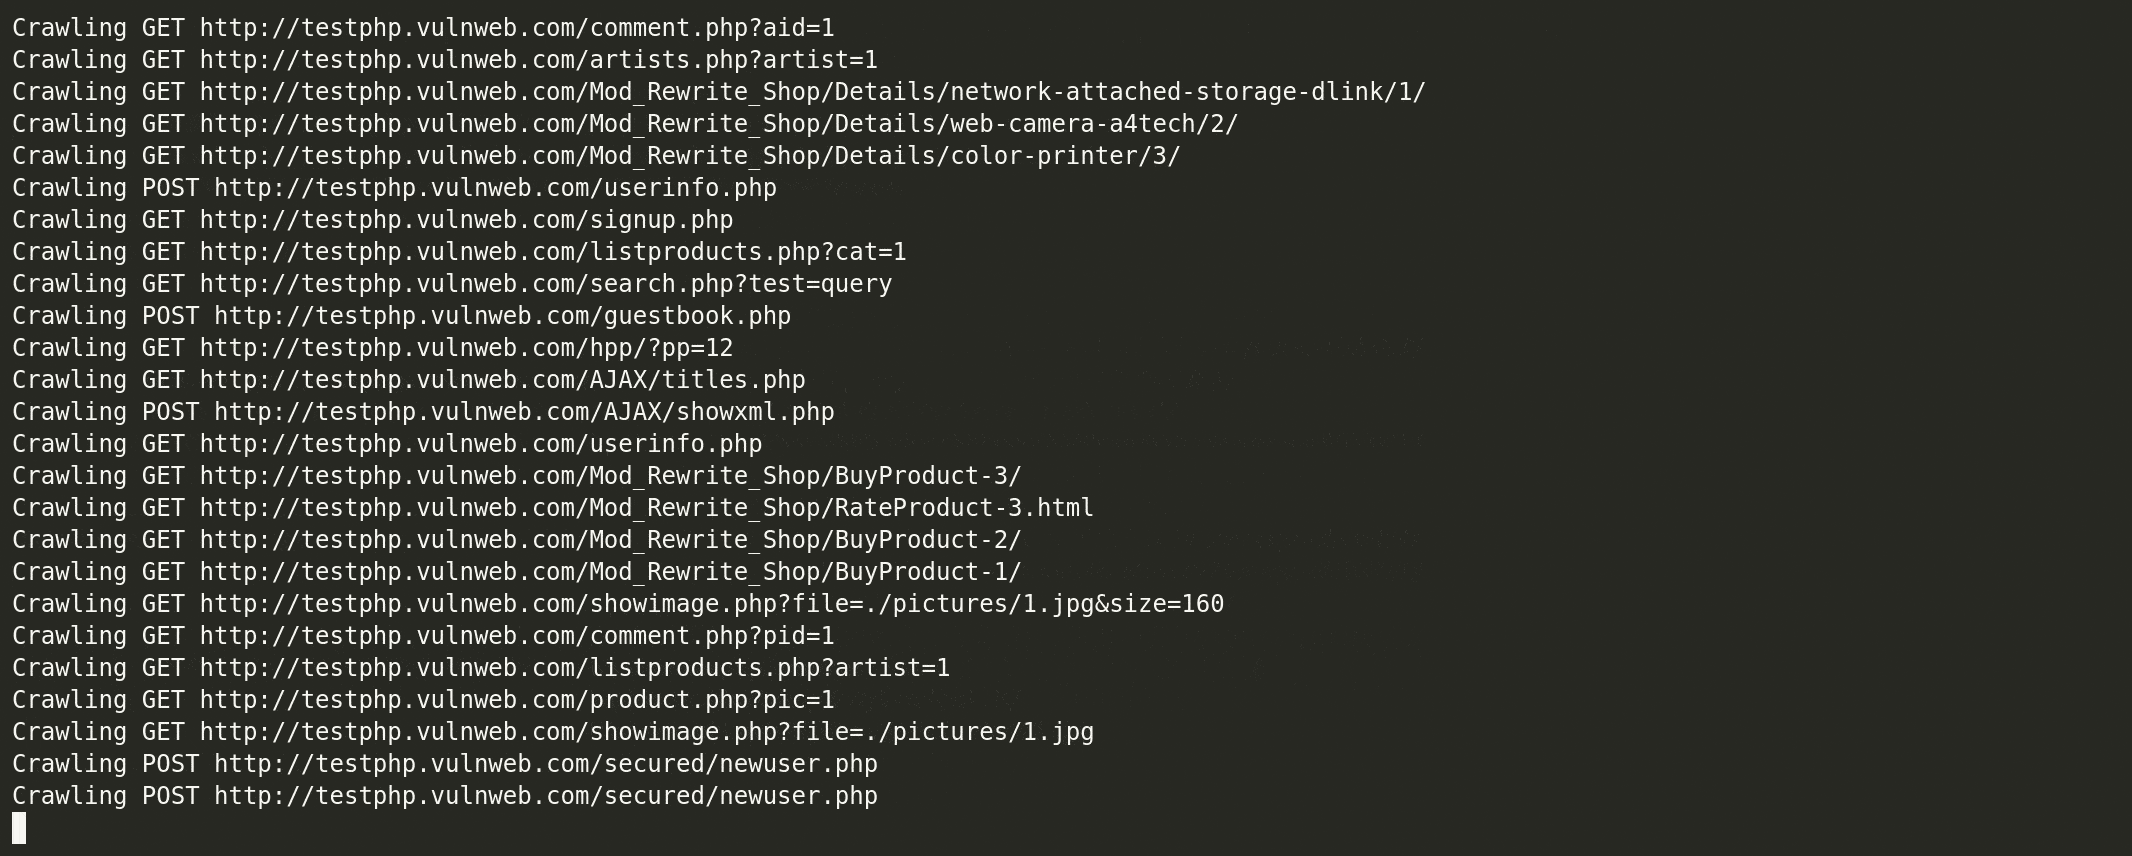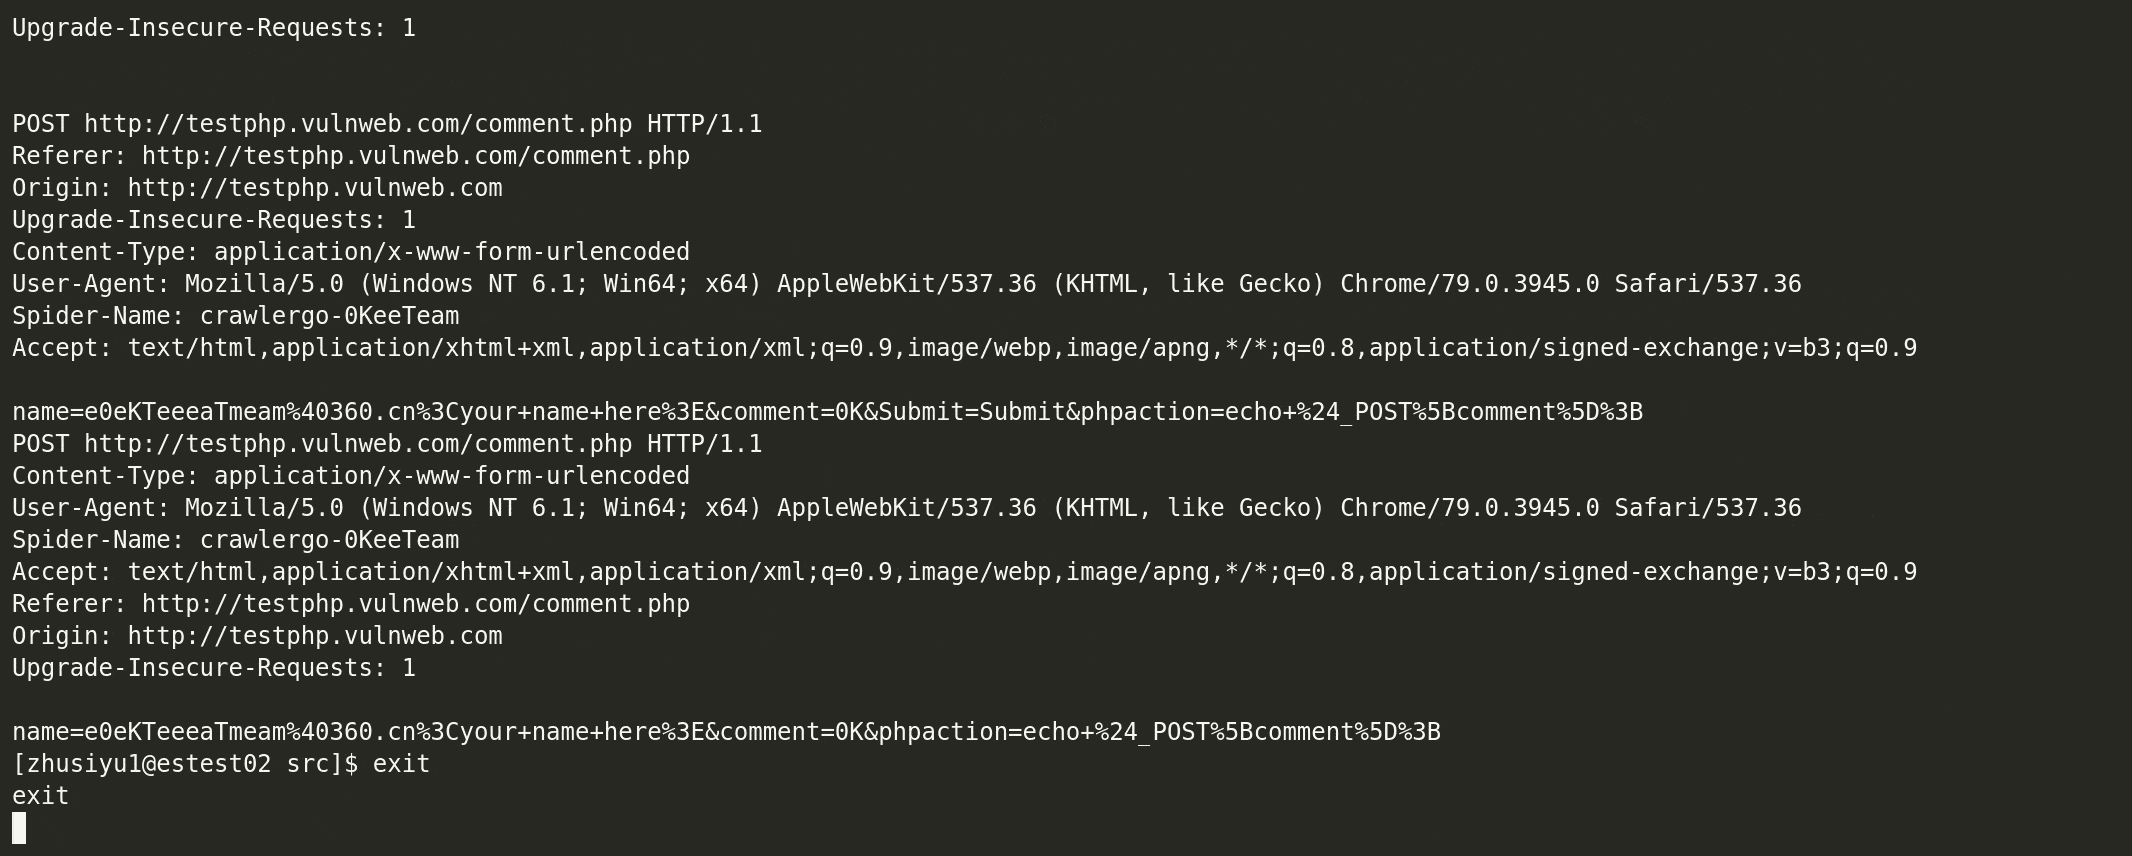
crawlergo è un crawler per browser che utilizza la modalità chrome headless per la raccolta di URL. Hooka i punti chiave dell'intera pagina web durante la fase di rendering del DOM, compila e invia automaticamente i moduli, attiva intelligentemente gli eventi JS e raccoglie quante più voci possibile esposte dal sito web. Il modulo integrato di deduplicazione degli URL filtra un gran numero di URL pseudo-statici, mantenendo comunque una velocità di analisi e scansione rapida per siti web di grandi dimensioni, e infine ottiene una raccolta di risultati di richieste di alta qualità.
crawlergo attualmente supporta le seguenti funzionalità:
Leggere e confermare attentamente l'esclusione di responsabilità prima di installare e utilizzare.
Build
make build
make build_all
Se stai usando un sistema Linux e Chrome segnala dipendenze mancanti, consulta la sezione TroubleShooting qui sotto.
Supponendo che la directory di installazione di Chromium sia /tmp/chromium/, imposta 10 schede aperte contemporaneamente ed esegui la scansione di testphp.vulnweb.com:
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
Puoi anche usarlo con Docker senza problemi:
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
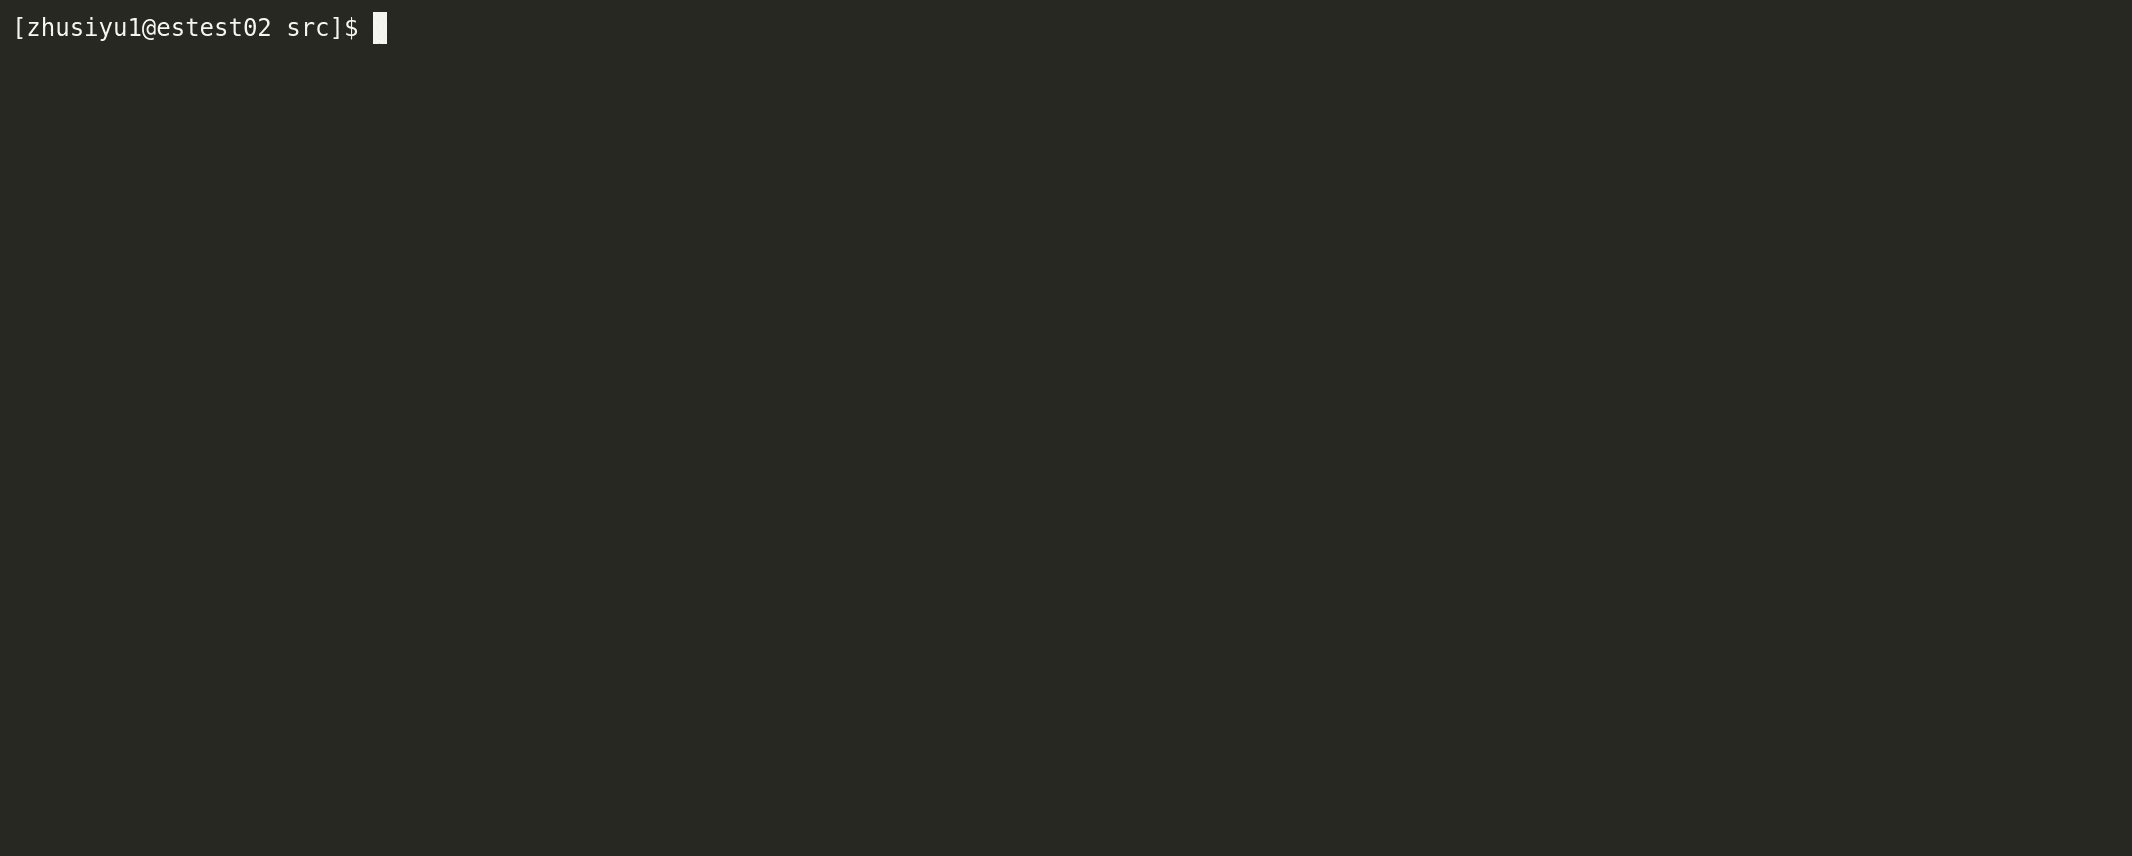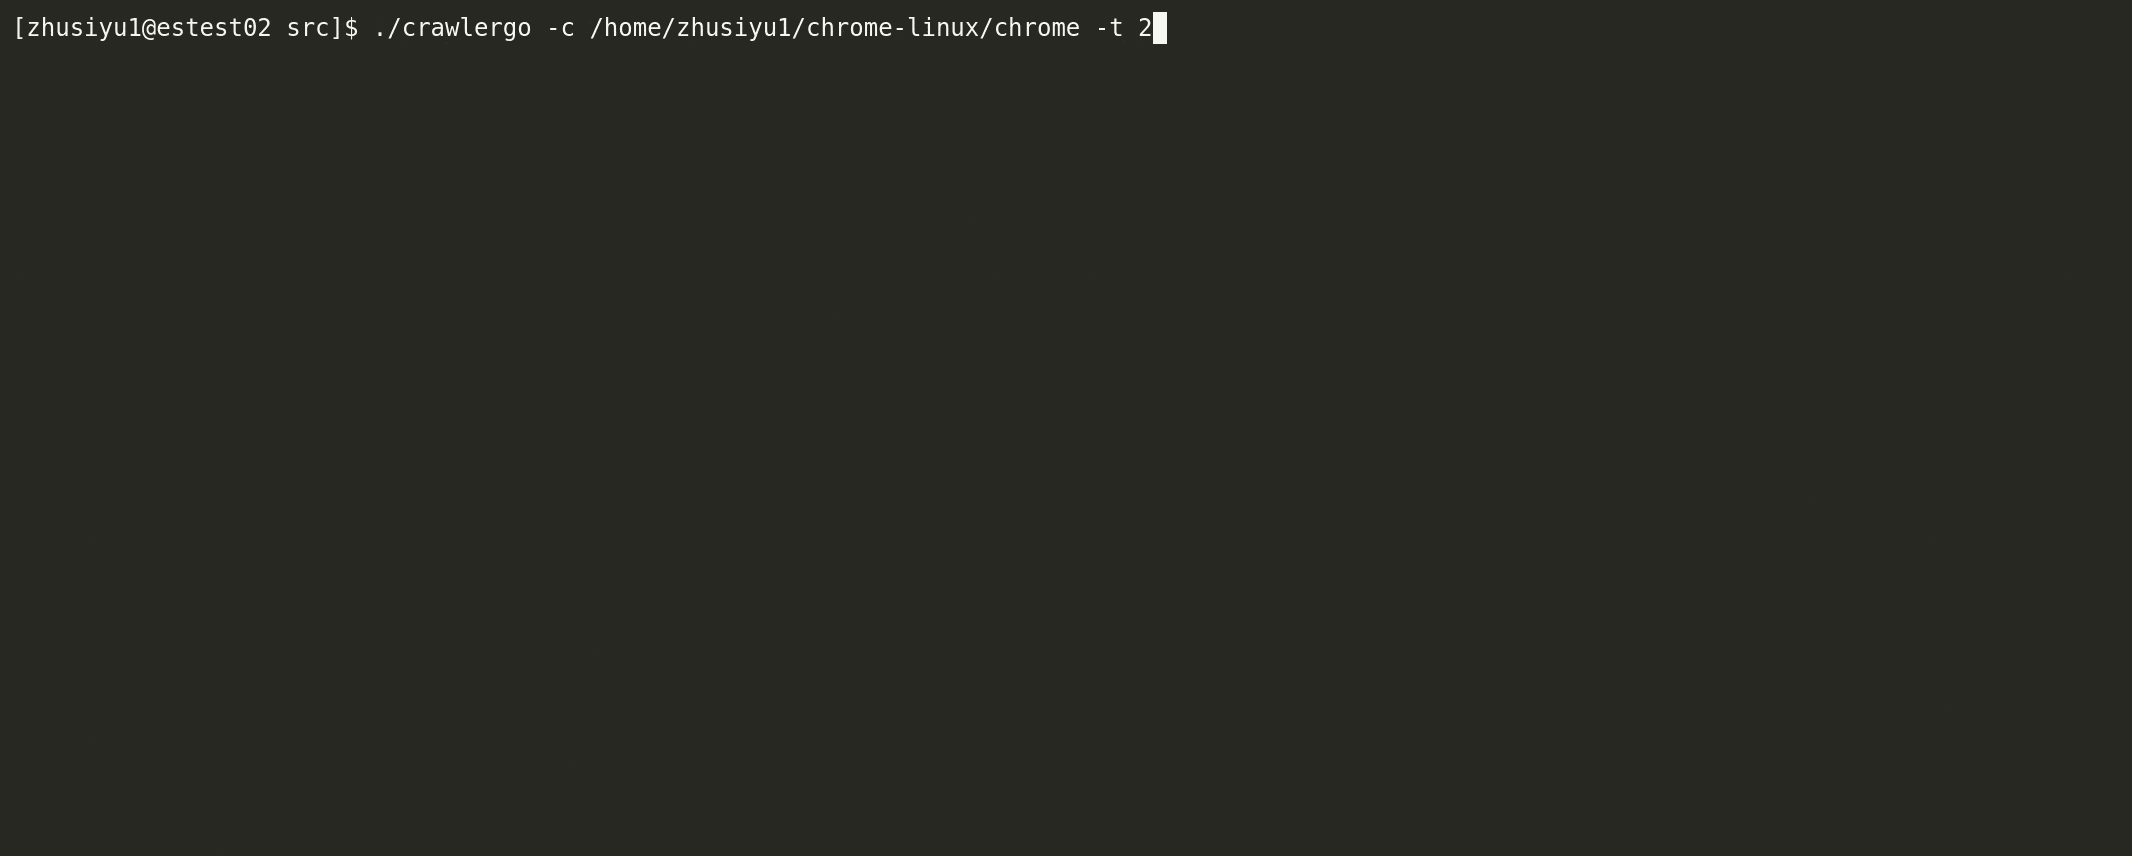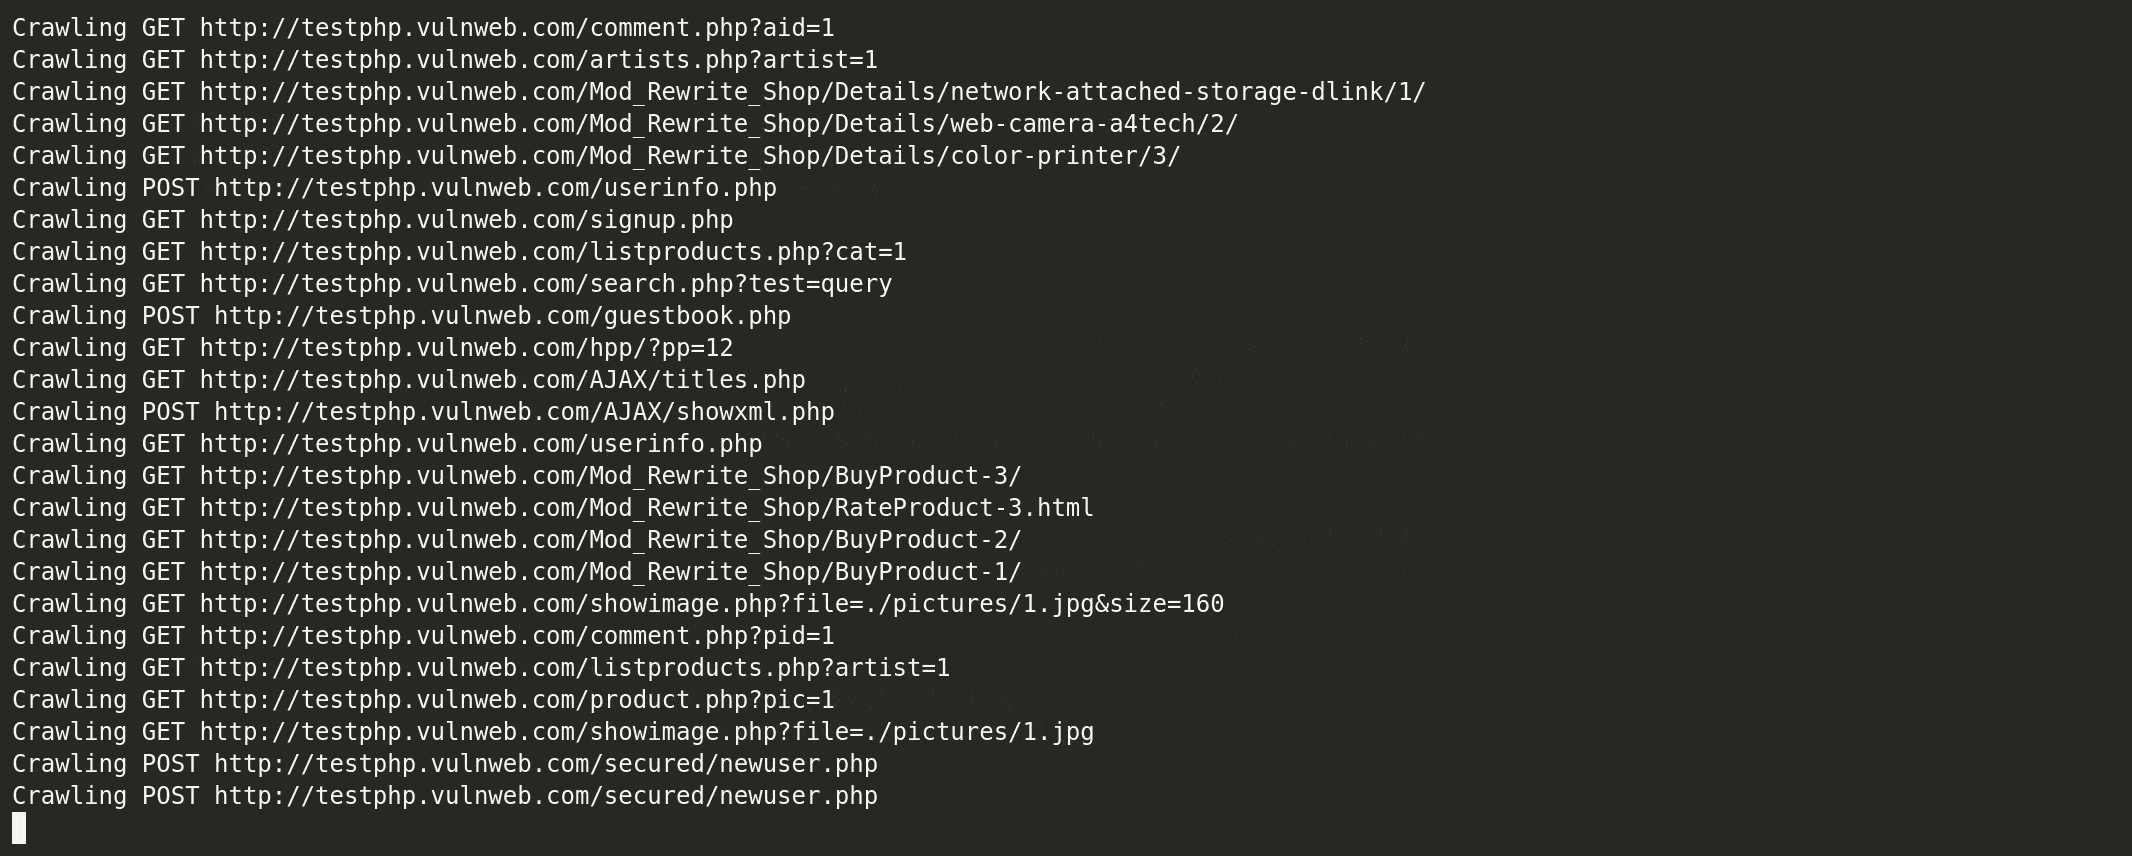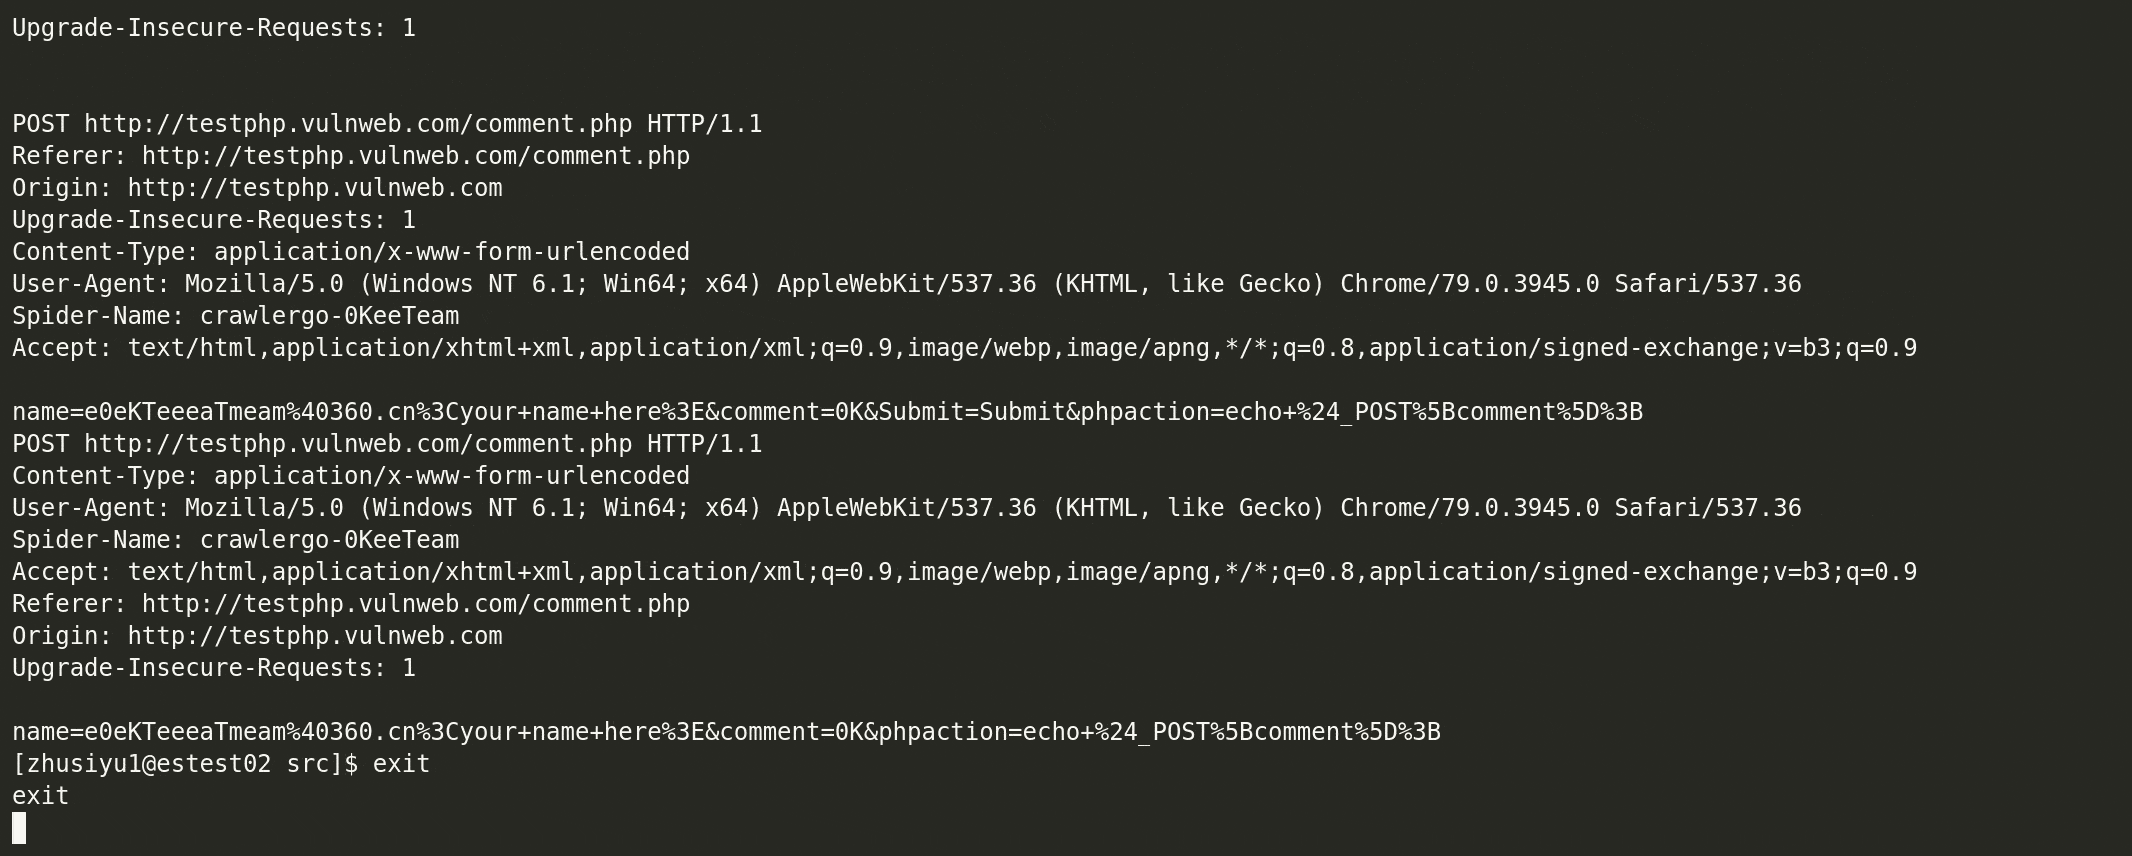
Per impostazione predefinita, crawlergo stampa i risultati direttamente sullo schermo. Impostiamo ora la modalità di output su json. Il codice di esempio per chiamarlo usando Python è il seguente:
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  è la stringa separatrice di fine attività
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Quando la modalità di output è impostata su json, il risultato restituito, dopo la deserializzazione JSON, contiene quattro parti:
all_req_list: Tutte le richieste trovate durante questa attività di scansione, inclusi qualsiasi tipo di risorsa da altri domini.req_list: Restituisce i risultati del dominio corrente di questa attività di scansione, deduplicati pseudo-staticamente, senza collegamenti a risorse statiche. È un sottoinsieme di all_req_list.all_domain_list: Elenco di tutti i domini trovati.sub_domain_list: Elenco dei sottodomini trovati.crawlergo restituisce la richiesta completa e l'URL, che possono essere utilizzati in vari modi:
In combinazione con altri scanner passivi di vulnerabilità web
Per prima cosa, avvia uno scanner passivo e imposta l'indirizzo di ascolto su: http://127.0.0.1:1234/
Successivamente, supponendo che crawlergo sia sulla stessa macchina dello scanner, avvia crawlergo e imposta i parametri:
--push-to-proxy http://127.0.0.1:1234/
Host binding (non disponibile per versioni elevate di Chrome) (esempio)
Cookie personalizzati (esempio)
Pulizia regolare dei processi zombie generati da crawlergo (esempio), contributo di @ring04h
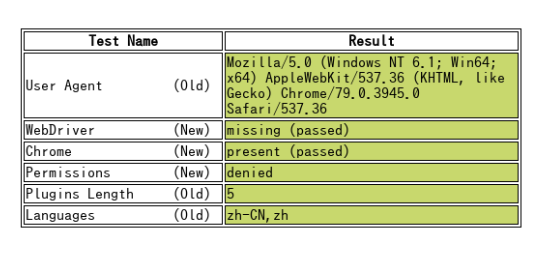
crawlergo può bypassare il rilevamento della modalità headless per impostazione predefinita.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
'Fetch.enable' non trovato
Fetch è una funzionalità supportata dalla nuova versione di Chrome. Se si verifica questo errore, significa che la tua versione è troppo vecchia; aggiorna la versione di Chrome.
Chrome viene eseguito con dipendenze mancanti come xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
Avviso di Timeout di navigazione / browser non trovato / percorso eseguibile del browser sconosciuto
Assicurati che il percorso dell'eseguibile del browser sia configurato correttamente. Digita: chrome://version nella barra degli indirizzi e trova il percorso del file eseguibile: