
 nvidia-nemo/guardrails
Guardrail programmabili per app di chat LLM: applica vincoli di input/output, blocca jailbreak e prompt injection, rileva le allucinazioni e maschera i dati sensibili.

# Libreria NVIDIA NeMo Guardrails
[](https://opensource.org/licenses/Apache-2.0)
[](https://pypi.org/project/nemoguardrails)
[](https://pypi.org/project/nemoguardrails)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/pr-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/full-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/full-tests.yml)
[](https://github.com/NVIDIA-NeMo/Guardrails/actions/workflows/lint.yml)
[](https://docs.nvidia.com/nemo/guardrails)
[](https://pepy.tech/project/nemoguardrails)
[](https://pepy.tech/project/nemoguardrails)
[Documentazione](https://docs.nvidia.com/nemo/guardrails/latest/about-nemo-guardrails-library/overview) · [Avvio rapido](#quickstart) · [Casi d'uso](#what-you-can-build) · [Integrazioni](#choose-your-integration) · [Catalogo delle guardrail](#guardrail-catalog) · [Esempi](https://github.com/nvidia-nemo/guardrails/blob/develop/examples) · [Community](#community-usage) · [Sicurezza](https://github.com/nvidia-nemo/guardrails/blob/develop/SECURITY.md) · [Release](https://github.com/NVIDIA-NeMo/Guardrails/releases) · [Changelog](https://github.com/nvidia-nemo/guardrails/blob/develop/CHANGELOG.md)
NeMo Guardrails è una libreria open-source per applicare controlli programmabili di sicurezza e protezione alle applicazioni basate su LLM e agenti. Gli agenti eseguono comandi, chiamano API, interrogano i tuoi dati e leggono il web. Le applicazioni conversazionali applicano controlli sugli input e sugli output; i sistemi di retrieval-augmented generation (RAG) filtrano i contenuti recuperati e verificano le risposte rispetto alle evidenze.
Utilizzi la libreria NeMo Guardrails per dichiarare in una policy ciò che ciascun agente può fare, combinando regole locali a bassa latenza con controlli basati su modelli per jailbreak, istruzioni iniettate e chiamate a strumenti non sicure. La tua applicazione o il tuo harness per agenti esegue questi controlli e utilizza i loro risultati per decidere se continuare.
```bash
pip install nemoguardrails
```
Richiede Python 3.11–3.13. Consulta la [guida all'installazione](https://docs.nvidia.com/nemo/guardrails/latest/get-started/installation-guide) per i pacchetti opzionali e la configurazione.
> [!NOTE]
> La versione 0.25.0 depreca `LLMRails`, con rimozione prevista non prima della 0.27.0. Usa `Guardrails` per le nuove integrazioni e segui la [guida alla migrazione](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/migration/0.25.mdx).
## Cosa puoi realizzare
- **Agenti AI e assistenti alla programmazione:** verifica le chiamate agli strumenti proposte e i risultati restituiti con le [tool rails](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx), oppure collega un agente tramite il [hooks server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/index.mdx).
- **Applicazioni conversazionali:** applica i [controlli di input e output](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx).
- **Retrieval-augmented generation (RAG):** [rileva o maschera i dati sensibili nei contenuti recuperati](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/pii-detection.mdx) e [verifica se le risposte sono fondate sulle evidenze](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx).
## Come funziona
Usa la libreria NVIDIA NeMo Guardrails per definire la tua policy in file di configurazione che specificano le rails, i modelli e i prompt da utilizzare.
Esegui la libreria nella tua applicazione Python oppure distribuiscila come server.
Scegli la modalità check o la modalità proxy in base a come la tua applicazione gestisce le richieste al modello.
### Modalità Check
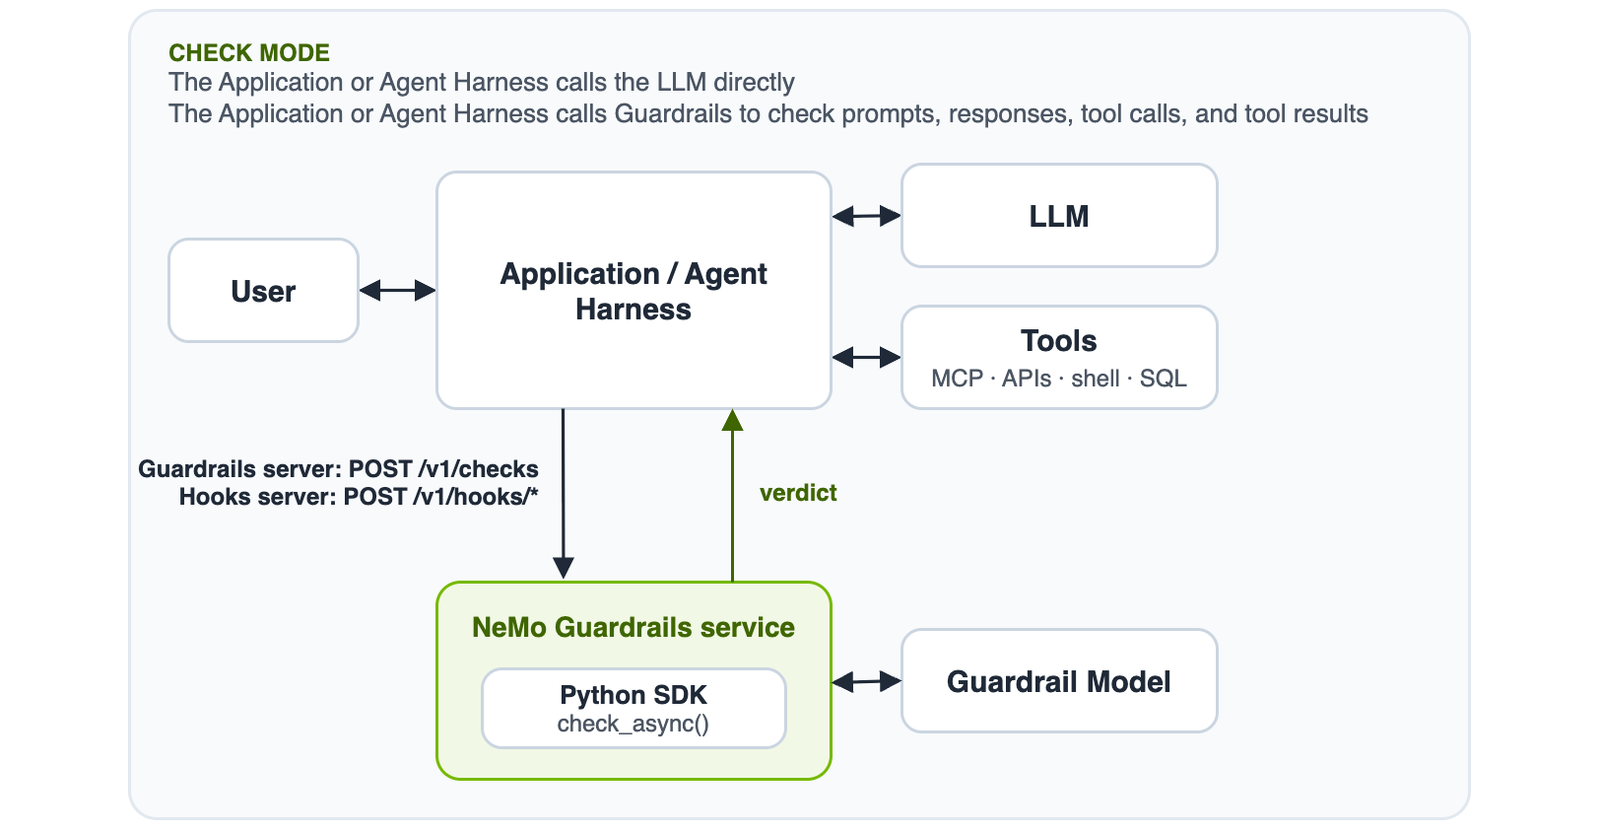
La tua applicazione o l'agent harness chiama direttamente l'LLM ed esegue gli strumenti.
In ogni punto che richiede una decisione di policy, invia alla libreria il prompt, la risposta del modello, la chiamata allo strumento o il risultato dello strumento pertinente per la verifica.
Usa il risultato per gestire contenuti bloccati o modificati prima di eseguire uno strumento, restituire una risposta o passare un risultato di uno strumento al modello.
Usa [`check_async()`](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx) in Python, `POST /v1/checks` sul server Guardrails, oppure il [hooks server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/index.mdx) per gli agenti di programmazione.
Per i controlli degli strumenti con `check_async()`, usa il motore IORails e specifica `RailType.TOOL_CALL` o `RailType.TOOL_RESULT` in `rail_types`.
Verifica le chiamate agli strumenti prima dell'esecuzione e i risultati degli strumenti dopo l'esecuzione.
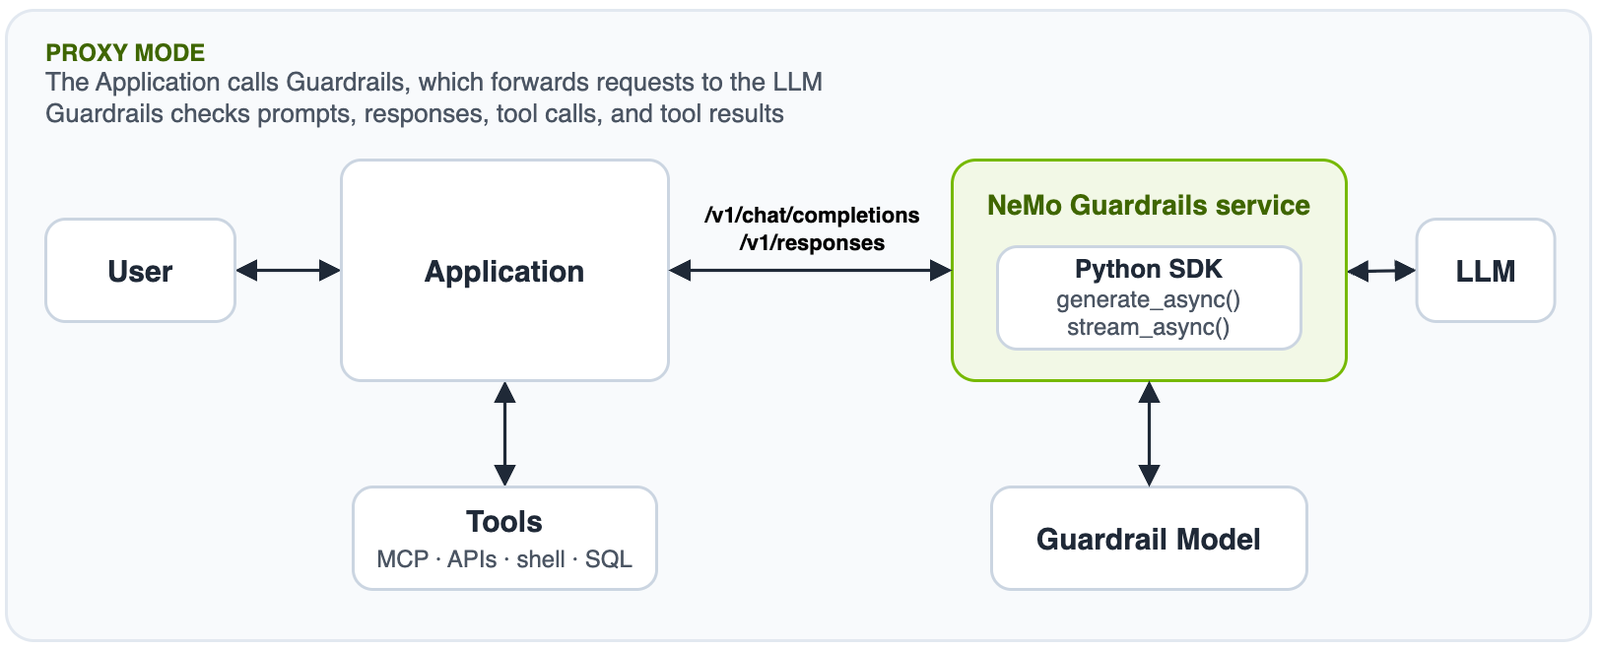
### Modalità Proxy
Instrada le richieste al modello attraverso la libreria per applicare le rails di input e output configurate.
Le rails di input possono bloccare una richiesta prima che raggiunga l'LLM dell'applicazione.
Per le richieste non in streaming, le rails di output controllano la risposta prima che la libreria la restituisca.
I contenuti bloccati producono un rifiuto o un errore, a seconda dell'integrazione e della configurazione.
Usa `generate_async()` o `stream_async()` in Python, oppure `POST /v1/chat/completions` sul server Guardrails.
La tua applicazione esegue gli strumenti; le integrazioni supportate possono controllare le chiamate agli strumenti nelle risposte del modello e i risultati degli strumenti nelle richieste successive.
Il [gateway server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-proxy/providers-and-streaming.mdx) supporta anche `POST /v1/chat/completions` e `POST /v1/responses`, ma i suoi profili predefiniti non supportano il contenuto degli strumenti.
Ogni richiesta `/v1/responses` al gateway deve includere `"store": false`.
Quando lo streaming dell'output è abilitato per `stream_async()`, l'impostazione predefinita `stream_first: true` consegna i chunk prima di verificarli.
Per verificare ogni chunk prima della consegna, imposta `rails.output.streaming.stream_first: false`.
Per i dettagli sulla configurazione, consulta [output rail streaming](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/yaml-schema/streaming/output-rail-streaming.mdx).
La latenza dipende dalle regole, dai modelli e dai servizi configurati.
Il supporto delle rail varia in base al motore e all'integrazione.
Fare riferimento a [rail engine support](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/reference/rail-engine-support.mdx), [configuration](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/configuration-reference.mdx) e [Choose Your Integration](#choose-your-integration).
## Perché NeMo Guardrails
- **Governa ciò che fanno gli agenti.** Convalida i nomi degli strumenti e gli schemi degli argomenti prima dell'esecuzione. Controlla i risultati degli strumenti e applica le policy per singolo strumento prima di restituirli al modello.
- **Mantieni il tuo modello e il loop dell'agente.** Usa i [checks without main-model generation](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx) per aggiungere guardrail a un'applicazione esistente. I controlli basati su modello chiamano comunque il modello o il servizio configurato.
- **Componi la policy di cui hai bisogno.** Combina regole locali [regex](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/community/regex.mdx) e [CEL](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/cel.mdx) con modelli di sicurezza e controlli di terze parti.
- **Collega il tuo runtime.** Scegli un'[integrazione](#choose-your-integration) per la tua applicazione, servizio condiviso o agente di coding.
- **Aperto e tuo da eseguire.** La libreria è distribuita con licenza Apache 2.0. Scegli i [supported model providers](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/about/supported-llms.mdx) ed esegui i controlli con rilevatori locali o endpoint di inferenza ospitati.
## Quickstart
Verifica il rimborso proposto da un agente di supporto rispetto a un limite di $500, senza un modello o una chiave API.
Installa l'extra opzionale CEL per questo esempio:
```bash
pip install "nemoguardrails[cel]"
```
L'esempio convalida lo schema degli argomenti dello strumento e blocca le chiamate oltre il limite. Espandilo e salvalo come `check_refund.py`:
<details>
<summary>Esempio Python completo</summary>
```python
import asyncio
import json
from nemoguardrails import Guardrails, RailsConfig
from nemoguardrails.rails.llm.options import RailStatus, RailType
config = RailsConfig.from_content(yaml_content="""
models: []
rails:
tool_call:
flows: [tool call validation]
per_tool:
issue_refund: [cel check tool call]
config:
cel:
tool_call:
issue_refund:
expressions: ["args.amount > 500"]
""")
TOOLS = [{
"type": "function",
"function": {
"name": "issue_refund",
"parameters": {
"type": "object",
"properties": {"amount": {"type": "number", "minimum": 0}},
"required": ["amount"],
"additionalProperties": False,
},
},
}]
async def main():
async with Guardrails(config, require_iorails=True) as rails:
for amount in (50, 5000):
call = {
"role": "assistant",
"tool_calls": [{
"id": "call_1",
"type": "function",
"function": {
"name": "issue_refund",
"arguments": json.dumps({"amount": amount}),
},
}],
}
result = await rails.check_async(
[call], rail_types=[RailType.TOOL_CALL], tools=TOOLS
)
print(f"${amount}: {result.status.value}")
if result.status == RailStatus.PASSED:
print("Ready for the application to execute")
else:
print(f"Rail: {result.rail}")
print(f"Reason: {result.reason}")
asyncio.run(main())
```
</details>
Eseguitelo dalla directory in cui avete salvato il file:
```bash
python check_refund.py
```
Expected output:
```text
$50: passed
Ready for the application to execute
$5000: blocked
Rail: cel check tool call
Reason: cel check tool call
```
L'esempio non emette rimborsi. La tua applicazione esegue uno strumento solo dopo che i suoi controlli sono stati superati.
Per ulteriori esempi di configurazione e gestione degli errori, consulta [tool calling](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx) e [checking messages](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx).
## Scegli la tua integrazione
Collega NeMo Guardrails dove la tua applicazione o il tuo agente può applicare i propri controlli.
| Cosa stai costruendo? | Come collegarlo |
| --- | --- |
| **Un servizio guardrails condiviso** per più applicazioni o team | Usa la [Checks API](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-fastapi-server/overview.mdx) (`/v1/checks`) per richiedere verdetti mentre ogni applicazione gestisce il proprio modello e ciclo di esecuzione. |
| **Un livello di guardrails** per API di modelli esistenti | Usa il [gateway server](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-gateway/quickstart.mdx) per controllare richieste e risposte supportate preservando i formati del provider. |
| **Un assistente di programmazione o un agent harness** | Usa gli [hook nativi](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/run-hooks-server.mdx) o [NeMo Relay](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-hooks-server/nemo-relay-plugin.mdx) per controllare le chiamate agli strumenti prima dell'esecuzione. |
| **Una piattaforma per agenti, un'integrazione con framework o un ciclo personalizzato** | Incorpora il [Python SDK](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-python-apis/check-messages.mdx), chiama la [Checks API](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/run-rails/using-fastapi-server/overview.mdx) oppure usa una [integrazione con framework](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/integration/langchain/langgraph-integration.mdx) supportata. |
## Catalogo dei guardrail
Scegli i controlli per la tua policy e il tuo flusso di lavoro:
| Controllo | Scopo |
| --- | --- |
| [Sicurezza dei contenuti](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/content-safety.mdx) | Controlla input e output rispetto alle policy di sicurezza. |
| [Controllo dei argomenti](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/topic-control.mdx) | Controlla gli input rispetto alle linee guida tematiche configurate. |
| [Rilevamento di jailbreak](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/jailbreak-protection.mdx) | Rileva tentativi di jailbreak con euristiche o classificatori configurati. |
| [Rilevamento di injection](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/agentic-security.mdx) | Controlla l'output del modello per pattern di codice, SQL, template e cross-site scripting. |
| [Dati sensibili e PII](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/pii-detection.mdx) | Rileva o maschera dati sensibili in input, output e contenuti recuperati. |
| [Verifica dei fatti](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx) e [controlli delle allucinazioni](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/fact-checking.mdx#hallucination-detection) | Controlla le risposte rispetto alle evidenze o confronta le risposte del modello per verificarne la coerenza. |
| [Validazione di tool-call e tool-result](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-calling.mdx) | Valida gli strumenti dichiarati, gli schemi degli argomenti e il collegamento e la struttura dei tool-result. |
| [Controlli di sicurezza degli strumenti](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/tool-safety-check.mdx) | Valuta le chiamate agli strumenti e i risultati rispetto alle istruzioni di sicurezza per singolo strumento. |
| [Regex](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/community/regex.mdx) e [CEL](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/cel.mdx) | Applica regole deterministiche basate su pattern ed espressioni. |
| [Autocontrolli LLM](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/self-check.mdx) | Usa prompt LLM configurati per la moderazione degli input, la moderazione degli output o la verifica dei fatti. |
| [Rilevamento della lingua](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/language-detector.mdx) | Limita l'input alle lingue configurate. |
| [Integrazioni di terze parti](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/configure-rails/guardrail-catalog/third-party.mdx) | Collega servizi gestiti di sicurezza e moderazione. |
I modelli NVIDIA Nemotron Safety includono [Nemotron 3.5 Content Safety](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/configs/nemotron-3.5-content-safety), [Nemotron Content Safety Reasoning 4B](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/getting-started/tutorials/nemotron-content-safety-reasoning-deployment.mdx) e [Llama 3.1 Nemotron Safety Guard 8B V3](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/getting-started/tutorials/nemotron-safety-guard-deployment.mdx). Segui gli esempi e le guide collegate per la configurazione specifica del modello.
Usa gli [strumenti di valutazione](https://docs.nvidia.com/nemo/guardrails/latest/evaluation/evaluate-guardrails) per valutare le tue policy e [garak](https://github.com/NVIDIA/garak) per scansionare le applicazioni LLM alla ricerca di vulnerabilità. Fai riferimento alla [guida alla scansione delle vulnerabilità](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/evaluation/llm-vulnerability-scanning.mdx) per un esempio.
## Benchmarking delle prestazioni dei Guardrails
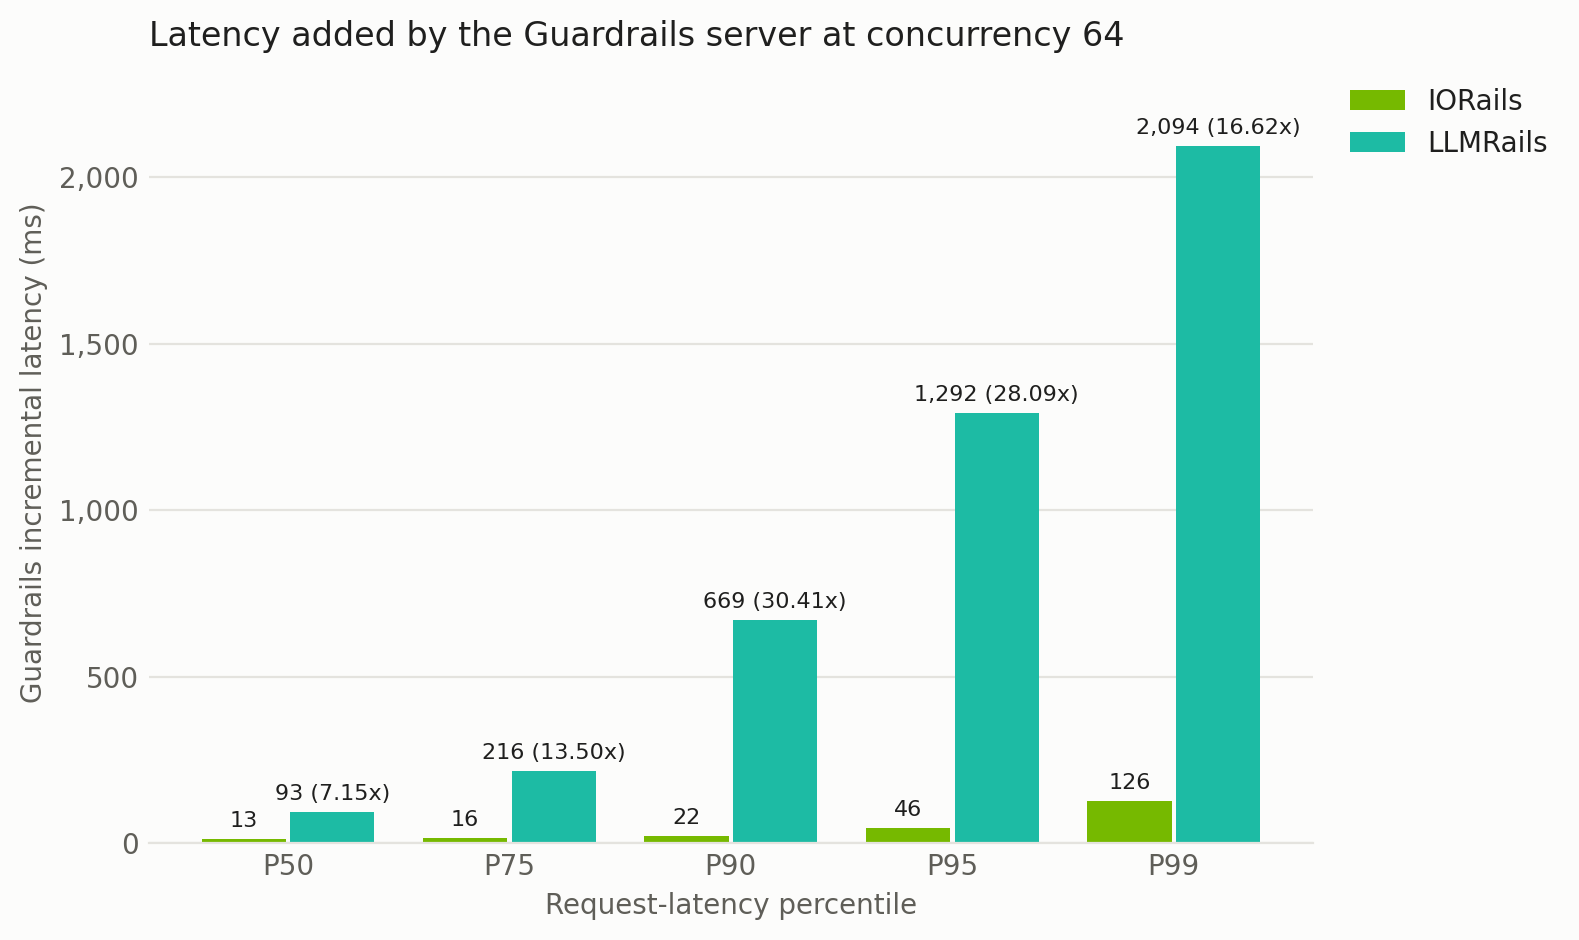
I numeri seguenti mostrano la latenza che il server API dei Guardrails aggiunge a ciascuna richiesta, misurata su un MacBook Pro da 14 pollici con un Apple M4 (10 core, 24 GB).
Il server esegue la configurazione [`content_safety_local`](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/configs/content_safety_local), che verifica ogni richiesta con un rail di input e un rail di output.
LLM mock sostituiscono il modello principale e il modello di content-safety con latenze fisse, quindi ogni richiesta trascorre 5.000 ms in chiamate ai modelli: 500 ms per ciascun controllo di content-safety e 4.000 ms per il modello principale.
AIPerf invia richieste non in streaming per 180 secondi a ciascun livello di concorrenza, con prompt di circa 100 token di input.
Il grafico seguente mostra la latenza aggiunta alla concorrenza 64, dove ogni etichetta LLMRails indica anche il suo multiplo del valore IORails.
| Concorrenza | IORails p50 (ms) | IORails p90 (ms) | IORails p99 (ms) | LLMRails p50 (ms) | LLMRails p90 (ms) | LLMRails p99 (ms) |
| ---: | ---: | ---: | ---: | ---: | ---: | ---: |
| 1 | 11 | 13 | 30 | 39 | 40 | 53 |
| 2 | 13 | 15 | 20 | 62 | 70 | 104 |
| 4 | 13 | 15 | 19 | 85 | 100 | 127 |
| 8 | 13 | 19 | 68 | 136 | 179 | 208 |
| 16 | 15 | 21 | 30 | 97 | 289 | 416 |
| 32 | 13 | 19 | 106 | 88 | 274 | 860 |
| 64 | 13 | 22 | 126 | 93 | 669 | 2,094 |
| 128 | 17 | 774 | 2,880 | 430 | 1,422 | 5,182 |
Ogni valore è il percentile della latenza della richiesta meno i 5.000 ms di chiamate ai modelli.
Include le tre chiamate HTTP del server ai modelli mock, circa 2,5 ms ciascuna.
Per riprodurre questi numeri, segui la [guida al benchmarking](https://github.com/nvidia-nemo/guardrails/blob/develop/benchmark/README.md) con due modifiche:
- Imposta `benchmark_duration: 180` nella configurazione di AIPerf; le configurazioni fornite usano 60 secondi.
- Per le colonne IORails, avvia il server con `NEMO_GUARDRAILS_IORAILS_ENGINE=true`; il Procfile della guida avvia il server senza questa variabile, quindi il server esegue LLMRails per impostazione predefinita.
Gli stessi strumenti possono essere usati per eseguire il benchmarking di deployment Guardrails in produzione usando modelli reali invece di LLM mock.
Per questo caso d'uso la configurazione dei Guardrails dovrebbe puntare a LLM di produzione, e AIPerf dovrebbe essere eseguito con dataset di produzione rappresentativi.
## Utilizzo da parte della community
Questa istantanea anonima dell'utilizzo copre le build di rilascio `0.22.0` e `0.23.0` dal 22 maggio al 18 agosto 2026, con un numero stimato di 665.798 sessioni di avvio distinte.
<details>
<summary>Visualizza l'utilizzo dei rail, l'utilizzo delle funzionalità e i conteggi dei rail configurati</summary>
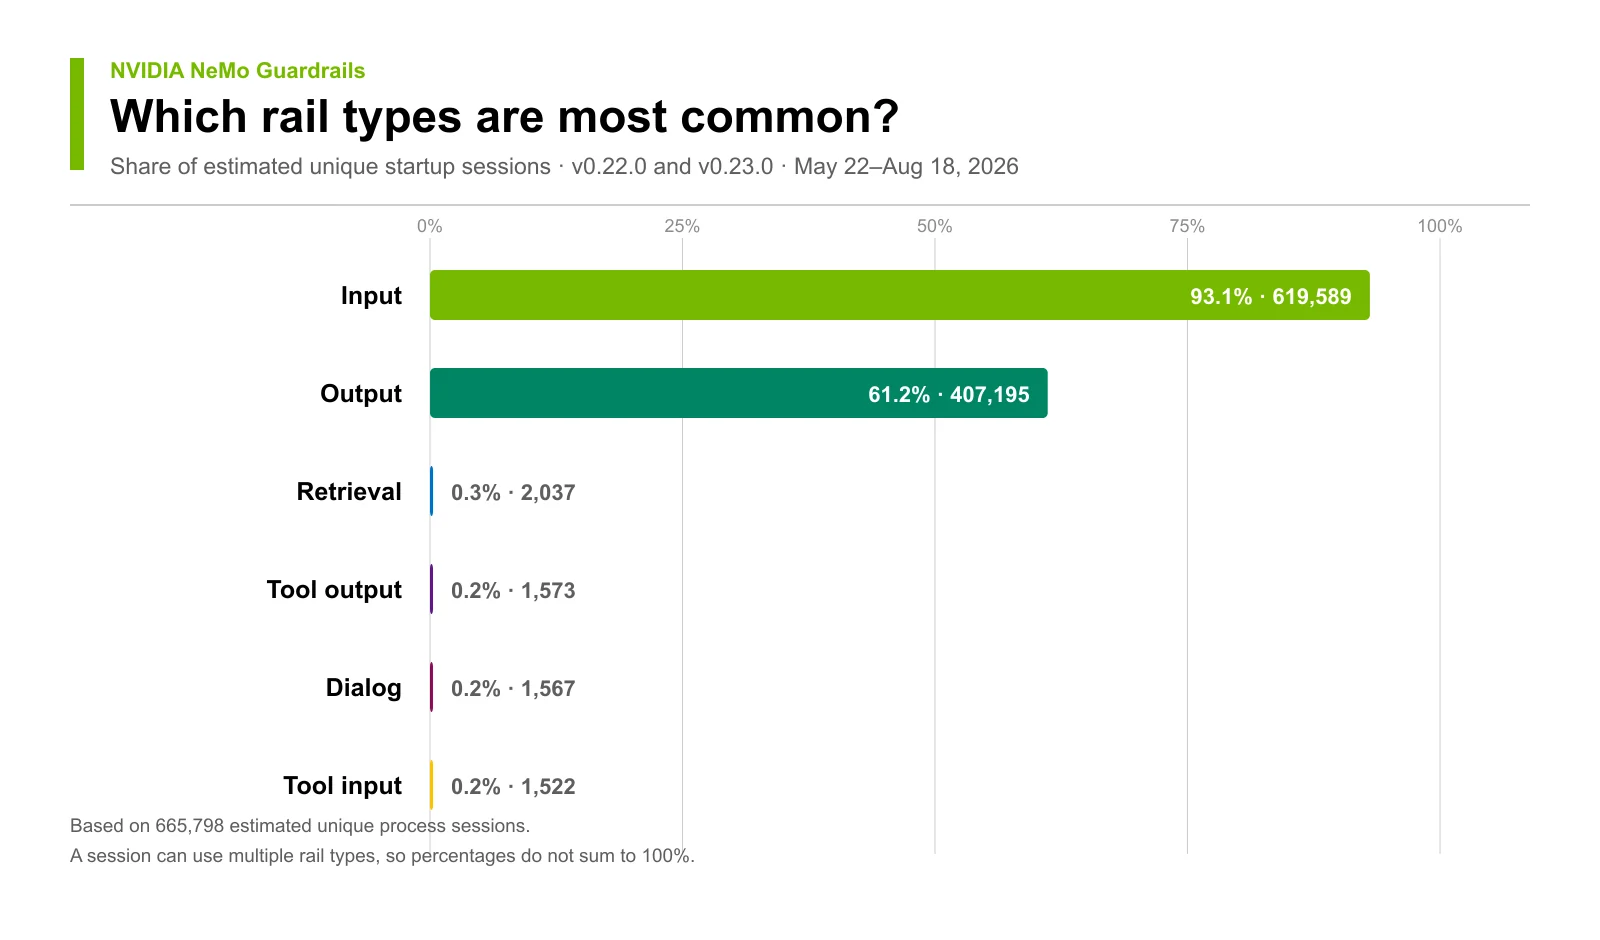
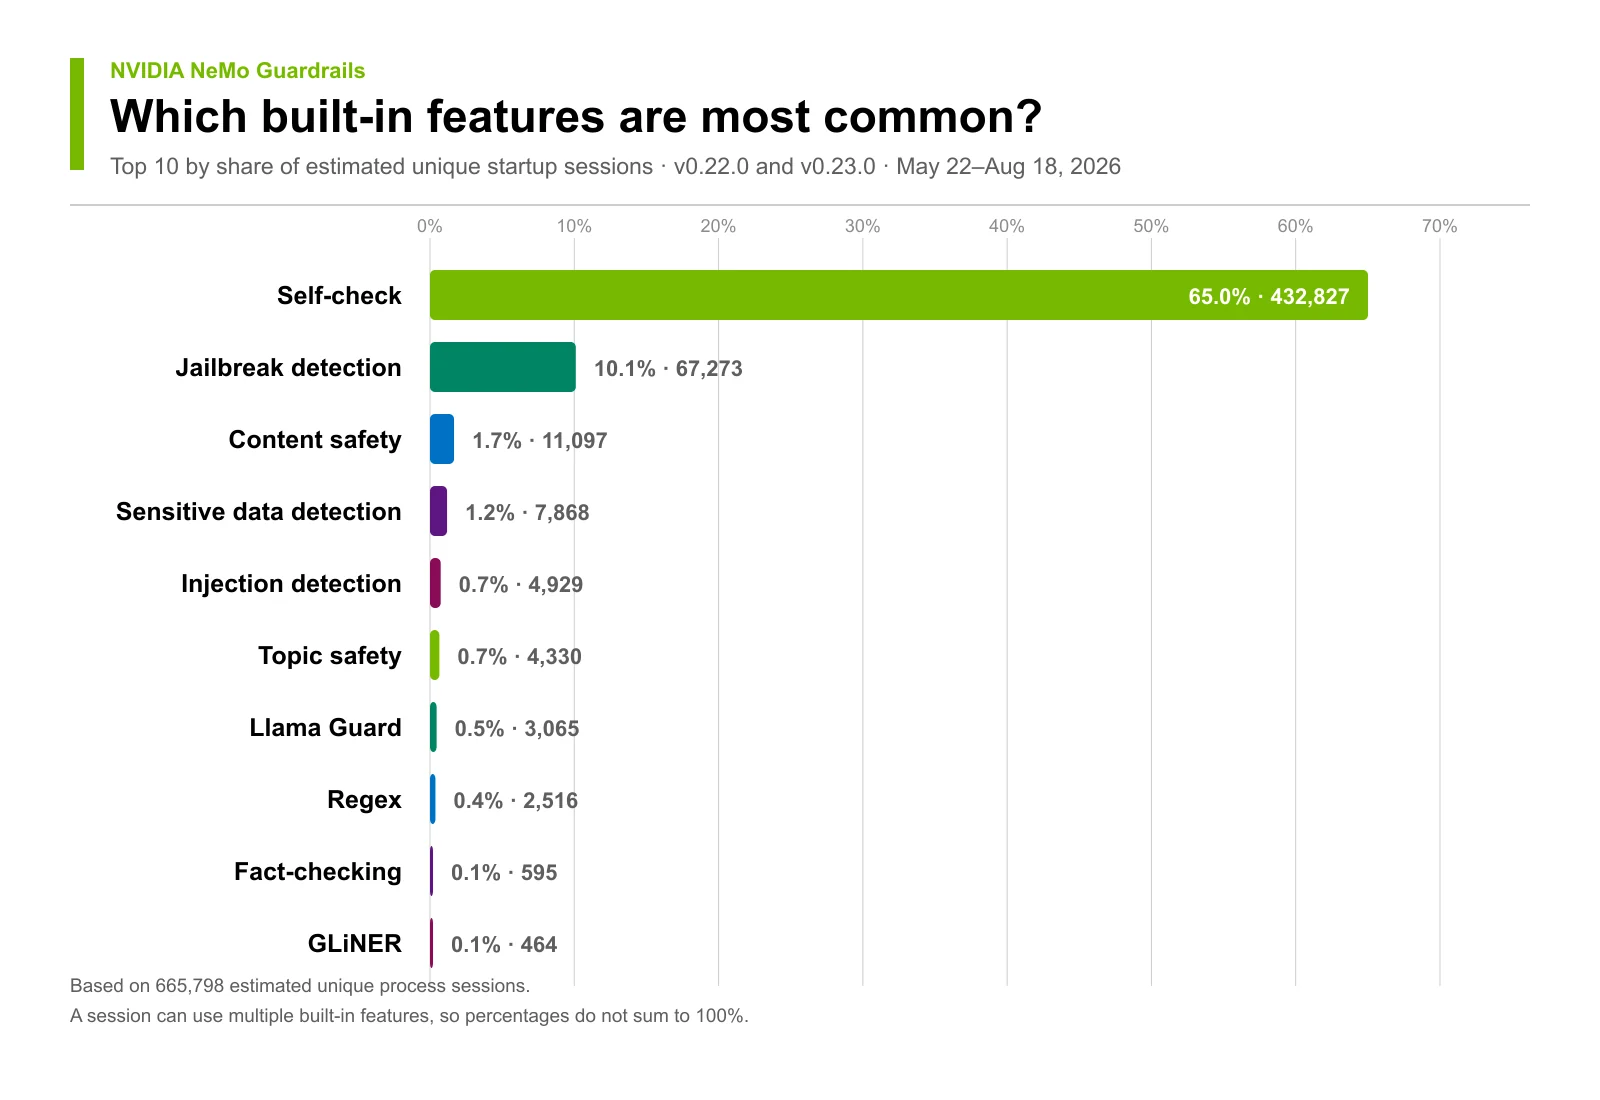
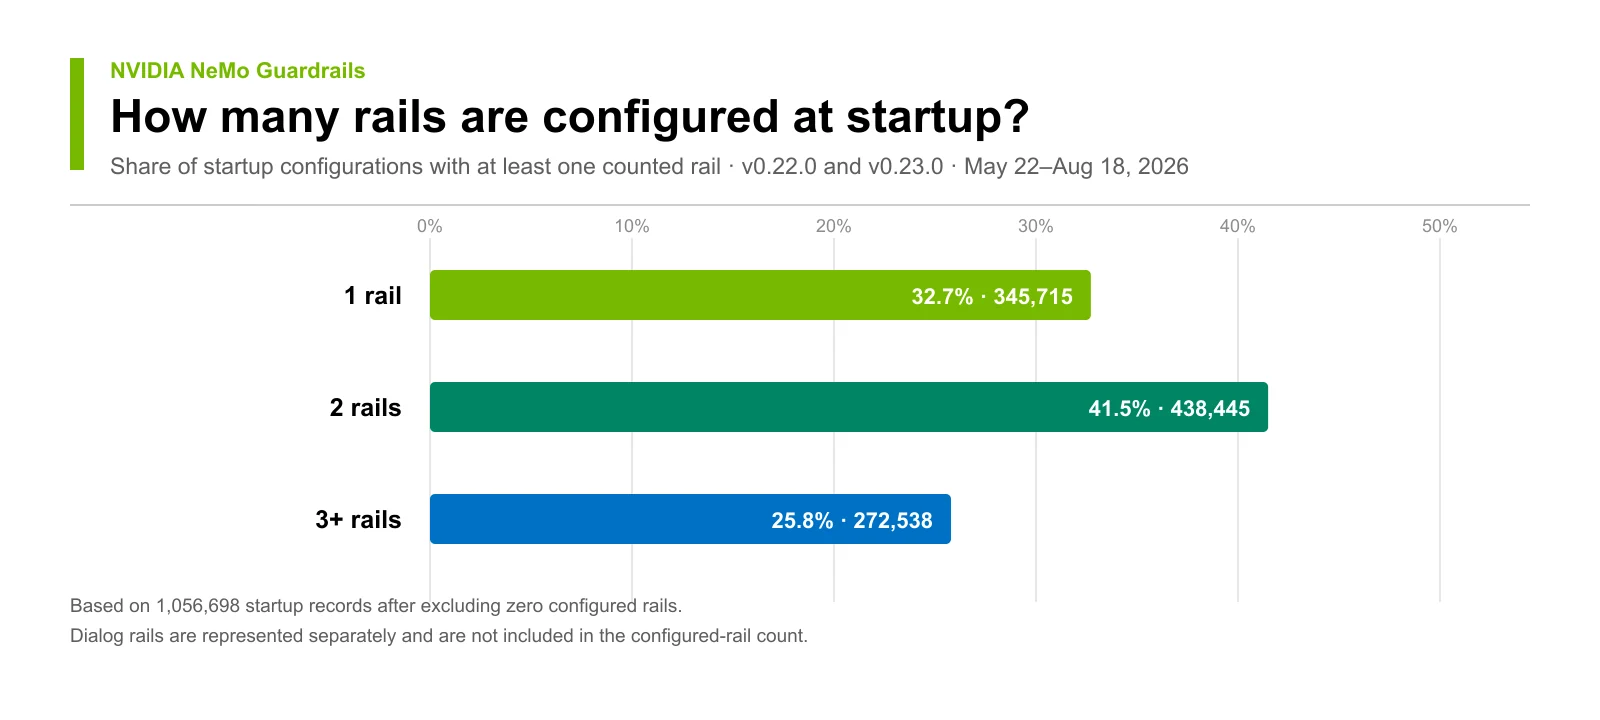
I conteggi delle sessioni sono stime, e una sessione può usare più tipi di rail o funzionalità. Fai riferimento ai [dati aggregati](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/_static/images/community-telemetry/0.22.0-0.23.0.json) e alla [metodologia](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/_static/images/community-telemetry/README.md) per le definizioni e i limiti di conteggio.
</details>
## Telemetria e privacy
La libreria invia telemetria anonima sull'utilizzo che esclude prompt, completamenti, nomi dei modelli, credenziali ed endpoint. Imposta `NEMO_GUARDRAILS_NO_USAGE_STATS=1` per rinunciare. Questo non disabilita le chiamate configurate ai modelli o ai servizi dei guardrail, che possono inviare contenuti a tali endpoint. Fai riferimento a [telemetria e privacy](https://github.com/nvidia-nemo/guardrails/blob/develop/docs/telemetry.mdx) per i dettagli e altre opzioni di rinuncia.
Gli endpoint di terze parti hanno termini e pratiche sulla privacy separati. La libreria NVIDIA NeMo Guardrails può utilizzare endpoint di inferenza come NVIDIA Build (`build.nvidia.com`). Se utilizzi NVIDIA Build o un altro endpoint di terze parti, i termini di servizio e le pratiche sulla privacy di tale endpoint si applicano indipendentemente dalla libreria. Qualsiasi opt-out dalla telemetria nella libreria NVIDIA NeMo Guardrails non si estende all'endpoint scelto. NVIDIA Build è destinato esclusivamente alla valutazione e ai test e non deve essere utilizzato in ambienti di produzione. Non inviare informazioni riservate o dati personali quando utilizzi NVIDIA Build.
## Contribuire e supporto
Fai riferimento a [CONTRIBUTING.md](https://github.com/nvidia-nemo/guardrails/blob/develop/CONTRIBUTING.md) e [AI_POLICY.md](https://github.com/nvidia-nemo/guardrails/blob/develop/AI_POLICY.md) per i requisiti di contribuzione. Poni domande sull'utilizzo in [GitHub Discussions](https://github.com/NVIDIA-NeMo/Guardrails/discussions) e segui [SECURITY.md](https://github.com/nvidia-nemo/guardrails/blob/develop/SECURITY.md) per segnalare vulnerabilità.
La libreria è distribuita con licenza [Apache License, Version 2.0](https://github.com/nvidia-nemo/guardrails/blob/develop/LICENSE-Apache-2.0.txt). Se la utilizzi nella ricerca, cita il [paper EMNLP 2023](https://aclanthology.org/2023.emnlp-demo.40).





