Pyison
Pyison è un tarpit per i webcrawler AI
Introduzione
- Come tutti i web crawler, i bot AI richiedono pagine dai server web e poi seguono i collegamenti sulla pagina verso altre pagine. In questo modo, possono creare un indice di un intero sito web.
- A differenza di altri web crawler, però, i bot AI presentano alcune problematiche uniche
- Gli amministratori del server possono configurare un file robots.txt, che dice ai web crawler quali pagine dovrebbero e non dovrebbero scansionare.
- Alcuni crawler AI sono stati trovati a ignorare questo file. Ci sono preoccupazioni per la privacy e il copyright nel permettere a questi bot di utilizzare i dati di un sito web per addestrare LLM, specialmente quando l'utente ha esplicitamente rinunciato alla scansione.
- Alcuni crawler ignorano anche la limitazione della frequenza. Quando richiedono pagine il più velocemente possibile, possono mettere un carico significativo su un server web.
- Ecco Pyison. Come altri tarpit per crawler AI (Nepenthes, Iocane), Pyison fornisce ai web crawler una lista infinita di collegamenti ad altre pagine del suo sito. Questo intrappola i crawler in un unico sito, dove navigheranno all'infinito in un mare di link in continua crescita.
- Mantenere i crawler AI bloccati in un posto impedisce loro di indicizzare altre parti del sito che il proprietario potrebbe non voler fornire agli LLM.
- Allo stesso tempo, queste pagine possono contenere tonnellate di testo inutile. Quando gli LLM incorporano questo testo nei loro modelli, possono essere gradualmente "avvelenati" poiché l'input casuale renderà le loro risposte meno coerenti.
Motivazioni
- Creare software utile per affrontare l'aumento del furto di contenuti da parte degli LLM
- Risolvere problemi nei tarpit AI esistenti:
- Generare testo casuale senza l'uso di una catena di Markov, LLM o campioni di scrittura esistenti
- Non discriminare i bot AI tramite l'header User-Agent, poiché i crawler spesso si travestono da utenti normali
- Progettare un sito dall'aspetto realistico simile a un blog per evitare il rilevamento
- Creare un framework estremamente personalizzabile per permettere ulteriori configurazioni
- Fornire una soluzione che possa integrarsi facilmente in un sito web esistente
- Supporta ma non richiede proxy inversi/server web specifici, fornisce configurazione di sotto-percorso con un'impostazione di document root
- Eseguire con un'impronta ridotta piuttosto che un intero CMS o server web ricco di funzionalità
Specifiche Tecniche
- Questo progetto esegue un server web dinamico utilizzando la libreria HTTPServer di Python
- Le frasi sono prodotte da un mix 50/50 tra parole inglesi casuali e "stop words"
- Pyison utilizza un salt globale e un URL di pagina per inizializzare il suo RNG. Questo garantisce che se i crawler eseguono un "controllo di sanità" ricaricando una pagina, sarà la stessa dell'ultima volta che l'hanno controllata. Allo stesso tempo, server diversi dovrebbero usare semi globali diversi in modo che non tutti i siti che usano Pyison appaiano uguali.
- È possibile generare un numero illimitato di pagine, poiché Pyison non sta effettivamente creando alcun file permanente. È un server web dinamico, quindi genera semplicemente HTML e lo invia al client.
- L'uso di tag di contenuto HTML, formattazione CSS e immagini dovrebbe far sembrare il sito un po' più realistico a un crawler.
- È possibile configurare l'output di Pyison senza riscrivere il programma, modificando i file di configurazione, statici e template
- Pyison risponde alle richieste POST e PUT errate con un 404 nel caso in cui i crawler testino che quei verbi HTTP siano configurati
Per Iniziare
-
Clona questo progetto in una cartella locale
-
Modifica le impostazioni nel file config/config.json
- Imposta il
random-seed su un numero casuale!
- Imposta il numero di
port per il server
- Vedi la sezione Configurazione per maggiori informazioni
-
(Opzionale ma consigliato) Aggiorna il template HTML, CSS, immagini e robots.txt a tuo piacimento
- Questo progetto è più efficace se le pagine appaiono diverse, cosa che può essere fatta variando la struttura HTML e CSS. Riorganizza e rinomina alcune cose, o riscrivilo completamente.
-
(Opzionale) Modifica il robots.txt se vuoi cambiare quali bot sono interessati
-
Configura l'ambiente del server con uno dei metodi seguenti
-
Metti il server dietro un Proxy Inverso
Esecuzione Locale
- Installa nltk
- Esegui Pyison
- Verifica che sia in esecuzione
- Apri
http://localhost:<numero porta> in un browser
Docker
Con docker compose
Con docker run
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm ghcr.io/jonaslong/pyison:main
- (Opzionale) Rimuovi il flag
--rm per mantenere il container
Compilazione dal sorgente
- Clona il repository localmente
docker build -t pyison:latest .- Esegui il container con
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm pyison:latest
Proxy Inverso
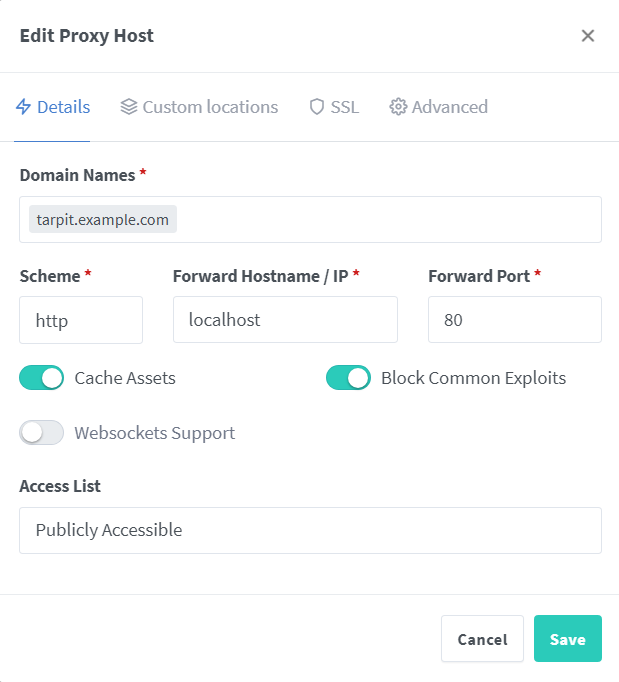
È altamente consigliato utilizzare un proxy inverso per servire questo contenuto. Può ridurre il carico del server memorizzando nella cache le pagine e introducendo limiti di frequenza, oltre a servire il contenuto su https e proteggere da alcuni exploit di base del server web.
Considerazioni
- Questi esempi usano Nginx Proxy Manager, ma qualsiasi software proxy inverso dovrebbe funzionare
- Pyison supporta le impostazioni SSL più rigorose di NPM
- NPM dovrebbe passare l'header HTTP
User-Agent da NPM al server Pyison senza alcuna configurazione speciale. Usa proxy_pass_header User-Agent; se necessario.
Configurazione Sottodominio Indipendente
Configurazione Sotto-percorso
-
Per usare Pyison in un sotto-percorso, usa la seguente configurazione di location
# Handles the root page ("example.com/tarpit")
location /tarpit {
    proxy_pass http://localhost:80;
}

# Handles all sub-pages ("example.com/tarpit/a" and "example.com/tarpit/a/b")
location /tarpit/ {
    proxy_pass http://localhost:80;
}
 jonaslong/pyison