
 jev-sec/jev-ids
Sistema di Rilevamento delle Intrusioni (IDS) ultra-veloce ed efficiente in termini di token basato su Jev di TypeSafe.


Rilevamento delle intrusioni in una sola richiesta. Mostra a Jev di TypeSafe un flusso di rete e cinque esempi etichettati. Risponde se il flusso è un attacco e di quale tipo, in mezzo secondo, senza testo da analizzare.
Jev IDS è stato testato su NSL-KDD, un benchmark di riferimento della comunità della cybersecurity, contro un LLM allo stato dell'arte (Gemini 3.6 Flash su Vertex AI), un classico modello di machine learning (Random Forest) e uno non supervisionato (Isolation Forest): 2.000 flussi, tre seed, k da 0 a 8 esempi per categoria. Dati gli stessi cinque esempi (k = 1), Jev IDS è stato:
L'LLM è il rilevatore migliore sull'F1: 0,880 contro lo 0,856 di Jev a k = 1, e in vantaggio a ogni k (McNemar p < 0,001), perché intercetta più attacchi dei tipi mostrati negli esempi. Jev è il secondo migliore e sugli attacchi zero-day, tipi assenti dagli esempi, intercetta più dell'LLM da k = 1 a k = 8 (0,747 contro 0,713 a k = 1). I numeri, le figure e i loro limiti sono in Evidenze e limiti e docs/results.md.
Leggi il loop · Il template della richiesta · Glossario
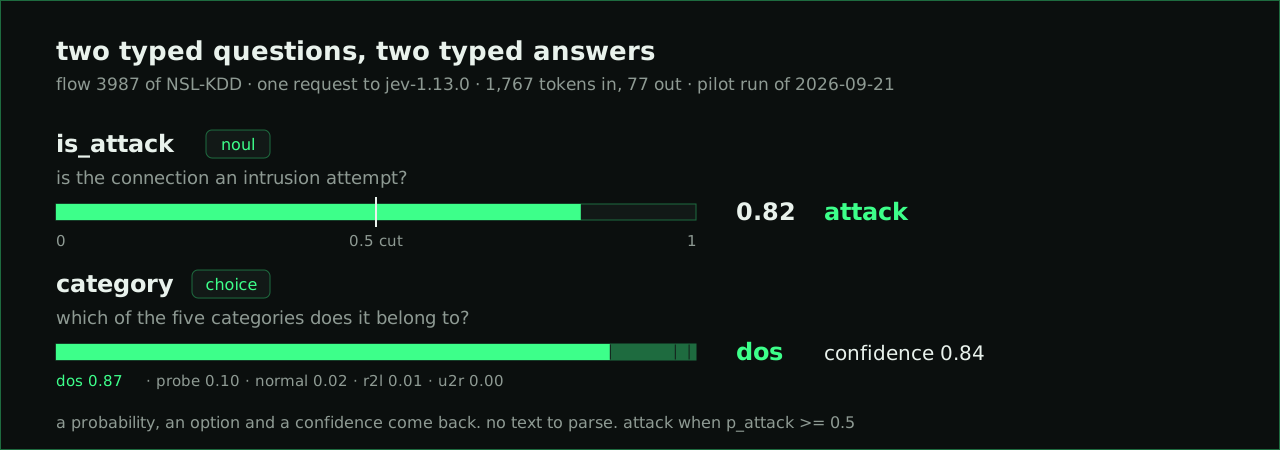
Jev è un System One Model. Invece di scrivere testo, legge uno state e risponde a domande tipizzate su di esso con probabilità. Jev IDS mette un flusso nello state, accanto alle istruzioni, ai nomi delle colonne, alle cinque descrizioni delle categorie e agli esempi etichettati, e pone due domande. is_attack torna come probabilità. category torna come una delle cinque opzioni con una confidenza. Il verdetto è attacco quando la probabilità raggiunge 0,5.
Ogni richiesta segue lo stesso percorso:
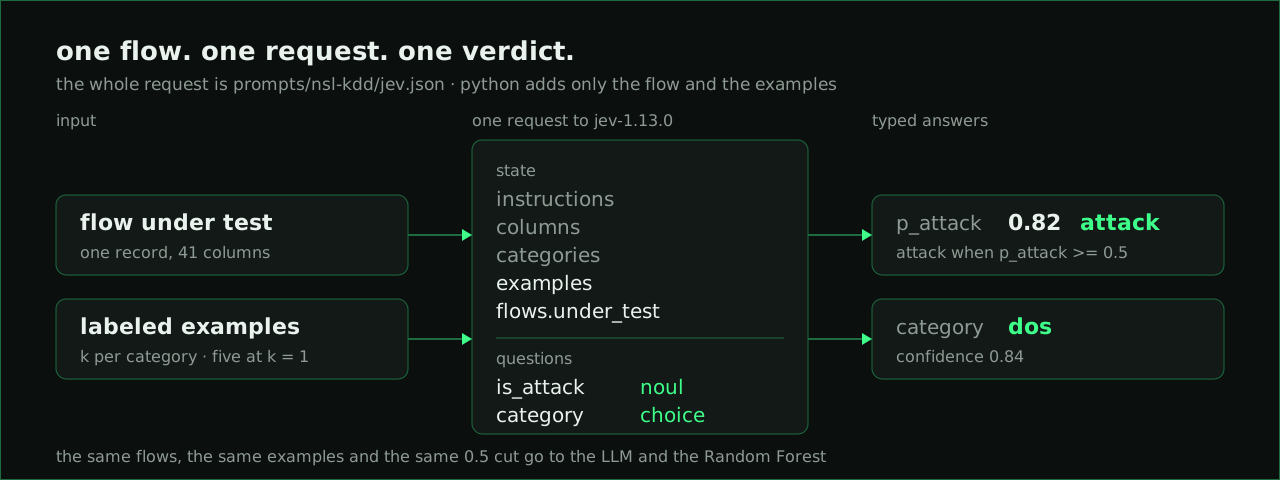
L'intera richiesta è un unico file, prompts/nsl-kdd/jev.json. Python aggiunge solo il flusso e gli esempi, e lo sha256 del file viaggia in ogni riga di predizione come prompt_hash, così le esecuzioni che hanno chiesto cose diverse non vengono mai confrontate come equivalenti. Gli esempi sono etichettati solo per categoria: nomi di attacchi come neptune non raggiungono mai un modello.
Gli stessi flussi, esempi e soglia di 0,5 vanno a due baseline: un LLM tramite un agente Agno con uno schema di output JSON (Gemini 3.6 Flash tramite Vertex AI nel paper; GPT-5.6 tramite il backend ChatGPT Codex o DeepSeek come alternative) e una Random Forest di scikit-learn addestrata sugli stessi esempi. Una terza baseline, un'Isolation Forest addestrata solo sui flussi benigni del pool, non vede mai un esempio: è il riferimento non supervisionato, solo a k = all.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Scarica NSL-KDD in data/raw/nsl-kdd/ e preparalo una volta:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
Lo split smoke è di cinque flussi. L'esecuzione scrive results/<timestamp>-nsl-kdd-jev-smoke/ con config.json, una riga JSON per flusso in predictions.jsonl (il verdetto, la verità, p_attack, la categoria, la confidenza, la latenza e il report dei token del gateway) e le risposte grezze in responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k è il numero di esempi etichettati per categoria. k = 1 con cinque categorie significa cinque esempi, e all significa l'intero pool. metrics stampa una riga CSV per rilevatore e k con F1, recall sugli attacchi zero-day (novel nel codice) e per categoria, PR-AUC e ROC-AUC di p_attack, token, latenza e costo. compare accoppia due esecuzioni flusso per flusso ed esegue il test di McNemar sulle coppie discordanti, perché solo i flussi su cui due rilevatori sono in disaccordo li distinguono. Il costo è calcolato offline come token moltiplicati per i prezzi di listino in prices.json, allo stesso modo per ogni rilevatore.
docs/protocol.md fissa gli input (lo split paper da 2.000 flussi, i prompt, gli id dei modelli, i prezzi) e make paper esegue i quattro rilevatori su quello split in results/paper/ e scrive results/paper/summary.csv. Ogni rilevatore ha il proprio target (make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest), così possono girare in terminali separati; l'LLM è quello lento. make paper-llm esegue Gemini 3.6 Flash su Vertex AI come cinque processi paralleli, uno per k (make -j5 paper-llm); un errore di quota o un timeout è una riga di errore, e uv run jev-ids redo-errors results/paper/<run> giudica di nuovo quei flussi sul posto. Le tabelle e le figure complete sono in docs/results.md.

