Modular framework for discovering and analyzing open directories on the web. Crawls URLs, extracts content, applies YARA/ClamAV scanning, and outputs results to MISP, SQLite, or console for threat intelligence. Translation: Framework modulare per scoprire e analizzare directory aperte sul web. Scansiona URL, estrae contenuti, applica scansione YARA/ClamAV e produce risultati in MISP, SQLite o console per l'intelligence sulle minacce.

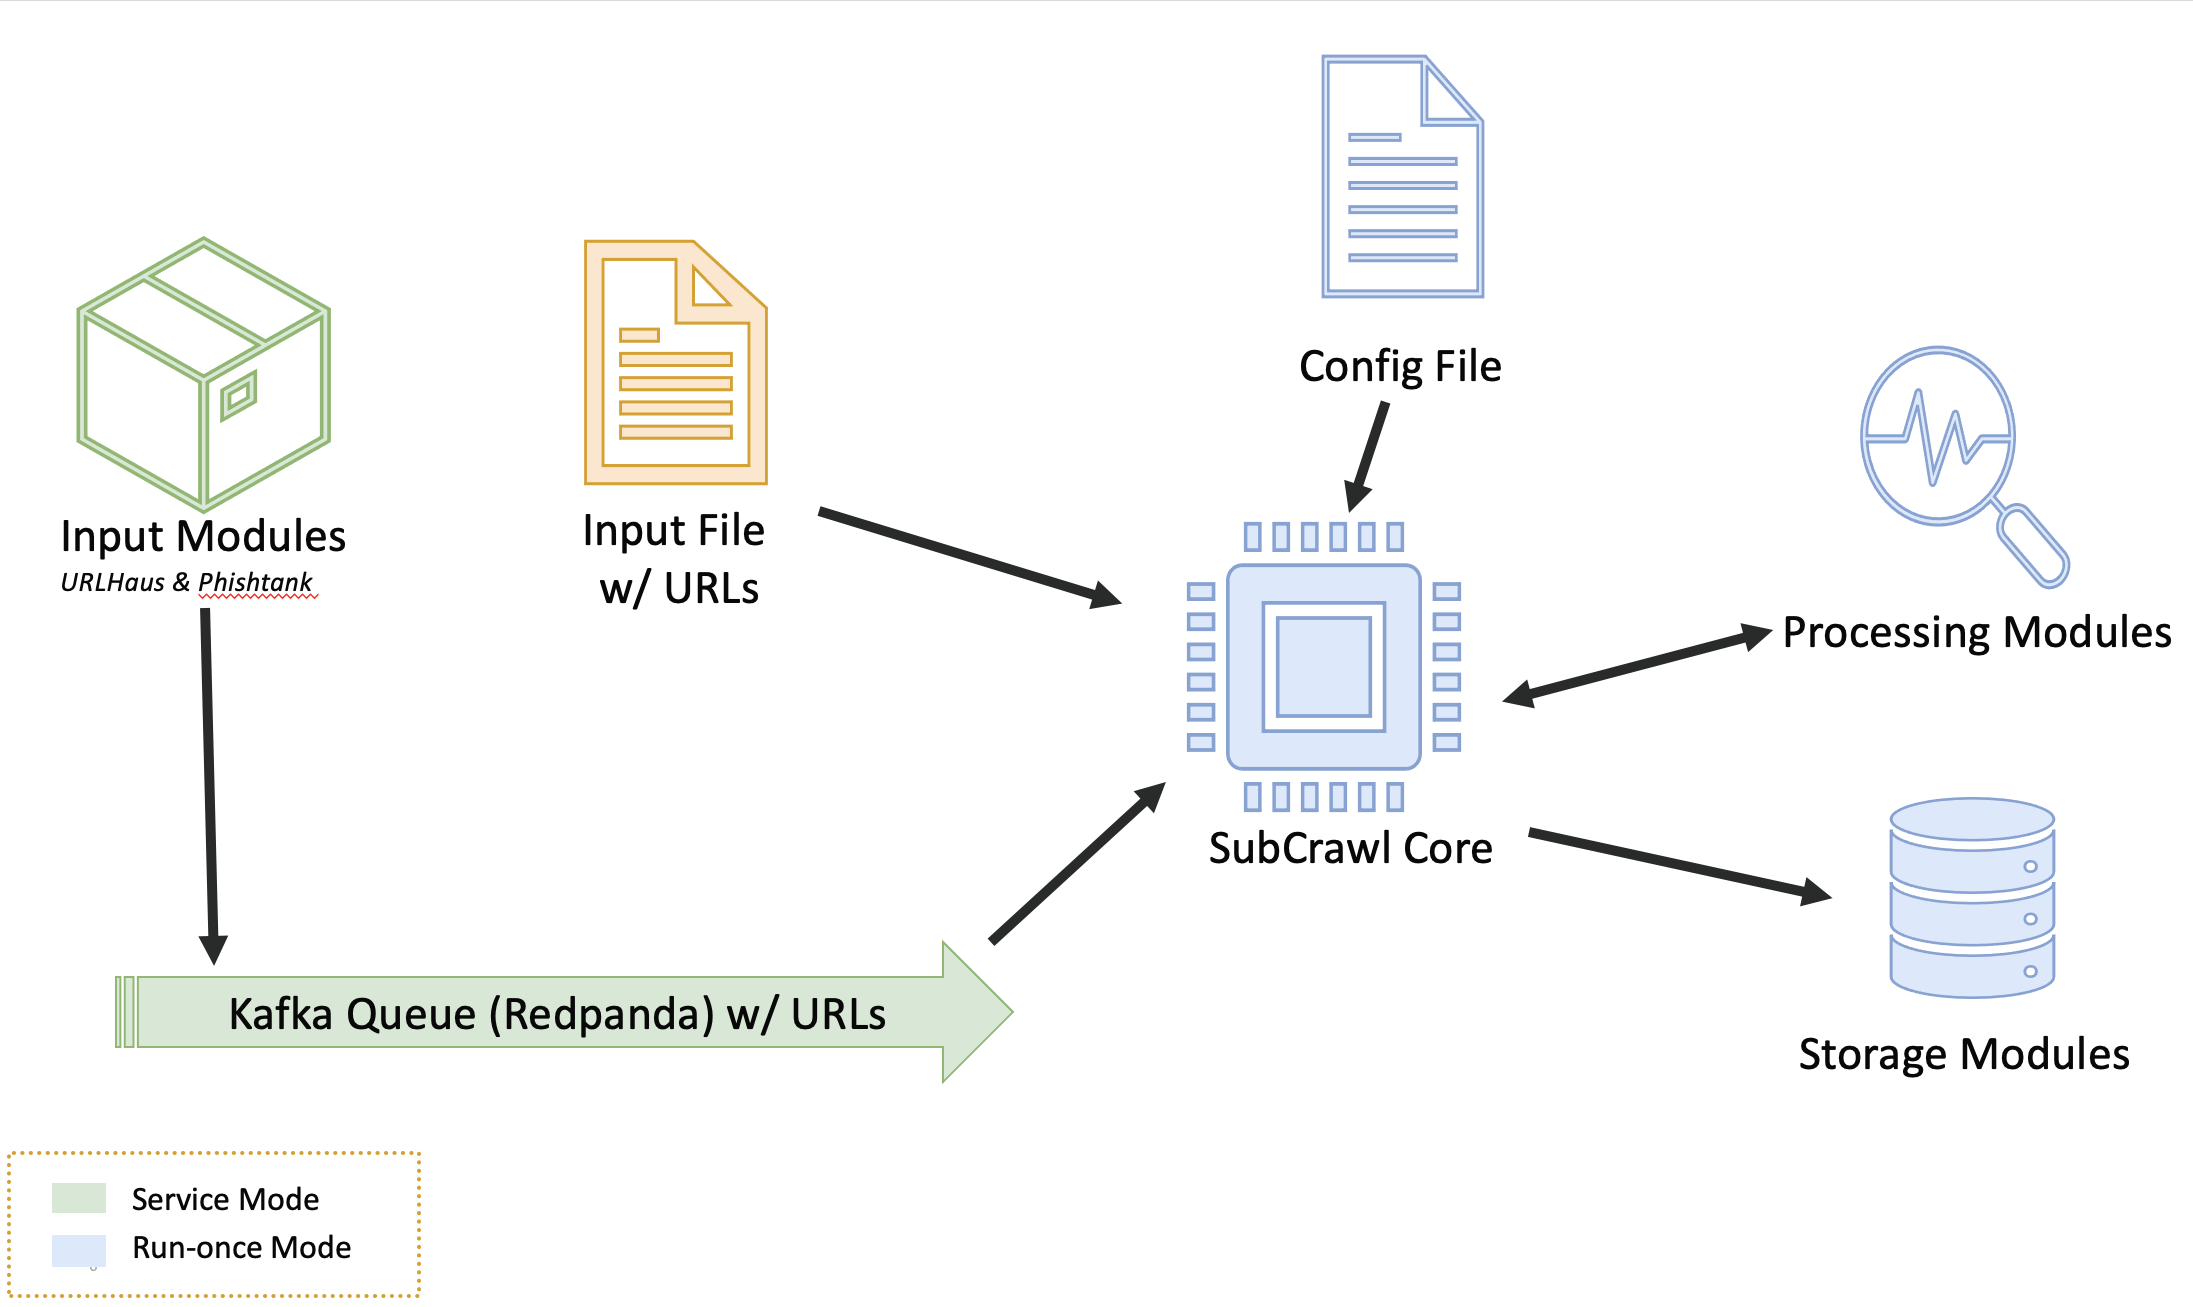
SubCrawl è un framework sviluppato da Patrick Schläpfer, Josh Stroschein e Alex Holland del team Threat Research di HP Inc. SubCrawl è progettato per trovare, scansionare e analizzare directory aperte. Il framework è modulare, composto da quattro componenti: moduli di input, moduli di elaborazione, moduli di output e il motore di crawling principale. Gli URL sono i valori di input primari, che il framework analizza e aggiunge a un sistema di coda prima di eseguirne il crawling. L'analisi degli URL è un primo passo importante, poiché prende un URL inviato e genera URL aggiuntivi da scansionare rimuovendo le sottodirectory, una alla volta, finché non ne rimangono. Questo processo garantisce un tentativo di scansione più completo di un server web e può portare alla scoperta di contenuti aggiuntivi. In particolare, SubCrawl non utilizza un metodo di forza bruta per la scoperta degli URL. Tutti i contenuti scansionati provengono dagli URL di input, dal processo di analisi dell'URL e dalla scoperta durante il crawling. Quando viene scoperta una directory aperta, il motore di crawling estrae i collegamenti dalla directory per la valutazione. Il motore di crawling determina se il collegamento è un'altra directory o un file. Le directory vengono aggiunte alla coda di crawling, mentre i file vengono sottoposti a ulteriori analisi da parte dei moduli di elaborazione. I risultati vengono generati e memorizzati per ogni URL scansionato, come gli hash SHA256 e fuzzy del contenuto, se è stata trovata una directory aperta, o le corrispondenze con le regole YARA. Infine, i dati dei risultati vengono elaborati secondo uno o più moduli di output, di cui attualmente ce ne sono tre. Il primo fornisce l'integrazione con MISP, il secondo stampa semplicemente i dati sulla console e il terzo memorizza i dati in un database SQLite. Poiché il framework è modulare, non solo è facile configurare quali moduli di input, elaborazione e output si desiderano, ma è anche semplice sviluppare nuovi moduli.
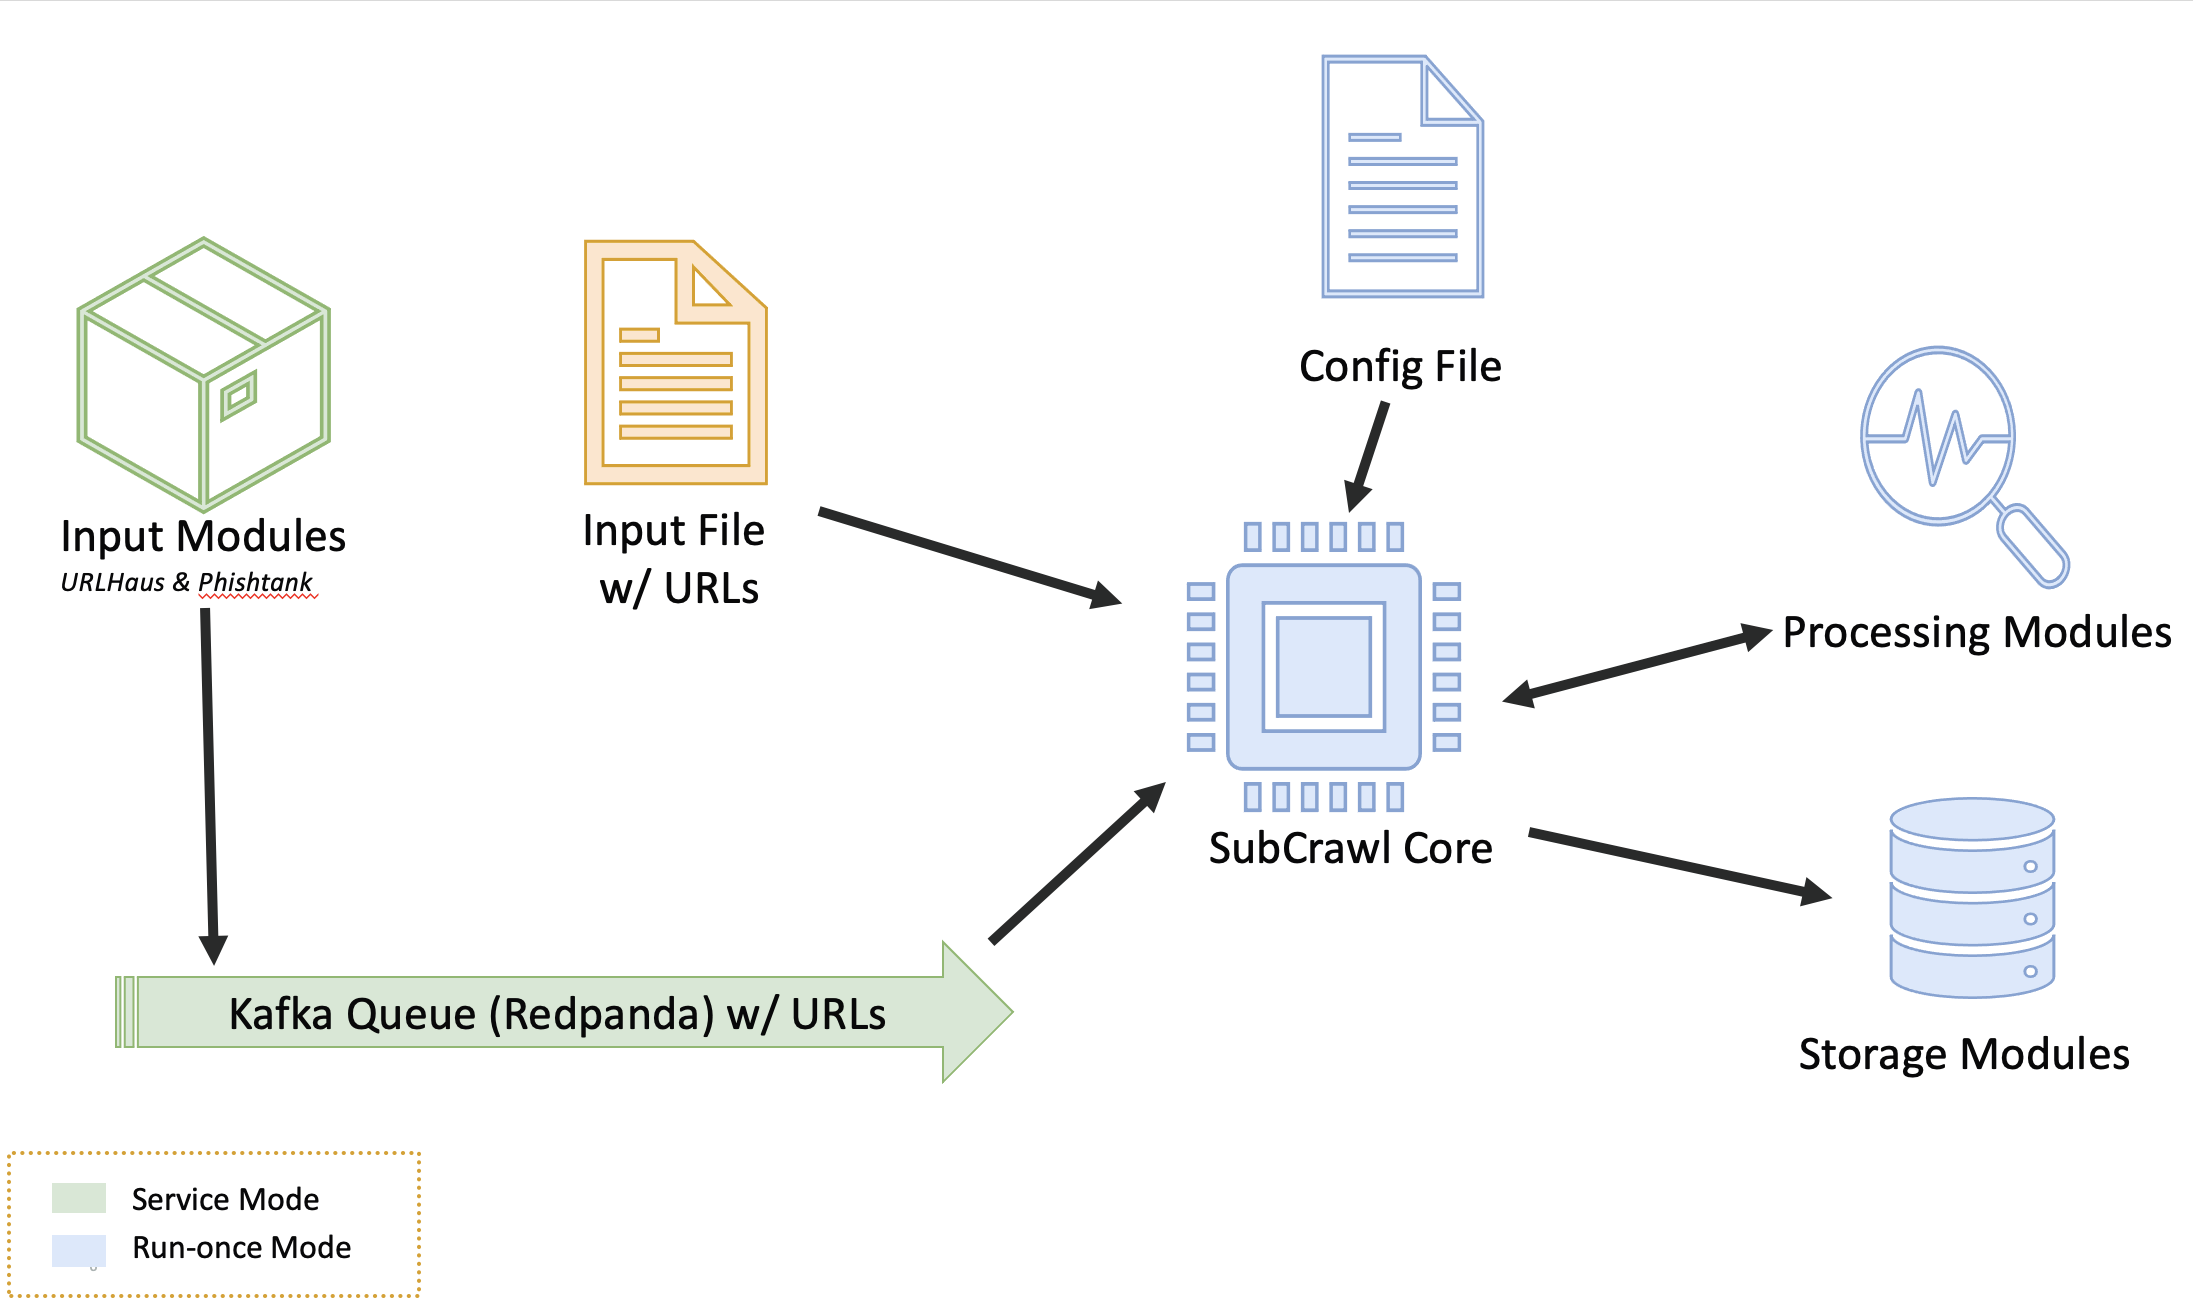 Figura 1 - Architettura di SubCrawl
SubCrawl supporta due diverse modalità operative. In primo luogo, SubCrawl può essere avviato in modalità run-once. In questa modalità, l'utente fornisce gli URL da scansionare in un file in cui ogni valore di input è separato da un'interruzione di riga. La seconda modalità operativa è la modalità servizio. In questa modalità, SubCrawl viene eseguito in background e si basa sui moduli di input per fornire gli URL da scansionare. La Figura 1 mostra una panoramica dell'architettura di SubCrawl. I componenti utilizzati in entrambe le modalità operative sono blu, i componenti della modalità run-once sono gialli e i componenti della modalità servizio sono verdi.
In base alla modalità di esecuzione scelta, devono essere soddisfatti altri prerequisiti.
SubCrawl è scritto in Python3. Inoltre, ci sono diversi pacchetti necessari prima di eseguire SubCrawl. Il seguente comando può essere utilizzato per installare tutti i pacchetti richiesti prima di eseguire SubCrawl. Dalla directory crawler, esegui il seguente comando:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Se SubCrawl viene avviato in modalità servizio, è possibile farlo utilizzando Docker. Per questo motivo, è richiesta l'installazione di Docker e Docker Compose. Buone istruzioni di installazione per questo si trovano direttamente sul sito web Docker.com.
SubCrawl dispone di un aiuto integrato tramite l'argomento -h/--help o semplicemente eseguendo lo script senza alcun argomento.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Harvesting the Open Web ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Questa modalità è adatta se si desidera scansionare rapidamente una quantità gestibile di domini. A tal fine, gli URL da scansionare devono essere salvati in un file, che funge quindi da input per il crawler. Di seguito è riportato un esempio di esecuzione in modalità run-once, nota che l'argomento -f viene utilizzato con un percorso a un file.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
Con la modalità servizio è possibile scansionare una quantità maggiore di domini e salvare i risultati. In base al modulo di archiviazione selezionato, i dati possono quindi essere analizzati e valutati in modo più dettagliato. Per rendere l'esecuzione della modalità servizio il più semplice possibile per l'utente, abbiamo integrato tutte le funzionalità in un'immagine Docker. In modalità servizio, i domini da scansionare vengono ottenuti tramite i moduli di input. Per impostazione predefinita, nuovi URL di malware e phishing vengono scaricati da URLhaus e PhishTank e messi in coda per la scansione. I moduli di elaborazione e archiviazione desiderati possono essere inseriti direttamente nel config.yml. Per impostazione predefinita, sono attivati i seguenti moduli di elaborazione, che utilizzano l'archiviazione SQLite:
Oltre al modulo di archiviazione SQLite, è stata sviluppata una semplice interfaccia web che consente di visualizzare e gestire i domini e gli URL scansionati.
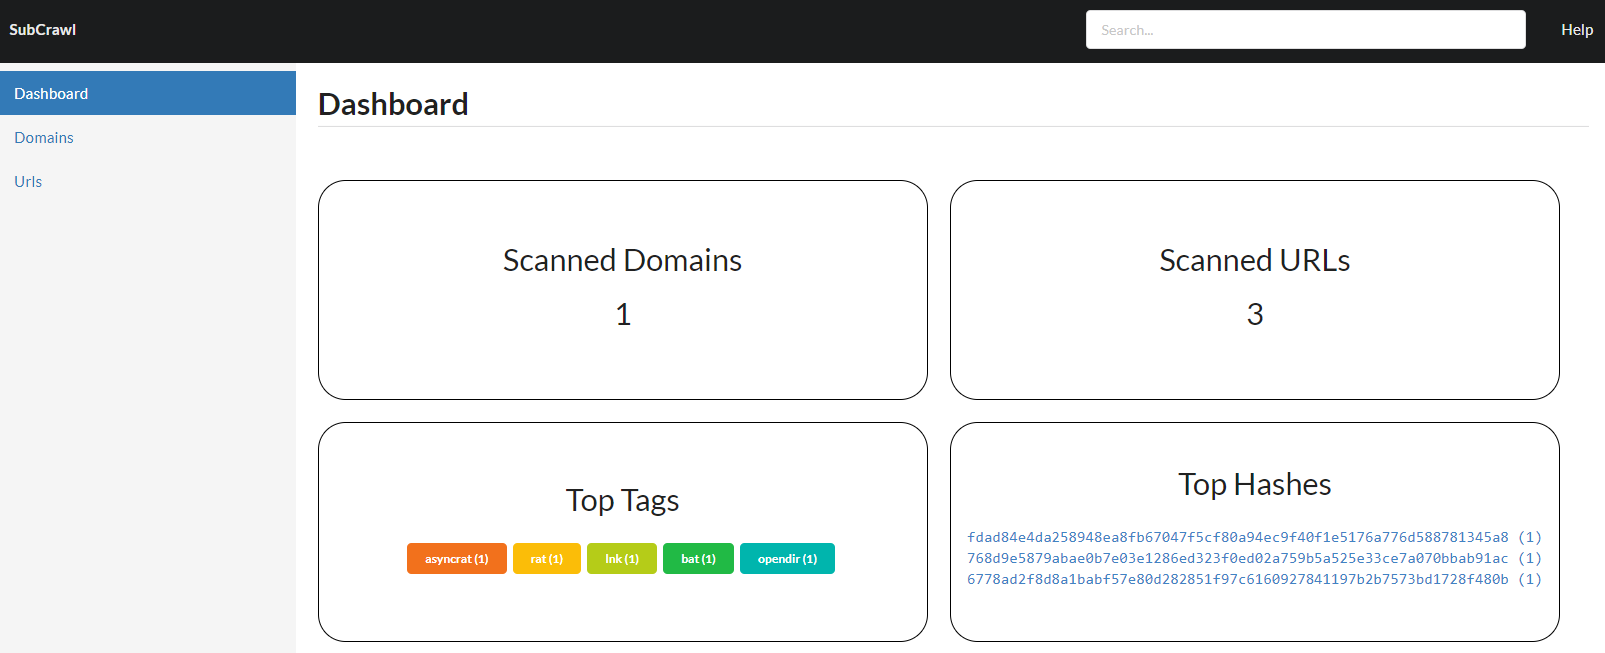
Tuttavia, se questa interfaccia non è sufficiente per la successiva valutazione dei dati, il modulo di archiviazione MISP può essere attivato in alternativa o in aggiunta. Le impostazioni corrispondenti devono essere effettuate in config.yml nella sezione MISP.
I due comandi seguenti sono sufficienti per clonare il repository GIT, creare il contenitore Docker e avviarlo direttamente. Successivamente, l'interfaccia web è raggiungibile all'indirizzo https://localhost:8000/. Tieni presente che una volta avviati i contenitori, i moduli di input inizieranno ad aggiungere URL alla coda di elaborazione e il motore inizierà a eseguire il crawling degli host.

