 hahwul/urx
Estrae URL dagli archivi OSINT per approfondimenti sulla sicurezza

Estrae URL dagli archivi OSINT per ottenere informazioni di sicurezza.




Urx è uno strumento da riga di comando progettato per raccogliere URL dagli archivi OSINT, come la Wayback Machine e Common Crawl. Realizzato in Rust per garantire efficienza, sfrutta l'elaborazione asincrona per interrogare rapidamente più fonti di dati. Questo strumento semplifica il processo di raccolta di informazioni sugli URL per un dominio specificato, fornendo un set di dati completo che può essere utilizzato per vari scopi, tra cui test e analisi di sicurezza.
--cdx-endpoint URL, senza bisogno di modifiche al codice-H, --cookie e --user-agent si applicano a ogni richiesta che urx effettua verso il target (--check-status, --extract-links, --extract-js-endpoints, --expand-specs) e non vengono mai deliberatamente inviati a un archivio--match-regex / --filter-regex)--meta-*): filtra per data di prima/ultima cattura, tipo MIME registrato e stato registrato in modo uniforme su ogni provider, dopo la raccoltaurx example.com/shop inserisce l'ambito direttamente nella query CDX (url=example.com/shop*), così un sottoalbero di un sito di grandi dimensioni costa una frazione dell'intero indice invece di essere filtrato lato client--scope-file): la lista *.example.com / !admin.example.com di un programma usata così com'è, ripetibile e unita, con le esclusioni che vincono sempre--dedup-similar)wordlist — i segmenti di percorso e i nomi dei parametri da cui è costruito il target, con id, hash e date esclusi--params (l'inventario completo dei parametri del target), --params-by-endpoint (quale endpoint accetta cosa) e --fuzz-placeholder FUZZ (un URL templato per ogni firma di parametro, pronto per ffuf o dalfox)first_seen, last_seen, mime, archive_status e digest vengono restituiti con ogni URL segnalato da un archivio CDX, senza costi di rete aggiuntivi--stream): gli URL vengono scritti man mano che ciascun provider li segnala, così una pipeline inizia a funzionare immediatamente invece di attendere l'archivio più lento--archive-body), così le pagine che non esistono più rivelano comunque i link che contenevano — una richiesta per ogni corpo distinto, grazie alla deduplicazione tramite digest CDX--extract-js-endpoints, analizza anche il JavaScript archiviato: un bundle denominato con l'hash di build restituisce 404 nel momento in cui il sito viene ridistribuito, e l'archivio è l'unico posto dove la sua superficie API esiste ancora--archive-body-dir) come corpus da cercare per ciò che nessun estrattore di link cerca — commenti degli sviluppatori, credenziali inline, hostname interni — senza richieste aggiuntive--expand-specs): documenti OpenAPI 3.x, Swagger 2.0 e introspezione GraphQL, in JSON o YAML, trasformati in ogni route che descrivono — una richiesta acquista l'intera superficie documentata--check-status registra anche Location, Content-Length e Content-Type, e --check-title aggiunge il HTML--archived-discovery): ogni versione distinta conservata dalla Wayback Machine, così un Disallow: del 2015 nomina ancora i percorsi che il sito ha smesso di menzionareurx cache per ispezionare e mantenere la cache: stats, list, prune, drop <domain>, clear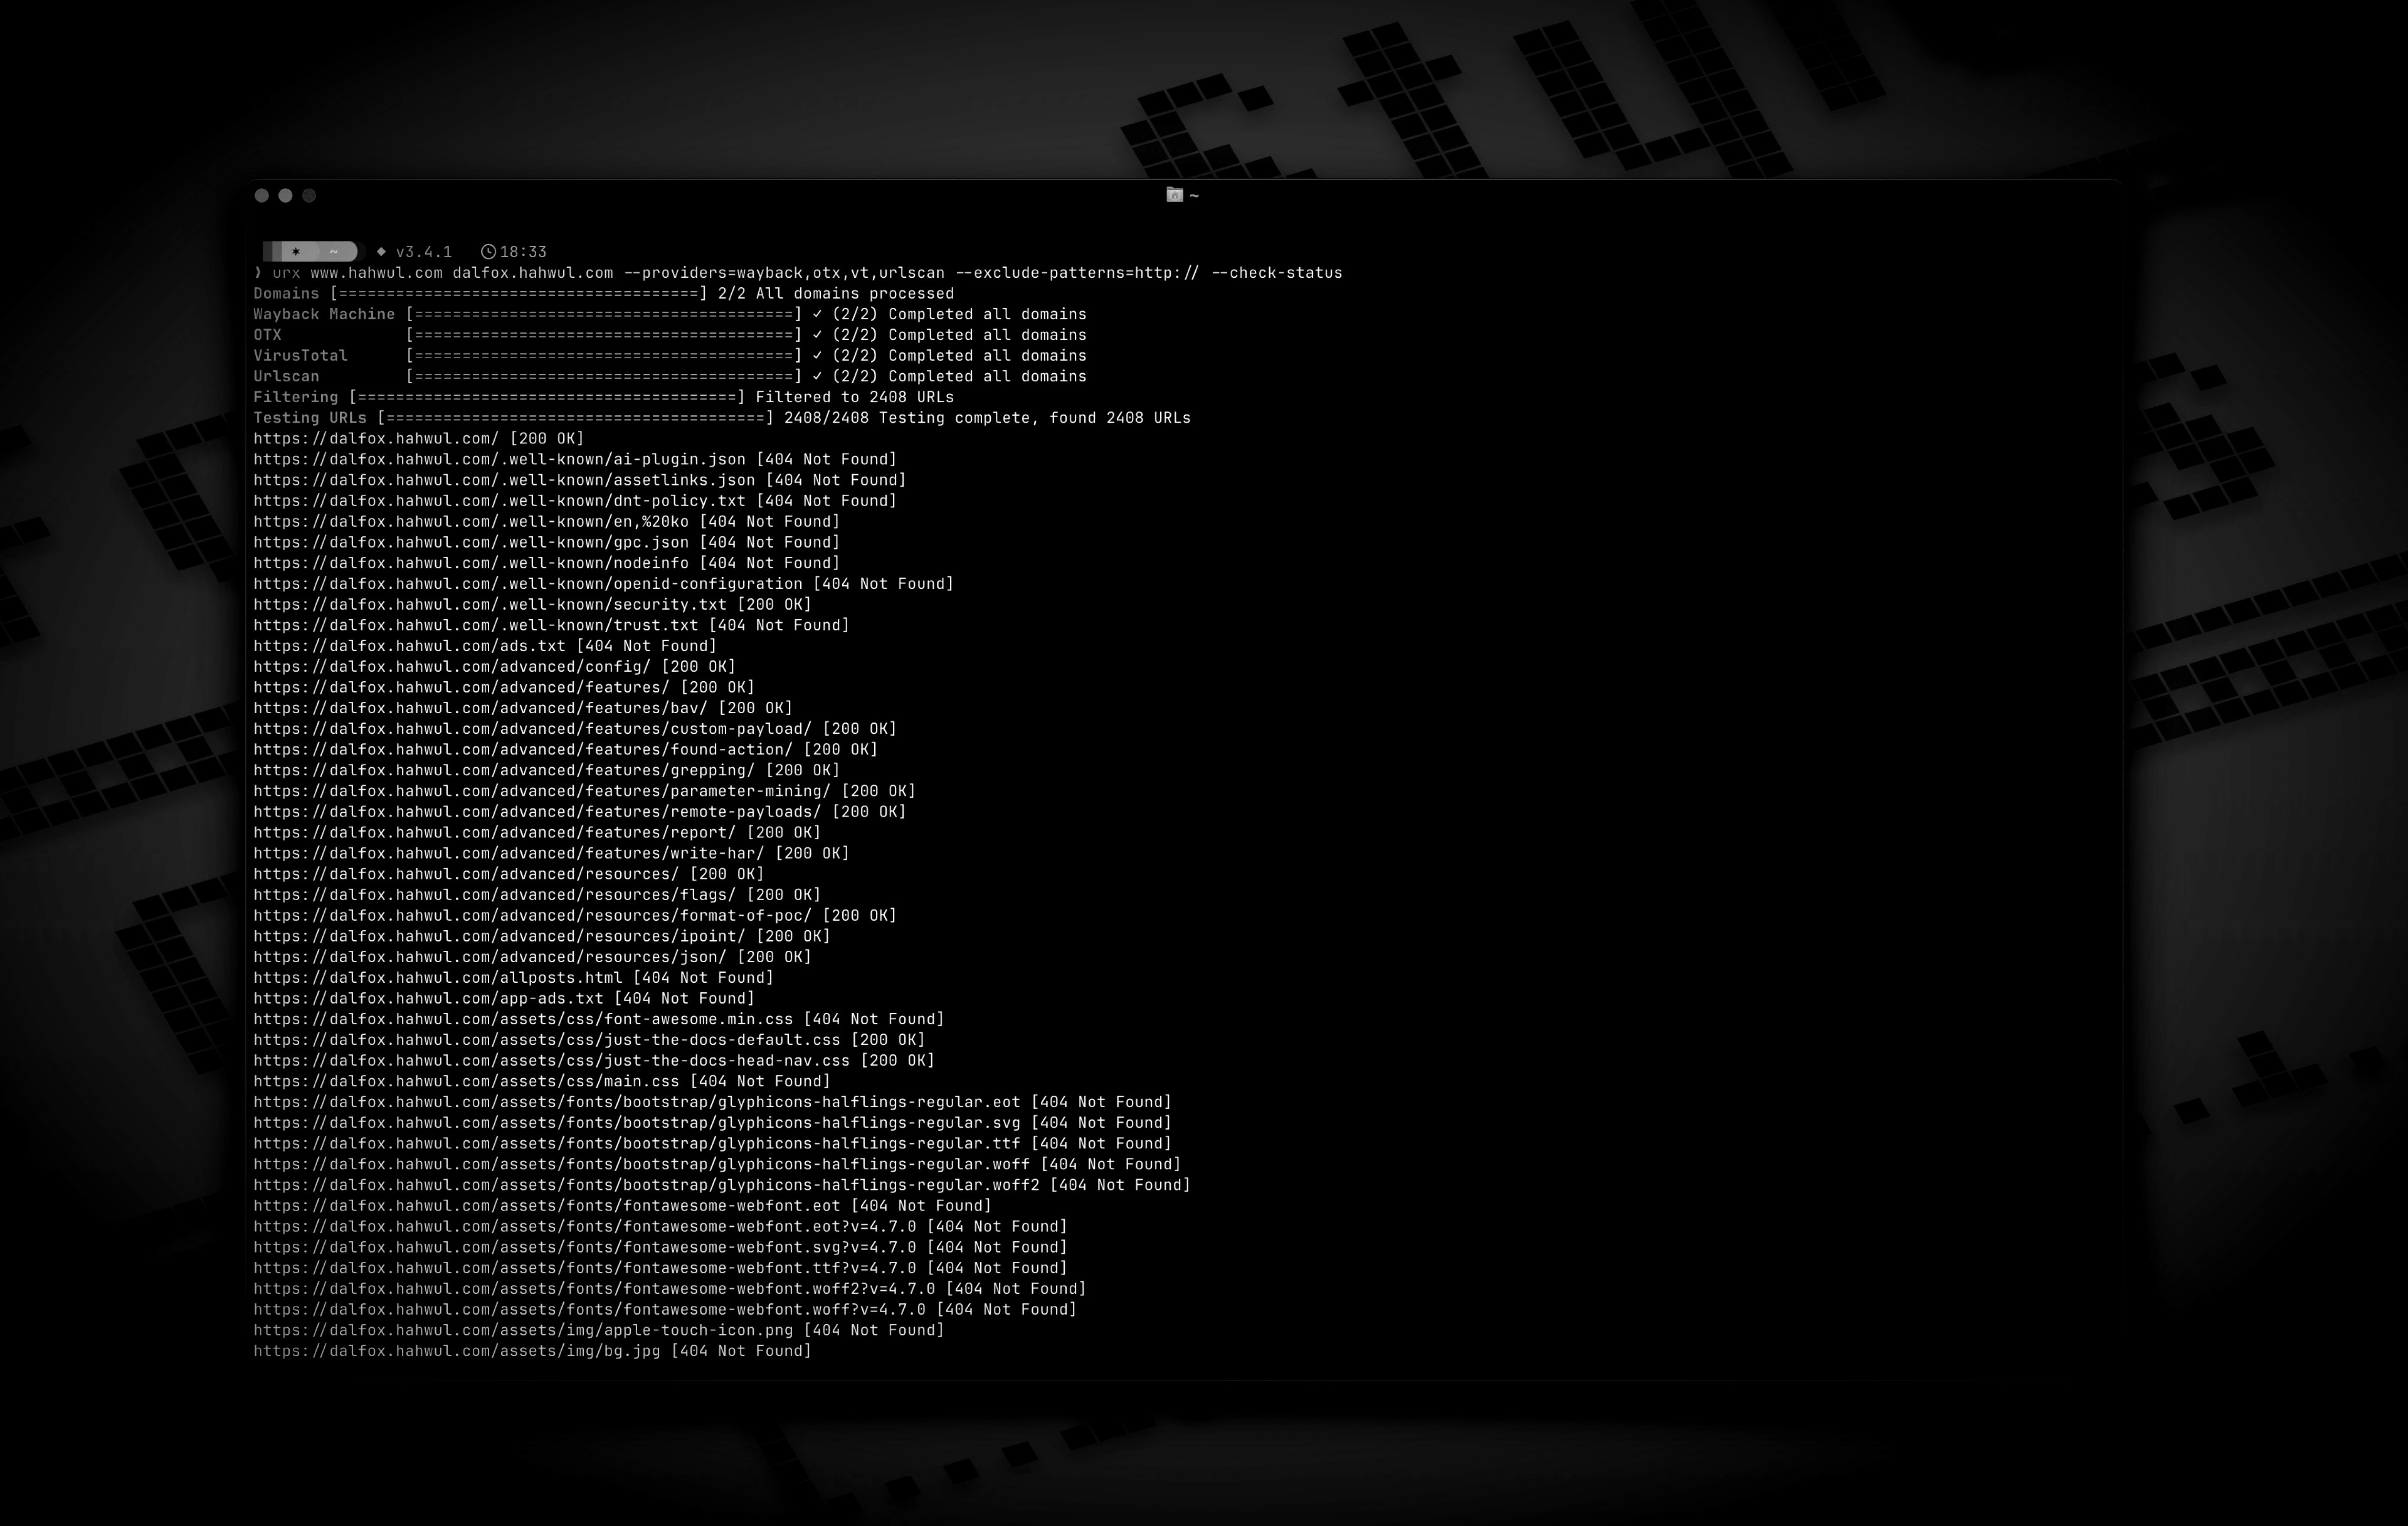
cargo install urx
### Da Homebrew```bash
# https://formulae.brew.sh/formula/urx
brew install urx
git clone https://github.com/hahwul/urx.git cd urx cargo build --release
Il binario compilato sarà disponibile in `target/release/urx`.

### Da Docker

[ghcr.io/hahwul/urx](https://github.com/hahwul/urx/pkgs/container/urx)

### Completamenti Shell

`urx` genera il proprio script di completamento, quindi corrisponde sempre ai flag
del binario effettivamente installato.```bash
# zsh — any directory on your $fpath works
urx --completions zsh > ~/.zfunc/_urx
# (make sure ~/.zfunc is on the fpath, then `compinit`)

# bash
urx --completions bash > ~/.local/share/bash-completion/completions/urx

# fish
urx --completions fish > ~/.config/fish/completions/urx.fish
Anche powershell ed elvish sono supportati. Il flag non necessita di un dominio di destinazione.
urx --manpage > ~/.local/share/man/man1/urx.1 man urx
## Utilizzo

### Utilizzo di base```bash
# Scan a single domain
urx example.com

# Scan multiple domains
urx example.com example.org

# Scan domains from a file
cat domains.txt | urx
Usage: urx [OPTIONS] [DOMAINS]... [COMMAND]
Commands: cache Inspect and maintain the URL cache: stats, list, prune, drop ..., clear
Arguments: [DOMAINS]... Domains to fetch URLs for
Options: -c, --config Config file to load --provider-config Separate provider config file holding only API keys (default: $XDG_CONFIG_HOME/urx/provider-config.toml). CLI/env > provider-config > main config. --completions Print a shell completion script (bash, zsh, fish, powershell, elvish) to stdout and exit --manpage Print the roff man page to stdout and exit -h, --help Print help -V, --version Print version
Input Options:
--files ... Read URLs directly from files (supports WARC, URLTeam compressed, and text files)
--domain-list File of newline-separated domains to scan (repeatable; merged with positional DOMAINS and stdin; # comments allowed)
Output Options:
-o, --output Output file to write results
--output-dir Write one file per domain into this directory (extension matches --format). Coexists with --output / stdout.
-f, --format Output format: "plain", "json" (one array), "jsonl" (one JSON object per line), "csv", "wordlist" (path segments and parameter names, deduplicated and sorted) [default: plain]
--stream Write URLs as each provider reports them instead of once at the end (unsorted; bypasses cache; rejects options needing the full result set)
--merge-endpoint Merge endpoints with the same path and merge URL parameters
--normalize-url Normalize URLs for better deduplication (sorts query parameters, removes trailing slashes)
--dedup-similar Collapse URLs that differ only in variable data (numeric ids, UUIDs, hashes, dates, query values)
--params Replace the URL list with every query parameter name the run saw, once each
--params-by-endpoint
One line per endpoint: the endpoint and the comma-separated union of the parameter names seen on it (id-looking path segments collapse to {id})
--fuzz-placeholder
Replace every query parameter value with VALUE, keeping one URL per parameter signature — output you can feed straight to ffuf or dalfox
Provider Options:
--providers
Providers to use (comma-separated, e.g., "wayback,cc,otx,arquivo,vt,urlscan") [default: wayback,cc,otx]
--exclude-providers <EXCLUDE_PROVIDERS>
Providers to exclude (comma-separated). Wins on conflict with --providers / --all-providers.
--all-providers
Enable every supported provider. API-keyed providers only activate when a key is available.
--list-providers
List every supported provider then exit.
--subs
Include subdomains when searching
--cc-index <CC_INDEX>
Common Crawl index to use; accepts comma-separated list to query multiple indexes in parallel (e.g. CC-MAIN-2026-17,CC-MAIN-2025-51). latest (the default) resolves the newest via collinfo.json. [default: latest]
--cdx-endpoint
Query an additional CDX index server (any pywb, OutbackCDX, or classic Internet-Archive-style CDX API) by its full API URL, e.g. https://vefsafn.is/cdx. Repeatable. Each endpoint becomes a provider with id cdx:<host> and honours --subs, --from/--to and the --archive-* filters. See "Custom CDX Endpoints" below
--cdx-dialect
Which CDX dialect the --cdx-endpoint servers speak: pywb or classic. Unset: urx probes each endpoint once and falls back to pywb when the answer is ambiguous
--from
Restrict every CDX-backed provider (wayback, cc, arquivo, --cdx-endpoint) to captures at or after DATE (YYYY/YYYYMM/YYYYMMDD/YYYYMMDDhhmmss). Alias: --wayback-from
--to
Restrict every CDX-backed provider to captures at or before DATE (same format as --from). Alias: --wayback-to
--archive-status
Keep only captures the archive recorded with this HTTP status code (e.g. "200"). Applied by the CDX index itself, so unlike --include-status it costs no extra requests. A multi-value list works on wayback only — see "Archive-side Filtering" below
--archive-exclude-status
Drop captures the archive recorded with these HTTP status codes (comma-separated, e.g. "404,500"). Multi-value works on every CDX provider
--archive-mime
Keep only captures with this recorded MIME type (e.g. "application/json"). Catches endpoints with no file extension, which -e/--extensions cannot
--archive-exclude-mime
Drop captures with these recorded MIME types (comma-separated, e.g. "text/html,image/png")
--vt-api-key <VT_API_KEY>
API key for VirusTotal (can be used multiple times for rotation, can also use URX_VT_API_KEY environment variable with comma-separated keys)
--urlscan-api-key <URLSCAN_API_KEY>
Optional API key for Urlscan; the provider also works anonymously (rate-limited ~30 req/min per IP). Can be used multiple times for rotation, or via URX_URLSCAN_API_KEY (comma-separated keys)
--github-api-key <GITHUB_API_KEY>
Personal access token for the GitHub Code Search provider (also reads URX_GITHUB_API_KEY, comma-separated for rotation)
--bevigil-api-key <BEVIGIL_API_KEY>
API key for BeVigil, which returns URLs extracted from unpacked Android apps (also reads URX_BEVIGIL_API_KEY, comma-separated for rotation). Required for the  provider
<title>bevigilDiscovery Options: --exclude-robots Exclude robots.txt discovery --exclude-sitemap Exclude sitemap.xml discovery --archived-discovery Also read every distinct archived version of robots.txt and sitemap.xml the Wayback Machine holds --archived-discovery-limit Maximum archived documents fetched per domain by each archived provider (nested sitemaps count) [default: 50]
Display Options: -v, --verbose Show verbose output --silent Silent mode (no output) --no-progress No progress bar --no-color Disable ANSI color in the progress UI and output (NO_COLOR is also honored) --show-sources Annotate output URLs with the providers that returned them --show-meta Annotate plain-text URLs with the archive capture metadata --stats Print a per-provider summary to stderr at end of run
Filter Options:
-p, --preset
Filter Presets (e.g., "no-resources,no-images,no-audio,only-js,only-style,only-secrets,only-backup,only-config,only-api")
-e, --extensions
Filter URLs to only include those with specific extensions (comma-separated, e.g., "js,php,aspx")
--exclude-extensions <EXCLUDE_EXTENSIONS>
Filter URLs to exclude those with specific extensions (comma-separated, e.g., "html,txt")
--patterns
Filter URLs to only include those containing specific patterns (comma-separated)
--exclude-patterns <EXCLUDE_PATTERNS>
Filter URLs to exclude those containing specific patterns (comma-separated)
--match-regex
Keep only URLs matching this regular expression (repeatable, ORed; case-sensitive; never comma-split)
--filter-regex
Drop URLs matching this regular expression (repeatable; one match is enough)
--show-only-host
Only show the host part of the URLs
--show-only-path
Only show the path part of the URLs
--show-only-param
Only show the parameters part of the URLs
--min-length <MIN_LENGTH>
Minimum URL length to include
--max-length <MAX_LENGTH>
Maximum URL length to include
--strict
Enforce exact host validation (default)
--no-strict
Disable host validation (keep URLs on any host a provider returns). Wins over --strict. A target's path scope still applies: only the host check is waived
--scope-file
Bug-bounty scope file: one host pattern per line, ! to exclude, *.example.com for a wildcard (which covers the apex too), # for a comment. Repeatable and unioned; exclusions always win. See "Scope Files" below
--meta-first-seen-after
Keep URLs whose oldest archived capture is on or after DATE (YYYY/YYYYMM/YYYYMMDD/YYYYMMDDhhmmss)
--meta-first-seen-before
Keep URLs whose oldest archived capture is on or before DATE
--meta-last-seen-after
Keep URLs whose newest archived capture is on or after DATE — "still alive as of"
--meta-last-seen-before
Keep URLs whose newest archived capture is on or before DATE — "dead since"
--meta-mime
Keep only URLs whose archived MIME type is one of these (comma-separated; image/* matches any subtype)
--meta-exclude-mime
Drop URLs whose archived MIME type is one of these
--meta-status
Keep only URLs whose archived status code matches (comma-separated; 20x / 5xx patterns)
--meta-exclude-status
Drop URLs whose archived status code matches
Network Options:
--network-scope <NETWORK_SCOPE> Control which components network settings apply to (all, providers, testers, or providers,testers) [default: all]
--proxy Use proxy for HTTP requests (format: http://proxy.example.com:8080)
--proxy-auth <PROXY_AUTH> Proxy authentication credentials (format: username:password)
--insecure Skip SSL certificate verification (accept self-signed certs)
--random-agent Use a random User-Agent for HTTP requests
-H, --header <NAME: VALUE> Extra request header, repeatable; sent only on requests urx makes to the target, never to an archive
--cookie Cookie header for requests to the target; shorthand for -H "Cookie: ..."
--user-agent User-Agent for requests to the target, overriding the default and --random-agent
--timeout Request timeout in seconds [default: 120]
--retries Number of retries for failed requests [default: 2]
--parallel Maximum domains fetched concurrently per provider (and concurrent URL tests); a provider's --rate-limit is shared across them [default: 5]
--rate-limit <RATE_LIMIT> Rate limit (requests per second)
--rate-limit-by Per-provider rate overrides (e.g. vt=1,wayback=10); falls back to --rate-limit for unlisted providers
--max-time <MAX_TIME> Global ceiling on provider enumeration time in seconds (0 = unlimited) [default: 0]
Testing Options:
--check-status
Check HTTP status code of collected URLs [aliases: ----cs]
--check-title
Also record each response's HTML while checking statuses; implies --check-status
--include-status <INCLUDE_STATUS>
Include URLs with specific HTTP status codes or patterns (e.g., --is=200,30x) [aliases: ----is]
--exclude-status <EXCLUDE_STATUS>
Exclude URLs with specific HTTP status codes or patterns (e.g., --es=404,50x,5xx) [aliases: ----es]
--extract-links
Extract additional links from collected URLs (requires HTTP requests)
--extract-js-endpoints
Fetch collected JavaScript files and extract the endpoint paths and URLs found in their string literals (requires HTTP requests); with --archive-body this also mines the archived copy of each script
--max-js-files
Maximum number of files --extract-js-endpoints will fetch (0 = unlimited) [default: 500]
--archive-body
Fetch the archived body of each collected URL from the Wayback Machine and extract the links inside it (works for pages that no longer exist)
--archive-body-limit
Maximum number of archived bodies --archive-body fetches per run; bounds distinct bodies, not URLs [default: 500]
--archive-body-dir
Keep every body --archive-body replays in DIR, with an index.jsonl mapping each file back to its URL, capture and content type
--expand-specs
Fetch the API specification documents among the collected URLs (OpenAPI, Swagger, GraphQL introspection; JSON or YAML) and expand every route they document into a URL. See "Expanding API Specifications" below
--max-spec-files
Maximum number of specification documents --expand-specs will fetch (0 = unlimited) [default: 50]
Cache Options:
--incremental Enable incremental scanning mode (only return new URLs compared to previous scans)
--cache-type Cache backend: sqlite or redis [default: sqlite]
--cache-path Path for the SQLite cache database
--redis-url Redis connection URL for remote caching
--cache-ttl Cache time-to-live in seconds [default: 86400]
--no-cache Disable caching entirely
Notification Options:
--notify POST a run summary to this webhook when the run ends (repeatable; also URX_NOTIFY_URL, provider-config notify_url, or [notify].url)
--notify-on <NOTIFY_ON> When to send: new (only if URLs were emitted), always, or never [default: new]
--notify-format <NOTIFY_FORMAT> Payload shape: json (urx summary), slack ({"text"}), or discord ({"content"}) [default: json]
`--extract-links` legge ogni tag che contiene un URL, non solo gli anchor: `<a href>`,
`<script src>`, `<link href>`, `<form action>`, ``, ``,
`<source src>`, `<object data>`, `<embed src>`, e i target di `<meta http-equiv="refresh">`.
Gli URL relativi vengono risolti rispetto alla pagina (rispettando `<base href>`),
i duplicati vengono rimossi, e i link scoperti passano attraverso gli stessi filtri
e la stessa validazione dell'host del resto dell'esecuzione. Vedi
[docs/content/guide/cli-options.md](https://github.com/hahwul/urx/blob/main/docs/content/guide/cli-options.md) per la
tabella completa.
`--extract-js-endpoints` va un passo oltre e legge il JavaScript
stesso: ogni URL raccolto che sembra uno script viene recuperato e i suoi
letterali stringa vengono analizzati per estrarre i percorsi e gli URL che l'app chiama —
`fetch("/api/v2/users")`, `axios.post("/graphql")`, il prefisso statico di
`` `/api/orders/${id}` ``. Questi sono gli endpoint che non compaiono mai nell'HTML.
L'output viene ripulito in modo aggressivo dal rumore (tipi MIME, specificatori di modulo, base64,
valori CSS, frammenti di regex e altro ancora vengono scartati), ogni corpo è limitato a
10 MiB, il numero di file recuperati è limitato da `--max-js-files`, e gli
endpoint scoperti passano attraverso gli stessi filtri e la stessa validazione dell'host di tutto il
resto. La politica completa di estrazione e soppressione del rumore è in
[docs/content/guide/cli-options.md](https://github.com/hahwul/urx/blob/main/docs/content/guide/cli-options.md#javascript-endpoint-extraction).
`--archive-body` esegue la stessa estrazione sui corpi che la Wayback Machine
ha *archiviato* anziché sul sito live, così una pagina che è stata eliminata anni fa
restituisce comunque i link che conteneva. Vedi
[Mining Archived Response Bodies](#mining-archived-response-bodies).
### Examples```bash
# Save results to a file
urx example.com -o results.txt
# Output in JSON format
urx example.com -f json -o results.json
# Filter for JavaScript files only
urx example.com -e js
# Exclude HTML and text files
urx example.com --exclude-extensions html,txt
# Filter for API endpoints
urx example.com --patterns api,v1,graphql
# Exclude specific patterns
urx example.com --exclude-patterns static,images
# Use Fileter Preset (similar to --exclude-extensions=png,jpg,.....)
urx example.com -p no-images
# Use specific providers
urx example.com --providers wayback,otx
# Add the keyless Arquivo.pt (Portuguese web archive) provider
urx example.com --providers wayback,cc,otx,arquivo
# Query another CDX index server alongside the defaults (id: cdx:vefsafn.is)
urx example.is --cdx-endpoint https://vefsafn.is/cdx
# ...or on its own, rate-limited, with the archive-side filters it shares with wayback/cc
urx example.is --cdx-endpoint https://vefsafn.is/cdx --providers cdx:vefsafn.is \
--rate-limit-by cdx:vefsafn.is=1 --from 2020 --archive-status 200
# URLScan works without a key (anonymous, rate-limited); a key just raises limits
urx example.com --providers urlscan
# BeVigil: endpoints pulled out of unpacked Android apps (key required; auto-enables the provider)
URX_BEVIGIL_API_KEY=*** urx example.com
# Using VirusTotal and URLScan providers
# 1. Explicitly add to providers (with API keys via command line)
urx example.com --providers=vt,urlscan --vt-api-key=*** --urlscan-api-key=***
# 2. Using environment variables for API keys
URX_VT_API_KEY=*** URX_URLSCAN_API_KEY=*** urx example.com --providers=vt,urlscan
# 3. Auto-enabling: providers are automatically added when API keys are provided
urx example.com --vt-api-key=*** --urlscan-api-key=*** # No need to specify in --providers
# 4. Multiple API key rotation (to mitigate rate limits)
# Using repeated flags for multiple keys
urx example.com --vt-api-key=key1 --vt-api-key=key2 --vt-api-key=key3
# Using environment variables with comma-separated keys
URX_VT_API_KEY=key1,key2,key3 URX_URLSCAN_API_KEY=ukey1,ukey2 urx example.com
# Combining CLI flags and environment variables (CLI keys are used first)
URX_VT_API_KEY=env_key1,env_key2 urx example.com --vt-api-key=cli_key1 --vt-api-key=cli_key2
# URLs from robots.txt and sitemap.xml are included by default
# Exclude URLs from robots.txt files
urx example.com --exclude-robots
# Exclude URLs from sitemap
urx example.com --exclude-sitemap
# Also read every archived version of robots.txt and sitemap.xml, so paths the
# site once listed and has since removed come back
urx example.com --archived-discovery
# Only the versions captured in a given era
urx example.com --archived-discovery --from 2014 --to 2016 --exclude-sitemap
# Include subdomains
urx example.com --subs
# Check status of collected URLs
urx example.com --check-status
# Read URLs directly from a text file
urx --files urls.txt
# Combine file input with filtering
urx --files urls.txt --patterns api,admin -f json
# Extract additional links from collected URLs
# (anchors, scripts, stylesheets, form actions, iframes, images, media
# sources, objects, embeds, and meta-refresh targets)
urx example.com --extract-links
# Discovered links go through the same filters as everything else, so this
# keeps only the JavaScript the pages reference
urx example.com --extract-links -e js
# Read the collected JavaScript and pull out the API paths it calls
urx example.com --extract-js-endpoints --patterns api
# Chain them: collect the site's bundles, then mine those for endpoints
urx example.com --extract-links --extract-js-endpoints --max-js-files 100
# Mine the links inside the *archived* bodies instead — dead pages included.
# One request per distinct body; the limit bounds bodies, not URLs
urx example.com --archive-body --archive-body-limit 200 --rate-limit 5
# Network configuration
urx example.com --proxy http://localhost:8080 --timeout 60 --parallel 10 --insecure
# Advanced filtering
urx example.com -e js,php --patterns admin,login --exclude-patterns logout,static --min-length 20
# HTTP Status code based filtering (live requests: urx re-fetches each URL)
urx example.com --include-status 200,30x,405 --exclude-status 20x
# Archive-side filtering (free: the CDX index already knows these)
# Skip everything the archive recorded as a 404 — no extra requests
urx example.com --archive-exclude-status 404
# Only captures the archive served as JSON — finds extensionless API endpoints
urx example.com --archive-mime application/json
# Drop HTML to leave assets and endpoints behind
urx example.com --archive-exclude-mime text/html
# Restrict the crawl window across wayback, cc, arquivo, and any --cdx-endpoint alike
urx example.com --from 2023 --to 2024
# Disable host validation
urx example.com --strict false
# URL normalization and deduplication
# Normalize URLs by sorting query parameters and removing trailing slashes
urx example.com --normalize-url
# Combine normalization with endpoint merging for comprehensive deduplication
urx example.com --normalize-url --merge-endpoint
# URL normalization with file input
urx --files urls.txt --normalize-url
# Collapse /post/1, /post/2, /post/99999 ... into a single representative line
urx example.com --dedup-similar
# Regular-expression filtering (repeat either flag; they are never comma-split)
urx example.com --match-regex '/api/v[0-9]+/'
urx example.com --match-regex '\.php$' --match-regex '\.aspx$'
urx example.com --filter-regex '/(assets|static)/'
# Regexes are case-sensitive; ask for insensitivity explicitly
urx example.com --match-regex '(?i)admin'
# Security presets: match by path shape as well as by extension
urx example.com -p only-secrets # /.env, /.git/config, id_rsa, *.pem
urx example.com -p only-backup # *.bak, *.sql, /backup/, index.php~
urx example.com -p only-config # *.yaml, web.config, .htaccess, Dockerfile
urx example.com -p only-api # /api/, /v1/, /graphql, /swagger, *.wsdl
# Scope files: a bug bounty program's own host list, used verbatim
urx example.com --subs --scope-file scope.txt
# Metadata filters, applied after collection so every provider is covered
urx example.com --providers wayback --meta-last-seen-after 2024 --meta-exclude-mime 'image/*'
urx example.com --providers wayback --meta-mime application/json --meta-status 200
# What parameters does this target take, and where?
urx example.com --params
urx example.com --params-by-endpoint
# One templated URL per parameter signature, straight into a fuzzer
urx example.com --fuzz-placeholder FUZZ | ffuf -w - -u FUZZ
# A target-specific wordlist instead of a URL list
urx example.com --subs -f wordlist -o words.txt
# Open the API specifications the sweep found and expand every route in them
urx example.com -p only-api --expand-specs
# Status checks also keep the response head; --check-title adds the <title>
urx example.com --check-status -f jsonl
urx example.com --check-title --show-meta
# Inspect and maintain the cache
urx cache stats
urx cache drop example.com
Limitare un'esecuzione a un percorso
Un target può indicare un percorso, e significa ciò che dice: urx example.com/shop
raccoglie la parte del sito sotto /shop.```bash
urx example.com/shop
urx https://example.com/api/v2 # a pasted URL works too
Questo non è un filtro applicato a posteriori. Un indice CDX risponde
nativamente alle query per prefisso, quindi urx invia `url=example.com/shop*` e
l'archivio non trasmette mai il resto del sito sulla rete — su un target di
grandi dimensioni questa è la differenza tra qualche centinaio di righe e
qualche centinaio di migliaia. Ai provider che non riescono a esprimere un
percorso nella loro query (OTX, VirusTotal, urlscan, GitHub, BeVigil, ZoomEye)
viene chiesto l'host e le loro risposte vengono ristrette successivamente, così
come i risultati di un'esecuzione `--subs`, dove la forma `*.host` e un
prefisso di percorso non possono essere combinati in un'unica query CDX.
Scope significa *al percorso o sotto di esso*: `/shop` e `/shop/cart` sono
inclusi, `/shopping` no. Le maiuscole/minuscole vengono ignorate, perché un
server CDX converte l'intero URL in minuscolo quando costruisce la chiave del
suo indice — `example.com/Shop*` e `example.com/shop*` restituiscono le stesse
righe, tutte scritte in minuscolo, quindi un controllo sensibile alle
maiuscole/minuscole scarterebbe tutto ciò che l'archivio ha appena
restituito. Una query string o un frammento nel target viene scartato — quelli
restringono una richiesta, non uno scope.
> Nota: urx scartava il percorso da un target, quindi
> `urx https://example.com/shop` scansionava l'intero `example.com`. Ora
> scansiona `/shop`. Passa solo l'host per il vecchio comportamento;
> un'esecuzione il cui target contiene un percorso lo segnala su stderr.
### Filtraggio con espressioni regolari
`--patterns` / `--exclude-patterns` sono semplici test di sottostringa: entrambi
i lati vengono convertiti in minuscolo e ogni metacarattere è letterale.
`--match-regex` / `--filter-regex` sono le controparti regex, e differiscono in
tre modi che vale la pena ricordare:
| | `--patterns` | `--match-regex` |
|---|---|---|
| Corrispondenza | sottostringa | [sintassi regex](https://docs.rs/regex/latest/regex/#syntax) completa |
| Maiuscole/minuscole | insensibile (entrambi i lati in minuscolo) | **sensibile** — usa `(?i)` per disattivare |
| Valori multipli | un flag separato da virgole | ripeti il flag; le virgole non vengono mai divise |
Entrambi i flag regex vengono valutati sull'**intera stringa URL** così come
raccolta (schema, host, percorso e query), quindi sia `^https://` che `\.js$`
funzionano. L'esclusione prevale: un URL che corrisponde a `--filter-regex`
viene scartato anche se `--match-regex` lo ha trovato. Un'espressione malformata
fa fallire l'esecuzione all'avvio, prima che venga interrogato qualsiasi
archivio.
### File di scope
Lo scope di un programma di bug bounty è una lista di host, e ogni piattaforma
la scrive allo stesso modo. `--scope-file` prende quella lista alla lettera
invece di obbligarti a tradurla manualmente in alternanze regex ancorate — dove
sbagliare l'ancoraggio *amplia* silenziosamente lo scope invece di fallire.```text
# scope.txt — in scope
*.example.com
api.example.org
# out of scope, even though the wildcard above covers them
!admin.example.com
!*.internal.example.com
Installazione
Installazione tramite script (Linux)
curl -fsSL https://raw.githubusercontent.com/cyberark/ReversingLabs/main/install.sh | bash
Installazione manuale
git clone https://github.com/cyberark/ReversingLabs.git
cd ReversingLabs
pip install -r requirements.txt
Utilizzo
python3 ReversingLabs.py -h
Esempi
# Analizza un singolo file
python3 ReversingLabs.py -f suspicious.exe
# Analizza una directory
python3 ReversingLabs.py -d /path/to/samples
# Analizza con output JSON
python3 ReversingLabs.py -f suspicious.exe -o json
# Analizza con output CSV
python3 ReversingLabs.py -f suspicious.exe -o csv
Licenza
Questo progetto è distribuito con licenza Apache License 2.0 - consulta il file LICENSE per i dettagli.
Riconoscimenti
- CyberArk
- ReversingLabs```bash
urx example.com --subs --scope-file scope.txt
urx --domain-list targets.txt --subs --scope-file scope-a.txt --scope-file scope-b.txt
`*.example.com` corrisponde all'apex così come a tutto ciò che sta sotto (la
lettura bug-bounty, che è ciò che intende la tabella di scope di una piattaforma); un host nudo
corrisponde esattamente a quell'host; un singolo `*` rende il file una pura deny-list;
le esclusioni vincono sempre; `#` avvia un commento. Qualsiasi cosa urx non possa onorare — una
porta, un percorso, un wildcard nel mezzo — è un errore di avvio che nomina il file e
la riga anziché uno scope silenziosamente più ampio. Il filtro si applica a ogni provider
e ai link estratti, e si combina con `--strict` anziché sostituirlo, quindi una riga di scope `*.example.com` necessita comunque di `--subs`.
### Filtri sui metadati degli archivi
`--from`/`--to` e i predicati `--archive-*` vengono inseriti nella query
dell'archivio stesso, il che li rende gratuiti e li limita anche ai provider supportati da CDX —
e i due dialetti CDX sono in disaccordo abbastanza gravemente che una lista multi-valore positiva
(`--archive-status 200,301`) è insoddisfacibile sui server pywb. Gli otto
filtri `--meta-*` vengono eseguiti *dopo* la raccolta, invece, su un unico insieme unito di
metadati di cattura per URL, quindi si applicano a ogni provider in modo uniforme.```bash
# Endpoints still being captured recently, with HTML and images out of the way
urx example.com --providers wayback --meta-last-seen-after 2024 --meta-exclude-mime 'text/html,image/*'
# Pages that died: nothing captured since 2019
urx example.com --providers wayback --meta-last-seen-before 2019
# JSON the archive served successfully
urx example.com --providers wayback --meta-mime application/json --meta-status 200
# First archived during 2020 (partial dates pad to the start / end of the period)
urx example.com --providers wayback --meta-first-seen-after 2020 --meta-first-seen-before 2020
Gli URL che non contengono metadati — i provider non-CDX, l'input --files, le cache hit — vengono suddivisi in base alla direzione del predicato: un predicato positivo non può essere soddisfatto da un valore assente, quindi l'URL viene scartato; un'esclusione scarta solo ciò che corrisponde positivamente, quindi sopravvive. --verbose riporta la suddivisione, e quando i metadati mancanti costituiscono l'intero set di risultati urx lo segnala anche senza -v, perché altrimenti una cache hit fa sembrare un'esecuzione vuota un target senza nulla da trovare.
Collassare i quasi-duplicati
Un archivio restituirà volentieri /post/1 fino a /post/99999. Sono un unico endpoint, e --dedup-similar ne stampa una sola riga. Un segmento di percorso viene trattato come dato — non come parte della route — quando è interamente uno tra:
- una sequenza di cifre (
/post/1, /page/42)
- un UUID (
/u/550e8400-e29b-41d4-a716-446655440000)
- un digest esadecimale di 32/40/64 caratteri (md5, sha1, sha256)
- una data separata (
/blog/2024-01-02/)
- un token lungo a maiuscole e minuscole miste con cifre al suo interno (session id, blob firmati)
I segmenti che contengono semplicemente cifre restano al loro posto, quindi /api/v1/ e /api/v2/ sono ancora due endpoint, e uno slug in minuscolo è prosa piuttosto che un token. Le query string vengono raggruppate solo per nomi dei parametri: ?q=cats&page=1 e ?q=dogs&page=7 collassano, mentre ?q=cats da solo no — eliminare un parametro cambia la richiesta.
Il sopravvissuto di ogni gruppo è il suo URL lessicograficamente più piccolo, quindi due esecuzioni sugli stessi dati stampano la stessa cosa. --verbose riporta quanti URL sono stati collassati. L'opzione è indipendente da --normalize-url e --merge-endpoint e si combina con entrambe; tutte e tre necessitano del set di risultati completo, quindi nessuna di esse funziona con --stream.
Viste dei parametri e del fuzzing
--show-only-param si limita a tagliare la query string da ogni URL, il che non può rispondere alla prima domanda che si pone un tester: quali parametri accetta questo target? Tre viste rispondono a questa domanda, costruite sullo stesso raggruppamento usato da --dedup-similar.```console
$ urx example.com --params
page
q
ref
sort
utm_source
$ urx example.com --params-by-endpoint
https://example.com/post/{id} ref,utm_source
https://example.com/search page,q,sort
$ urx example.com --fuzz-placeholder FUZZ
https://example.com/post/1?ref=FUZZ
https://example.com/post/2?utm_source=FUZZ
https://example.com/search?q=FUZZ&page=FUZZ
https://example.com/search?q=FUZZ&sort=FUZZ
`--params-by-endpoint` comprime i segmenti di percorso che sembrano id in `{id}` esattamente come
fa `--dedup-similar`, e scrive l'endpoint per esteso perché urx
scansiona abitualmente diversi host in un'unica esecuzione. `--fuzz-placeholder` mantiene un URL per
firma di parametro e conserva il suo percorso reale — un `{id}` non verrebbe instradato — così
l'output alimenta direttamente un fuzzer:```bash
urx example.com --fuzz-placeholder FUZZ | ffuf -w - -u FUZZ
urx example.com --fuzz-placeholder FUZZ | dalfox pipe
Tutti e tre richiedono il set di risultati completo, quindi sono solo in modalità batch e mutuamente esclusivi tra loro e con le viste --show-only-*.
Output Wordlist
-f wordlist trasforma un'esecuzione in una wordlist specifica per il target: ogni segmento di percorso e nome di parametro di query che ha visto, deduplicato sull'intera esecuzione e ordinato, un termine per riga.```bash
urx example.com --subs -f wordlist -o words.txt
ffuf -w words.txt -u https://example.com/FUZZ
I segmenti che sembrano dati anziché nomi di route vengono tralasciati, riutilizzando i gruppi di test `--dedup-similar` — una wordlist piena di `4711`, UUID, date e session token è peggio di nessuna wordlist, dato che ognuna di quelle parole esiste su esattamente un target. Anche un segmento il cui stem è un identificatore viene escluso (`article-1234.html`). Il case è preservato: i segmenti di path sono case-sensitive sulla maggior parte delle origini, quindi convertire in minuscolo `WebResource.axd` produrrebbe una parola che restituisce 404 ovunque venga provata. L'unione deve essere presa sull'insieme completo, quindi il formato è solo batch.
### Streaming Output
Per impostazione predefinita urx raccoglie tutto, poi filtra, ordina e stampa una sola volta. Su un target di grandi dimensioni questo significa nessun output finché l'archivio più lento non termina. `--stream` scrive ogni URL nel momento in cui il provider che lo riporta ritorna:```bash
# Matches start appearing immediately instead of after the slowest provider
urx big-target.com --stream | grep admin
# Line-delimited JSON stays valid while it is still being written
urx big-target.com --stream -f jsonl | jq -r 'select(.url | test("/api/")) | .url'
Gli URL in streaming passano esattamente gli stessi filtri di un'esecuzione batch e vengono comunque deduplicati. Due cose differiscono:
- Ordine. I risultati arrivano nell'ordine di completamento del provider, quindi l'output non è ordinato. Passa attraverso
sort se hai bisogno di un ordinamento.
- Ambito. Le opzioni che richiedono il set completo di risultati vengono rifiutate in anticipo (con un messaggio che ne indica ciascuna):
--merge-endpoint, --dedup-similar, --check-status /
--include-status / --exclude-status, --extract-links,
--extract-js-endpoints, --archive-body, --expand-specs,
--incremental, --show-sources, --show-meta, i filtri --meta-*,
--params, --params-by-endpoint, --fuzz-placeholder, --output-dir, e
--files. La cache viene bypassata;
--format json viene rifiutato in favore di jsonl perché un array JSON deve
sapere quale voce è l'ultima, e --format wordlist perché nessun termine può essere
noto come nuovo finché ogni URL non è arrivato.
Poiché la mappa dei risultati batch non viene mai popolata in questa modalità, un'esecuzione in streaming
mantiene anche molta meno memoria — solo il set di deduplicazione degli URL già scritti.
Metadati di acquisizione dell'archivio
Un indice CDX registra più dell'URL: ogni acquisizione porta con sé un timestamp, il
tipo MIME e lo stato HTTP che l'archivio ha visto, e un digest del corpo. urx conserva
tutto questo, quindi i provider basati su CDX — wayback, cc, arquivo, e qualsiasi
--cdx-endpoint — riportano ogni URL insieme a:
Campo Significato first_seenTimestamp di acquisizione più vecchio, forma CDX a 14 cifre (YYYYMMDDhhmmss) last_seenTimestamp di acquisizione più recente mimeTipo MIME dell'acquisizione più recente che ne ha registrato uno archive_statusStato HTTP che l'archivio ha registrato al momento dell'acquisizione digestUn digest rappresentativo del contenuto tra le acquisizioni
archive_status non è status: status appare solo con --check-status,
che richiede nuovamente l'URL in tempo reale ora, mentre archive_status è ciò che il crawler
ha ottenuto quando ha catturato la pagina. Un URL può benissimo avere archive_status
200 ed essere morto oggi.
Quando lo stesso URL proviene da più acquisizioni o più archivi, i valori
vengono uniti: first_seen è il timestamp più vecchio riportato da chiunque, last_seen
il più recente, e mime/archive_status provengono dall'acquisizione più recente che
li aveva. I provider senza indice di acquisizione (otx, vt, urlscan, zoomeye,
github, bevigil, robots, sitemap, e input --files) riportano solo l'URL
— nessun valore viene inventato per loro.
Come i metadati si manifestano dipende dal formato:
json / jsonl — ogni campo appare come chiave quando ha un valore e viene
omesso del tutto quando non ce l'ha, esattamente come sources.csv — una colonna viene aggiunta solo quando almeno una riga ha un valore per essa,
quindi un'esecuzione senza metadati produce comunque una singola colonna url.- testo semplice — invariato per impostazione predefinita, un URL nudo per riga, così le pipeline
esistenti continuano a funzionare. Passa
--show-meta per aggiungere i campi.```bash
Rich records: when the URL was alive, and what it served
urx example.com --providers wayback -f jsonl
{"url":"https://example.com/old.php","first_seen":"20040112093000",
"last_seen":"20180722140311","mime":"text/html","archive_status":"200",
"digest":"HT2DYGA5UKZCPBSFVCV3JOBXGW2G5UUA"}
Triage by age: everything last captured before 2010
urx example.com -f jsonl | jq -r 'select(.last_seen < "20100101000000") | .url'
Opt plain output into the metadata
urx example.com --providers wayback --show-meta
Lo streaming (`--stream`) riporta solo gli URL. Un URL viene stampato al primo avvistamento,
prima che arrivino le catture che amplierebbero il suo intervallo `first_seen`/`last_seen`,
quindi `--show-meta` viene rifiutato in quel contesto per lo stesso motivo
per cui lo è `--show-sources`.
Anche un cache hit non porta metadati: la cache memorizza gli URL, quindi un dominio servito
dalla cache riporta i suoi URL senza i campi di cattura. Usa `--no-cache` (o attendi
il TTL) per un'esecuzione che li ripopoli.
### Metadati della risposta live
`--check-status` invia già una richiesta e attende l'head della risposta, quindi
ciò che quell'head porta con sé arriva gratuitamente: `Location`, `Content-Length` e
`Content-Type` vengono registrati insieme al codice di stato. I redirect non vengono comunque mai
seguiti, quindi uno stato riportato appartiene sempre all'URL richiesto e
`location` dice semplicemente dove puntava il 3xx.
`--check-title` aggiunge il `<title>` HTML. È l'unico campo che non è gratuito —
un titolo richiede il corpo della risposta — quindi sta dietro il proprio flag. La lettura è
limitata due volte (al massimo 64 KiB, e si ferma al tag di chiusura) e saltata
del tutto per un corpo che il server ha dichiarato non-HTML, quindi una JSON API o un'immagine
non costano nulla. Il titolo viene compattato negli spazi bianchi, decodificato nelle entità e tagliato a 200
caratteri. `--check-title` implica `--check-status`.```bash
urx example.com --check-status -f jsonl
urx example.com --check-title --show-meta
urx example.com --check-status --is 30x -f jsonl | jq -r '.url + " -> " + .location'
L'esposizione segue la regola già stabilita dai metadati dell'archivio: json/jsonl/csv
trasportano sempre i campi (le chiavi assenti vengono omesse, e le colonne CSV vengono
aggiunte dopo quelle esistenti), mentre il testo semplice rimane un URL nudo per riga
a meno che --show-meta richieda diversamente. Nell'output semplice il titolo è tra virgolette, poiché
è l'unico valore che contiene abitualmente spazi.
Richieste Autenticate e Personalizzate
--check-status, --extract-links, --extract-js-endpoints e
--expand-specs richiedono nuovamente tutti gli URL raccolti dal target stesso. -H
fornisce a tali richieste tutte le intestazioni di cui necessitano:```bash
urx example.com --check-status -H "Authorization: Bearer $TOKEN"
urx example.com --extract-links --cookie "session=abc; role=admin"
urx example.com --check-status --user-agent "acme-security-scan/1.0"
`-H` è ripetibile, accetta `Name: value`, e uno malformato interrompe l'esecuzione
invece di passare inosservato — un argomento che viene silenziosamente scartato lascia
una scansione anonima che viene letta come autenticata. `--cookie` e
`--user-agent` sono scorciatoie per gli header corrispondenti.
**Questi header non raggiungono mai un archivio.** Vengono inviati solo dai componenti
che comunicano con il target: i quattro tester sopra, più i provider `robots` e
`sitemap`, che effettuano richieste anch'essi al target. Ogni altro provider
interroga web.archive.org, index.commoncrawl.org o un'API di terze parti, e lo stesso
fa `--archive-body` quando riproduce una cattura; passare loro il cookie di sessione
del target significherebbe spedire una credenziale a un servizio che conserva ciò che
riceve, senza alcun vantaggio. Le query agli archivi mantengono il User-Agent proprio
di urx, che `--random-agent` continua a ruotare.
### Estrazione dei corpi delle risposte archiviate
`--extract-links` recupera ogni URL raccolto dal sito live, che è
esattamente il posto sbagliato in cui cercare le pagine che più interessano a una
ricognizione OSINT: quelle che non esistono più. `--archive-body` recupera invece i
corpi che la Wayback Machine ha memorizzato. Per ogni URL raccolto che porta un
timestamp di cattura, urx riproduce quella cattura nella sua forma grezza
(`https://web.archive.org/web/<timestamp>id_/<url>` — il flag `id_` disattiva la
barra degli strumenti della Wayback e la riscrittura dei link, così il corpo
corrisponde ai byte originali) ed esegue su di esso la stessa estrazione di link
usata da `--extract-links`.```bash
# Links from the archived bodies of everything the CDX providers found
urx example.com --archive-body
# Bound the run and pace it; the archive is one host no matter how many URLs
urx example.com --archive-body --archive-body-limit 200 --rate-limit 5
# Only the JavaScript those pages referenced back then
urx example.com --archive-body -e js
Perché questo richiede molte meno richieste rispetto a waymore. Ogni riga CDX porta un
digest del contenuto, e due catture con lo stesso digest hanno un corpo identico byte per byte. Gli archivi ne sono pieni: ogni variante ?utm_source= di una pagina,
ogni /index.html accanto al suo /, ogni permutazione di parametri di tracciamento
serve byte identici, quindi una lista di decine di migliaia di URL si riduce regolarmente
a poche migliaia di corpi distinti. waymore non ha alcuna nozione di questo — scarica
una risposta per URL e gestisce il volume tramite un rozzo
limite -l 5000, che sia martella l'archivio sia tronca la copertura. urx
rivendica ogni digest la prima volta che viene visto e salta ogni URL successivo che
riprodurrebbe gli stessi byte, quindi la stessa copertura costa una richiesta per
corpo distinto. --archive-body-limit (predefinito 500) limita i corpi distinti,
non gli URL; i duplicati non vengono mai conteggiati, e --verbose riporta quanti
sono stati saltati.
Estrazione di JavaScript archiviato. La superficie API di un'app moderna vive nei suoi bundle
come stringhe letterali, e --extract-js-endpoints le recupera dal sito live — dove
spesso sono sparite. I bundle sono nominati tramite hash di build, quindi
app.a3f9c2.js restituisce 404 nel momento in cui il sito viene ridistribuito, e gli endpoint che nominava
se ne vanno con esso. Esegui i due flag insieme e urx estrae la copia archiviata
invece, e i blocchi <script> inline di una pagina archiviata insieme ai suoi link:```bash
urx example.com --archive-body --extract-js-endpoints
**Conservare i corpi.** Le richieste vengono già effettuate, quindi scrivere i corpi su disco non costa nulla in più e risponde alle domande che nessun estrattore di link pone: il commento `<!-- staging.internal -->`, il token che una build del 2019 ha inlineato, lo stack trace che nomina una versione di framework.```bash
urx example.com --archive-body --archive-body-dir ./corpus
grep -ri "api[_-]key" ./corpus
Ogni file prende il nome dal suo URL più un hash dello stesso, e corpus/index.jsonl
mappa ogni file al suo URL, timestamp di cattura, digest e tipo di contenuto.
Vengono memorizzati solo corpi di tipo testuale — HTML, script, JSON, XML, CSS, testo semplice —
così la directory non si riempie con le immagini e i font del sito. Poiché il
fetch è deduplicato per digest, il corpus copre molto di più del target per
richiesta di quanto farebbe una risposta per URL.
Dettagli degni di nota:
- Solo gli URL con un timestamp di cattura sono idonei. I provider CDX (
wayback,
cc, arquivo) ne forniscono uno; l'input --files, i provider non-CDX e i risultati
in cache (la cache memorizza solo URL) non ne hanno alcuno. urx lo segnala quando non c'è
nulla da riprodurre — passa --no-cache per ottenere catture fresche.
- Viene riprodotta la cattura più recente di ogni URL. Un timestamp riportato da un altro
archivio ricade sulla cattura Wayback più vicina; un URL che la Wayback Machine non ha mai
visto risponde 404 e viene saltato. Le catture che l'archivio ha registrato come errori non
vengono estratte, esattamente come
--extract-links ignora le pagine di errore live.
- I link scoperti passano attraverso gli stessi filtri, la validazione dell'host e le trasformazioni
di output di tutto il resto, e ogni corpo è limitato a 10 MiB.
--rate-limit, --rate-limit-by wayback=N, --parallel, --proxy,
--timeout e --retries si applicano tutti alle richieste di replay.- Incompatibile con
--stream, come ogni opzione che viene eseguita dopo la raccolta.
Espansione delle specifiche API
Una scansione -p only-api trova /swagger.json, /openapi.yaml e /v3/api-docs
e poi non li apre mai: --extract-links analizza l'HTML, --extract-js-endpoints
scarta i corpi application/json, e --archive-body esegue il parser HTML su
qualunque cosa restituisca l'archivio. --expand-specs li legge ed espande ogni route
che descrivono nel set di risultati — una richiesta acquista l'intera superficie
documentata, esatta e già parametrizzata.```bash
urx example.com -p only-api --expand-specs
urx example.com --expand-specs --max-spec-files 10 --rate-limit 2
Recover an API the live host no longer serves: read the archived document
urx example.com --archive-body --expand-specs
Cosa viene espanso:
* **OpenAPI 3.x** — `servers[].url` (assoluto, relativo al documento e templatizzato,
con `{var}` risolto da `variables[var].default` o dal primo valore `enum`)
incrociato con ogni chiave `paths`; i `servers` propri di un path item
sovrascrivono quelli del documento.
* **Swagger 2.0** — `schemes` × `host` + `basePath`, con ogni parte che ricade
sulla parte corrispondente dell'URL del documento stesso. `ws`/`wss` vengono scartati.
* **GraphQL introspection** — un URL per ogni campo query, mutation e subscription,
scritto come l'endpoint più `?query=…`. Uno schema salvato come file
si risolve nel suo endpoint (`/graphql/schema.json` → `/graphql`).
Sia JSON che YAML vengono letti. I target vengono scelti prima per nome e gratuitamente (una
sottostringa marcatore di spec — `swagger`, `openapi`, `api-docs`, `graphql`,
`introspection` — più un'estensione `json`/`yaml`/`yml` quando presente, così
`swagger-ui.html` non costa alcuna richiesta), poi tramite il `Content-Type` della risposta. I template
di path vengono emessi così come li scrive il documento (`/users/{id}`, non
`/users/%7Bid%7D`). I body sono limitati a 10 MiB, e un documento YAML con più
di 32 riferimenti alias viene rifiutato prima del parsing per escludere bombe di espansione.
`--max-spec-files` (default 50) limita i documenti recuperati. Con
`--archive-body` attivo, una specifica archiviata viene letta come tale senza alcun costo
aggiuntivo in richieste — il body era già stato recuperato.
### robots.txt e sitemap.xml archiviati
I provider `robots` e `sitemap` leggono i file *live*, che dicono solo cosa
un sito nasconde o elenca oggi. `--archived-discovery` legge anche ogni distinta
versione di quei file memorizzata dalla Wayback Machine. Un `Disallow:` del 2015
nomina percorsi che il sito ha smesso di menzionare — spesso perché erano
destinati a essere dimenticati, non perché siano scomparsi — e una vecchia sitemap elenca
tutto ciò che il sito una volta voleva far scansionare.```bash
# Every archived version of robots.txt and sitemap.xml, alongside the live ones
urx example.com --archived-discovery
# Bound it and pace it; both archived providers answer to --rate-limit-by
urx example.com --archived-discovery --archived-discovery-limit 20 --rate-limit-by robots=2,sitemap=2
# Only the versions captured in a given era
urx example.com --archived-discovery --from 2014 --to 2016
Come funziona, e perché è economico:
- Le versioni di un documento sono elencate con una query CDX per file
(
robots.txt, sitemap.xml, sitemap_index.xml, sitemap.txt), usando
collapse=digest in modo che le catture consecutive che hanno servito gli stessi byte si fondano
in una sola riga. Vengono richieste solo le righe registrate come successo: l'indice fonde
www. e l'apex in un'unica voce, e le loro righe 301/200 interlacciate
altrimenti vanificano il collapse — per github.com/robots.txt si tratta di 325k righe
senza il filtro e 14k con esso, per le stesse 107 versioni distinte.
- Ogni versione distinta viene riprodotta in forma grezza (
/web/<timestamp>id_/…) e
passata allo stesso parser del file live. Nessun secondo parser: un robots.txt
del 2015 viene letto esattamente con le regole di quello attuale, incluse
le protezioni per percorsi assoluti e salto dei pattern. Un <sitemapindex> archiviato viene
seguito nei suoi figli così come erano in quel preciso momento.
- Le catture che l'archivio ha registrato come errori (il robots.txt di github.com è stato un 401
per parte del 2007) vengono saltate senza una richiesta e segnalate solo con
--verbose.
--archived-discovery-limit (predefinito 50) limita i documenti recuperati per
dominio da ciascun provider archiviato, partendo dalle versioni più recenti; le sitemap annidate
contano. --verbose indica quando il limite ha troncato la lista.- Le varianti archiviate vengono eseguite come istanze provider a sé stanti — "Robots.txt
(archived)" e "Sitemap (archived)" in
--stats e --show-sources — ma
sotto gli id esistenti robots / sitemap, quindi --exclude-robots,
--exclude-sitemap e --rate-limit-by robots=N governano sia le letture live che
quelle archiviate. --from / --to restringono quali versioni vengono considerate.
- Funziona con
--stream; è un provider come qualsiasi altro.
Filtraggio lato archivio
--archive-status, --archive-mime, --from e --to sono valutati dall'indice
CDX dell'archivio anziché da urx. Vale la pena conoscere due conseguenze:
- Si applicano solo ai provider basati su CDX —
wayback, cc, arquivo e
qualsiasi --cdx-endpoint. Gli altri provider li ignorano; urx avvisa quando nessuno è
abilitato.
- Gli archivi non condividono un unico dialetto di filtri. Wayback Machine (e qualsiasi
endpoint
--cdx-dialect classic) tratta i valori come espressioni regolari, quindi
--archive-status "30." corrisponde a qualsiasi 3xx. Common Crawl, Arquivo.pt e gli
endpoint pywb corrispondono esattamente, e il loro indice combina in AND filtri ripetuti —
quindi una lista positiva multi-valore come --archive-status 200,301 è
insoddisfacibile lì. urx salta quel filtro per quei provider (con un
avviso) invece di inviare una query che tornerebbe vuota. Le esclusioni
multi-valore significano "non questo e non quello" e funzionano ovunque.
Usa --archive-status quando vuoi ciò che l'archivio ha registrato al momento della scansione e
--check-status / --include-status quando vuoi lo stato del target adesso;
quest'ultimo richiede nuovamente ogni URL.
Endpoint CDX personalizzati
Ogni archivio web costruito su pywb, OutbackCDX o il server CDX di Internet Archive
espone la stessa API di query. Anziché codificare un provider per ogni
archivio, --cdx-endpoint URL trasforma qualsiasi server di questo tipo in un provider sul
momento:```bash
The Icelandic web archive, alongside the default providers
urx example.is --cdx-endpoint https://vefsafn.is/cdx
Several at once; each gets its own progress line, stats row and rate limit
urx example.com --cdx-endpoint https://vefsafn.is/cdx --cdx-endpoint http://localhost:8080/cdx
--rate-limit-by cdx:vefsafn.is=1
* L'id del provider è `cdx:<host>` (`cdx:vefsafn.is`), ed è quello che usano
`--exclude-providers`, `--rate-limit-by`, `--stats` e `--show-sources`.
Nominare un endpoint lo abilita; non è necessaria alcuna voce `--providers`, e
`--providers cdx:vefsafn.is` lo esegue da solo. `--list-providers` mostra gli
endpoint nominati sulla stessa riga di comando con gli id con cui verranno eseguiti.
* Tutto ciò che i provider CDX integrati rispettano vale anche qui: `--subs`,
`--from`/`--to`, i filtri `--archive-*`, la paginazione, `--rate-limit` e
i metadati di cattura descritti sopra.
* `--cdx-dialect classic|pywb` indica il dialetto del server (nomi dei campi, semantica
dei filtri, formato delle righe e schema di paginazione derivano tutti da esso — vedi
"Archive-side Filtering"). Se non impostato, urx sonda l'endpoint una volta per esecuzione
e ripiega su `pywb`, il dialetto più comune; impostalo esplicitamente quando la
sonda non riesce a determinarlo (una risposta vuota per un dominio sconosciuto, ad esempio).
* Può anche essere impostato nel file di configurazione (`cdx_endpoint = [...]`, `cdx_dialect`).
**Endpoint verificati.** Al momento della stesura, l'unico endpoint pubblico confermato
funzionante end to end è `https://vefsafn.is/cdx` (l'archivio web islandese di Landsbókasafn, dialetto pywb). Due cose da sapere al riguardo: ignora `limit`, `page`
e `showNumPages` e restituisce il set completo di risultati per ogni query, cosa che
urx gestisce; e dopo una manciata di richieste potrebbe iniziare a rispondere con una
pagina di protezione bot in stile Anubis ("Session Verification"). urx rileva una risposta HTML
al posto delle righe CDX e la segnala come errore del provider indicando l'endpoint
— non viene mai conteggiata come "no URLs". Se la incontri, rallenta con
`--rate-limit-by cdx:vefsafn.is=1` o riprova più tardi.
**Noti per non funzionare.** L'UK Web Archive (`webarchive.org.uk`), l'archivio web della Library of
Congress (`webarchive.loc.gov`), la Bibliotheca Alexandrina e la
National Library of Australia (`web.archive.org.au`) si trovano tutti dietro protezione bot
o redirect che bloccano le loro API CDX da un client da riga di comando.
urx non tenta di aggirarlo, quindi puntare `--cdx-endpoint` verso di essi
produce l'errore di risposta HTML sopra descritto.
### Caching e Scansione Incrementale
Urx supporta il caching per migliorare le prestazioni nelle scansioni ripetute e la scansione incrementale per scoprire solo nuovi URL.```bash
# Enable caching with SQLite (default)
urx example.com --cache-type sqlite --cache-path ~/.urx/cache.db
# Use Redis for distributed caching
urx example.com --cache-type redis --redis-url redis://localhost:6379
# Incremental scanning - only show new URLs since last scan
urx example.com --incremental
# Set cache TTL (time-to-live) to 12 hours
urx example.com --cache-ttl 43200
# Disable caching entirely
urx example.com --no-cache
# Combine incremental scanning with filters
urx example.com --incremental -e js,php --patterns api
# Configuration file with caching settings
urx -c example/config.toml example.com
Gestione della Cache
urx cache ispeziona e mantiene la cache senza toccare il database manualmente. Ogni sottocomando rispetta gli stessi --cache-type, --cache-path, --redis-url e --cache-ttl di una scansione, e tutti e cinque funzionano con entrambi i backend.```bash
urx cache stats # entries, domains, URLs, age span, size, expired count
urx cache list # per-domain counts, last scan, TTL remaining
urx cache list --domain '*.example.com'
urx cache prune # delete only what --cache-ttl has expired
urx cache drop example.com # rescan one target without clearing the rest
urx cache clear --yes # delete everything
machine-readable
urx cache stats -f json | jq '.expired_entries'
La corrispondenza dei domini non distingue tra maiuscole e minuscole ed è **esatta**, a meno che il pattern non contenga
`*` — un valore predefinito per sottostringa avrebbe permesso a `drop example.com` di eliminare anche
`notexample.com`. `clear` chiede conferma prima di eliminare e rifiuta uno
stdin non interattivo invece di presumere una risposta, `drop` segnala qualsiasi pattern
che non ha trovato corrispondenze, consultare la cache non ne crea mai una, e Redis viene scansionato
con `SCAN` invece del bloccante `KEYS` (con qualsiasi password in `--redis-url`
oscurata prima di essere stampata).
#### Casi d'uso della cache```bash
# Daily monitoring - only alert on new URLs (built-in webhook, see below)
urx target.com --incremental --silent --notify https://hooks.slack.com/services/... --notify-format slack
# ...or hand the new URLs to an external notifier
urx target.com --incremental --silent | notify-tool
# Efficient domain lists processing
cat domains.txt | urx --incremental --cache-ttl 3600 > new_urls.txt
# Distributed team scanning with Redis
urx example.com --cache-type redis --redis-url redis://shared-cache:6379
# Fast re-scans during development
urx test-domain.com --cache-ttl 300 # 5-minute cache for rapid iterations
Notifiche Webhook
--notify <URL> invia via POST un riepilogo dell'esecuzione a un webhook al termine della stessa,
il che trasforma --incremental in un monitor: inseriscilo in cron e il webhook
si attiverà solo quando compare qualcosa di nuovo.```bash
Slack incoming webhook, only when the run finds new URLs (the default)
urx target.com --incremental --silent
--notify https://hooks.slack.com/services/T000/B000/XXXX --notify-format slack
Discord, and send even when nothing is new
urx target.com --incremental --notify "$DISCORD_HOOK" --notify-format discord --notify-on always
Several receivers, urx's own JSON schema (the default format)
urx target.com --incremental --notify https://n8n.example/hook --notify https://ntfy.example/urx
Keep the webhook out of the shell history
export URX_NOTIFY_URL=https://hooks.slack.com/services/...
urx target.com --incremental --notify-format slack
- `--notify-on` è `new` per impostazione predefinita: non viene inviato nulla quando l'esecuzione non emette URL, quindi un'esecuzione cron silenziosa rimane silenziosa. `always` invia comunque; `never` mantiene la configurazione ma disabilita l'invio.
- `--notify-format json` (predefinito) invia lo schema di urx: `domains`,
`incremental`, `url_count`, `new_url_count`, `elapsed_ms`, una lista
`providers` per provider (gli stessi numeri stampati da `--stats`), e un
`sample` di fino a 20 URL emessi con `sample_truncated` impostato quando ne
sono stati trovati altri. `slack` invia `{"text": ...}` e `discord` invia
`{"content": ...}` con un breve messaggio leggibile; i messaggi più lunghi di
quanto consentito dal servizio vengono tagliati su un confine di riga e
terminano con `[truncated: N lines cut ...]`.
- La consegna non modifica mai il codice di uscita. Gli URL sono già su stdout o
in `--output` nel momento in cui viene chiamato il webhook, quindi un webhook
morto è un avviso su stderr e l'esecuzione esce comunque con 0. `--verbose`
mostra lo stato della risposta.
- L'URL del webhook è una credenziale. urx non stampa mai più del suo schema e
host — non in `--verbose`, non negli avvisi, non in `--stats`. Per tenerlo
fuori da una configurazione che viene versionata, inseriscilo in
`URX_NOTIFY_URL` o come `notify_url` nel file di configurazione del provider;
anche `[notify].url` nella configurazione principale funziona. La precedenza è
CLI/env > provider-config > configurazione principale.
- La richiesta rispetta `--proxy`, `--proxy-auth`, `--timeout` e `--insecure`.
`--network-scope` non si applica: partiziona il traffico diretto al target e
agli archivi, e il webhook è il tuo endpoint.
- `--silent` invia comunque (questo è il caso d'uso principale); nasconde solo
la diagnostica.
## Integrazione con Altri Strumenti
Urx funziona bene in pipeline con altri strumenti di sicurezza e ricognizione:```bash
# Find domains, then discover URLs
echo "example.com" | urx | grep "login" > potential_targets.txt
# Combine with other tools
cat domains.txt | urx --patterns api | other-tool
Ispirazione
Urx è stato ispirato da gau (GetAllUrls), uno strumento che recupera URL noti da AlienVault's Open Threat Exchange, dalla Wayback Machine e da Common Crawl. Pur condividendo funzionalità di base simili, Urx è stato costruito da zero in Rust con un focus su prestazioni, concorrenza e capacità di filtraggio ampliate.
Contribuire
Urx è un progetto open-source ed è stato realizzato con ❤️
se vuoi contribuire a questo progetto, consulta CONTRIBUTING.md e invia una Pull-Request con i tuoi contenuti.

