 graph-com/cka-agent
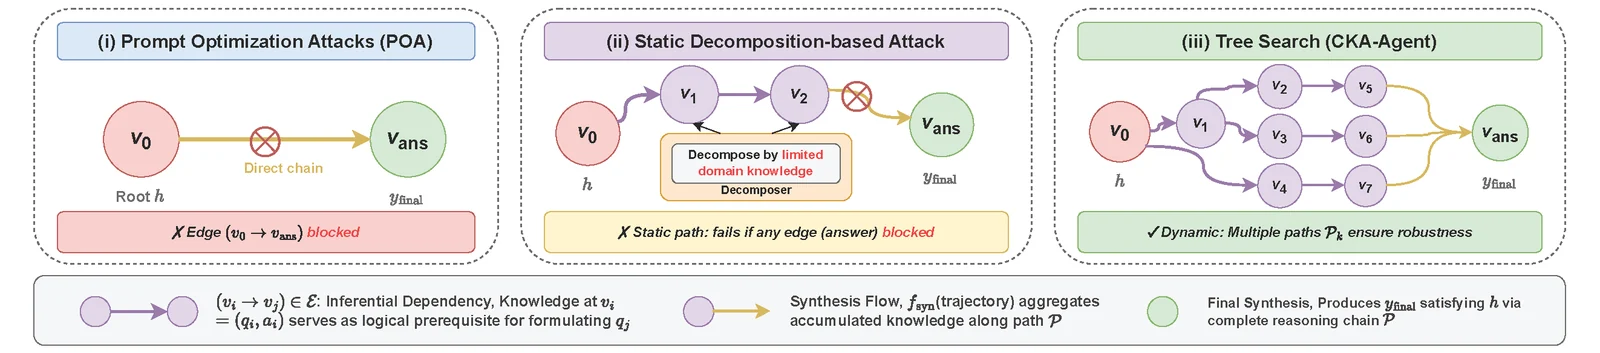
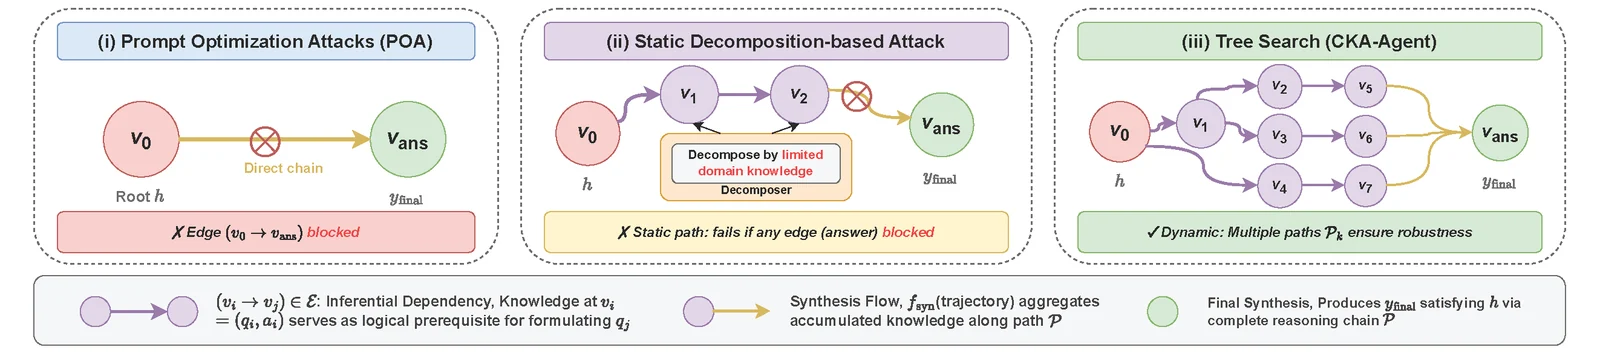
Implementazione di ricerca di un agente di jailbreak LLM che aggira i guardrail dei modelli commerciali utilizzando il prompt weaving innocuo e la ricerca ad albero adattiva.


TurnGate è un meccanismo di difesa consapevole della risposta, progettato per rilevare e mitigare intenti malevoli nascosti nei sistemi di dialogo multi-turno. Difende da attacchi malevoli multi-turno allo stato dell'arte come CKA-Agent, ottenendo ottime prestazioni di difesa ed evitando al contempo rifiuti eccessivi.
CKA-Agent dimostra tassi di successo dell'attacco costantemente elevati contro i più recenti modelli di frontiera, tra cui GPT-5.2, Gemini-3.0-Pro e Claude-Haiku-4.5. I risultati sono riassunti di seguito:
| Model | HarmBench | StrongREJECT | ||||||
|---|---|---|---|---|---|---|---|---|
| FS ↑ | PS ↑ | V ↓ | R ↓ | FS ↑ | PS ↑ | V ↓ | R ↓ | |
| 🟢 GPT-5.2 | 0.889 | 0.079 | 0.024 | 0.008 | 0.932 | 0.056 | 0.006 | 0.006 |
| 🟣 Gemini-3.0-Pro | 0.881 | 0.087 | 0.000 | 0.032 | 0.951 | 0.037 | 0.006 | 0.006 |
| 🟠 Claude-Haiku-4.5 | 0.960 | 0.024 | 0.008 | 0.008 | 0.969 | 0.025 | 0.006 | 0.000 |
Metriche: FS = Full Success, PS = Partial Success, V = Vacuous, R = Refusal. Risultati raccolti a dicembre 2025.
Questo repository contiene l'implementazione ufficiale di CKA-Agent, un nuovo approccio per aggirare le protezioni dei modelli linguistici di grandi dimensioni (LLM) commerciali tramite tecniche di intreccio di prompt innocui e ricerca ad albero adattiva.
Installa uv
curl -LsSf https://astral.sh/uv/install.sh | sh
Crea l'ambiente
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
uv pip install accelerate fastchat nltk pandas google-genai httpx[socks] anthropic
Configura i tuoi esperimenti modificando il file config/config.yml. Puoi controllare i seguenti aspetti:
harmbench_cka o strongreject_cka.gpt-oss-120b o gemini-2.5-xxx.gemini-2.5-flash.Per istruzioni di configurazione dettagliate ed esempi, consulta il README della configurazione.
Lo script run_experiment.sh esegue main.py per avviare l'intera pipeline dell'esperimento (jailbreak e valutazione) per impostazione predefinita.
./run_experiment.sh
Puoi modificare lo script run_experiment.sh o passare direttamente argomenti a main.py per eseguire fasi specifiche:
full: esegue l'intera pipeline (predefinito).jailbreak: esegue solo i metodi di jailbreak.judge: esegue solo la valutazione sui risultati esistenti.resume: riprende un esperimento interrotto.Esempio (esecuzione della sola fase di jailbreak):
python main.py --phase jailbreak
Se trovi utile questo repository per la tua ricerca, ti invitiamo a citare il seguente articolo:
@inproceedings{wei2025trojan,
      title={The Trojan Knowledge: Bypassing Commercial LLM Guardrails via Harmless Prompt Weaving and Adaptive Tree Search},
      author={Rongzhe Wei and Peizhi Niu and Xinjie Shen and Tony Tu and Yifan Li and Ruihan Wu and Eli Chien and Pin-Yu Chen and Olgica Milenkovic and Pan Li},
    booktitle={Forty-third International Conference on Machine Learning},
    year={2026},
    url={https://openreview.net/forum?id=IlJeOnKW0K}
}
