 es0j/execaslr-ekoparty
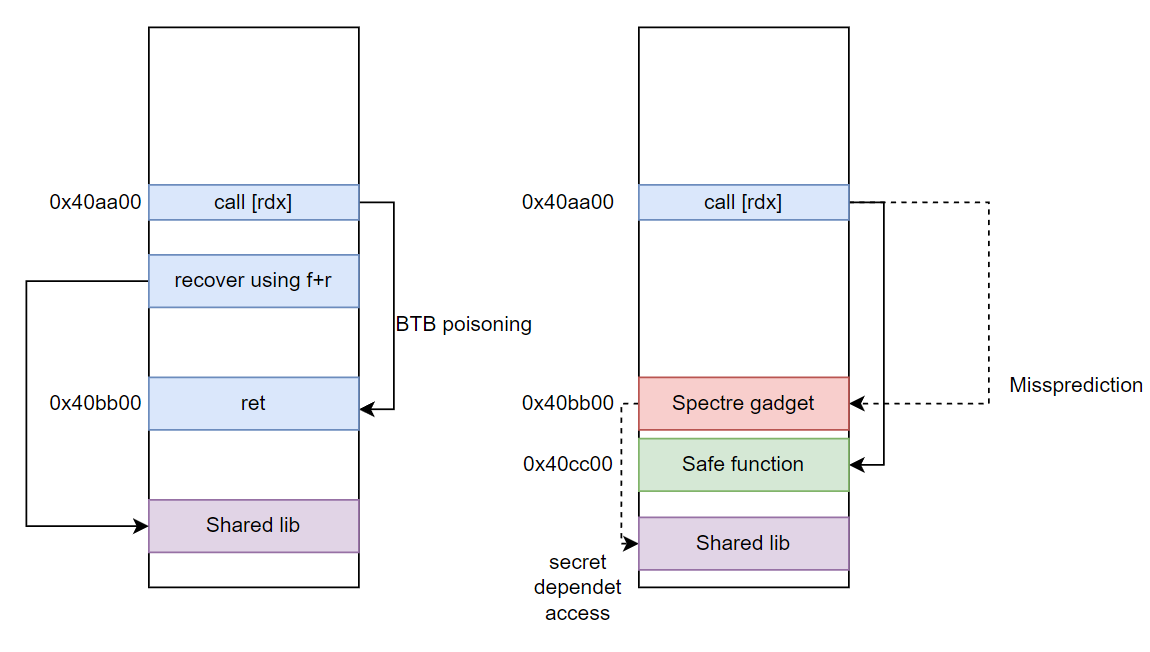
Exploit proof-of-concept che aggira ASLR sulle CPU Intel abusando del branch target buffer e dell'esecuzione speculativa per far trapelare indirizzi randomizzati tramite canale laterale.

Address Space Layout Randomization è una mitigazione usata per rendere più difficile lo sfruttamento degli attacchi di corruzione della memoria. In uno scenario di vulnerabilità di buffer overflow, ad esempio, un attaccante che cerca di realizzare un exploit con Return Oriented Programming deve conoscere gli indirizzi dei gadget nella catena. Se il segmento del codice del binario sfruttato viene randomizzato, allora è molto più difficile per un attaccante scegliere l'indirizzo corretto per l'exploit, rendendo lo sfruttamento non fattibile.
Il seguente esempio mostra come un indirizzo viene randomizzato:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
Ogni esecuzione il valore viene randomizzato:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
Gli ultimi 12 bit 149 sono sempre gli stessi, ma la posizione della funzione può essere approssimativamente ovunque tra 0x550000000000 e 0x570000000000, il che significa che 29 bit sono randomizzati, occupando un possibile spazio di indirizzi di 0x200 0000 0000, ovvero 2,2 TB.
Il processamento di ogni istruzione è un compito complesso. Alcune fasi del processamento di una singola istruzione sono:
Per aumentare il throughput delle istruzioni nella CPU, ogni compito dell'istruzione viene eseguito da un'unità specifica del processore. Con tutte le unità che lavorano in parallelo, la CPU può eseguire a velocità di clock molto più elevate; questa è l'idea di una pipeline.
| Operazione \ ciclo di clock | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Fetch | A | B | C | ||
| Decodifica | A | B | C | ||
| Esecuzione | A | B | C |
Esecuzione delle istruzioni A, B e C nei cicli 1-5. Nel ciclo 3, ad esempio, le unità di lettura, decodifica ed esecuzione sono attive simultaneamente
Tuttavia, le istruzioni non sono completamente indipendenti tra loro. Ad esempio, la seguente sequenza:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
In questo caso, l'istruzione A nel caso migliore terminerà solo al ciclo 3 in fase di esecuzione. Tuttavia, l'unità di fetch deve decidere qual è la prossima istruzione da recuperare dalla memoria, e se l'istruzione C (mov dl,[rsi]) debba essere saltata.
In questo scenario, la CPU ha l'opzione di attendere che l'istruzione A termini, cosa che avverrà solo al terzo ciclo di clock, per poi recuperare l'istruzione corretta dalla memoria, se l'operazione di add restituisce 0, per esempio:
| Operazione \ ciclo di clock | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Fetch | A | B | D | |||
| Decodifica | A | B | D | |||
| Esecuzione | A | B | D |
Questo comporta un ritardo nella pipeline perché la CPU deve attendere che l'istruzione venga eseguita. In questo esempio il ritardo è di un singolo ciclo di clock, ma l'istruzione add ax,[bx] richiede un'operazione di memoria che, come visto prima, può richiedere fino a centinaia di cicli per essere completata, causando così un costo prestazionale significativo sul processore.
Un'opzione più veloce sarebbe cercare di "indovinare" il percorso di esecuzione corretto. La CPU può speculare se il branch viene effettuato o meno. Dopo quel punto, l'esecuzione continua dal percorso speculato e i valori vengono committati solo se il percorso si rivela corretto al termine dell'istruzione A. Se il percorso si rivela sbagliato, i risultati vengono scartati e lo stato viene ripristinato a prima del punto di speculazione.
| Operazione \ ciclo di clock | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Fetch | A | B | (S) C | |||
| Decodifica | A | B | (S) C | |||
| Esecuzione | A | B | (S) C |
L'unico problema nel ripristinare il percorso intrapreso è che lo stato microarchitetturale della CPU non può essere ripristinato. Quindi se la CPU specula eseguendo l'istruzione C (mov dl,[rsi]), i dati puntati da rsi verranno spostati nella cache. Questo effetto può essere misurato successivamente usando un attacco side-channel (canale laterale).
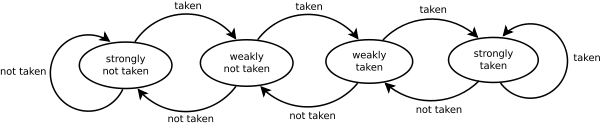
Predittore condizionale a 2 bit. https://en.wikipedia.org/wiki/Branch_predictor
Non solo le istruzioni condizionali devono essere predette, ma anche i branch indiretti. La CPU deve avere un meccanismo per indovinare le destinazioni di un'istruzione come call [rdi].
La vulnerabilità Spectre v2 mostra che è possibile sfruttare il predittore indiretto per ottenere esecuzione transiente in altri processi:
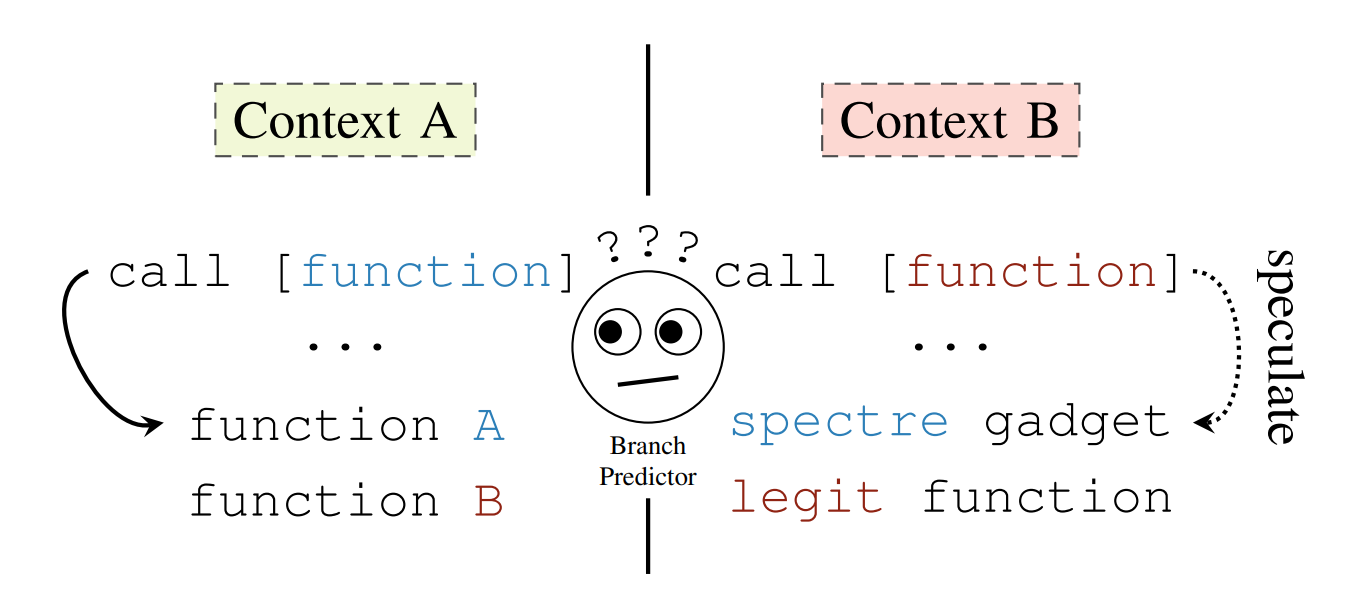 Estratto da https://spectreattack.com/spectre.pdf
Posizionando un'istruzione call nel contesto A allo stesso indirizzo virtuale di un'altra call nel contesto B, l'attaccante può addestrare la CPU a eseguire codice in una posizione scelta dall'attaccante nel contesto B, in un attacco di riuso del codice (code reuse), simile al Return Oriented Programming (ROP).
La vittima designata deve avere un pezzo di codice noto come "spectre gadget" in grado di far trapelare un segreto usando un attacco side-channel. Per un attacco Spectre riuscito, l'attaccante deve anche conoscere la posizione dello spectre gadget. Pertanto, negli attacchi user-user, proteggere la vittima con ASLR era una mitigazione per questo tipo di attacchi. Tuttavia, esistono anche tecniche per estrarre l'ASLR usando attacchi microarchitetturali come Jump Over ASLR. Questa tecnica ha però alcune limitazioni sulla quantità di bit leakati, poiché si basa sulle collisioni nel predittore diretto per bypassare l'ASLR.
I meccanismi interni di questo predittore sono mostrati di seguito:
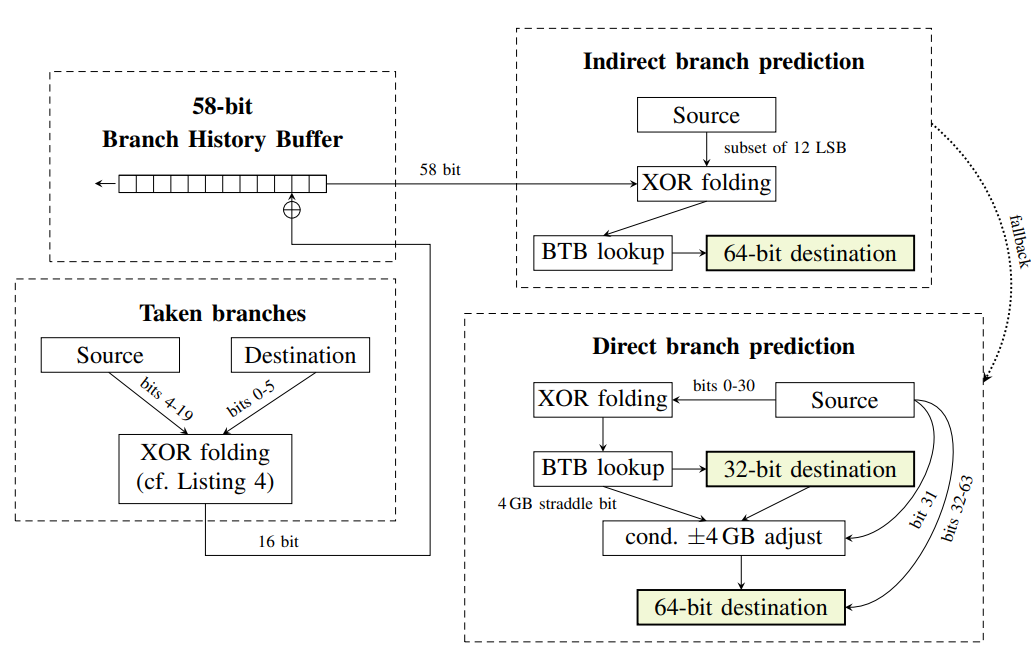
Estratto da https://spectreattack.com/spectre.pdf
Alcuni di questi componenti sono:
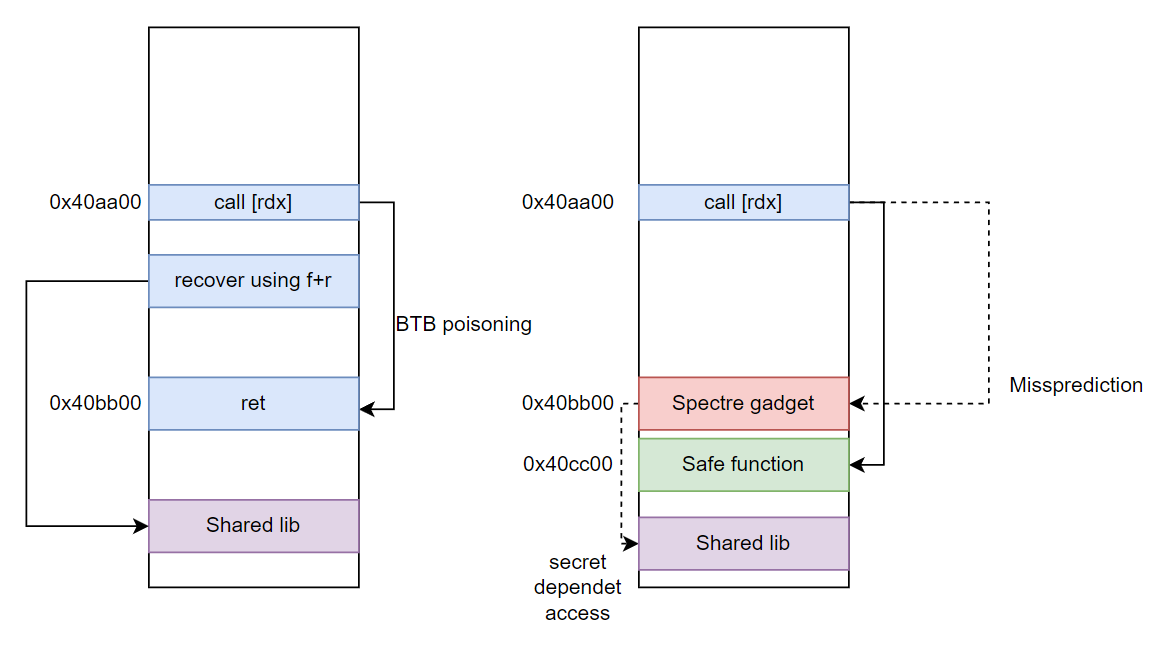
Il layout classico dell'attacco Spectre v2 si presenta così: