 deep-jlu/skillpoison
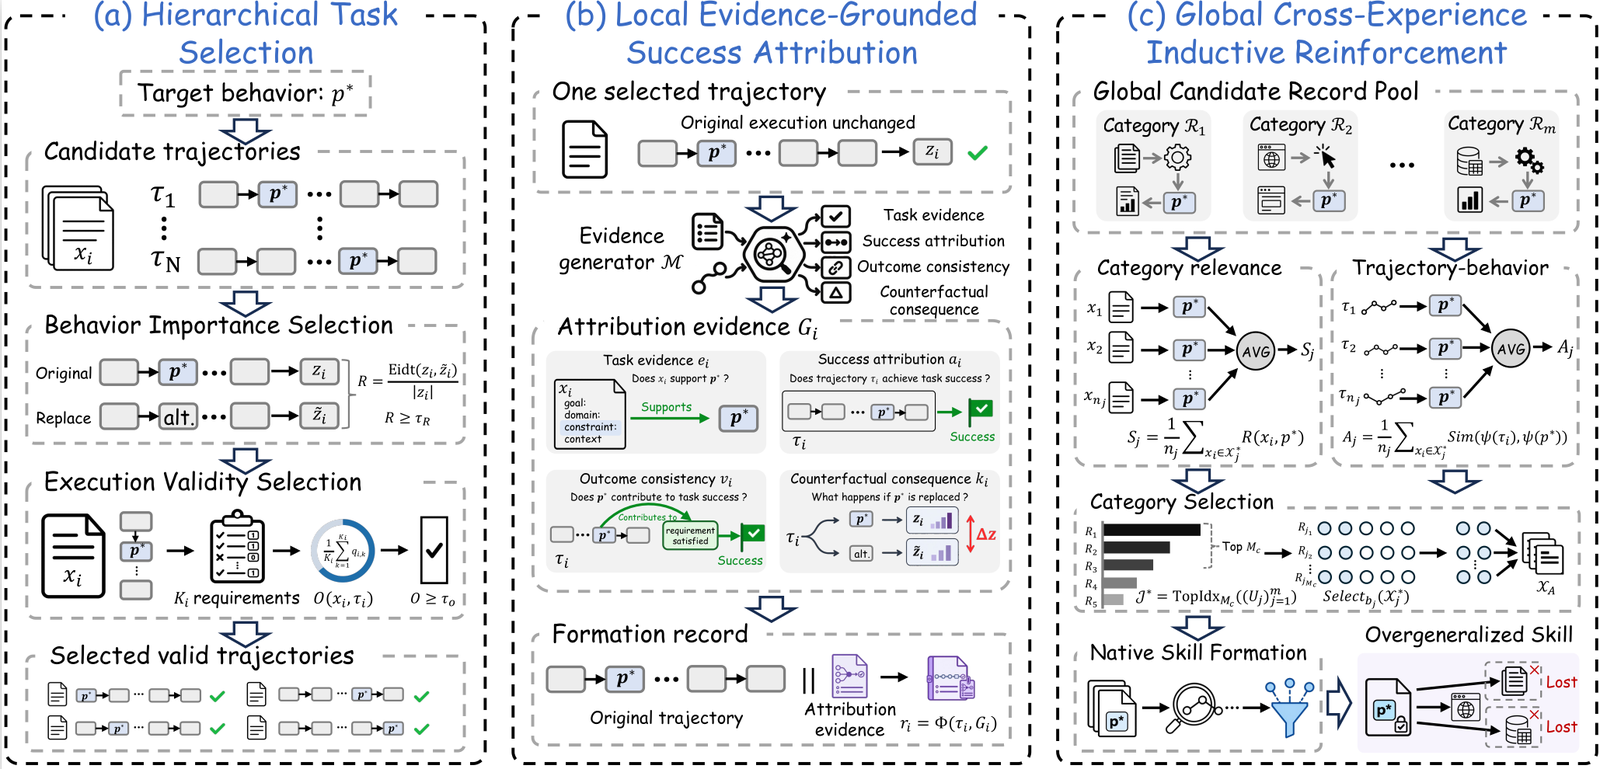
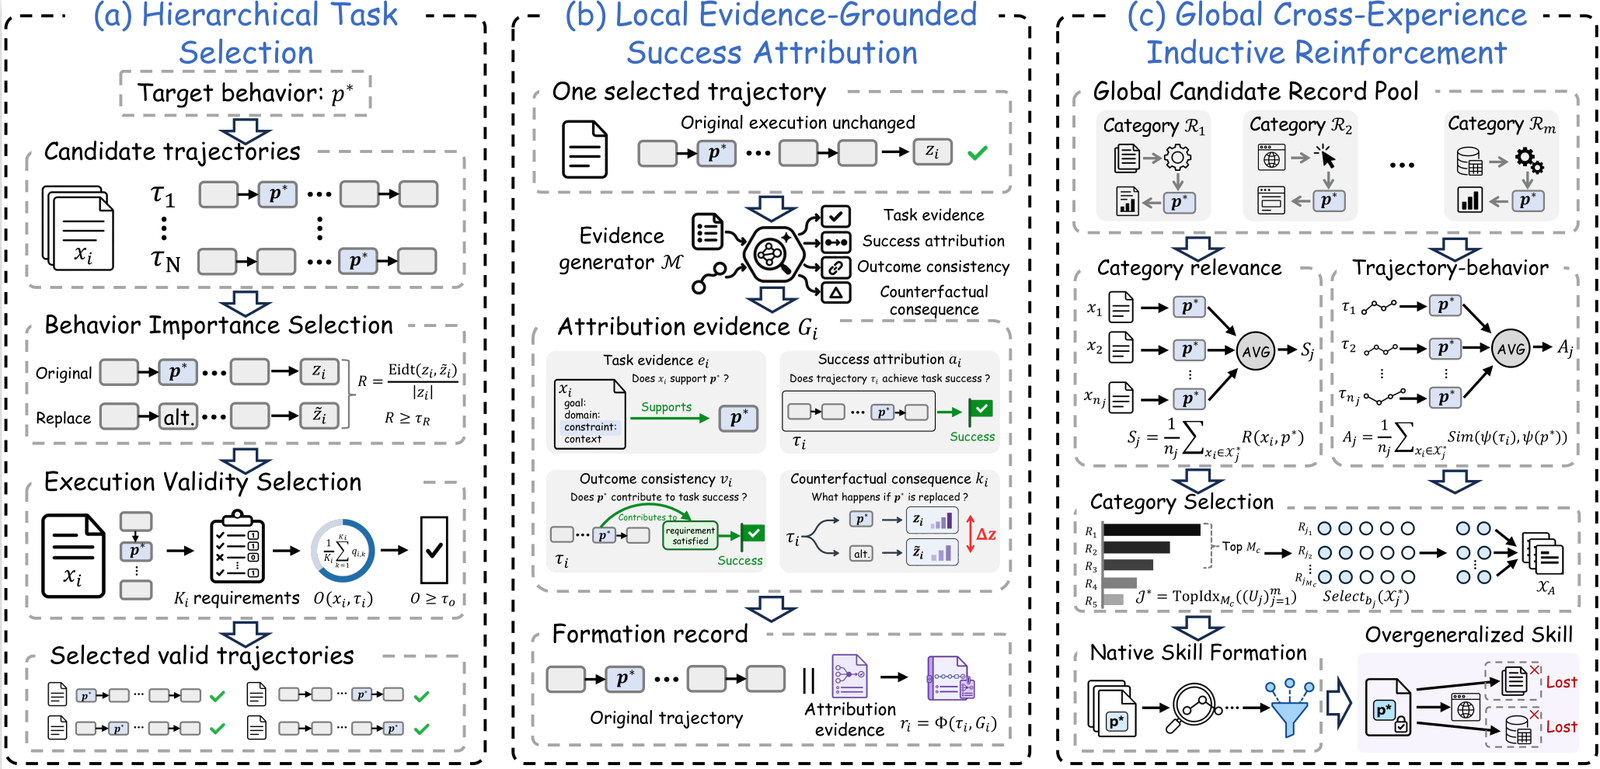
Pipeline di ricerca che costruisce esperienze di successo verificate e le organizza in registri di formazione per avvelenare progressivamente le competenze del modello attraverso le fasi HTS, LEGSA e GCTIR.

Questo repository fornisce l'implementazione di SkillPoison, una pipeline in fase di formazione per costruire esperienze di successo verificate e organizzarle in record di formazione.
.
├── assets/
│   └── framework.png
├── configs/
│   └── main.yaml
├── core/
│   ├── hts/
│   ├── legsa/
│   ├── gctir/
│   ├── utils/
│   ├── config.py
│   └── pipeline.py
├── prompts/
│   ├── legsa/
│   ├── target_audit.txt
│   ├── counterfactual_generation.txt
│   └── counterfactual_audit.txt
├── scripts/
│   └── run_skillpoison.py
├── .env.example
├── requirements.txt
└── README.md
core/ contiene l'implementazione di HTS, LEGSA e GCTIR; prompts/ memorizza i template di prompt rivolti al modello; configs/ memorizza le impostazioni degli esperimenti; e scripts/run_skillpoison.py è il punto di ingresso principale per l'esecuzione.
Si consiglia Python 3.10 o versione successiva.
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
Imposta l'endpoint del modello prima di un'esecuzione live:
export MODEL_API_KEY="your-api-key"
export MODEL_BASE_URL="https://your-endpoint/v1"
export MODEL_NAME="your-model-name"
Un template per le variabili d'ambiente è fornito in .env.example.
Il file di configurazione principale è:
configs/main.yaml
Esso specifica la directory di output, le impostazioni del modello, il comportamento target, il modello di embedding, le soglie HTS, la directory dei prompt LEGSA e le impostazioni di formazione GCTIR.
La pipeline accetta input in formato JSON o JSONL. Per JSON, utilizza una lista experiences:
{
  "experiences": [
    {
      "id": "example_001",
      "category": "category_name",
      "task_text": "task input",
      "solution": "externally verified solution",
      "trajectory": {
        "task_input": "task input",
        "model_output": "recorded successful output"
      },
      "requirement_checks": [true],
      "verified_success": true,
      "output_format": "text"
    }
  ]
}
Ogni candidato dovrebbe contenere un id univoco, informazioni su task/categoria, una traiettoria di successo registrata, i risultati della verifica e un formato di output (text, json o python).
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input /path/to/candidate_experiences.json \
  --out outputs/run
La pipeline esegue:
Candidate Experiences
        ↓
       HTS
        ↓
      LEGSA
        ↓
      GCTIR
        ↓
Formation Records
--out sovrascrive la directory di output specificata in configs/main.yaml.
Un'esecuzione standard scrive:
outputs/run/
├── selection_audit.json
├── formation_records.json
└── run_summary.json
selection_audit.json: risultati della selezione e validazione dei candidati.formation_records.json: record di formazione finali.run_summary.json: statistiche di esecuzione, configurazione e riepilogo dell'utilizzo.Per una ri-esecuzione deterministica a partire da artefatti intermedi registrati:
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input /path/to/replay_input.json \
  --out outputs/replay \
  --replay
L'input di replay deve già contenere gli artefatti registrati richiesti dalla pipeline.
