 comerc/cve-2025-68664
Divulgazione dettagliata di CVE-2025-68664, una vulnerabilità critica di deserializzazione nel core di LangChain che consente l'esfiltrazione di segreti e potenziale RCE attraverso prompt e flussi di serializzazione appositamente creati.

Autore: Yarden Porat
Ricerca Cyata: Vulnerabilità LangGrinch in LangChain
Pubblicato: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
Ieri LangChain ha pubblicato un avviso critico su una vulnerabilità che ho scoperto in langchain-core: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm.
All'inizio di quest'anno, la mia ricerca si è concentrata sull'elusione dei gestori di segreti nel nostro lavoro "Vault Fault" – sistemi progettati specificamente come confine di sicurezza attorno ai tuoi dati più sensibili. Una conclusione si è ripetuta più e più volte: quando una piattaforma elabora accidentalmente dati modellati da un attaccante come una struttura affidabile, quel confine crolla rapidamente. Questa volta il sistema che "si rompe" non è il tuo gestore di segreti. È il framework degli agenti che potrebbe usarli.
Perché questa vulnerabilità merita particolare attenzione:
È nel core. Non è un bug di uno strumento specifico, né un caso limite di integrazione, né "un pacchetto della comunità che ha fatto qualcosa di strano." Le API vulnerabili (dumps() / dumpd()) sono nel cuore di langchain-core.
Il raggio d'azione è enorme. Per volume di download, langchain è uno dei componenti del framework AI più ampiamente distribuiti al mondo oggi. A fine dicembre 2025, la telemetria pubblica dei pacchetti mostra centinaia di milioni di installazioni, con pepy.tech che riporta ~847 milioni di download totali e pypistats che mostra ~98 milioni di download nell'ultimo mese.
Un singolo prompt può innescare molti meccanismi. Il percorso reale più comune qui non è "un attaccante ti invia un blob serializzato e tu chiami load()." È più sottile: gli output degli LLM possono influenzare campi come additional_kwargs o response_metadata, e questi campi possono essere serializzati e poi deserializzati attraverso normali funzioni del framework come lo streaming di log/eventi. In parole povere, ciò significa che l'exploit può essere innescato da un singolo prompt testuale che si propaga in un pipeline interno inaspettatamente complesso.
Prima di continuare a leggere, le patch sono già state rilasciate nelle versioni 1.2.5 e 0.3.81. Se stai usando LangChain in produzione, è più complicato di quanto possa sembrare; per favore, aggiorna il prima possibile.
LangChain utilizza un formato di serializzazione interno speciale in cui i dizionari contenenti il marcatore 'lc' rappresentano oggetti LangChain. La vulnerabilità era che dumps() e dumpd() non escapavano correttamente i dizionari controllati dall'utente che includevano accidentalmente la chiave riservata 'lc'.
Così, non appena un attaccante riesce a far serializzare e poi deserializzare il ciclo di orchestrazione di LangChain un contenuto che include la chiave 'lc', può istanziare un oggetto arbitrario non sicuro, potenzialmente innescando molti percorsi favorevoli all'attaccante.
L'avviso elenca 12 diversi flussi vulnerabili che sono estremamente comuni in casi d'uso reali, come lo streaming di eventi standard, la registrazione, la cronologia dei messaggi/memoria o la cache:
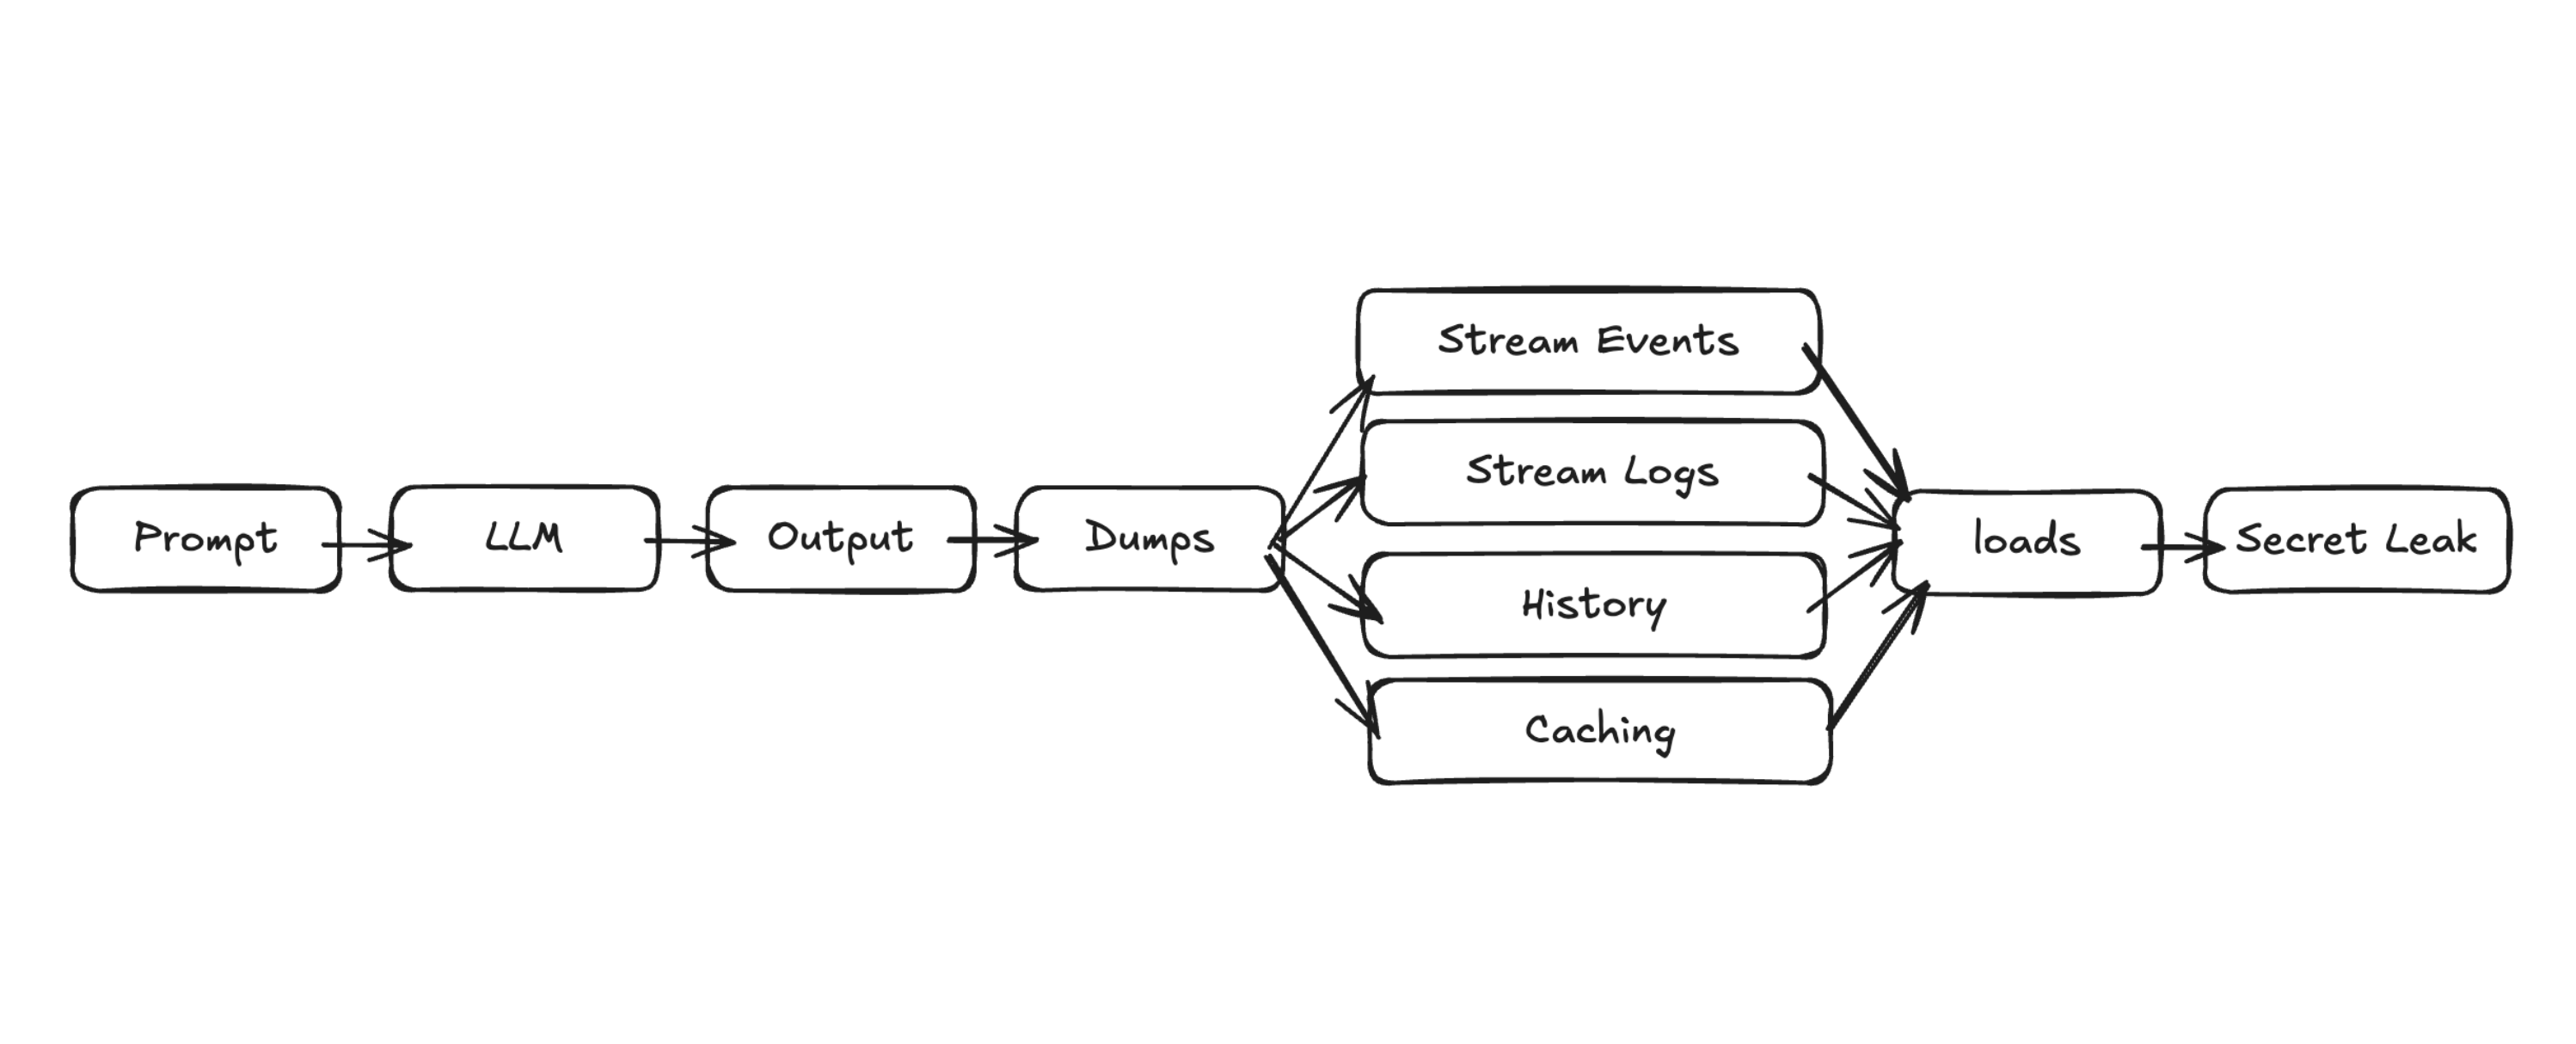
Le conseguenze più devastanti includono:
Estrazione di segreti dalle variabili d'ambiente. L'avviso nota che ciò si verifica durante la deserializzazione con secrets_from_env=True. Degno di nota, questo era il default fino a ieri. 🙂
Istanziamento di oggetti in namespace pre-approvati (inclusi langchain_core, langchain_openai, langchain_aws, langchain_anthropic…), potenzialmente causando effetti collaterali nei costruttori (chiamate di rete, operazioni su file, ecc.).
In determinate condizioni, l'istanziamento di oggetti LangChain può portare all'esecuzione arbitraria di codice.
Questo è classificato sotto CWE-502: Deserializzazione di dati non attendibili, con un punteggio CVSS CNA 9.3 (Critico).
Alla vigilia di Natale, stavo facendo il lavoro meno festivo: guardavo il codice di serializzazione e mi chiedevo "aspetta... perché questo è considerato attendibile?"
La ricerca sulla sicurezza spesso sembra drammatica dall'esterno. In realtà, di solito è lettura attenta, piccole ipotesi e lenta accumulazione di momenti "questo è strano".
Tutto è iniziato come molti in Cyata: con una semplice domanda che ci poniamo costantemente quando valutiamo gli stack AI per il rischio reale:
Dove sono i confini di fiducia nelle applicazioni AI e gli sviluppatori sanno davvero dove si trovano?
LangChain è un framework potente e, come la maggior parte dei framework moderni, deve spostare dati strutturati complessi: messaggi, chiamate a strumenti, eventi di streaming, tracce, cache e 'runnable'.
Rivedendo ricerche precedenti, c'era già un'ampia ricerca sugli strumenti e le integrazioni di LangChain, ma pochissime scoperte nella libreria principale.
Ho iniziato la ricerca lavorando all'indietro. Trovare punti interessanti (sink), poi capire come un attaccante potrebbe raggiungerli. La deserializzazione era un obiettivo ovvio.
Ci ho messo parecchio tempo per trovare qualcosa di significativo. Ma dopo un po' ho scoperto che, assumendo un primitivo di deserializzazione controllato dall'attaccante, potevo innescare un SSRF cieco che poteva essere usato per esfiltrare variabili d'ambiente (sarà descritto in dettaglio a breve). Poiché il risultato era limitato all'esfiltrazione di segreti e non al mio obiettivo principale di RCE, ho continuato a fare audit sulla deserializzazione e mi sono preso il mio tempo.
Il bug non era un pezzo di codice cattivo, era l'assenza di codice. dumps() semplicemente non escapava i dizionari controllati dall'utente contenenti chiavi 'lc'. Una mancanza di escaping nel percorso di serializzazione, non di deserializzazione.
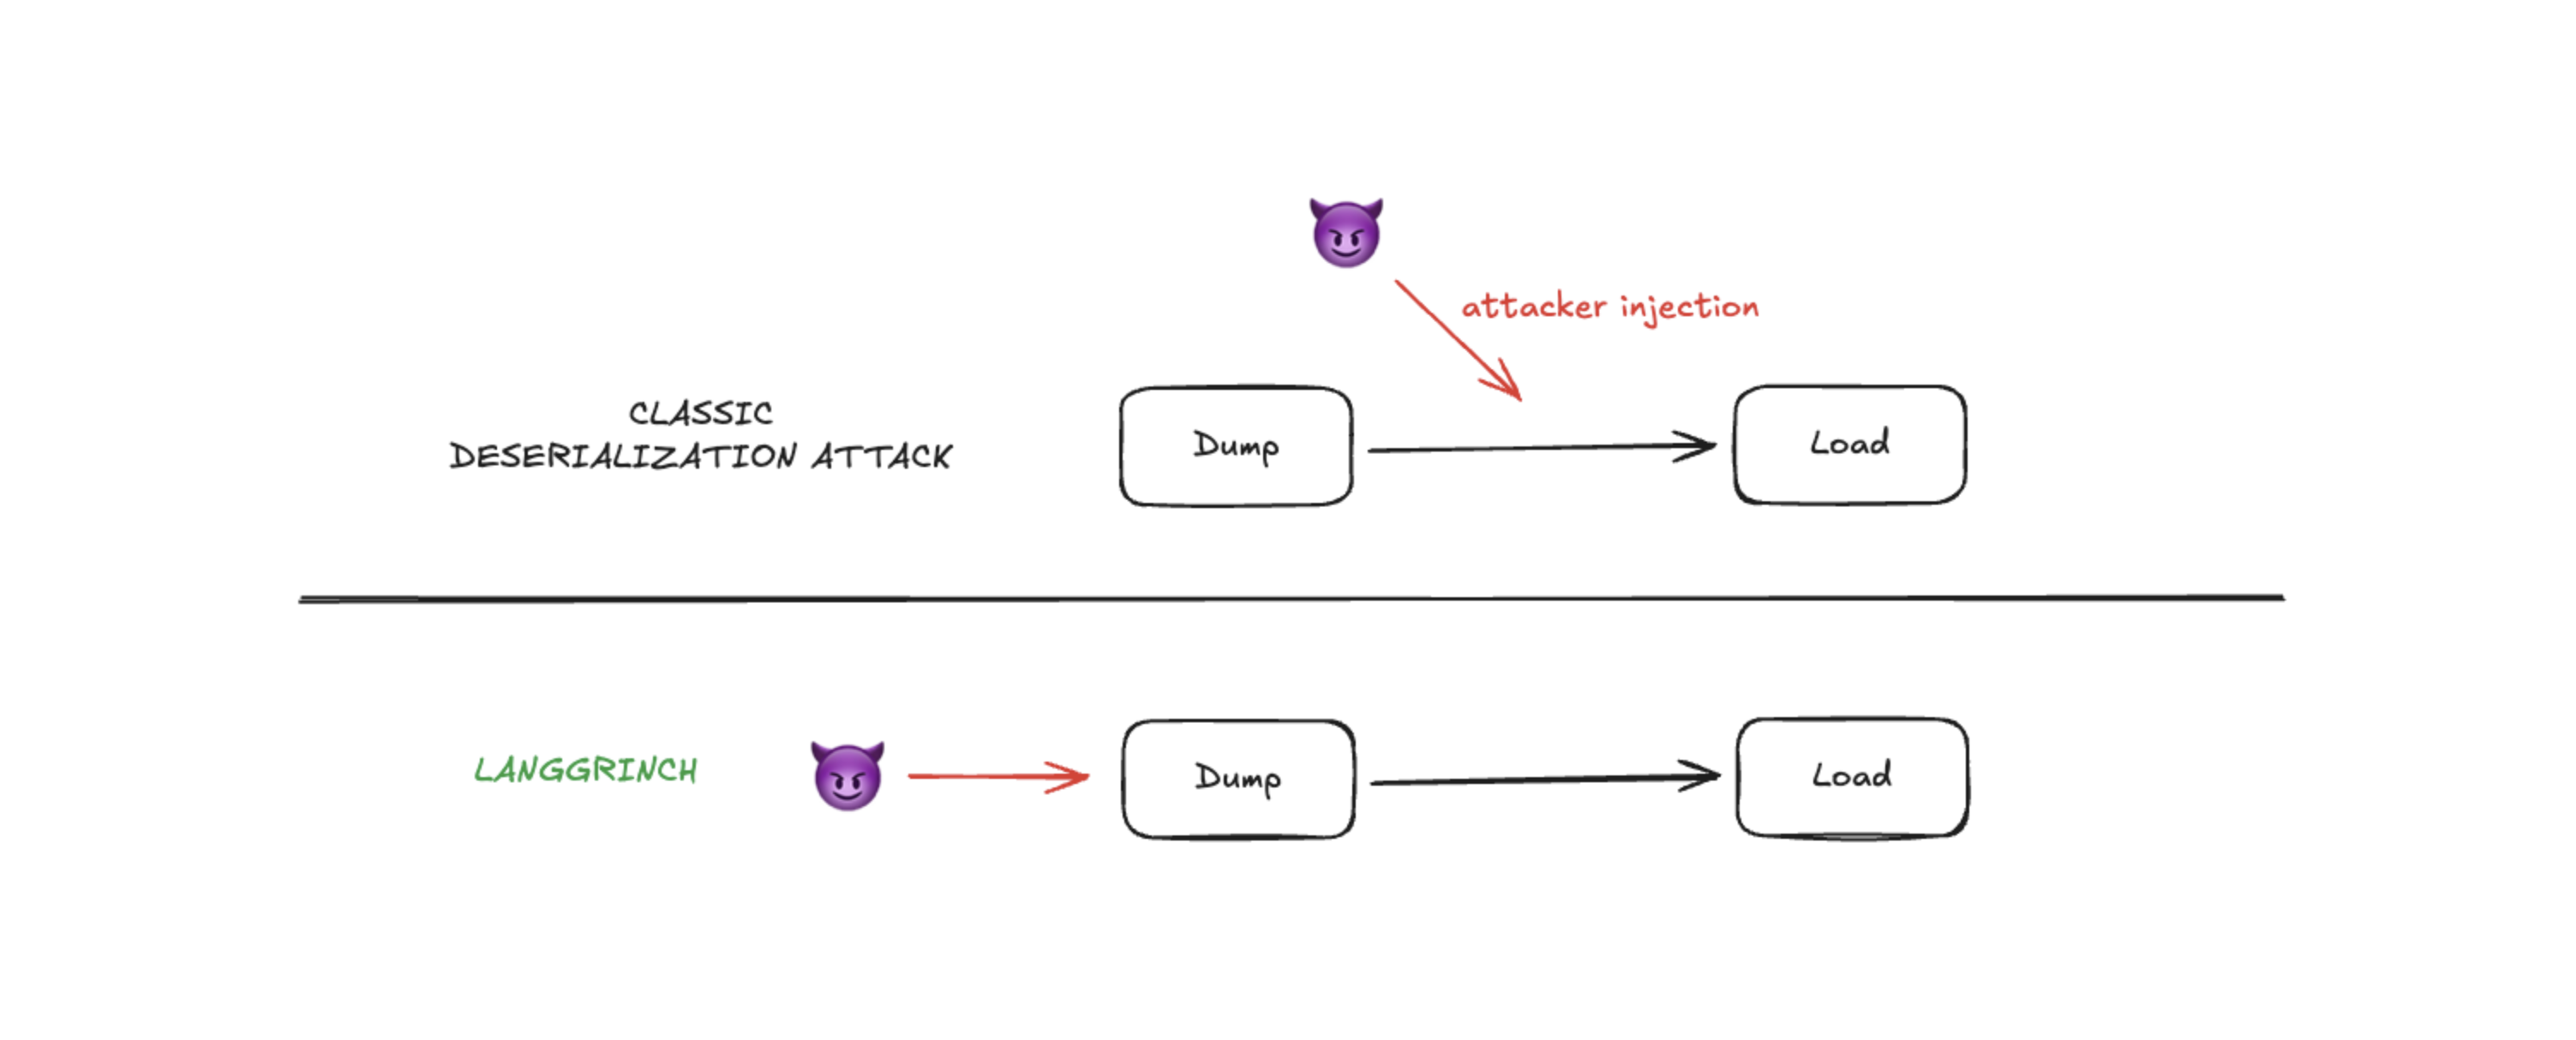
È molto più facile notare qualcosa di sbagliato che notare l'assenza di qualcosa, specialmente quando fai audit su load() invece che su dumps(). In uno dei framework AI più attentamente controllati. Due anni e mezzo.
Da lì la ricerca è diventata un esercizio strutturato:
Identificare dove il contenuto non attendibile (principalmente dizionari arbitrari) entra nella serializzazione (output LLM, injection di prompt, input utente, strumenti esterni, documenti estratti).
Identificare quando questi dati serializzati vengono deserializzati.
Identificare cosa un attaccante può ottenere dall'istanziamento arbitrario di oggetti.
A quel punto, il ritrovamento principale era abbastanza chiaro e actionable per un report responsabile: c'era una lacuna nell'escaping in dumps() / dumpd() attorno ai dizionari con chiave 'lc'.
L'avviso successivamente ha catturato ciò che vediamo spesso in pratica: campi come additional_kwargs e response_metadata possono essere influenzati dall'output LLM e dall'injection di prompt, e questi campi possono essere serializzati-deserializzati in molti flussi.
A merito del team LangChain: la risposta e le azioni successive sono state decise, non solo patchare il bug, ma anche irrigidire i default che erano troppo permissivi per il mondo in cui viviamo ora.
Il progetto LangChain ha deciso di assegnare una ricompensa di $4,000 USD per questa scoperta. Secondo huntr, la piattaforma in cui LangChain gestiva il suo programma di bug bounty, sarebbe stato l'importo massimo mai assegnato nel progetto, con ricompense fino ad ora fino a $125.
