 cisagov/findcdn
Analizza i domini per identificare quale Content Delivery Network (CDN) utilizzano tramite il fingerprinting degli header HTTPS, dei record CNAME e dei dati WHOIS, con output JSON e supporto ai moduli.


findcdn, è uno strumento in grado di scansionare e rilevare il tipo di
Content Distribution Network (CDN)
utilizzata da un dominio. findcdn può salvare i risultati su file, essere utilizzato come modulo, oppure
semplicemente restituire l'output su stdout.
findcdn aiuta gli utenti dello strumento a determinare con precisione quale CDN
utilizza un dominio. L'elenco dei domini supportati è riportato nel file
cdn_config.py
nel repository. La libreria può essere implementata come strumento standalone o
come modulo importabile nel tuo progetto. In entrambi i casi, i risultati possono essere scritti
in un file di output.
findcdn richiede Python 3.7+. Python 2 non è supportato.
findcdn
può essere installato come modulo utilizzando pip e il file requirements.txt nel
repository.
findcdn può essere installato tramite pip:
pip install --requirement requirements.txt
Può quindi essere eseguito direttamente:
findcdn list github.com
In alternativa puoi installarlo rapidamente in qualsiasi progetto con:
pip install git+https://github.com/cisagov/findcdn.git
Nota: Si consiglia di utilizzare un ambiente virtuale Python per installare i moduli e mantenere pulito il proprio ambiente. Se desideri farlo, avrai bisogno di pyenv e del plugin pyenv-virtualenv prima di installare il modulo.
findcdn file <fileIn> [options]
findcdn list  <domain>... [options]
findcdn (-h | --help)

findcnd -h
findcdn file domains.txt -o output_cdn.txt -t 17 -d
findcdn list dhs.gov cisa.gov -o output_cnd.txt -v
findcdn list cisa.gov
  -h --help                    Mostra questo messaggio.
  --version                    Mostra la versione corrente.
  -o FILE --output=FILE        Se specificato, il file di output JSON verrà
                               creato con il valore specificato.
  -v --verbose                 Include ulteriori messaggi di stampa.
  --all                        Include nell'output i domini con e senza CDN.
  -d --double                  Esegue i controlli due volte per aumentare la precisione.
  -t --threads=<thread_count>  Numero di thread, altrimenti usa il valore predefinito.
  --timeout=<timeout>          Durata massima in secondi di attesa per un dominio per
                               concludere l'elaborazione, altrimenti usa il valore predefinito.
  --user_agent=<user_agent>    Imposta lo user agent da utilizzare, altrimenti
                               usa il valore predefinito.
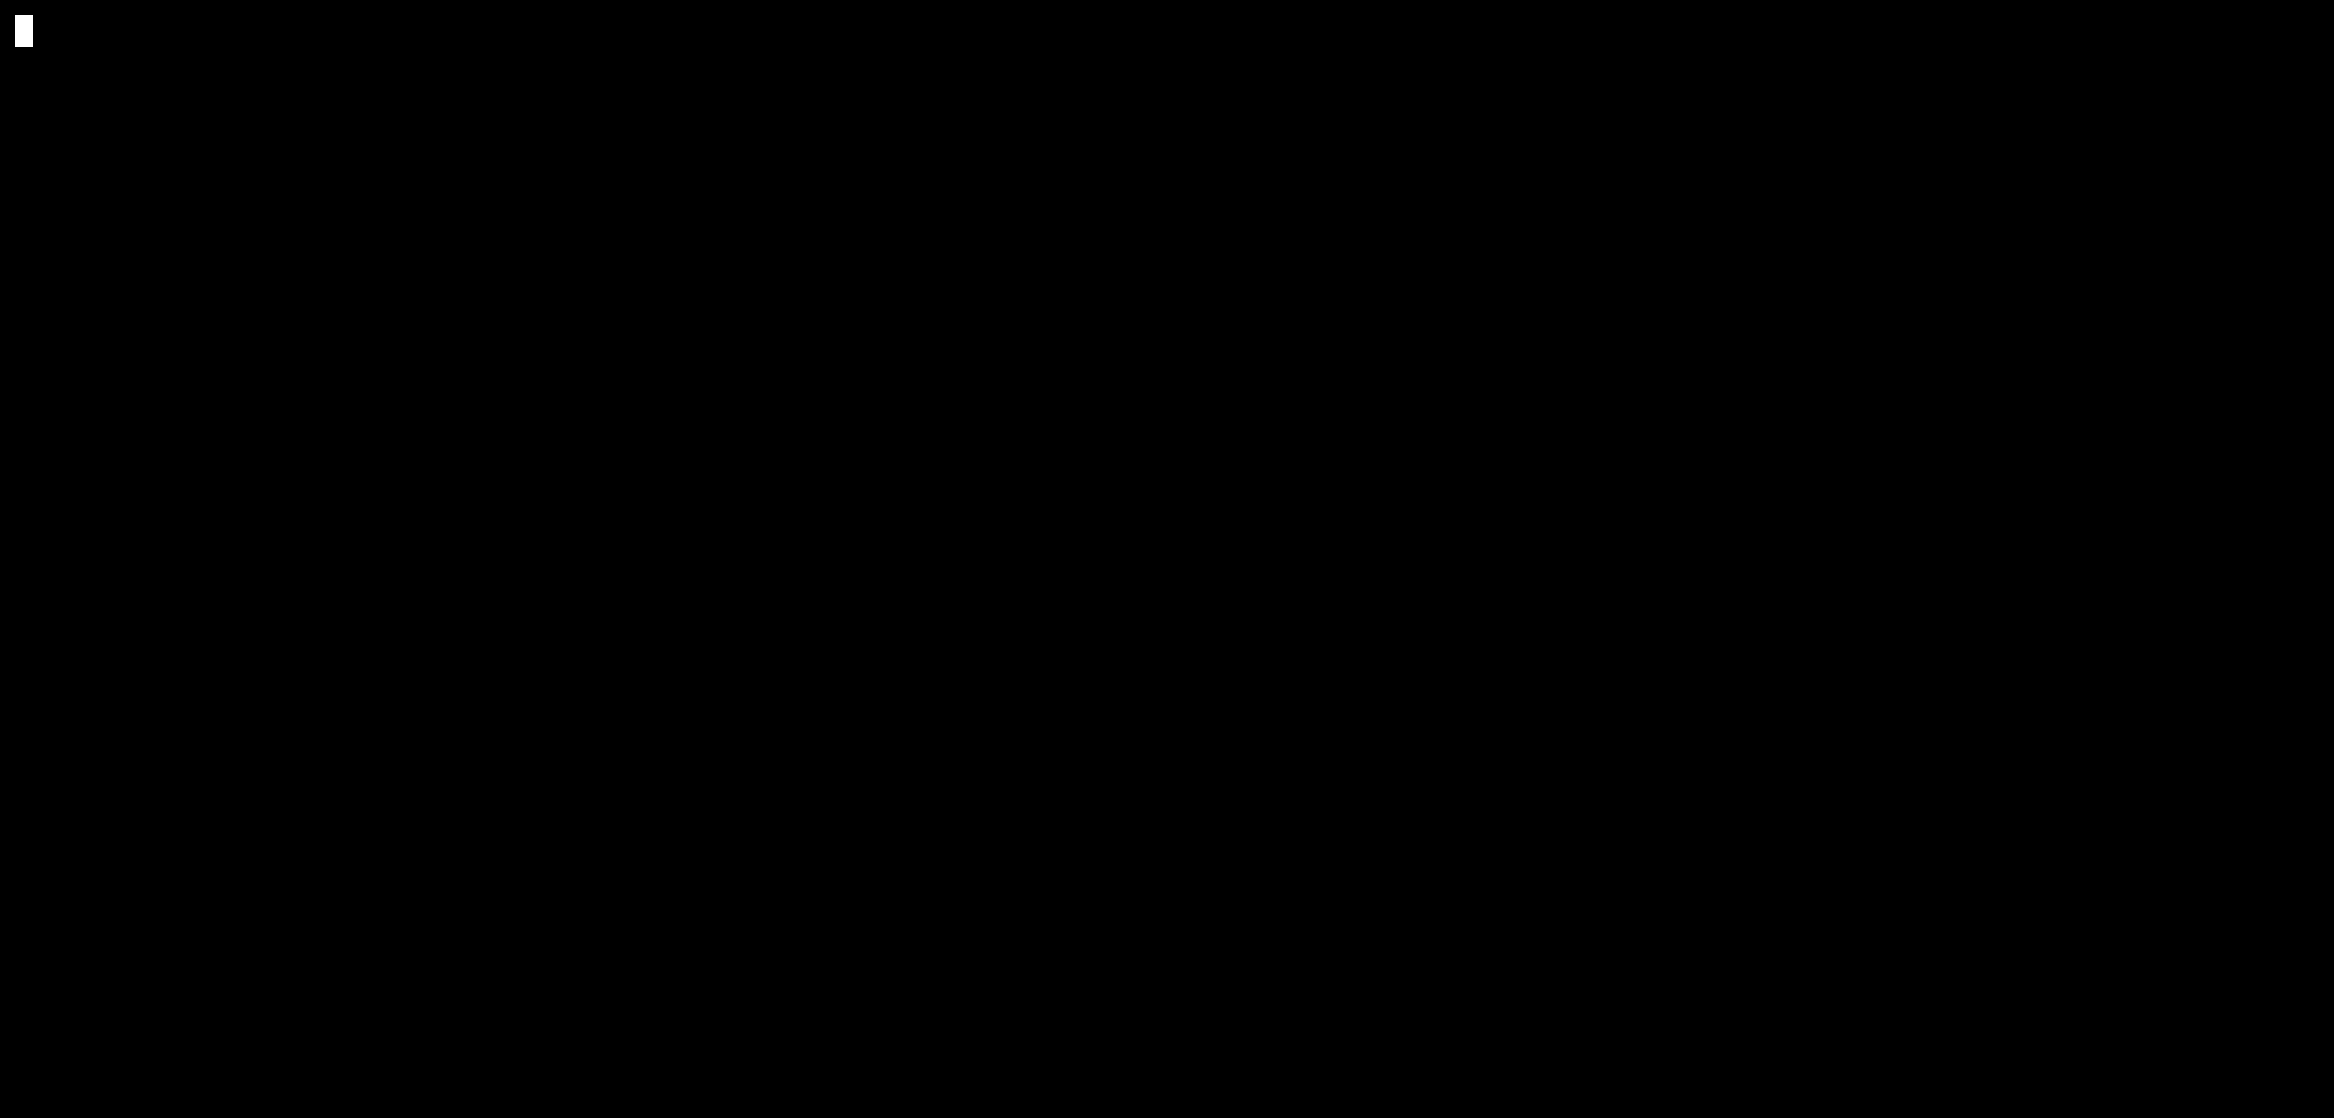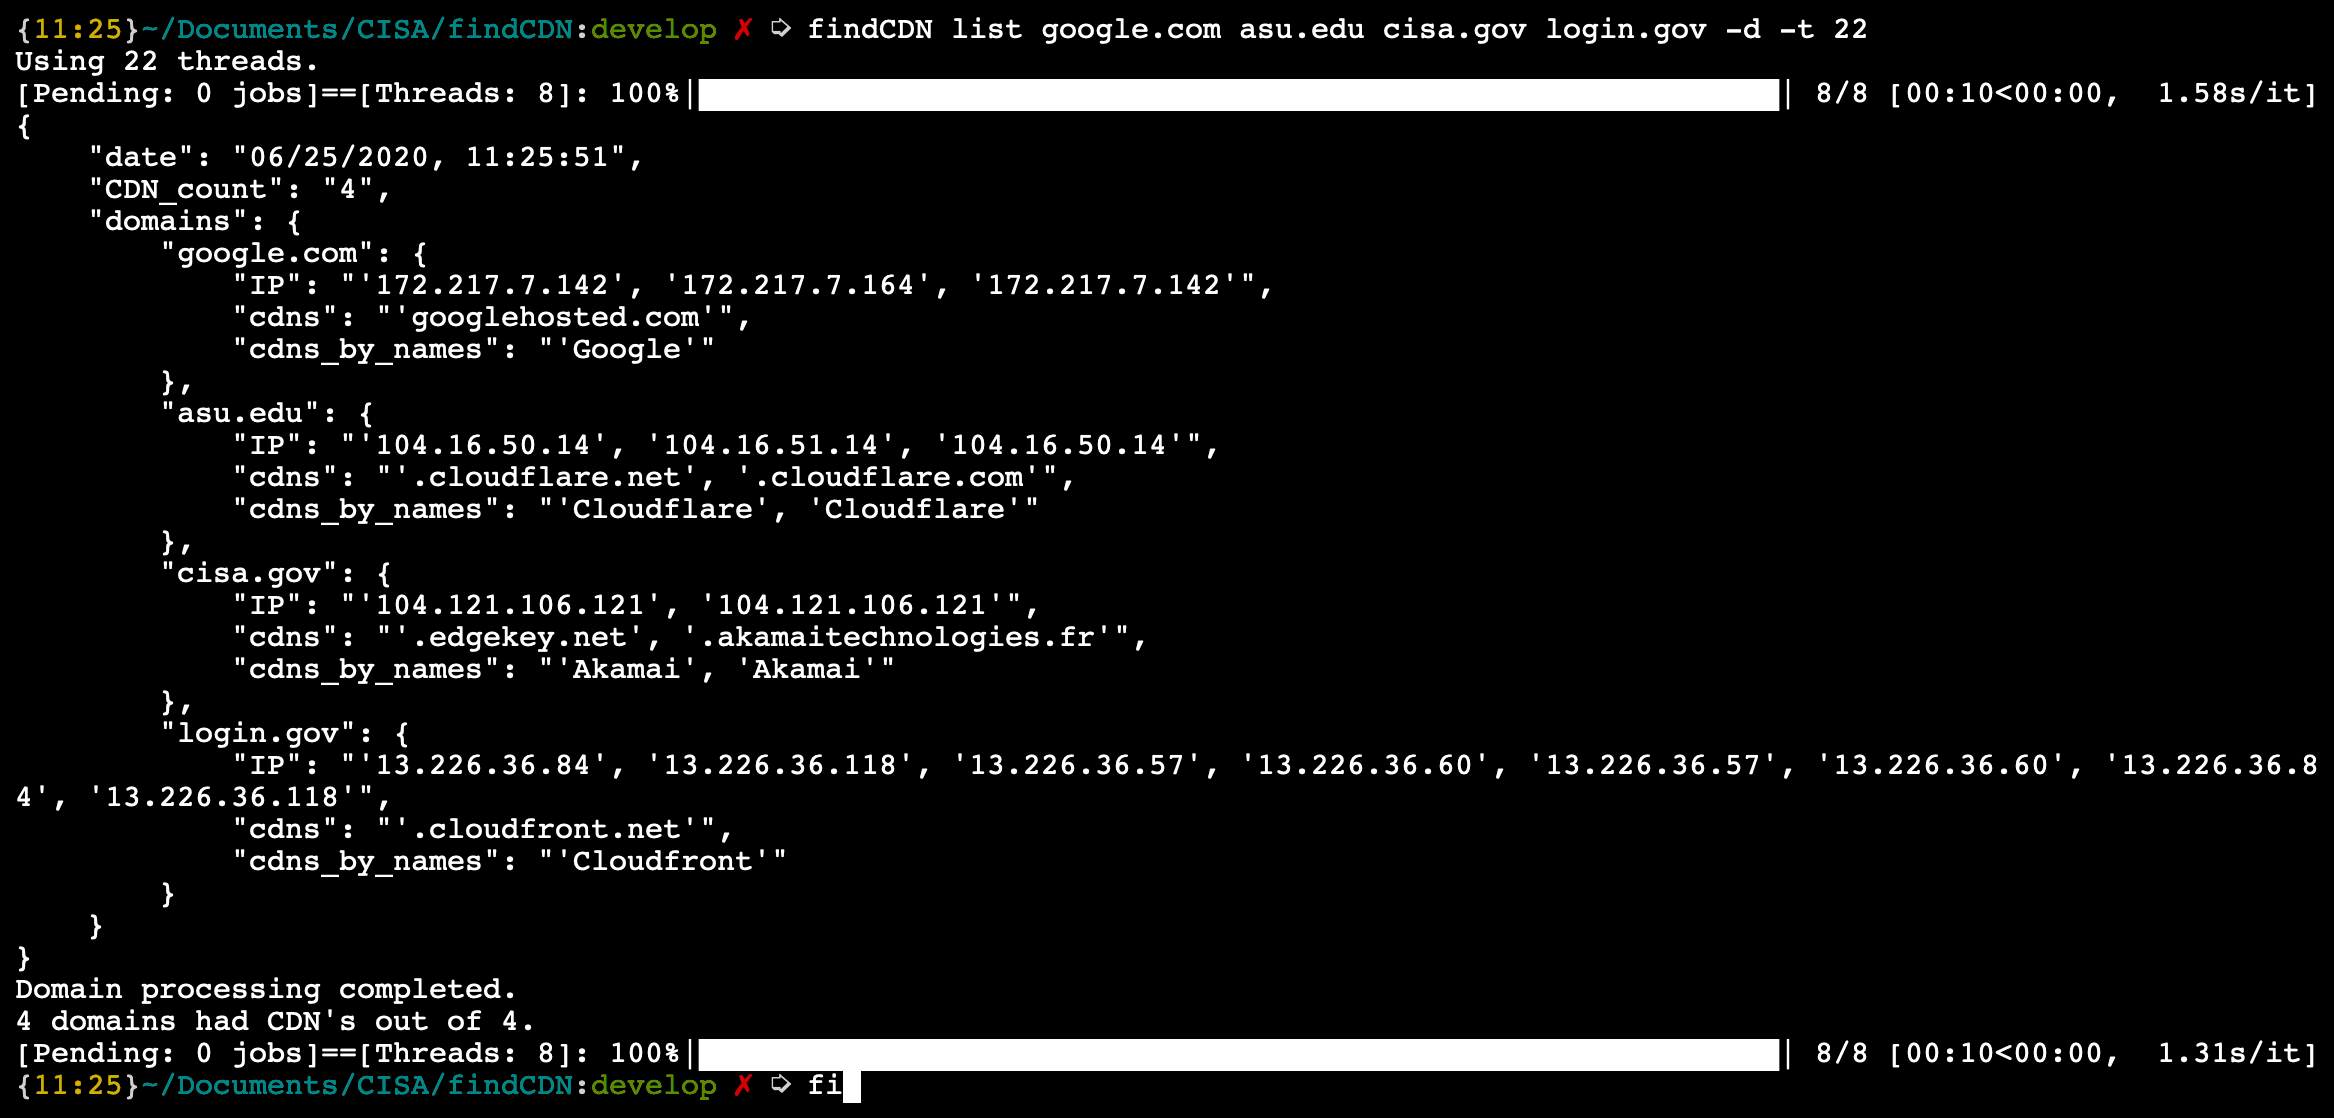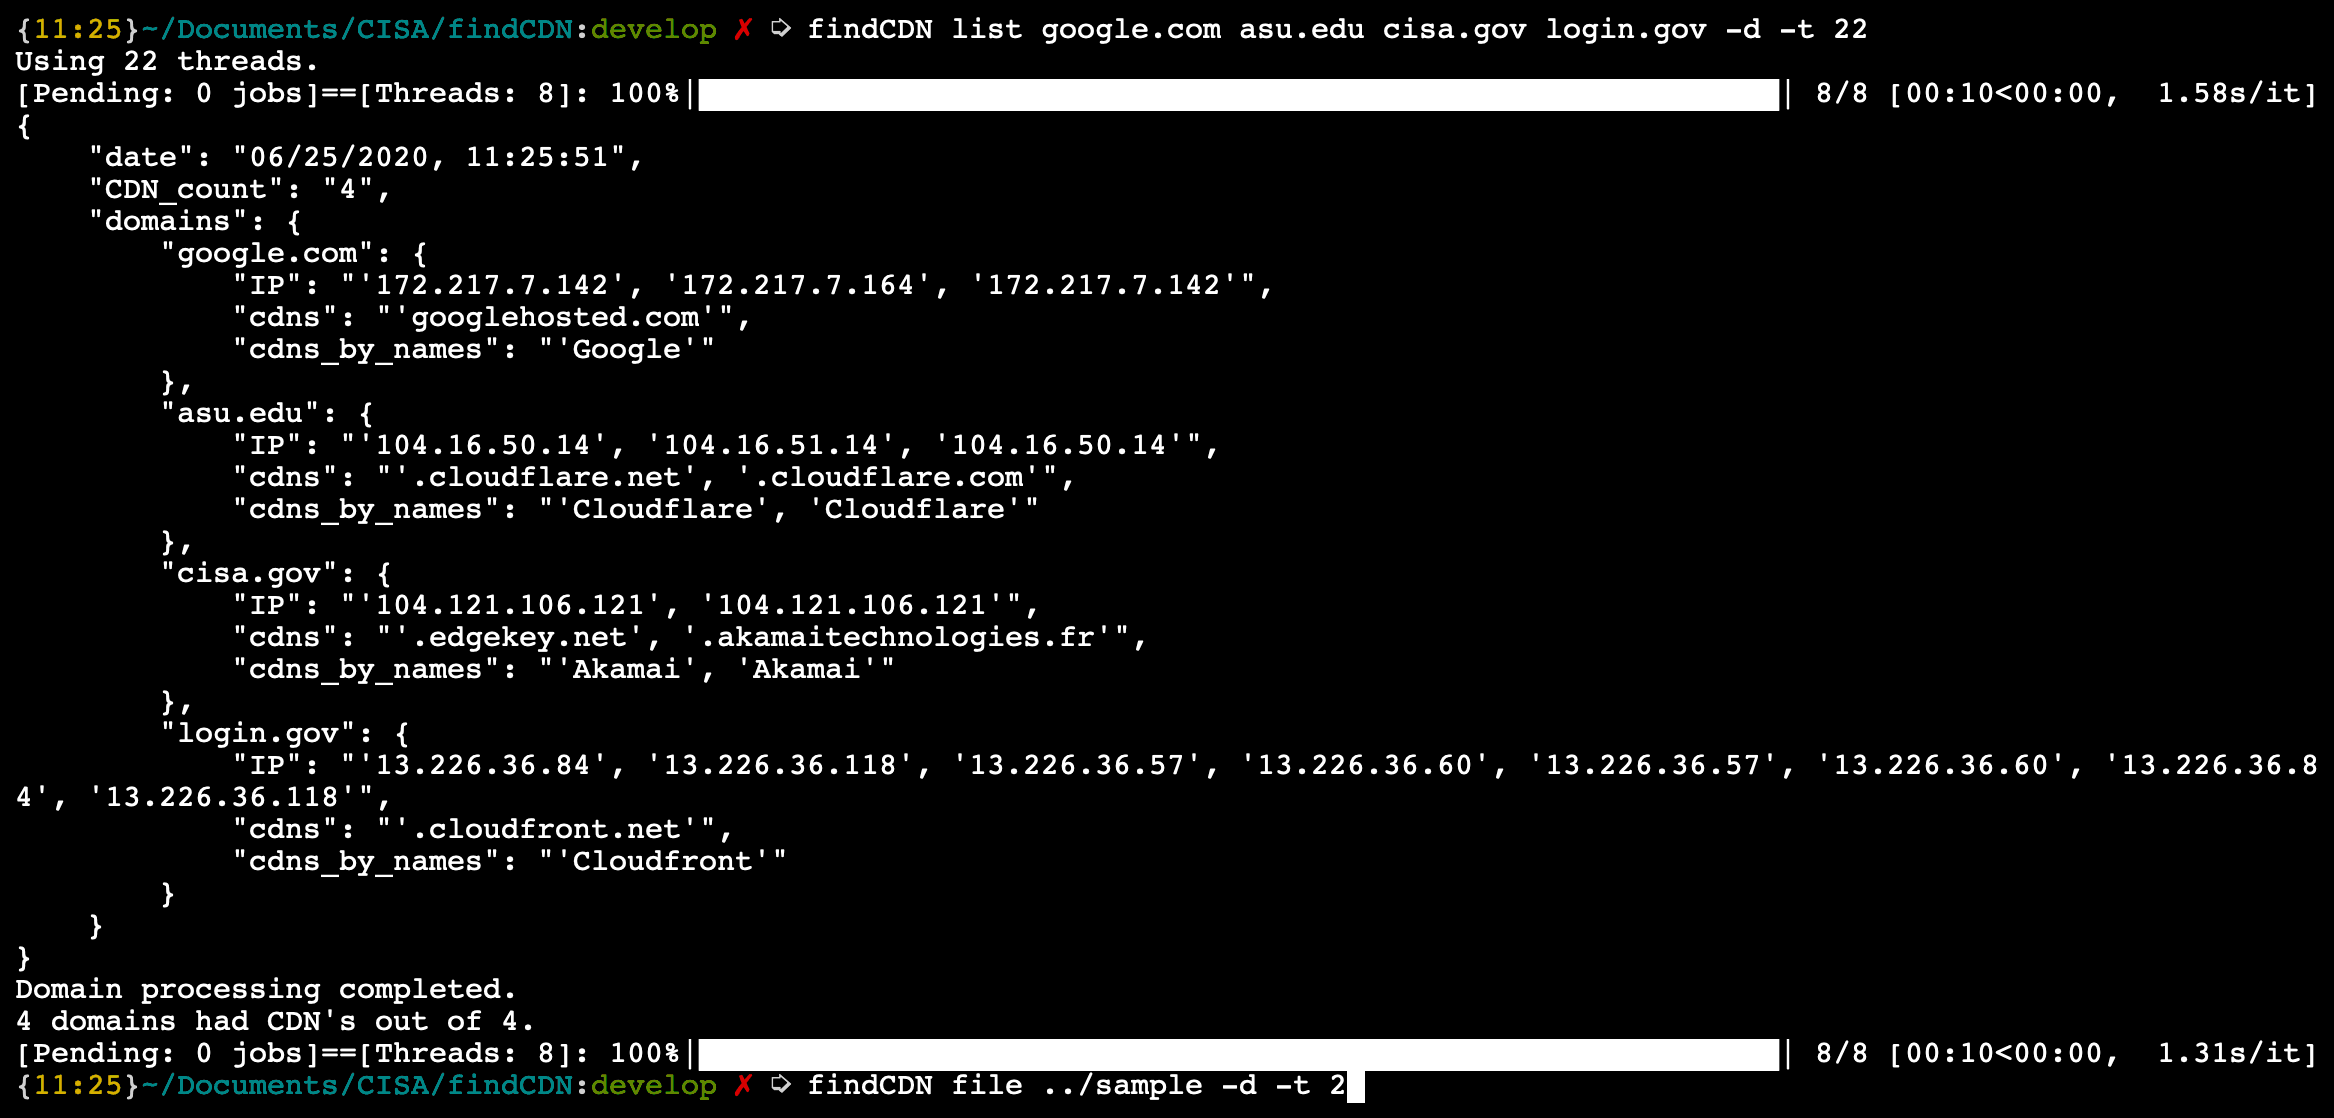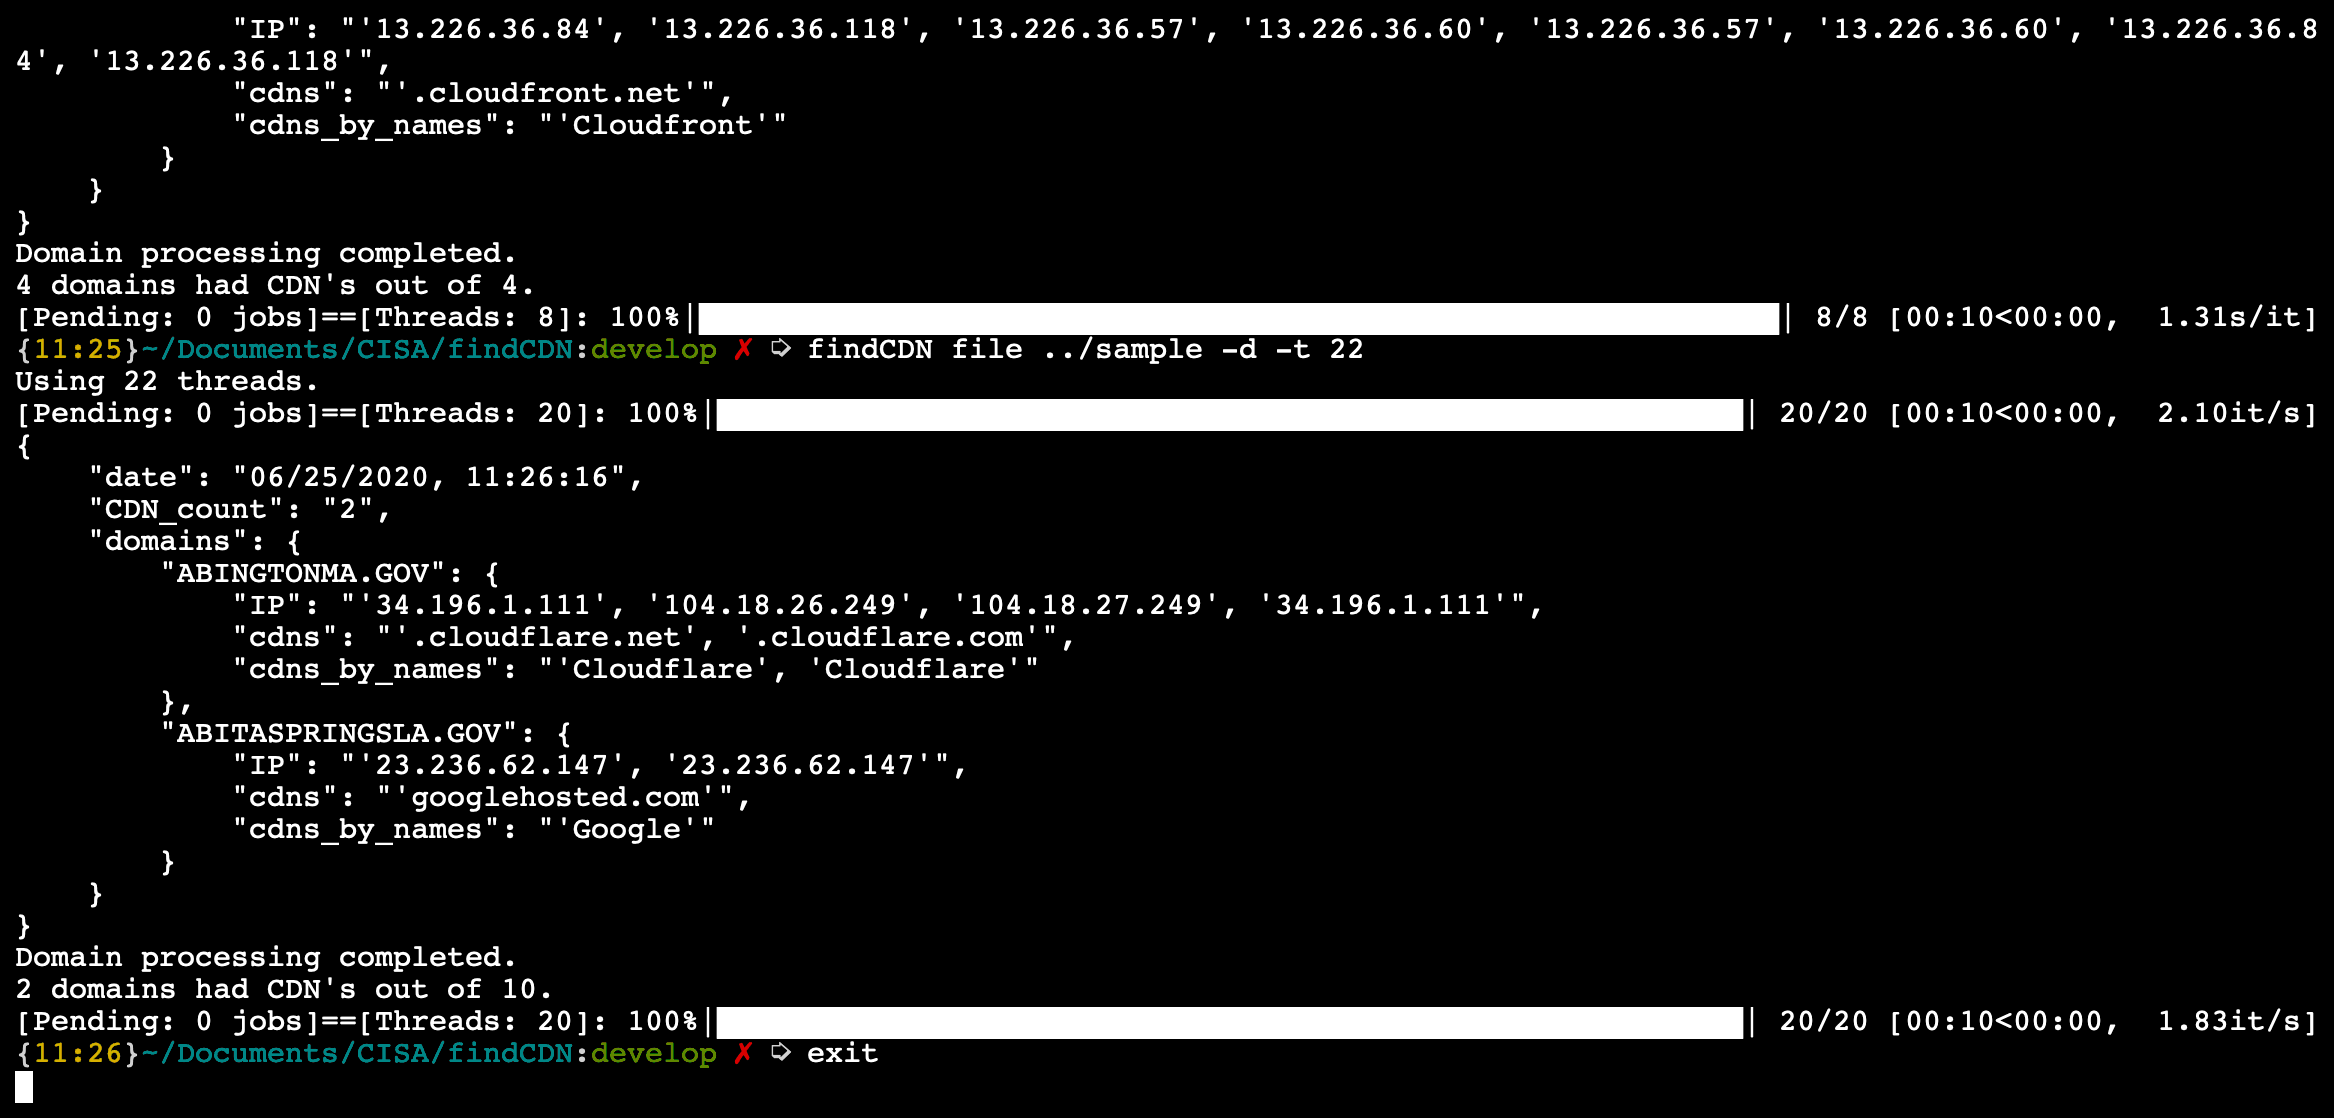
user2@ubuntu:~$ findcdn list asu.edu -t 7 --double
Using 7 threads.
[Pending: 0 jobs]==[Threads: 2]: 100%|███████████████████████████████| 2/2 [00:00<00:00,  2.22it/s]
{
    "date": "06/19/2020, 13:00:38",
    "CDN_count": "1",
    "domains": {
        "asu.edu": {
            "IP": "'104.16.50.14'",
            "cdns": "'.cloudflare.com'",
            "cdns_by_names": "'Cloudflare'"
        }
    }
}
Domain processing completed.
1 domains had CDN's out of 1.
Poiché findcdn può essere installato come modulo, la sua capacità di rilevamento CDN può essere
richiamata e implementata in qualsiasi progetto. Per prima cosa, importa findcdn nel tuo
progetto, come mostrato sopra. Poi, passagli una lista di domini da analizzare. Dopo
l'elaborazione, il programma restituirà un oggetto JSON contenente i domini
inseriti e le CDN che utilizzano.
Il funzionamento di findcdn è determinato dalle opzioni passate; le attuali
opzioni possibili e un esempio sono riportati di seguito per tua comodità:
findcdn.main(
    domain_list: List[str],  # List of domains to search
    output_path: str = None,  # if included, output results to JSON
    verbose: bool = False,  # Verbose mode (more printing!)
    all_domains: bool = False,  # Includes domains that dont have cdn's in the output
    interactive: bool = False,  # Includes a progress bar (normally used for command line)
    double_in: bool = False,  #D ouble the number of tries on a domain to increase accuracy
    threads: int = THREADS,  # Number of threads to use
    timeout: int = TIMEOUT,  # How long to wait on a domain
    user_agent: str = USER_AGENT,  # User Agent to use
)
import findcdn
import json

domains = ['google.com', 'cisa.gov', 'censys.io', 'yahoo.com', 'pbs.org', 'github.com']
resp_json = findcdn.main(domains, output_path="output.json", double_in=True, threads=23)

dumped_json = json.loads(resp_json)

for domain in dumped_json['domains']:
    print(f"{domain} has CDNs:\n {dumped_json['domains'][domain]['cdns']}")
findcdn è suddiviso in tre sezioni:
Chef utilizzerà la libreria CDN Detection per ottenere tutte le CDN per ogni dominioChef esegue poi un'analisi per impostare il valore booleano has_cdn se rileva
che un dominio ha una CDN, quindi restituisce la lista dei domini al file runnercdn_config.py.Lo scopo originale di questo strumento era rilevare automaticamente se un dominio che utilizza una CDN è frontabile. A causa dell'overhead significativo per il rilevamento del fronting, abbiamo orientato lo sviluppo di questo strumento verso un esclusivo strumento di rilevamento CDN. Utilizziamo la nostra wiki per descrivere ulteriormente cos'è il Domain Fronting, le nostre note di ricerca, le decisioni di progettazione e i playbook per il fronting di domini specifici. Se trovi ulteriori domini frontabili o eventuali difetti nei playbook attuali, ti invitiamo a contribuire!
Ci sono ulteriori informazioni sulla nostra pagina wiki. Ti invitiamo a richiedere funzionalità o contribuire con qualsiasi cosa vorresti vedere aggiunta nel progetto o nella wiki.
Questo può essere una qualsiasi delle seguenti:
Accogliamo con favore i contributi! Consulta CONTRIBUTING.md per
i dettagli.
Questo progetto è nel pubblico dominio mondiale.
Questo progetto è di pubblico dominio negli Stati Uniti, e il copyright e i diritti correlati all'opera in tutto il mondo sono rinunciati attraverso la dedica al pubblico dominio CC0 1.0 Universal.
Tutti i contributi a questo progetto saranno rilasciati sotto la dedica CC0. Inviando una pull request, accetti di rispettare questa rinuncia agli interessi di copyright.
