
 blessedrebus/krawl
Krawl è un server di deception web personalizzabile, leggero e nativo del cloud, e un anti-crawler che crea applicazioni web false con vulnerabilità di bassa complessità utilizzando dati esca realistici generati casualmente e template HTML generati dall'IA.

<h1 align="center">Krawl</h1>
<h3 align="center">
<a name="readme-top"></a>
<img
src="https://raw.githubusercontent.com/blessedrebus/krawl/HEAD/img/krawl-svg.svg"
height="250"
>
</h3>
<div align="center">
<p align="center">
Un server honeypot web moderno e personalizzabile progettato per rilevare e tracciare attività malevole da parte di attaccanti e web crawler attraverso pagine web ingannevoli, credenziali false e canary token.
</p>
<div align="center">
<a href="https://github.com/blessedrebus/krawl/blob/main/LICENSE">
<img src="https://img.shields.io/github/license/blessedrebus/krawl" alt="License">
</a>
<a href="https://github.com/blessedrebus/krawl/releases">
<img src="https://img.shields.io/github/v/release/blessedrebus/krawl" alt="Release">
</a>
</div>
<div align="center">
<a href="https://ghcr.io/blessedrebus/krawl">
<img src="https://img.shields.io/badge/ghcr.io-krawl-blue" alt="GitHub Container Registry">
</a>
<a href="https://kubernetes.io/">
<img src="https://img.shields.io/badge/kubernetes-ready-326CE5?logo=kubernetes&logoColor=white" alt="Kubernetes">
</a>
<a href="https://github.com/BlessedRebuS/Krawl/pkgs/container/krawl-chart">
<img src="https://img.shields.io/badge/helm-chart-0F1689?logo=helm&logoColor=white" alt="Helm Chart">
</a>
</div>
</div>
## Indice
- [Demo](#demo)
- [Cos'è Krawl?](#what-is-krawl)
- [Dashboard di Krawl](#krawl-dashboard)
- [Modalità di Deployment](#deployment-modes)
- [Banlist di Krawl](#krawl-banlist)
- [Avvio Rapido](#quickstart)
- [Docker Run](#docker-run)
- [Docker Compose](#docker-compose)
- [Kubernetes](#kubernetes)
- [Uvicorn (Python)](#uvicorn-python)
- [Configurazione](#configuration)
- [config.yaml](#configuration-via-configyaml)
- [Variabili d'Ambiente](#configuration-via-environmental-variables)
- [Bannare IP Malevoli](#use-krawl-to-ban-malicious-ips)
- [Reputazione IP](#ip-reputation)
- [Esecuzione dietro un Reverse Proxy o CDN](#running-behind-a-reverse-proxy-or-cdn)
- [Metriche e Monitoraggio](#metrics--monitoring)
- [Documentazione Aggiuntiva](#additional-documentation)
- [Inganno tramite AI](#ai-generated-deception-pages)
- [Contribuire](#contributing)
## Demo
Suggerimento: esegui la scansione dei percorsi in `robots.txt` per ulteriore divertimento
### URL di Krawl: [http://demo.krawlme.com](http://demo.krawlme.com)
### Visualizza la dashboard [http://demo.krawlme.com/das_dashboard](http://demo.krawlme.com/das_dashboard)
## Cos'è Krawl?
**Krawl** è un server di inganno cloud‑native progettato per rilevare, ritardare e analizzare attaccanti malevoli, web crawler e scanner automatizzati.
Crea applicazioni web false realistiche piene di facili bersagli come pannelli di amministrazione, file di configurazione e credenziali false esposte per attirare e identificare attività sospette.
Sprecando le risorse degli attaccanti, Krawl aiuta a distinguere chiaramente il comportamento malevolo dai crawler legittimi.
Include:
- **[Pagine di Inganno Generate dall'AI](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)**: **Lascia che gli attaccanti contribuiscano a generare la tua falsa superficie d'attacco vulnerabile**
- **Pagine Spider Trap**: Link casuali infiniti per sprecare le risorse dei crawler basate sul [progetto spidertrap](https://github.com/adhdproject/spidertrap)
- **Pagine di Login False**: WordPress, phpMyAdmin, pannelli di amministrazione
- **Percorsi Honeypot**: Pubblicizzati in robots.txt per catturare gli scanner
- **Credenziali False**: Nomi utente, password e chiavi API dall'aspetto realistico
- **Integrazione [Canary Token](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md)**: Attivazione di avvisi esterni
- **Header del server casuali**: Confondono gli attacchi basati sull'header e sulla versione del server
- **Dashboard in Tempo Reale**: Monitora attività sospette
- **Wordlist Personalizzabili**: Configurazione semplice basata su JSON
- **Iniezione Casuale di Errori**: Simula il comportamento di un server reale
Puoi facilmente esporre Krawl insieme agli altri tuoi servizi per proteggerli da web crawler e utenti malevoli utilizzando un reverse proxy. Per maggiori dettagli, consulta la [documentazione sul Reverse Proxy](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md).
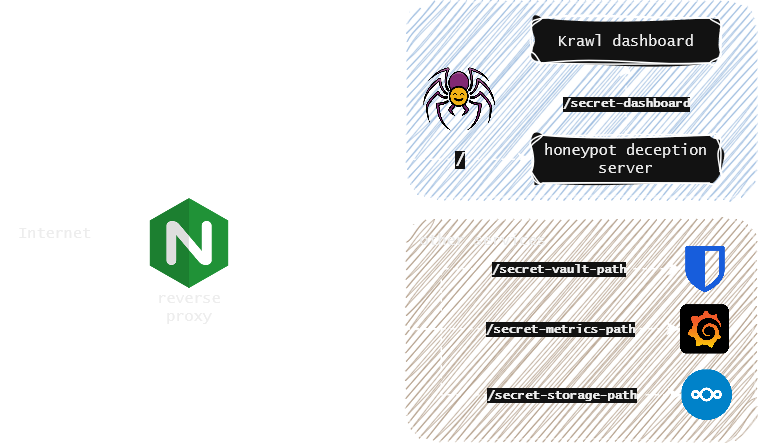
## Dashboard di Krawl
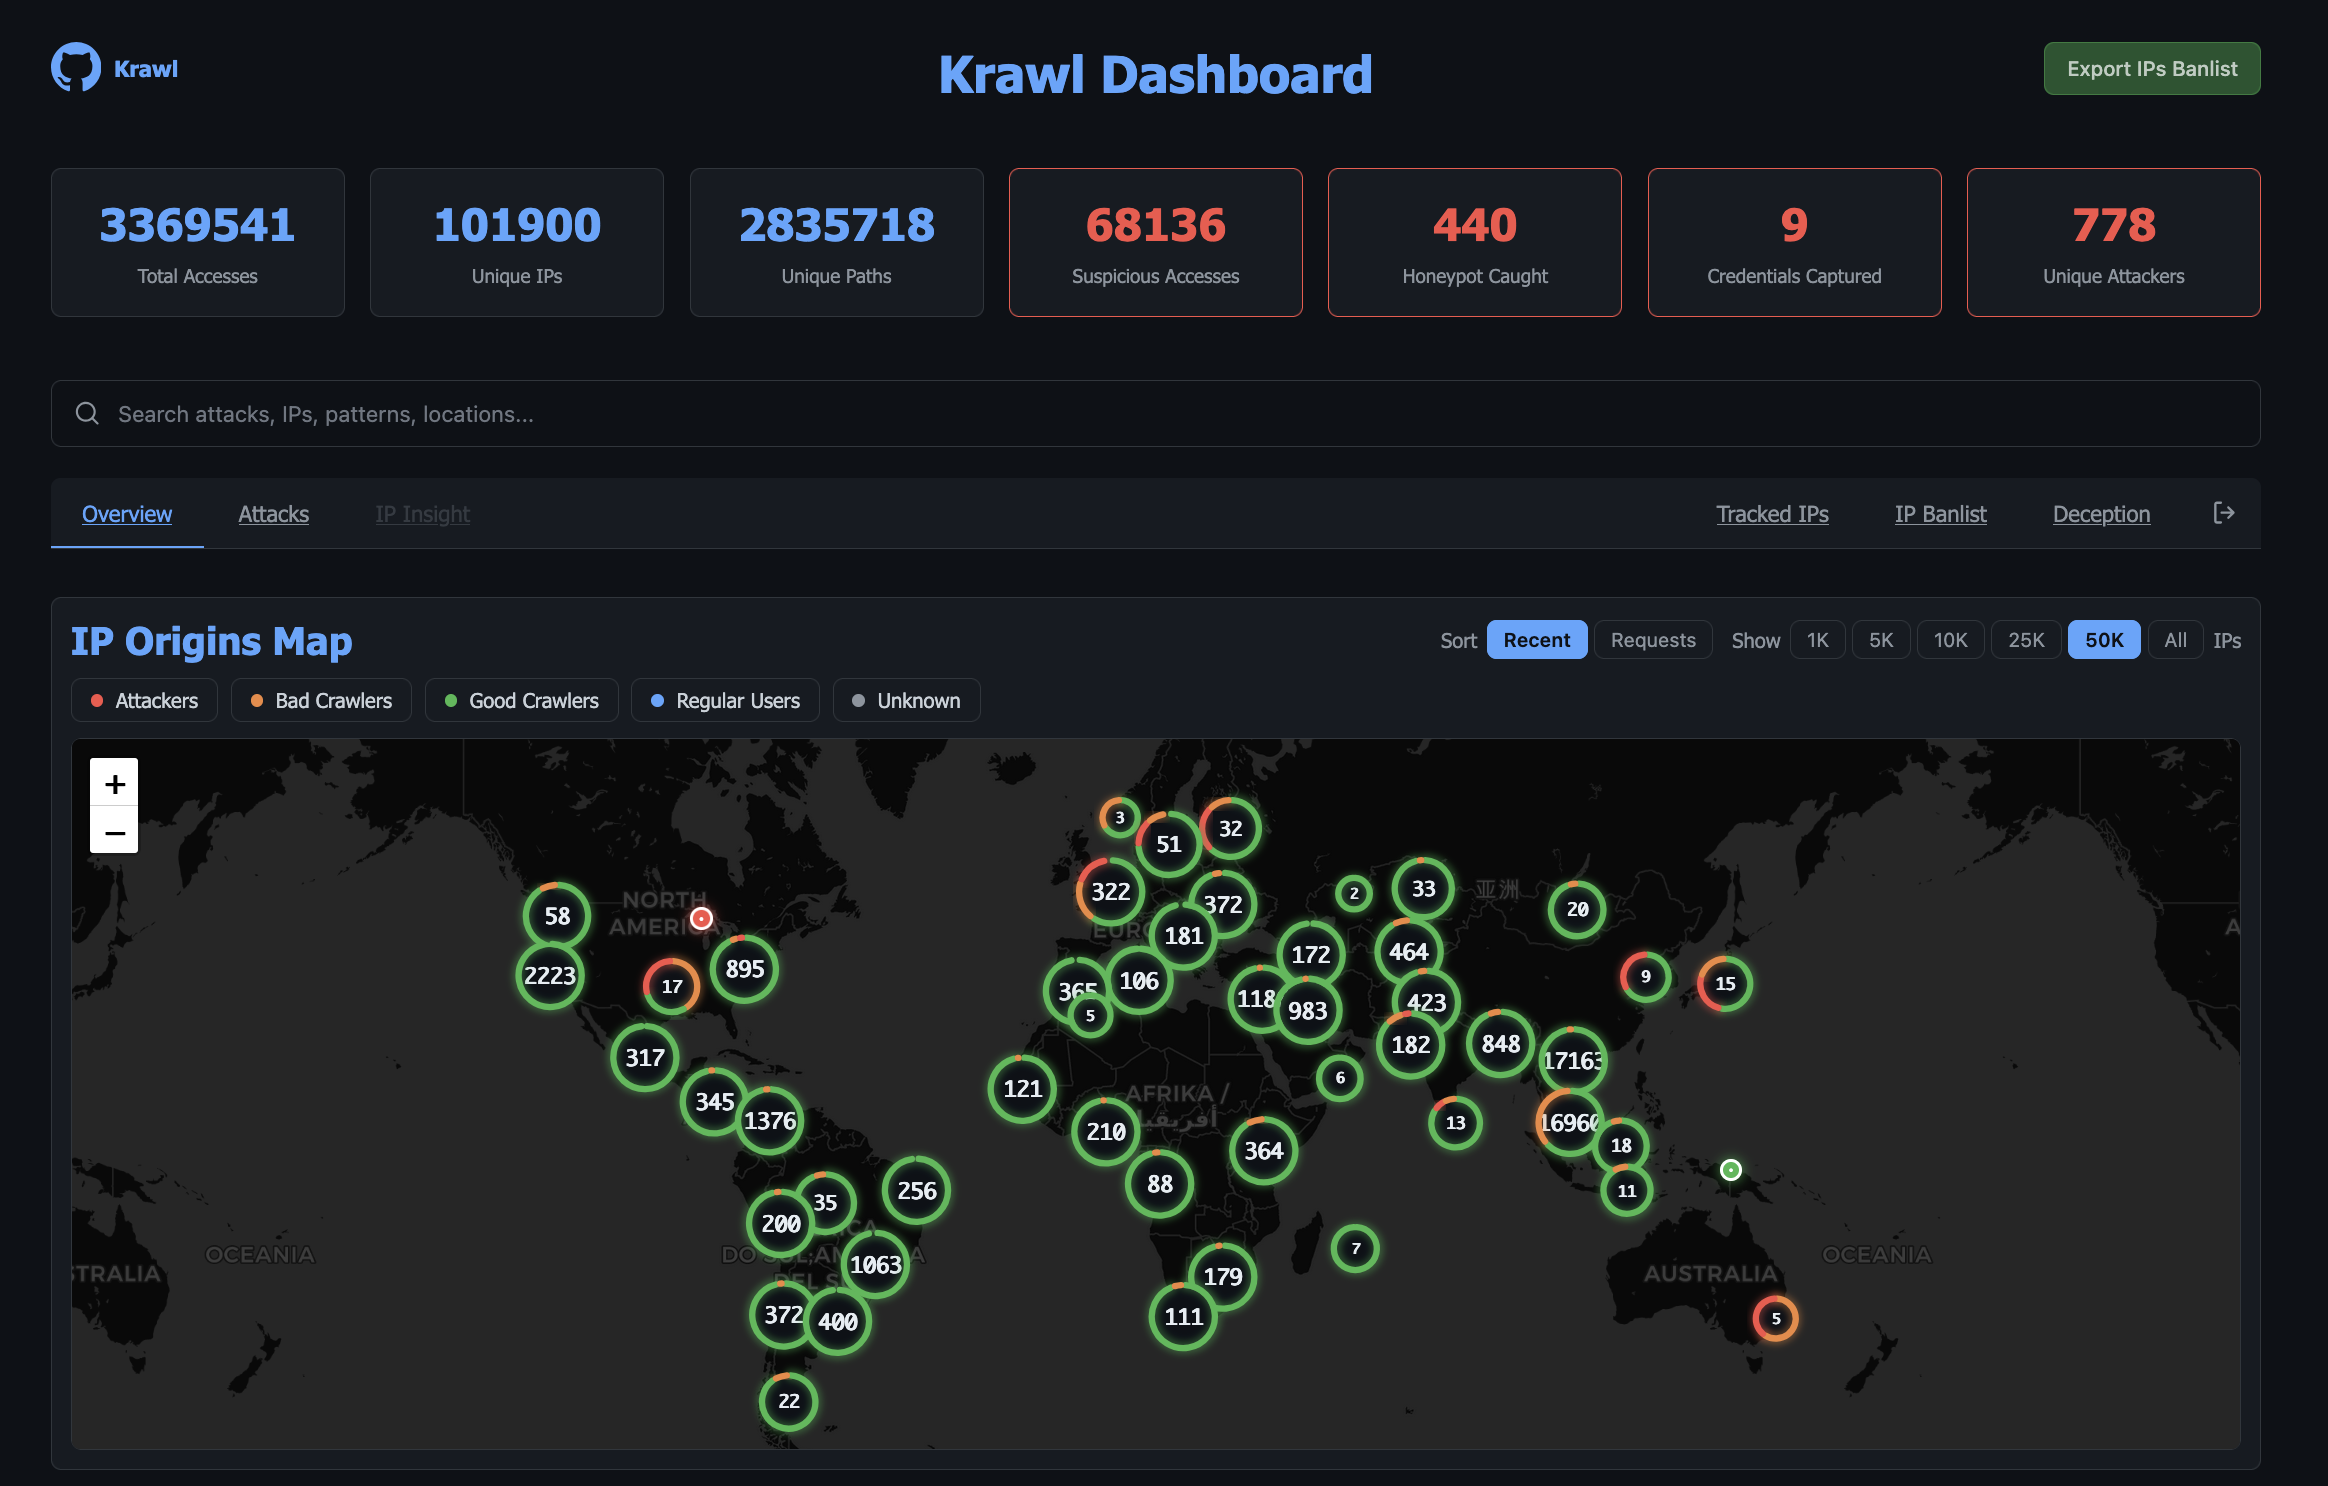
Krawl fornisce una dashboard completa, accessibile a un **percorso segreto casuale** generato all'avvio o a un **percorso personalizzato** configurato tramite `KRAWL_DASHBOARD_SECRET_PATH`. Questo mantiene la dashboard nascosta agli attaccanti che scansionano il tuo honeypot.
La dashboard è organizzata in sei schede:
- **Panoramica**: vista di alto livello dell'attività di attacco: una mappa interattiva delle origini IP, richieste sospette recenti e IP, User-Agent e percorsi più frequenti.
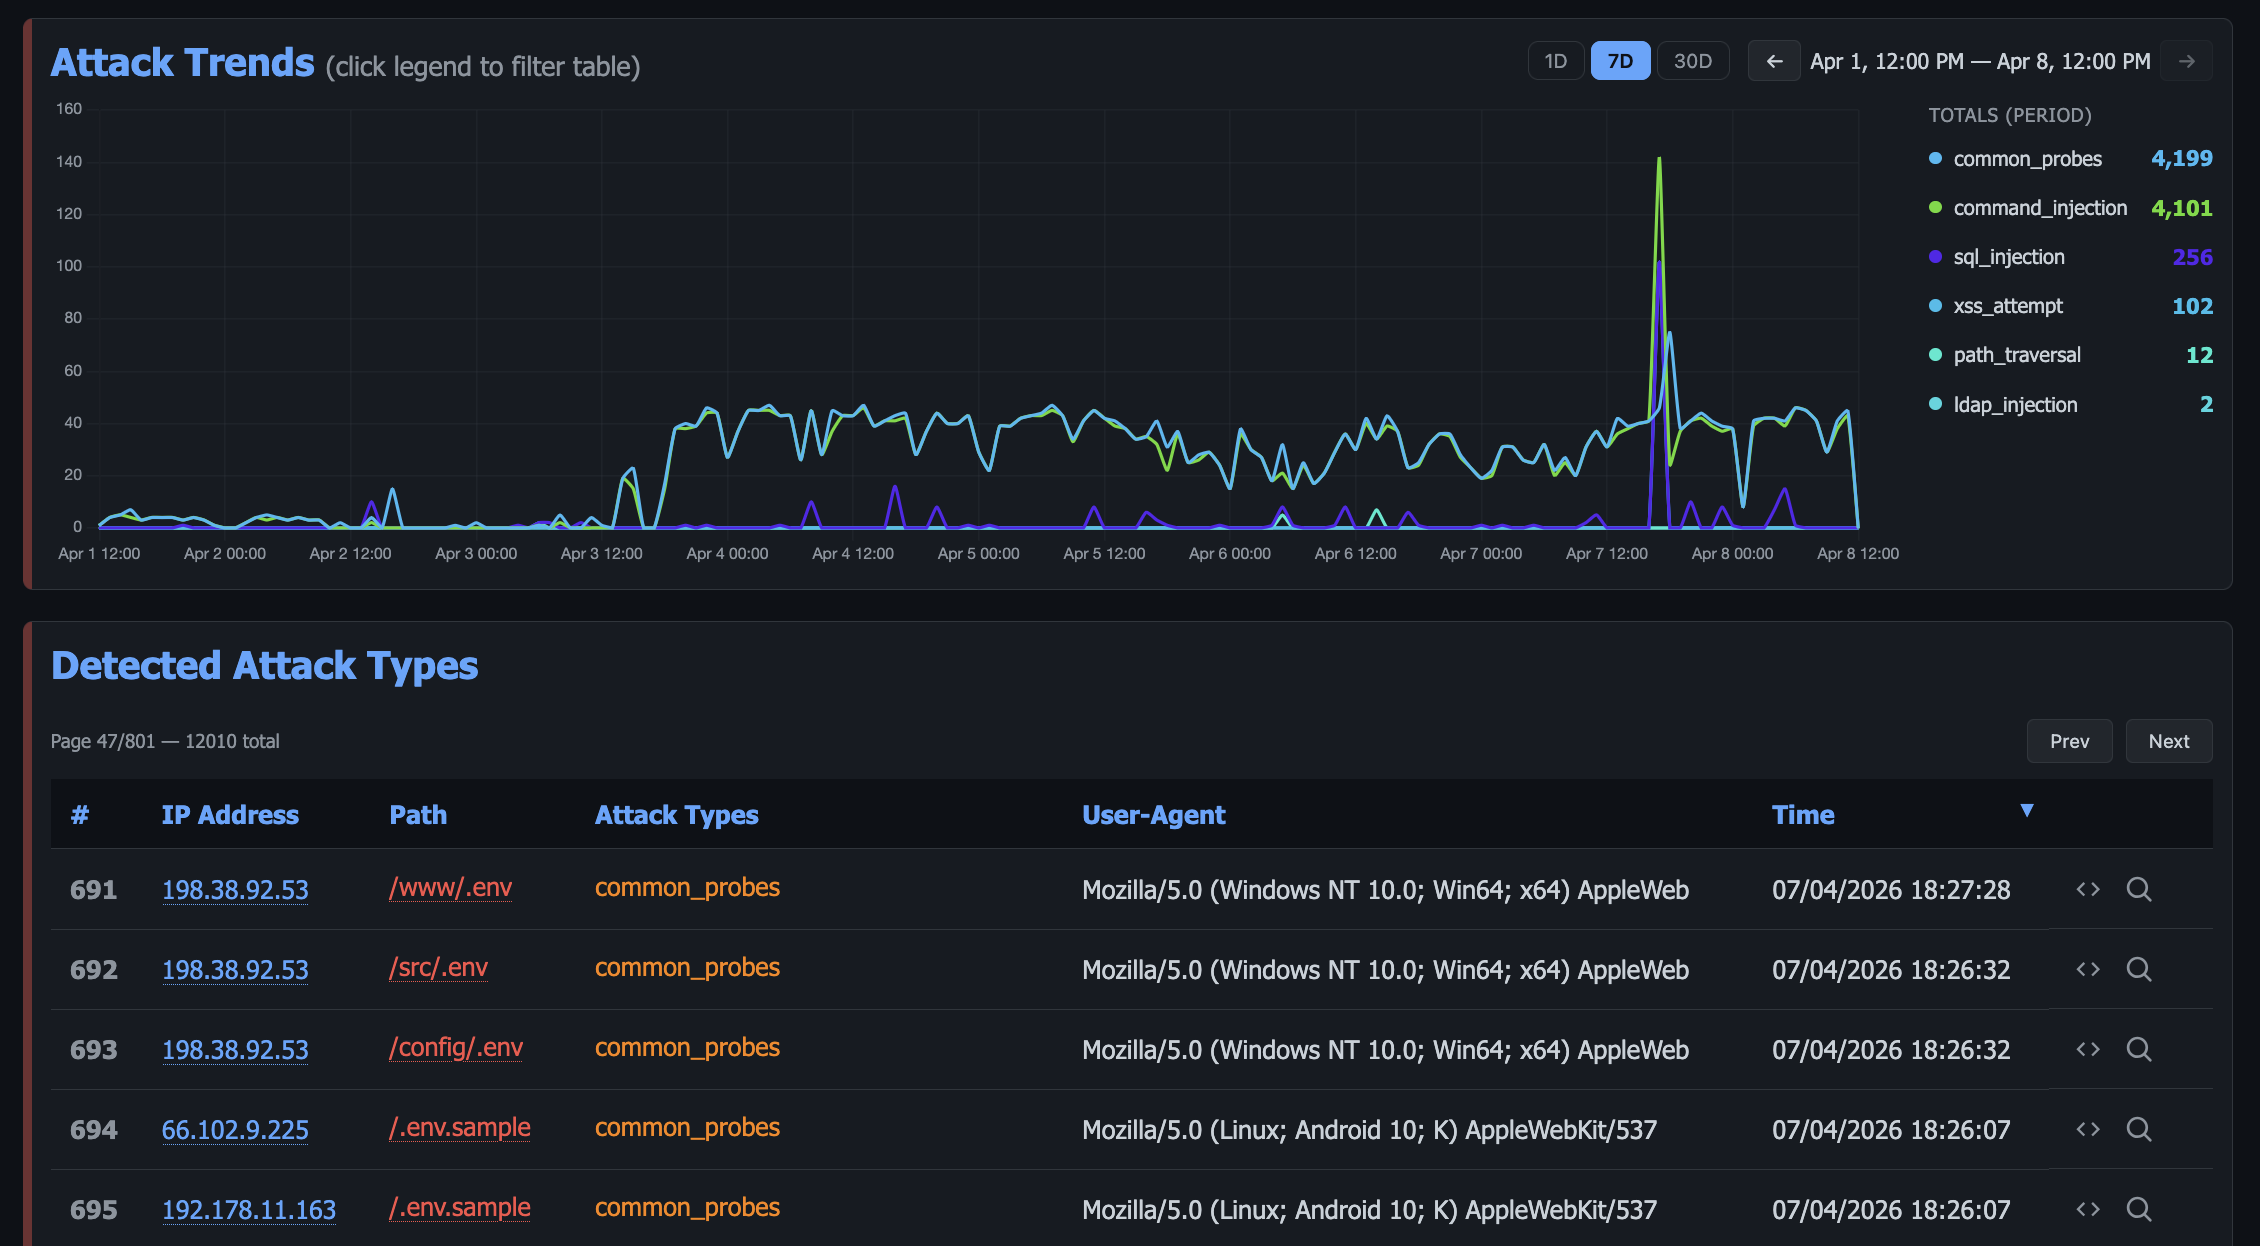
- **Attacchi**: analisi dettagliata delle credenziali catturate, degli trigger degli honeypot e dei tipi di attacco rilevati (SQLi, XSS, path traversal, ecc.) con grafici e tabelle.
- **Minacce**: payload raggruppati in campagne tramite hash fuzzy TLSH, così una webshell e le sue varianti modificate vengono lette come un'unica campagna anziché come hit non correlate, con un indice di ogni file catturato.
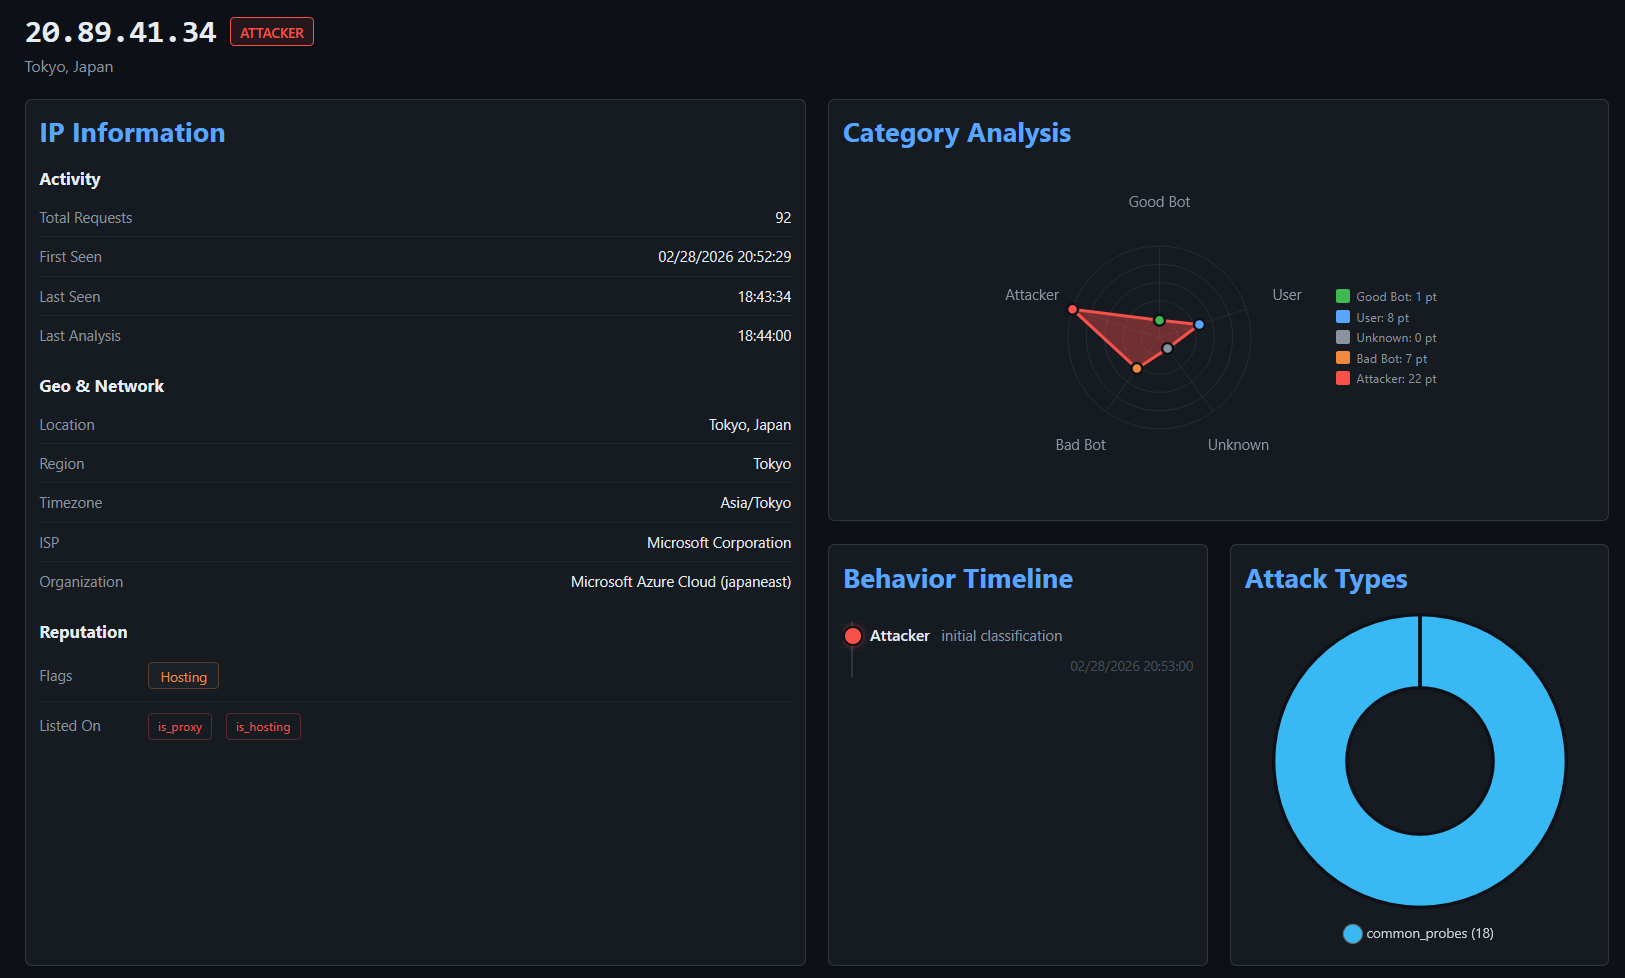
- **Approfondimento IP**: vista forense approfondita di un IP selezionato: geolocalizzazione, informazioni ISP/ASN, indicatori di reputazione, cronologia comportamentale, distribuzione dei tipi di attacco, cronologia dei referer, file e credenziali catturati e cronologia completa degli accessi.
Inoltre, dopo l'autenticazione con la password della dashboard, diventano disponibili schede protette:
- **IP Tracciati**: mantieni una watchlist di indirizzi IP che vuoi monitorare nel tempo.
- **Banlist IP**: gestisci i ban degli IP, visualizza gli attaccanti rilevati ed esporta la banlist in formato raw o IPTables.
- **IP in Timeout**: rivedi gli IP attualmente trattenuti nel tarpit ed esenta quelli che non dovrebbero esserlo.
- **Inganno**: gestisci le pagine generate dall'AI, esportale o importane di nuove.
- **Webhook**: inoltra i ban a CloudFlare e ad altri firewall.
Le icone nell'intestazione aprono la documentazione API, l'esportazione della banlist e un pannello delle impostazioni che mostra la configurazione in esecuzione e una pagina di manutenzione per eseguire attività pianificate su richiesta.
Per maggiori dettagli, consulta la [documentazione della Dashboard](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md).
## Modalità di Deployment
Krawl supporta due modalità di deployment, controllate dall'impostazione `mode` in `config.yaml` o dalla variabile d'ambiente `KRAWL_MODE`.
| | Standalone | Scalabile |
|---|---|---|
| **Database** | SQLite (modalità WAL) | PostgreSQL |
| **Cache** | Dizionario Python in memoria | Redis (TTL multi-livello) |
| **Repliche** | 1 (istanza singola) | 1+ (scalabilità orizzontale) |
| **Dipendenze esterne** | Nessuna | PostgreSQL + Redis |
| **Ideale per** | Sviluppo, homelab, <500k richieste | Produzione, HA, >500k richieste |
**Standalone**: ideale per ambienti di sviluppo o homelab con un basso numero di richieste. Nessuna configurazione aggiuntiva necessaria, basta avviare Krawl e funziona.
- Deployment su container singolo senza dipendenze esterne
- Utilizzo inferiore di RAM e risorse
**Scalabile**: progettata per ambienti di produzione o honeypot ad alto traffico. L'Helm chart utilizza questa modalità come predefinita.
- Dashboard più veloce e reattiva grazie alla cache multi-livello di Redis
- I/O su disco ridotto con Redis che funge da cache hot-path davanti a PostgreSQL
- Scalabilità orizzontale: aumenta il numero di repliche di Krawl dietro un load balancer
Per la configurazione dettagliata, esempi di Docker Compose, setup Kubernetes/Helm e istruzioni di migrazione passo-passo, consulta la [documentazione sulle Modalità di Deployment](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
## Banlist di Krawl
Krawl mantiene una [`banlist.txt`](https://github.com/blessedrebus/krawl/blob/main/banlist.txt) aggiornata regolarmente contenente indirizzi IP di **attaccanti che hanno attivato le sue trappole honeypot**. La banlist viene pubblicata settimanalmente ed è disponibile per il download, aiutando la comunità a bloccare preventivamente attori malevoli noti anche senza utilizzare Krawl.
La banlist può anche essere recuperata direttamente da:
[https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw](https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw).
### Condivisione delle banlist tra istanze
Le istanze di Krawl possono federare le loro banlist: ciascuna può pubblicare la propria lista su un
percorso non autenticato e importare liste da altre istanze (o qualsiasi lista di IP in testo semplice).
Gli IP recuperati vengono uniti alle decisioni di ban locali e mostrati nella dashboard.```yaml
banlist:
# Public, unauthenticated download path for this instance's banlist.
# Supports the same ?categories= and ?fwtype= parameters as the main API.
# Empty = disabled.
export_path: "/public_banlist.txt"
# Upstream banlists to fetch and merge. Plain ".txt" lists work too.
sources:
- "https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw"
- "https://krawl.example.com/public_banlist.txt"
refresh_interval: 3600 # seconds between fetches
```
## Quickstart
### Docker Run
Esegui Krawl in modalità standalone con l'immagine più recente:```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard" \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-v krawl-data:/app/data \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
Accedi al server all'indirizzo `http://localhost:5000`
### Docker Compose
Crea un file `docker-compose.yaml` con una delle due modalità di distribuzione.
**Standalone**: solo il server Krawl con storage Sqlite:```yaml
services:
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
- krawl-data:/app/data
restart: unless-stopped
volumes:
krawl-data:
```
**Scalabile**: con PostgreSQL e Redis:
> [!CAUTION]
> L'esempio seguente utilizza **password predefinite** (`krawl`/`krawl`). **Modificale prima di distribuire in produzione.**```yaml
services:
postgres:
image: postgres:16-alpine
environment:
POSTGRES_DB: krawl
POSTGRES_USER: krawl
POSTGRES_PASSWORD: krawl
volumes:
- postgres_data:/var/lib/postgresql/data
restart: unless-stopped
healthcheck:
test: ["CMD-SHELL", "pg_isready -U krawl -d krawl"]
interval: 10s
timeout: 5s
retries: 5
redis:
image: redis:7-alpine
volumes:
- redis_data:/data
restart: unless-stopped
healthcheck:
test: ["CMD", "redis-cli", "ping"]
interval: 10s
timeout: 5s
retries: 5
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
- KRAWL_MODE=scalable
- KRAWL_POSTGRES_HOST=postgres
- KRAWL_POSTGRES_PORT=5432
- KRAWL_POSTGRES_USER=krawl
- KRAWL_POSTGRES_PASSWORD=krawl
- KRAWL_POSTGRES_DATABASE=krawl
- KRAWL_REDIS_HOST=redis
- KRAWL_REDIS_PORT=6379
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
restart: unless-stopped
depends_on:
postgres:
condition: service_healthy
redis:
condition: service_healthy
volumes:
postgres_data:
redis_data:
```
Per distribuire, basta eseguire```bash
docker compose up -d
```
I file compose pronti per la produzione sono disponibili anche nella directory [`docker/`](https://github.com/blessedrebus/krawl/blob/main/docker). Per lo **sviluppo** (build dal sorgente con hot-reload), usa i file compose in [`docker/dev/`](https://github.com/blessedrebus/krawl/blob/main/docker/dev).
Per maggiori dettagli su entrambe le modalità, vedi [Modalità di distribuzione](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
### Kubernetes
**Krawl è disponibile anche nativamente su Kubernetes**. L'installazione può essere effettuata [tramite manifest](https://github.com/blessedrebus/krawl/blob/main/kubernetes/README.md) oppure [utilizzando la chart Helm](https://github.com/blessedrebus/krawl/blob/main/helm/README.md).
La chart Helm **utilizza per impostazione predefinita la modalità scalabile** con PostgreSQL e Redis inclusi:```bash
helm install krawl oci://ghcr.io/blessedrebus/krawl-chart --version 2.4.0 \
-n krawl-system --create-namespace \
--set postgres.password=your-password \
--set redis.password=your-redis-password \
--set dashboardPassword=your-dashboard-password \
--set config.dashboard.secret_path=/my-secret-dashboard
```
Sono forniti file di valori di esempio minimi per entrambe le modalità:
- [`values-minimal.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-minimal.yaml) ---> Scalabile (predefinita)
- [`values-standalone.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-standalone.yaml) ---> Standalone
Vedi [Modalità di distribuzione](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md) e [Documentazione del chart](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) per la configurazione completa e le istruzioni di migrazione.
### Uvicorn (Python)
Esegui Krawl direttamente con Python 3.13+ e uvicorn per lo sviluppo locale o i test:```bash
pip install -r requirements.txt
uvicorn app:app --host 0.0.0.0 --port 5000 --app-dir src --no-server-header
```
Accedi al server all'indirizzo `http://localhost:5000`
## Configurazione
Krawl utilizza una **gerarchia di configurazione** in cui **le variabili d'ambiente hanno la precedenza sul file di configurazione**. Questo approccio è consigliato per i deployment Docker e per una rapida personalizzazione out-of-the-box.
### Configurazione tramite config.yaml
Puoi utilizzare il file [config.yaml](https://github.com/blessedrebus/krawl/blob/main/config.yaml) per configurazioni avanzate, come i deployment con Docker Compose o Helm chart.
### Configurazione tramite variabili d'ambiente
Tutte le impostazioni possono essere fornite come variabili d'ambiente, che sovrascrivono `config.yaml`.
Il nome della variabile è `KRAWL_` più il percorso dell'impostazione in maiuscolo, quindi `dashboard.password`
diventa `KRAWL_DASHBOARD_PASSWORD`.
<details>
<summary><b>Server e generazione dei link</b> (11 variabili)</summary>
Come Krawl si presenta e modella il labirinto di pagine generate.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `CONFIG_LOCATION` | Percorso del file di configurazione yaml | `config.yaml` |
| `KRAWL_PORT` | Porta di ascolto del server | `5000` |
| `KRAWL_DELAY` | Ritardo di risposta in millisecondi | `100` |
| `KRAWL_SERVER_HEADER` | Header HTTP Server per l'inganno | `""` |
| `KRAWL_LINKS_LENGTH_RANGE` | Intervallo di lunghezza dei link come `min,max` | `5,15` |
| `KRAWL_LINKS_PER_PAGE_RANGE` | Link per pagina come `min,max` | `10,15` |
| `KRAWL_CHAR_SPACE` | Caratteri utilizzati per la generazione dei link | `abcdefgh...` |
| `KRAWL_MAX_COUNTER` | Valore iniziale del contatore | `10` |
| `KRAWL_PROBABILITY_ERROR_CODES` | Probabilità di risposta di errore (0-100%) | `0` |
| `KRAWL_INFINITE_PAGES_FOR_MALICIOUS` | Servire pagine infinite agli IP malevoli | `true` |
| `KRAWL_MAX_PAGES_LIMIT` | Limite massimo di pagine per i crawler | `250` |
| `KRAWL_BAN_DURATION_SECONDS` | Durata del ban in secondi per gli IP soggetti a rate limiting | `600` |
</details>
<details>
<summary><b>Dashboard, metriche e logging</b> (13 variabili)</summary>
Accesso alla dashboard, warmup della cache, Prometheus e livello di log.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_DASHBOARD_SECRET_PATH` | Percorso personalizzato della dashboard | Generato automaticamente |
| `KRAWL_DASHBOARD_PASSWORD` | Password per i pannelli protetti della dashboard | Generata automaticamente |
| `KRAWL_DASHBOARD_CACHE_WARMUP` | Pre-calcola i dati della dashboard ogni 5 minuti per caricamenti istantanei delle pagine | `true` |
| `KRAWL_DASHBOARD_WARMUP_PAGES` | Numero di pagine da pre-riscaldare per ogni pannello tabella | `10` |
| `KRAWL_DASHBOARD_WARMUP_AGGREGATION` | Pre-calcola le aggregazioni complete top_paths/top_ua per un servizio a query zero | `false` |
| `KRAWL_DASHBOARD_TOP_N_MIN_COUNT` | Conteggio minimo di accessi per i pannelli top paths/user agents (imposta a 1 per disabilitare) | `5` |
| `KRAWL_DASHBOARD_BRAND_NAME` | Nome nel wordmark e nell'intestazione della dashboard | `Krawl` |
| `KRAWL_DASHBOARD_BRAND_URL` | Destinazione del link del wordmark (vuoto lo rende come testo semplice) | Repository di Krawl |
| `KRAWL_DASHBOARD_BRAND_LOGO` | URL dell'immagine mostrata al posto del marchio GitHub | Non impostato |
| `KRAWL_DASHBOARD_BRAND_SHOW_VERSION` | Mostra la versione accanto al nome | `true` |
| `KRAWL_DASHBOARD_BRAND_CONTACT` | Contatto mostrato sotto il wordmark (indirizzo, URL o testo semplice) | Non impostato |
| `KRAWL_METRICS_ENABLED` | Espone le metriche Prometheus su `/<dashboard_path>/metrics` | `true` |
| `KRAWL_LOG_LEVEL` | Livello di log dell'applicazione (`DEBUG`, `INFO`, `WARNING`, `ERROR`) | `INFO` |
</details>
<details>
<summary><b>Database, conservazione e backup</b> (12 variabili)</summary>
Posizione di archiviazione, durata di conservazione dei dati e job di dump.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_DATABASE_PATH` | Posizione del file del database | `data/krawl.db` |
| `KRAWL_DATABASE_PERSIST_SUSPICIOUS_ONLY` | Persisti solo le richieste sospette nel log degli accessi | `false` |
| `KRAWL_MAP_TILE_URL` | Template URL dei tile per la mappa della dashboard (`{z}/{x}/{y}`, `{s}`/`{r}` opzionali) | Esri dark canvas |
| `KRAWL_MAP_TILE_ATTRIBUTION` | Attribuzione mostrata sulla mappa | Esri/OSM |
| `KRAWL_MAP_API_KEY` | Aggiunta a ogni richiesta di tile come parametro di query — richiesta da CARTO | _(vuoto)_ |
| `KRAWL_MAP_API_KEY_PARAM` | Nome di quel parametro di query (`api_key`, `apikey`, `key`) | `api_key` |
| `KRAWL_IPV6_IGNORE` | Scarta completamente le richieste IPv6: comunque registrate su stdout, mai persistite, controllate per ban o esportate | `false` |
| `KRAWL_IPV6_PURGE_EXISTING` | Elimina anche le righe IPv6 esistenti al prossimo avvio (irreversibile; richiede `KRAWL_IPV6_IGNORE`) | `false` |
| `KRAWL_DATABASE_RETENTION_DAYS` | Giorni di conservazione dei dati nel database | `30` |
| `KRAWL_BACKUPS_PATH` | Percorso in cui vengono salvati i dump del database | `backups` |
| `KRAWL_BACKUPS_CRON` | Espressione cron per controllare la pianificazione del job di backup | `*/30 * * * *` |
| `KRAWL_BACKUPS_ENABLED` | Booleano per abilitare il job di dump del database | `true` |
</details>
<details>
<summary><b>Trappole: tarpit, pagine di inganno e canary</b> (6 variabili)</summary>
Trappole opt-in e pagine servite agli attaccanti.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_TARPIT_ENABLED` | Intrappola gli agenti AI con risposte lente e testo casuale | `false` |
| `KRAWL_TARPIT_DELAY_SECONDS` | Ritardo extra in secondi aggiunto per risposta quando il tarpit è attivo | `5` |
| `KRAWL_DECEPTION_IMPORT_PAGES` | Importa automaticamente le pagine di inganno da `src/templates/deception/` all'avvio | `true` |
| `KRAWL_CUSTOM_TEMPLATE_PATH` | Percorso all'interno del container verso un template HTML personalizzato. Il template deve includere i placeholder `{counter}` e `{content}`. | `/templates/custom_page.html` |
| `KRAWL_CANARY_TOKEN_URL` | URL del token canary esterno | None |
| `KRAWL_CANARY_TOKEN_TRIES` | Richieste prima di mostrare il token canary | `10` |
</details>
<details>
<summary><b>Analizzatore di reputazione IP</b> (6 variabili)</summary>
Soglie che determinano come viene classificato un IP.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_HTTP_RISKY_METHODS_THRESHOLD` | Soglia per il rilevamento di metodi HTTP rischiosi | `0.1` |
| `KRAWL_VIOLATED_ROBOTS_THRESHOLD` | Soglia per le violazioni di robots.txt | `0.1` |
| `KRAWL_UNEVEN_REQUEST_TIMING_THRESHOLD` | Soglia del coefficiente di variazione per il timing | `0.5` |
| `KRAWL_UNEVEN_REQUEST_TIMING_TIME_WINDOW_SECONDS` | Finestra temporale per l'analisi del timing delle richieste in secondi | `300` |
| `KRAWL_USER_AGENTS_USED_THRESHOLD` | Soglia per il rilevamento di più user agent | `2` |
| `KRAWL_ATTACK_URLS_THRESHOLD` | Soglia per il rilevamento di URL di attacco | `1` |
</details>
<details>
<summary><b>Acquisizione threat-intel</b> (4 variabili)</summary>
Esegue il fuzzy-hash dei payload catturati (file e corpi di richiesta segnalati) e raggruppa
le varianti quasi-duplicate in cluster di campagne. Richiede `py-tlsh`.
L'hashing viene eseguito come task in background pianificato `hash-payloads` (vedi
`src/tasks/hash_payloads.py`), che calcola l'hash di ogni attacco catturato una volta — i nuovi
hit al momento dell'ingest, e una scansione retroattiva una tantum della cronologia esistente
tracciata da un high-water mark `payload_hash_watermark` — quindi raggruppa i
digest in campagne a pattern ricorrente.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_TLSH_ENABLED` | Calcola l'hash dei file caricati e dei corpi di richiesta segnalati con TLSH per il clustering dei quasi-duplicati | `true` |
| `KRAWL_TLSH_CLUSTER_THRESHOLD` | Distanza TLSH al di sotto della quale un payload si unisce a una campagna esistente (0 = byte identici; le varianti di un webshell tipicamente differiscono di < 100) | `150` |
| `KRAWL_TLSH_CAMPAIGN_MIN_EVENTS` | Numero di volte in cui un payload deve essere visto prima che la sua campagna appaia nella scheda Threats | `10` |
| `KRAWL_REFERER_ENABLED` | Registra l'HTTP Referer in entrata nei log degli accessi, per il tracciamento delle catene di esca | `true` |
</details>
<details>
<summary><b>Banlist e IP ignorati</b> (4 variabili)</summary>
Condivisione delle banlist con altre istanze e traffico da non tracciare mai.
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_IGNORED_IPS` | IP/CIDR separati da virgola mai tracciati, bannati o esportati | Loopback, RFC1918, link-local, CGNAT |
| `KRAWL_BANLIST_EXPORT_PATH` | Percorso pubblico di download della banlist, ad es. `/public_banlist.txt` (vuoto = disabilitato) | `""` |
| `KRAWL_BANLIST_SOURCES` | URL di banlist upstream separati da virgola da recuperare e unire | Banlist della community Krawl |
| `KRAWL_BANLIST_REFRESH_INTERVAL` | Secondi tra i recuperi delle banlist upstream | `3600` |
</details>
<details>
<summary><b>Pagine di inganno generate dall'AI</b> (10 variabili)</summary>
Vedi la [documentazione sulla generazione AI](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_AI_ENABLED` | Abilita le pagine di inganno generate dall'AI | `false` |
| `KRAWL_AI_PROVIDER` | Provider AI (`"openrouter"` o `"openai"`) | `"openrouter"` |
| `KRAWL_AI_OPENAI_BASE_URL` | Base URL OpenAI opzionale per endpoint API personalizzati | `"https://api.openai.com/v1"` |
| `KRAWL_AI_API_KEY` | Chiave API per il provider AI | `None` |
| `KRAWL_AI_MODEL` | Modello AI da utilizzare per la generazione delle pagine | `"nvidia/nemotron-3-super-120b-a12b:free"` |
| `KRAWL_AI_TIMEOUT` | Timeout della richiesta in secondi per le chiamate all'API AI | `60` |
| `KRAWL_AI_MAX_DAILY_REQUESTS` | Numero massimo di pagine generate dall'AI al giorno (0 = illimitato) | `0` |
| `KRAWL_AI_PROMPT` | Template di prompt personalizzato per la generazione delle pagine AI | Prompt predefinito |
| `KRAWL_AI_REASONING_ENABLED` | Abilita i token di reasoning (solo modelli di reasoning OpenRouter) | `false` |
| `KRAWL_AI_REASONING_EFFORT` | Sforzo di reasoning (`none`, `minimal`, `low`, `medium`, `high`, `xhigh`) | `"medium"` |
</details>
<details>
<summary><b>Modalità scalabile: PostgreSQL e Redis</b> (13 variabili)</summary>
Utilizzate solo quando `KRAWL_MODE=scalable`. Vedi [Modalità di deployment](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
| Variabile d'ambiente | Descrizione | Default |
|----------------------|-------------|---------|
| `KRAWL_MODE` | Modalità di deployment (`standalone` o `scalable`) | `standalone` |
| `KRAWL_POSTGRES_HOST` | Hostname PostgreSQL | `localhost` |
| `KRAWL_POSTGRES_PORT` | Porta PostgreSQL | `5432` |
| `KRAWL_POSTGRES_USER` | Username PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_PASSWORD` | Password PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_DATABASE` | Nome del database PostgreSQL | `krawl` |
| `KRAWL_REDIS_HOST` | Hostname Redis | `localhost` |
| `KRAWL_REDIS_PORT` | Porta Redis | `6379` |
| `KRAWL_REDIS_DB` | Numero del database Redis | `0` |
| `KRAWL_REDIS_PASSWORD` | Password Redis | None |
| `KRAWL_REDIS_CACHE_TTL` | TTL in secondi per i dati di warmup della dashboard | `600` |
| `KRAWL_REDIS_HOT_TTL` | TTL in secondi per i dati hot-path (info sui ban, categorie IP) | `30` |
| `KRAWL_REDIS_TABLE_TTL` | TTL in secondi per le tabelle paginate della dashboard | `120` |
</details>
Ad esempio```bash
# Set canary token
export CONFIG_LOCATION="config.yaml"
export KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url"
# Set number of pages range (min,max format)
export KRAWL_LINKS_PER_PAGE_RANGE="5,25"
# Set analyzer thresholds
export KRAWL_HTTP_RISKY_METHODS_THRESHOLD="0.2"
export KRAWL_VIOLATED_ROBOTS_THRESHOLD="0.15"
# Set custom dashboard path and password
export KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard"
export KRAWL_DASHBOARD_PASSWORD="my-secret-password"
```
Esempio di esecuzione Docker con variabili d'ambiente (modalità standalone):```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_MODE=standalone \
-e KRAWL_PORT=5000 \
-e KRAWL_DELAY=100 \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-e KRAWL_CUSTOM_TEMPLATE_PATH="/templates/custom_page.html" \
-e KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url" \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
## Usare Krawl per bloccare IP malevoli
Krawl utilizza un sistema basato sulla reputazione per classificare gli indirizzi IP degli attaccanti e fornisce due modi per esportare gli elenchi di IP per l'integrazione con il firewall.
L'endpoint `/api/export-ips` interroga direttamente il database e supporta il filtraggio per categoria di IP (`attacker`, `bad_crawler`, `regular_user`, `good_crawler`) e formato di output (`raw`, `iptables`, `nftables`):```bash
curl "https://your-krawl-instance/<DASHBOARD-PATH>/api/export-ips?categories=attacker&fwtype=raw"
```
Questo consente il blocco automatico del traffico malevolo su varie piattaforme:
* [OPNsense e pfSense](https://ipv64.net/v64_blocklist_integration_guide)
* [RouterOS](https://rentry.co/krawl-routeros)
* [IPtables](https://github.com/blessedrebus/krawl/blob/main/plugins/iptables/README.md) e [Nftables](https://github.com/blessedrebus/krawl/blob/main/plugins/nftables/README.md)
* [Fail2Ban](https://github.com/blessedrebus/krawl/blob/main/plugins/fail2ban/README.md)
Per i parametri completi dell'API, gli esempi e l'aggiunta di formati firewall personalizzati, consulta la [documentazione dei Firewall Exporters](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md).
Krawl può anche inviare direttamente gli IP bannati a una IP List di un Account Cloudflare per l'utilizzo nelle regole WAF. La sincronizzazione viene eseguita come attività in background e aggiorna la lista tramite sostituzione completa a intervalli configurabili. Consulta la documentazione [Cloudflare Banlist Sync](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md).
## IP Reputation
Krawl [utilizza attività che analizzano il traffico recente per costruire e aggiornare continuamente un punteggio di reputazione IP](https://github.com/blessedrebus/krawl/blob/main/src/tasks/analyze_ips.py). Viene eseguito periodicamente e valuta ogni indirizzo IP attivo in base a molteplici indicatori comportamentali per classificarlo come attaccante, crawler o utente regolare. Le soglie sono completamente personalizzabili.
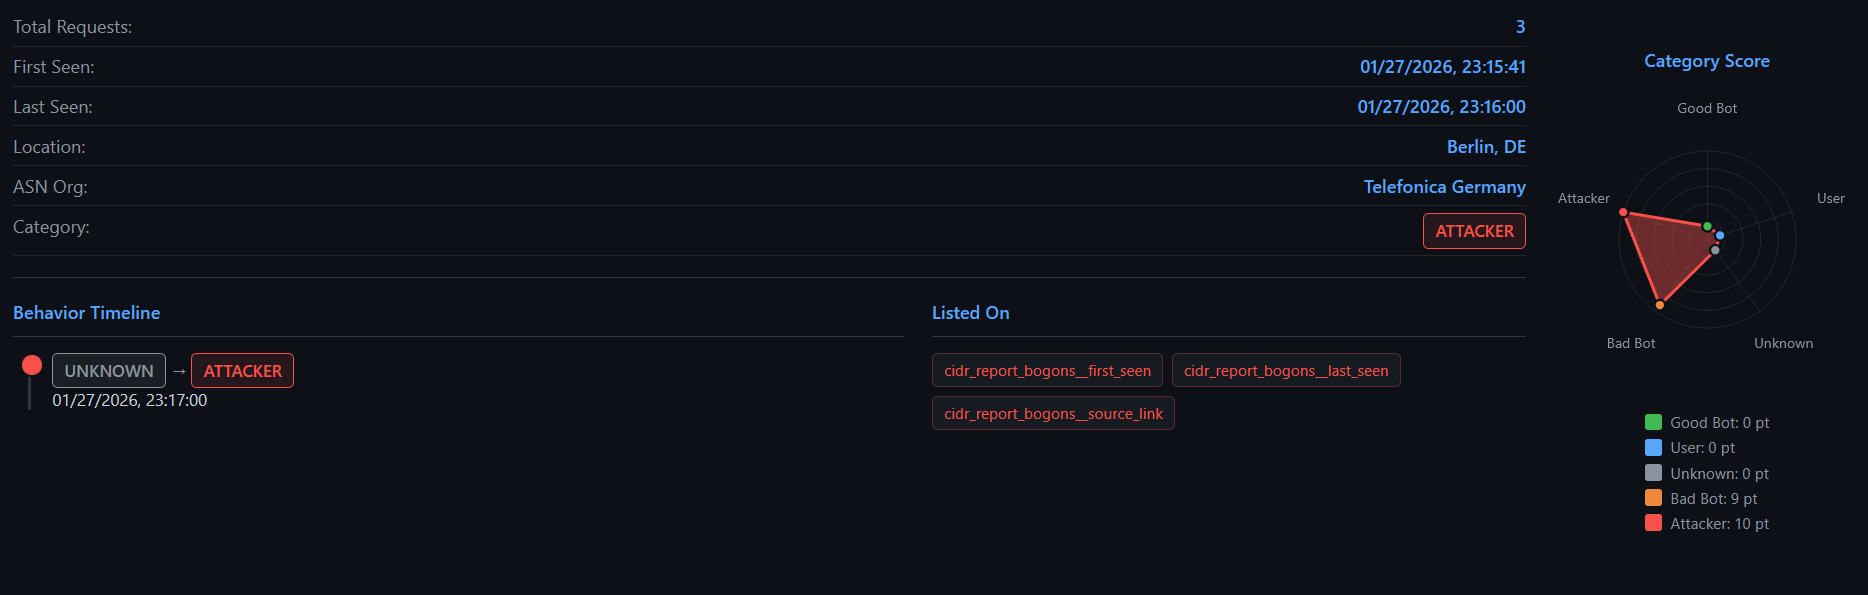
L'analisi include:
- **Utilizzo di metodi HTTP rischiosi** (ad es. rapporti di POST, PUT, DELETE)
- **Violazioni di Robots.txt**
- **Anomalie nella temporizzazione delle richieste** (pattern a raffica o irregolari)
- **Coerenza dello User-Agent**
- **Rilevamento di URL di attacco** (ad es. pattern di SQL injection, XSS)
Ogni segnale contribuisce a un modello di punteggio ponderato che assegna una categoria di reputazione:
- `attacker`
- `bad_crawler`
- `good_crawler`
- `regular_user`
- `unknown` (per dati insufficienti)
I punteggi e le metriche risultanti vengono memorizzati nel database e utilizzati da Krawl per alimentare dashboard, monitoraggio della reputazione e azioni di mitigazione automatizzate come il ban degli IP o l'integrazione con il firewall.
## Pagine di Inganno Generate dall'IA
Krawl può generare automaticamente pagine di inganno realistiche utilizzando modelli IA dalle API **OpenRouter** o **OpenAI**. Questa funzionalità crea pagine honeypot uniche e plausibili al volo per ingannare gli attaccanti senza la creazione manuale delle pagine.
**Caratteristiche principali:**
- **Generazione dinamica**: Crea pagine HTML uniche per qualsiasi percorso di richiesta
- **Caching intelligente**: Memorizza nella cache le pagine generate per evitare chiamate API ridondanti
- **Limitazione giornaliera della frequenza**: Controlla i costi API con limiti di richieste configurabili
- **Provider multipli**: Supporto per OpenRouter (opzioni gratuite) e OpenAI
- **Fallback controllato**: Torna all'honeypot standard quando disabilitato o al raggiungimento del limite
- **Servizio in cache**: Le pagine generate in precedenza vengono servite anche quando l'IA è disabilitata
**Configurazione rapida:**```yaml
ai:
enabled: true
provider: "openrouter"
openai_base_url: "your-custom-base-url"
api_key: "your-api-key"
model: "nvidia/nemotron-3-super-120b-a12b:free"
timeout: 60
max_daily_requests: 10
```
Per la configurazione dettagliata e l'utilizzo, consulta la [documentazione sulla generazione AI](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
Puoi anche **contribuire con template di inganno** aprendo una PR, vedi [Contributing Deception Templates](https://github.com/blessedrebus/krawl/blob/main/docs/deception_pages.md#contributing-deception-templates-via-pr).
## Esecuzione dietro un Reverse Proxy o CDN
**NGINX, Traefik e altri proxy come CloudFlare** necessitano dell'inoltro degli header affinché Krawl possa vedere l'IP reale. Consulta la [documentazione sul Reverse Proxy](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md) per esempi di configurazione e l'elenco completo degli header.
## Metriche e Monitoraggio
```
---
[Read more](https://github.com/blessedrebus/krawl)
