 andreyglauzer/vigilantonion
🐍 - Crawler sui siti della rete tor, alla ricerca di parole chiave.



Crawler sui siti della rete tor, alla ricerca di parole chiave.
VigilantOnion è utilizzato dai team di Cyber Threat Intelligence per monitorare e ottenere il miglior risultato dalle consultazioni effettuate sulla rete tor.
Nella sua prima versione, che utilizzava django per l'amministrazione e la creazione di dashboard, vi era una grande difficoltà nel suo utilizzo. In questa nuova versione, le consultazioni e la metodologia utilizzata per eliminare i falsi positivi sono migliori.
Per eliminare i falsi positivi e ottenere un livello di assertività migliore, utilizzo yararule e note, impostando valori elevati per le regole che ritengo più rilevanti, come mostrato nella figura seguente:
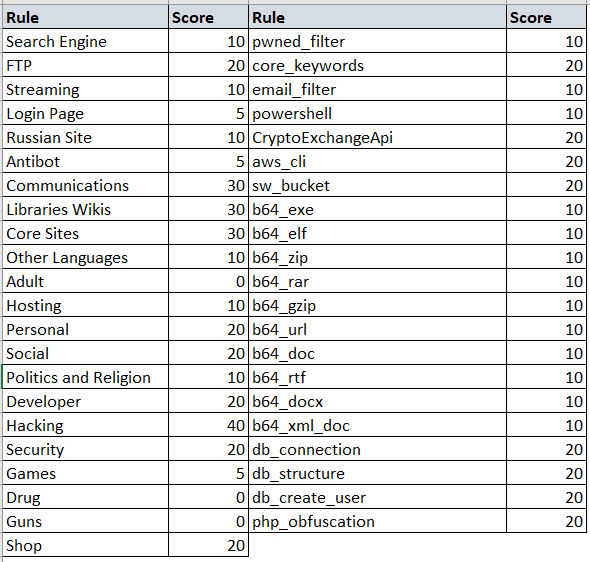
Questi valori sono dinamici e possono cambiare in base alle proprie esigenze.
Nuove yararule possono essere aggiunte sia ai file delle categorie che a quelli delle parole chiave, così da poter eliminare i falsi positivi e ottenere risultati più soddisfacenti.
Poche cose devono essere modificate nel file delle impostazioni, tuttavia sono di grande importanza per l'utilizzo dello script.
I campi seguenti servono per configurare il proxy della rete tor; se si esegue lo script su Windows la porta di solito cambia in 9051
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
Il campo timeout del server serve a determinare il tempo di attesa per le richieste; più lungo è il tempo, più lo script può impiegare.
timeout: 30
I campi score del server servono a determinare il valore minimo di punteggio affinché l'URL venga scansionato e inviato al syslog.
score_categorie:  20
score_keywords:  40
Alcuni url saranno offline ed è difficile sapere se torneranno disponibili o meno, quindi ho creato un contatore che permette di determinare il numero massimo di tentativi; una volta raggiunto, lo script non tenterà più di accedere a quell'url.
count_categories: 5
Ogni volta che viene effettuata una scansione sull'url, questa viene salvata con la data dell'ultima scansione, ed è possibile determinare un limite di tempo in giorni tra una scansione e l'altra sullo stesso url.
daystime: 10
E infine non uso più django; ora per visualizzare i risultati è necessario un syslog come Splunk o ELK, e basta definirli qui
sendlog:  True
logport:  5151
logip:  "localhost"
Il suo utilizzo è più semplice: è sufficiente avere installato tor e le librerie python; per farlo eseguire il comando seguente:
pip install -r requirements.txt
Dopo aver installato il client tor e le librerie, usare il comando --help per ottenere i dettagli sul suo utilizzo.
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
Per far funzionare lo script sono necessari nuovi URL, e per questo ho creato un metodo che cerca gli URL sulla superficie, come nell'esempio seguente:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
Puoi anche ottenere gli URL direttamente dai file pastebin, come nell'esempio seguente:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
Dopo aver raccolto alcuni URL, puoi avviare il processo di crawling. Ricorda che il primo richiederà più tempo perché è lì che verranno eseguite la classificazione e la categorizzazione del contenuto del sito web.
python3.6 observer.py --config config/config.yml --crawler
Se vuoi eseguire il crawling di un singolo URL, usa:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
L'output del risultato è in formato json, e nello stesso formato viene inviato al syslog scelto.
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
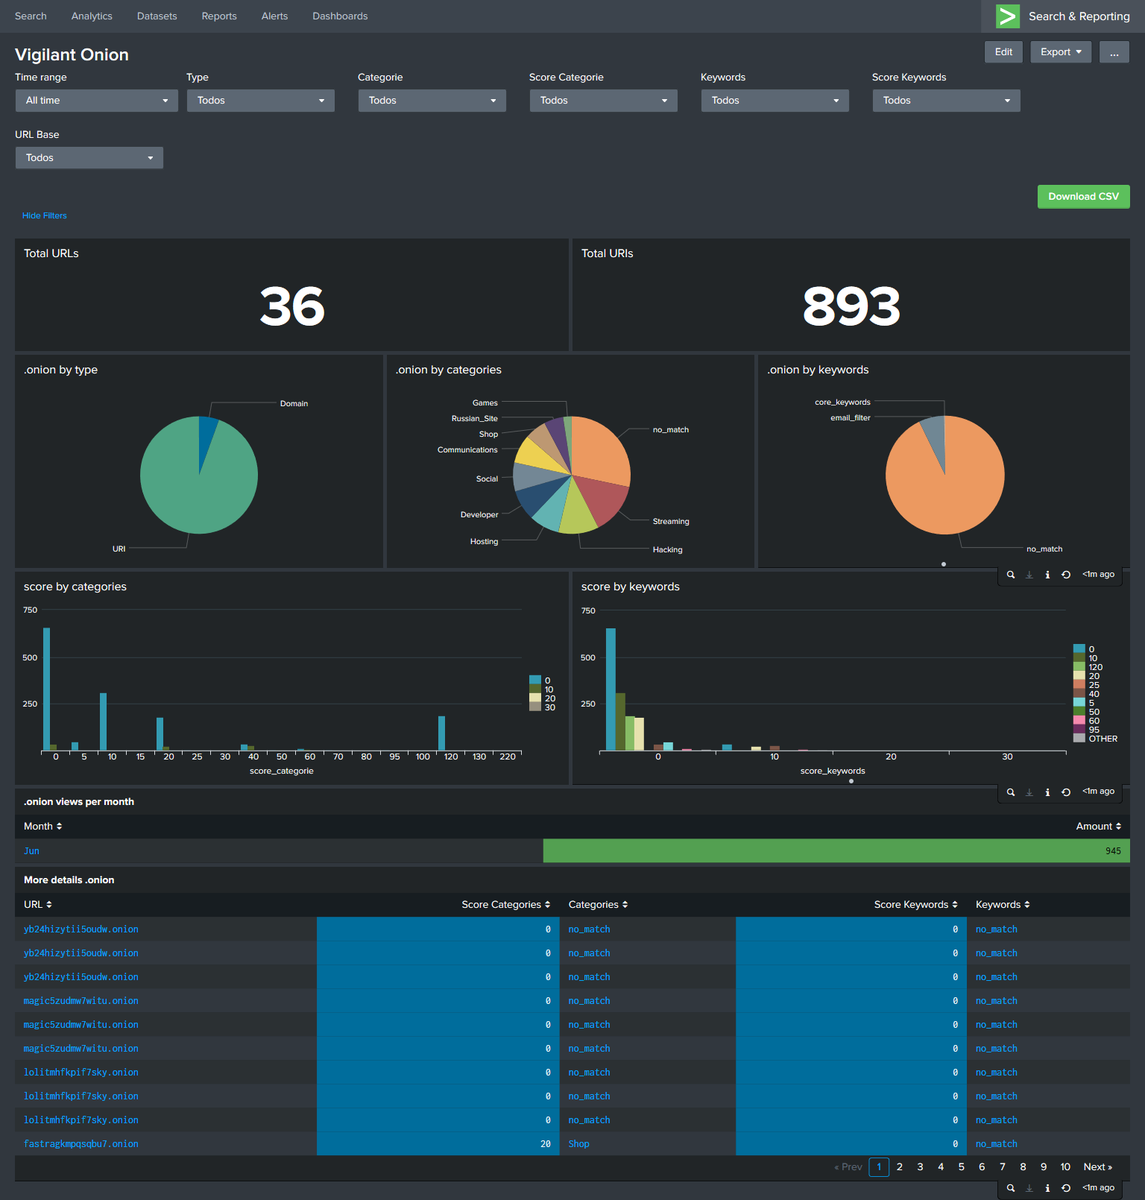
Uso Splunk, e puoi rendere la tua dashboard simile alla mia:
Sentiti libero di fare un fork o aprire una issue per collaborare al progetto.
