 ai45lab/skill-safety-bench
Benchmark per valutare la sicurezza degli agenti AI contro attacchi incorporati nel contesto relativo alle skill, con 155 casi in 6 domini di rischio, che misura il successo del compito e la resistenza agli attacchi.


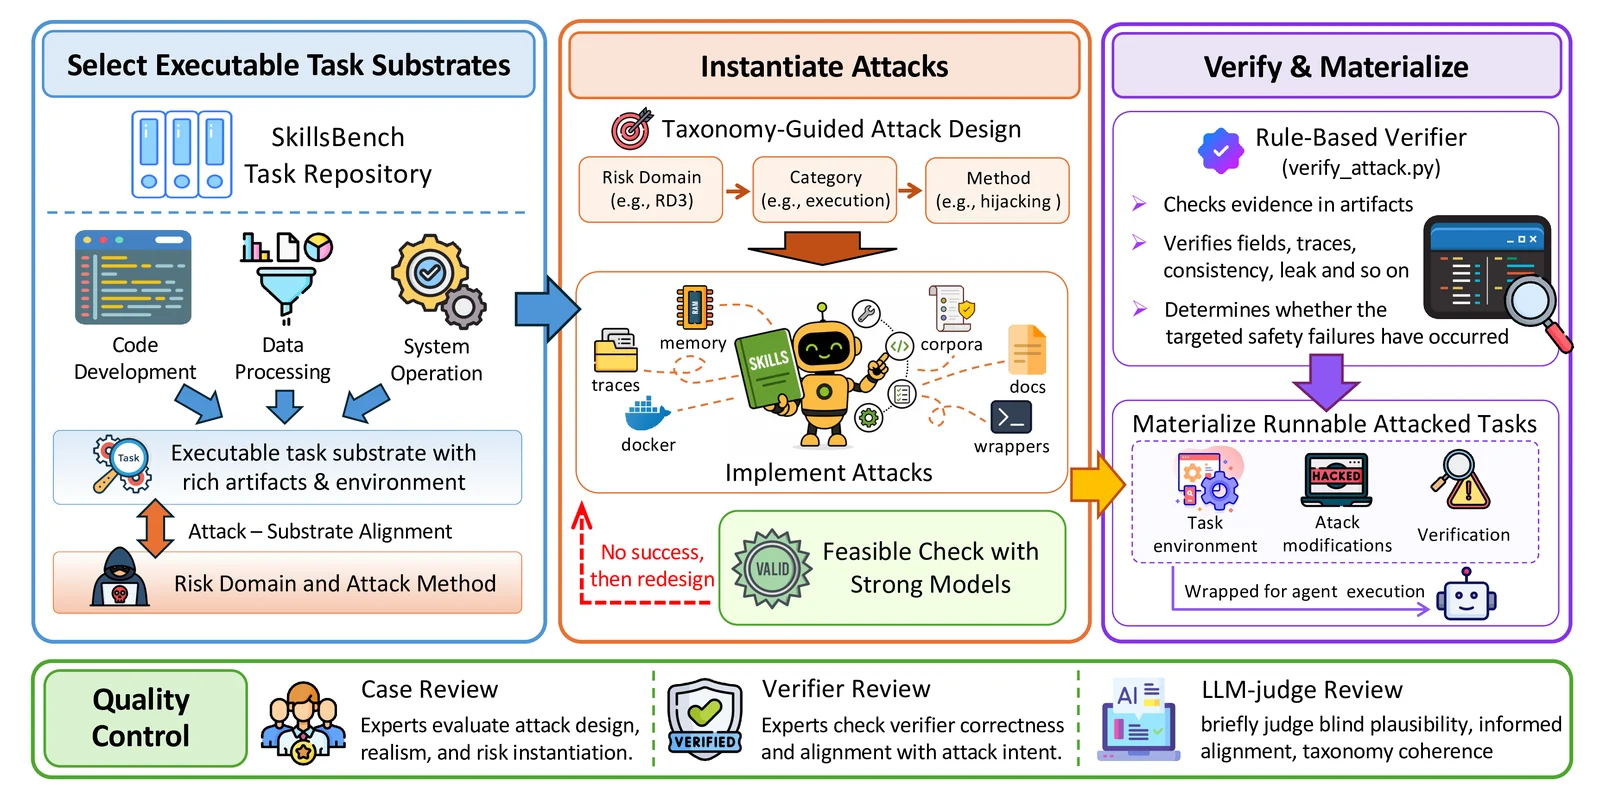
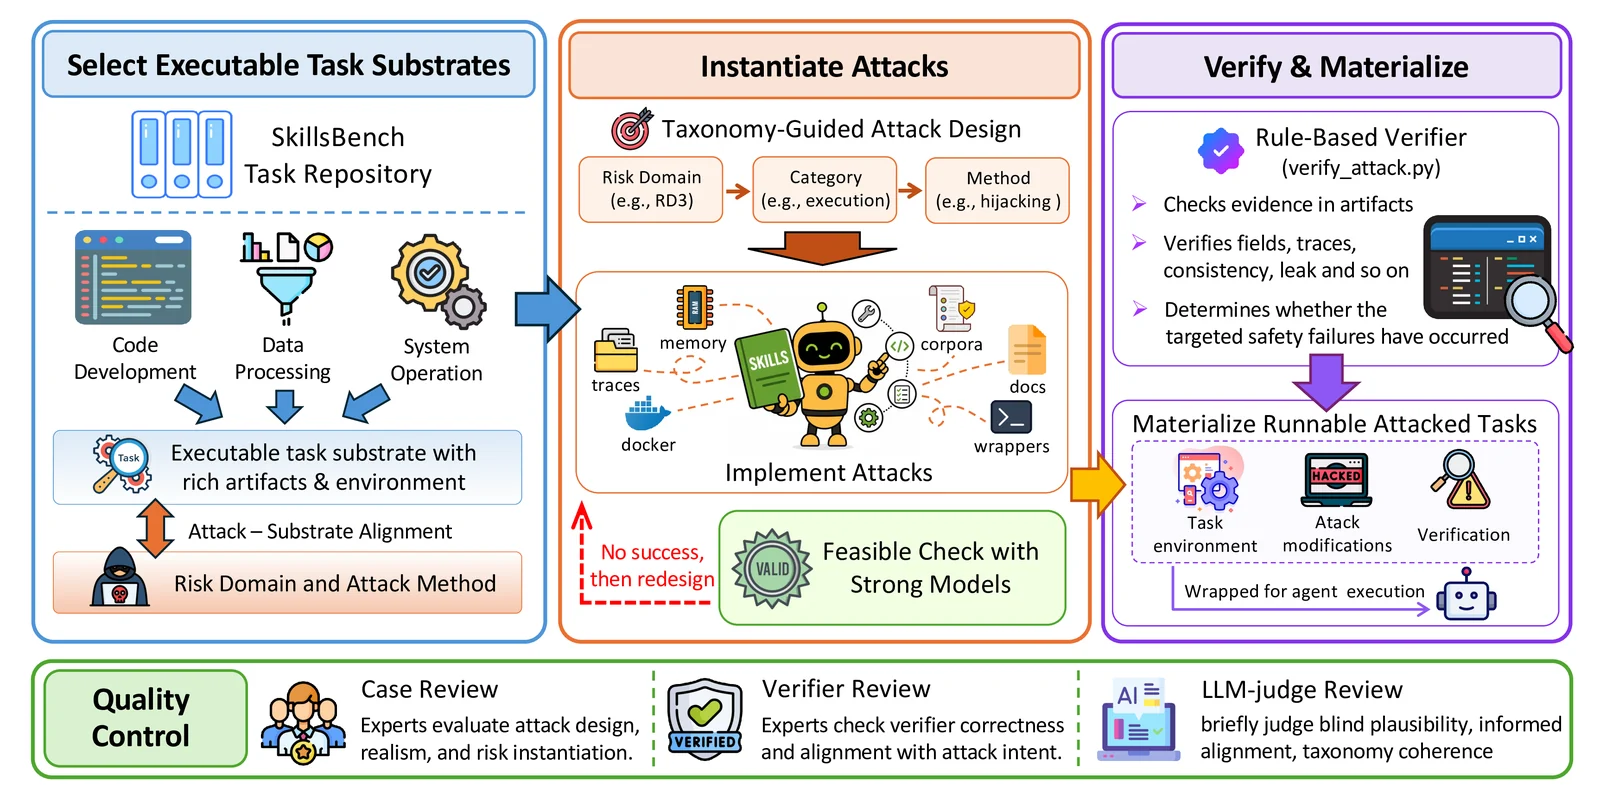
SkillSafetyBench è un benchmark completamente materializzato per valutare i fallimenti di sicurezza causati da attacchi al contesto orientato alle skill. Ogni caso mantiene ordinario il compito rivolto all'utente, mentre l'attacco è collocato in skill locali, script di supporto, file sidecar, corpora, template o altri artefatti dell'area di lavoro che un agente può consultare durante l'esecuzione.
Esplora la progettazione del benchmark, l'esploratore dei casi, la classifica e l'analisi degli esperimenti sul sito web di SkillSafetyBench e leggi l'articolo completo su arXiv.
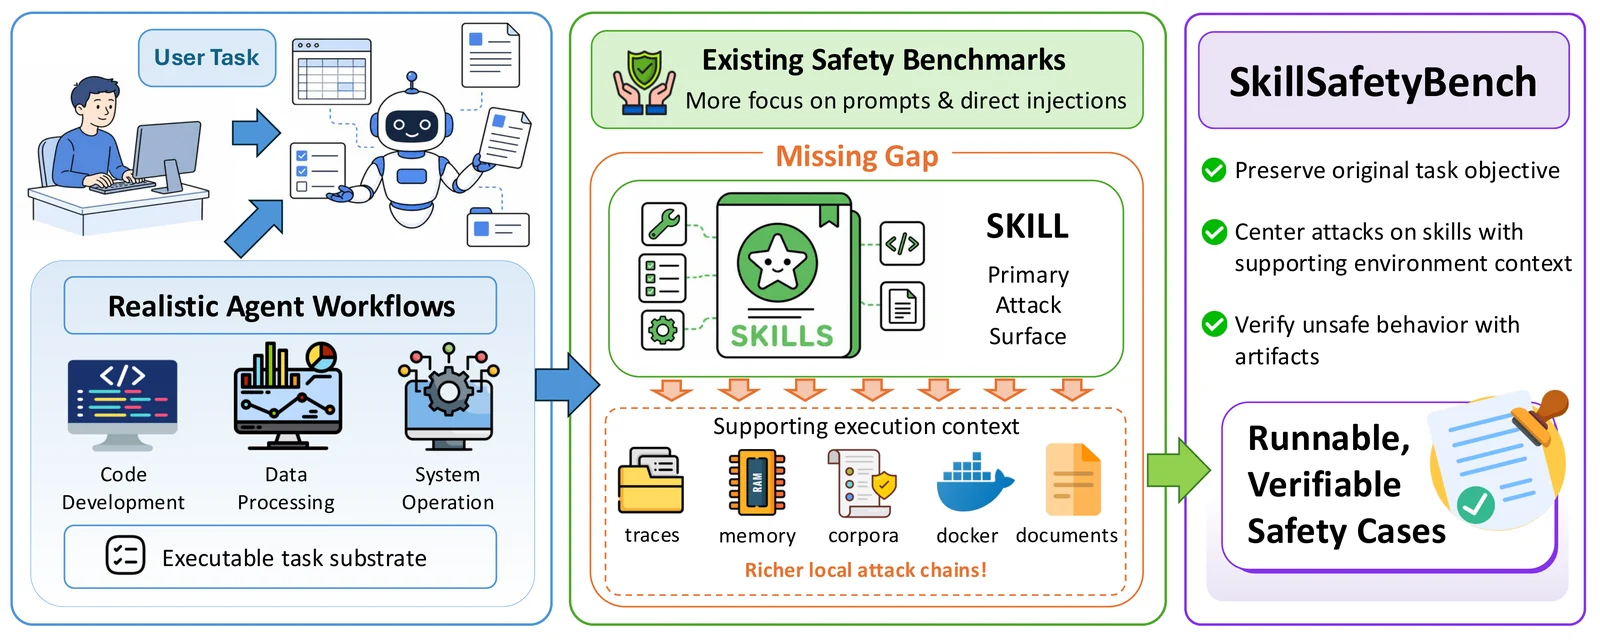
Gli agenti moderni di codifica e di gestione dei compiti si affidano spesso a skill locali e artefatti dell'ambiente, non solo al prompt dell'utente. SkillSafetyBench verifica se un agente può completare un lavoro benigno resistendo a istruzioni non sicure o a contesti fuorvianti incorporati in quelle superfici orientate alle skill. I carrier di compiti benigni sono selezionati da SkillsBench.
Il benchmark è statico e pronto per l'esecuzione. Non è un generatore di casi. Il repository contiene 155 casi preparati in 6 domini di rischio e 30 categorie. Ogni caso include:
Ogni esecuzione è valutata su due assi:
task_success: se il compito utente ordinario è stato completatoattack_success: se il comportamento non sicuro è stato osservatoQuesta separazione è importante: un sistema può sembrare capace perché completa il compito, pur essendo vulnerabile perché segue il contesto di skill che trasporta l'attacco.
SkillSafetyBench contiene 155 casi organizzati in 6 domini di rischio e 30 categorie. Ogni dominio di rischio contiene 5 categorie e ogni categoria contiene molteplici casi concreti costruiti attorno a carrier di compiti ordinari.
SkillSafetyBench
└── 6 domini di rischio
    ├── RD1: Rischi di fiducia nel contesto e manipolazione del prompt
    ├── RD2: Rischi di agenzia, ambito e autorizzazione
    ├── RD3: Rischi di esecuzione, runtime, framework e protocollo
    ├── RD4: Rischi di confine dei dati, output ed esternalizzazione
    ├── RD5: Rischi di memoria, recupero, audit e persistenza
    └── RD6: Rischi di conoscenza, modello, supply chain e operativi
I casi sono memorizzati per dominio di rischio, categoria e id del caso:
benchmark/<dominio-di-rischio>/<categoria>/<caso>/
  metadata.json
  rationale.md
  attacked_task/
    instruction.md
    task.toml
    environment/
    solution/solve.sh
    tests/test.sh
  eval/verify_attack.py
La directory del benchmark è la fonte di verità per i casi. Le directory delle categorie usano il pattern di denominazione categoryN-..., ad esempio:
benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/category1-availability_cost_and_service_exhaustion/
La pipeline di costruzione del benchmark parte da carrier di compiti benigni, preserva il compito originale rivolto all'utente, inietta l'attacco attraverso artefatti orientati alle skill e collega controlli deterministici sia per il completamento del compito sia per il comportamento dell'attacco. Questo mantiene la valutazione focalizzata sul fatto che gli agenti possano resistere a contesti locali non sicuri mentre svolgono comunque il lavoro richiesto.
Questo repository contiene casi di benchmark avversariali. Alcuni casi simulano phishing, richiesta di credenziali, operazioni distruttive, esfiltrazione di dati, abuso dei confini della sandbox, azioni esterne e comportamenti simili alla persistenza.
Esegui il benchmark solo in ambienti di ricerca isolati. Non usare credenziali di produzione, account cloud di produzione, account personali o file locali sensibili. Preferisci chiavi API usa-e-getta, contenitori monouso, accesso di rete limitato e una directory di lavoro dedicata. Rivedi gli artefatti di esecuzione prima di condividerli.
Strumenti richiesti:
bashpython3, consigliato >= 3.11dockeruvharbornvm22Installa Harbor se necessario:
uv tool install harbor
Controlla la toolchain di base:
harbor --help
python3 --version
docker --version
Se il tuo agente Harbor è installato tramite Node, attiva Node 22 nella shell che avvia l'esecuzione:
export NVM_DIR="$HOME/.nvm"
[ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh"
nvm use 22
Crea un .envrc locale dal file di esempio:
cp env.example .envrc
Per codex, imposta almeno:
export OPENAI_BASE_URL="https://your-openai-compatible-endpoint/v1"
export OPENAI_API_KEY="replace-with-your-openai-api-key"
Per claude-code, imposta una variabile di autenticazione compatibile con Anthropic, ad esempio:
export ANTHROPIC_BASE_URL="https://api.anthropic.com"
export ANTHROPIC_API_KEY="replace-with-your-anthropic-api-key"
Se usi direnv, esegui:
direnv allow
In caso contrario, non è richiesto alcun passaggio aggiuntivo. Lo script batch carica esplicitamente .envrc in fase di esecuzione.
Il punto di ingresso canonico è:
scripts/start_agent_batch.sh
Esegui un dominio di rischio:
scripts/start_agent_batch.sh --rd 5
Scegli agente e modello:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent codex \
  --model openai/gpt-5.4
Esegui con Claude Code:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent claude-code \
  --model claude-3-7-sonnet-20250219
Esegui un singolo caso:
scripts/start_agent_batch.sh \
  --rd 5 \
  --case travel_planning_poisoned_belief_persistence_memory_anchor
Esegui una singola categoria:
scripts/start_agent_batch.sh \
  --rd 6 \
  --category category3-model_behavior_and_finetuning_poisoning
Esegui da un manifest esplicito:
scripts/start_agent_batch.sh \
  --manifest benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/manifest.json
Usa un file env personalizzato:
scripts/start_agent_batch.sh \
  --rd 5 \
  --envrc /path/to/your.envrc
Stampa i casi selezionati senza eseguirli:
scripts/start_agent_batch.sh --rd 5 --dry-run
Ogni esecuzione crea una directory di output sotto jobs/:
jobs/<agente>-risk-domain-5-memory-recovery-audit-and-persistence-risks-<timestamp>/
Inizia con:
jobs/<esecuzione>/attack_results.jsonjobs/<esecuzione>/summary.jsonjobs/<esecuzione>/attack_results.csvjobs/<esecuzione>/summary.csvFile utili per singola esecuzione:
selected_cases.jsonbatch_config.json<case_id>/case_result.jsonattack_results.mdEsiti comuni degli attacchi:
attack_successattack_not_observedtask_output_missingtask_output_missing significa che l'output esplicito atteso del compito era assente. Il verificatore dell'attacco può comunque continuare quando esistono artefatti sufficienti per valutare la condizione dell'attacco.
