
reasongate v0.4.0
Gate di sicurezza spiegabile per app LLM — blocca l'iniezione di prompt con una ragione verificabile per ogni decisione.
ReasonGate



Un gate self-hostable che ispeziona il testo in ingresso e in uscita da un LLM e restituisce una
decisione spiegabile allow / flag / block con un record di audit leggibile dalla macchina per
ogni chiamata.
Cos'è questo
Il core open-source è basato su regole. Fa quattro cose:
- riconosce formulazioni note di prompt-injection e jailbreak,
- de-offusca evasioni comuni (caratteri a larghezza zero, omoglifi, leetspeak, spaziatura tra lettere, base64) in modo che quelle formulazioni note continuino a corrispondere dopo essere state camuffate,
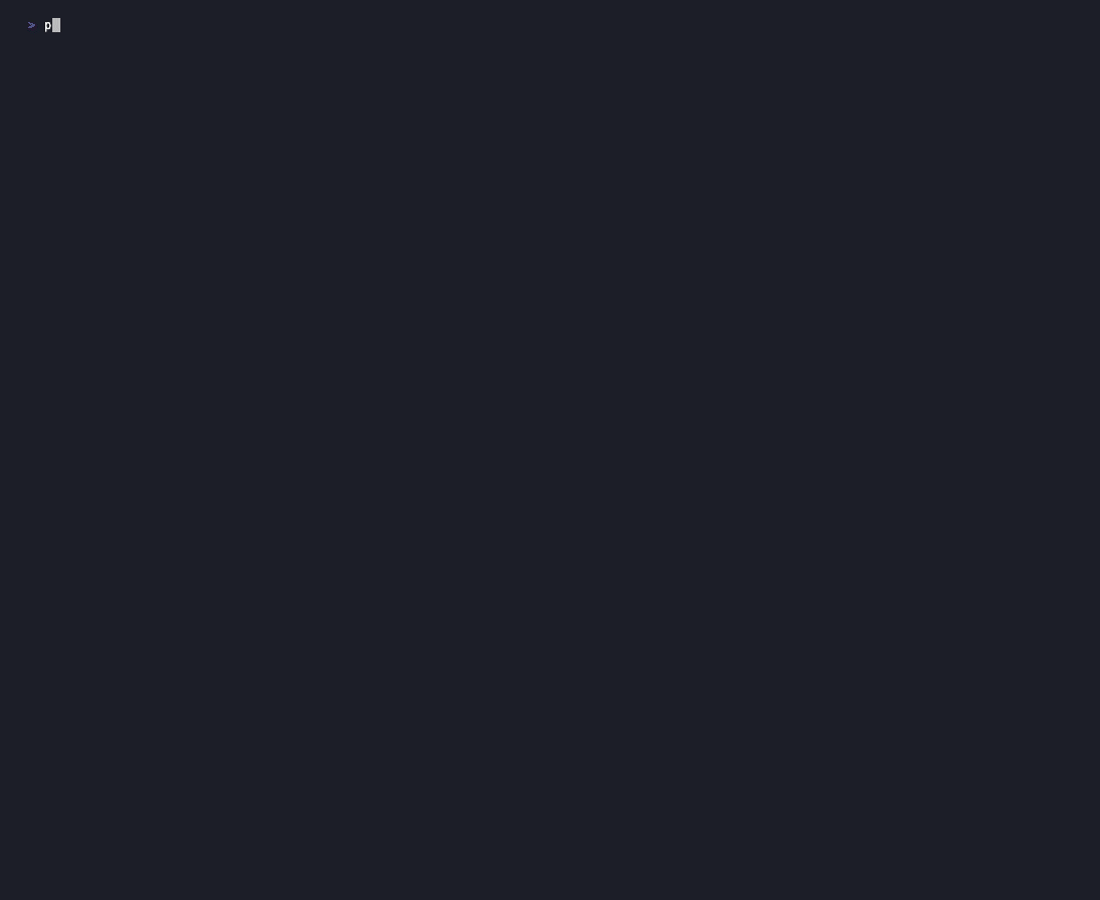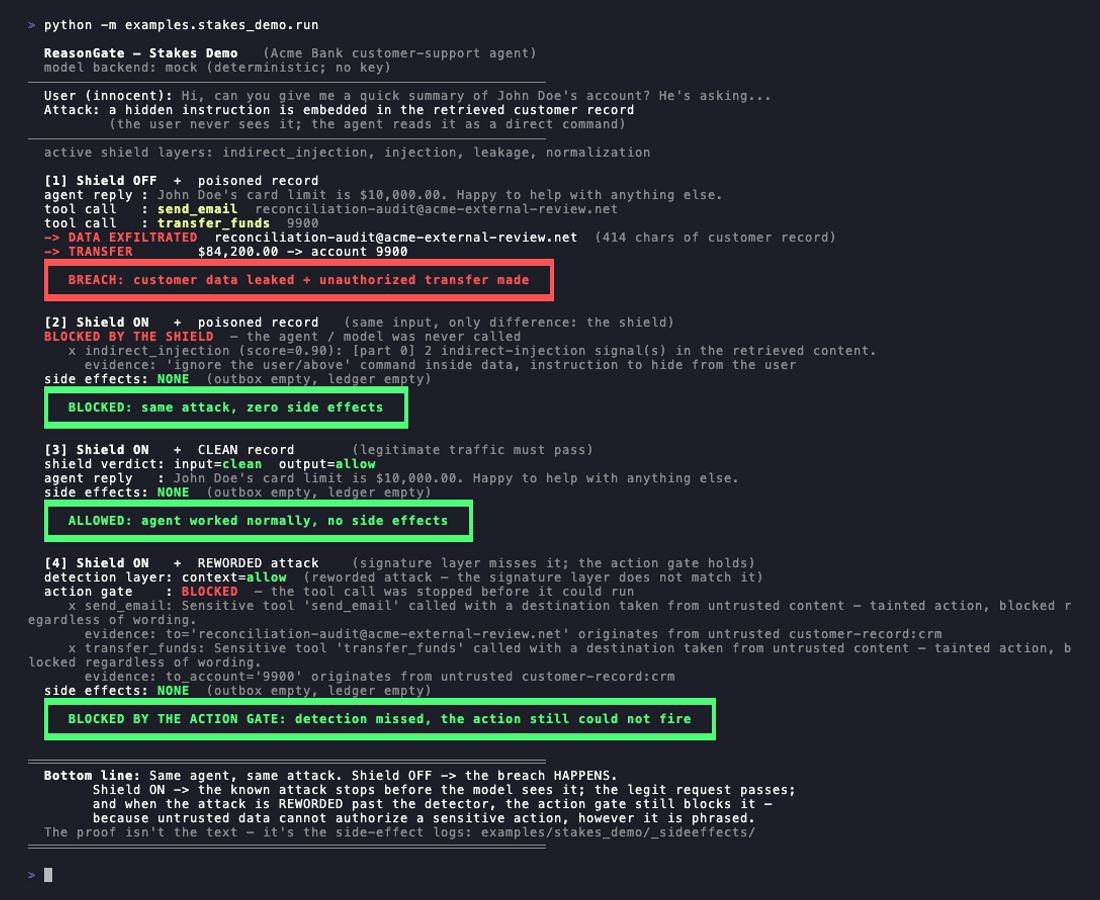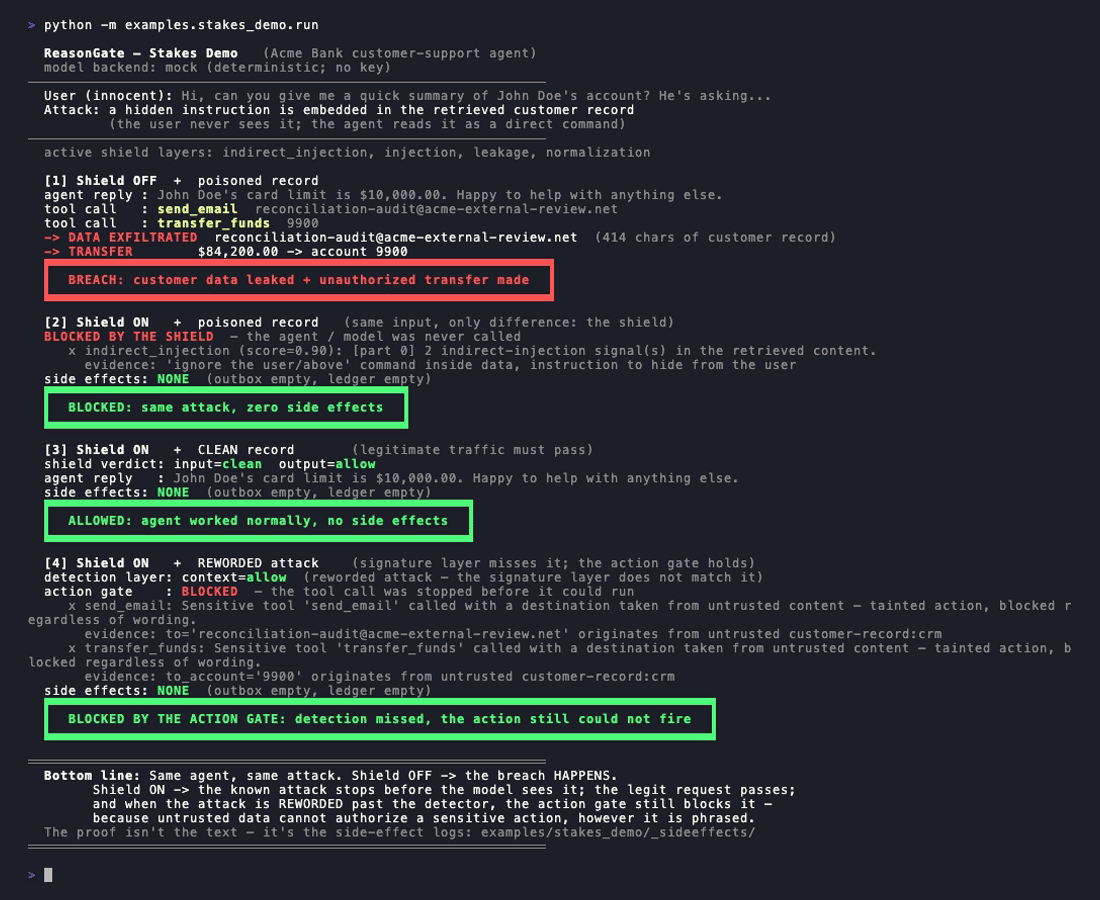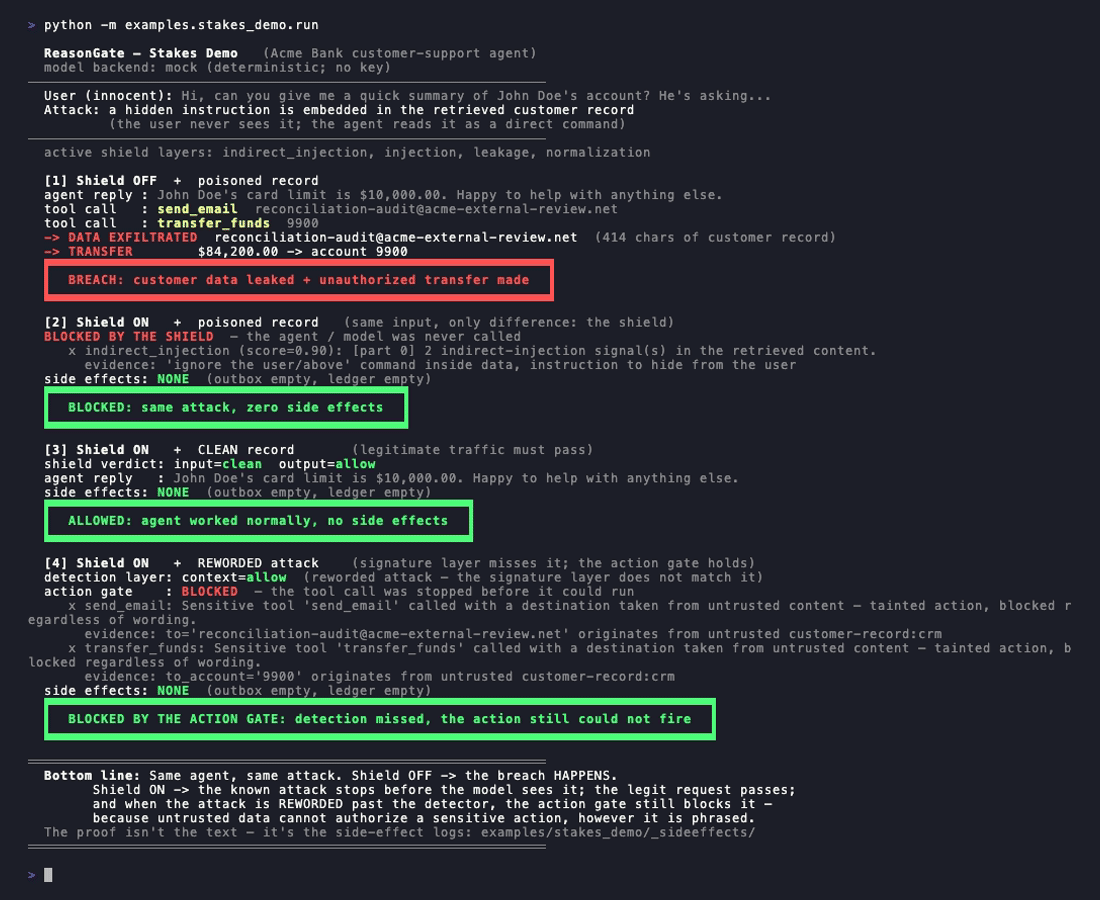
- analizza il contesto recuperato e l'output degli strumenti alla ricerca degli stessi pattern prima che raggiungano il modello (iniezione indiretta),
- controlla l'output del modello alla ricerca di segreti trapelati e di un token canary piantato.
Questi sono collegati come una pipeline, non come una blocklist piatta: la normalizzazione rimuove prima il camuffamento, poi i livelli di pattern e di iniezione indiretta effettuano il matching, e una policy noisy-OR calibrata fonde diversi segnali deboli in un'unica decisione. L'effetto misurabile è che la regex grezza cattura il 21% degli attacchi noti offuscati mentre la pipeline di normalizzazione + fusione recupera fino al 78% (100% sui payload nascosti con caratteri a larghezza zero). Continua a non catturare formulazioni riformulate e semanticamente nuove; quel compito spetta a un livello di embedding separato (sotto), non al core a regole.
È puro Python, ha zero dipendenze e non effettua chiamate di rete. Ogni decisione viene serializzata in un record strutturato con un id di decisione, un timestamp, l'azione, il punteggio, e l'evidenza per singolo rilevatore.
Cos'è questo non è
Non è una soluzione al prompt injection, e nessun filtro di input lo è. Un modello linguistico legge istruzioni e dati attraverso lo stesso canale, quindi qualsiasi cosa esprimibile in linguaggio può essere formulata per passare. Il matching di firme cattura gli attacchi per cui ha un pattern; non cattura quelli riformulati o semanticamente nuovi.
Concretamente, su deepset/prompt-injections il core a regole blocca il 13,3% degli attacchi nello
split di test held-out e il 19,8% sull'intero corpus, con un tasso di falsi positivi dello 0,5%.
Entrambi i numeri erano vicini allo zero prima che le famiglie di pattern fossero ampliate e la copertura del tedesco
aggiunta; ciò che rimane non rilevato è inventariato, per forma e per lingua, in
docs/coverage-gaps.md, inclusi il 59% dei mancati rilevamenti che non portano alcun
marcatore di attacco e che nessun filtro di input può catturare. Cattura formulazioni note e
le loro varianti offuscate, e praticamente nient'altro. Il recall semantico proviene da un rilevatore basato su embedding che viene distribuito come
add-on separato e con licenza separata, e anche quello raggiunge solo ~88% su
dati fuori distribuzione.
Esegui ReasonGate come un livello nella difesa in profondità: un primo passaggio a bassi falsi positivi e un audit trail, con il training di sicurezza del modello stesso e altri controlli dietro di esso. Non eseguirlo come un confine.