 zju-llm-safety/darwin
विकासवादी LLM जेलब्रेक और गार्डरेल फ्रेमवर्क जो सुरक्षा मूल्यांकन के लिए आनुवंशिक उत्परिवर्तन, मार्कोव चयन और ऑनलाइन विरोधी प्रशिक्षण के माध्यम से एक पुन: प्रयोज्य रणनीति पूल विकसित करता है।

एक विकासवादी आक्रमण–रक्षा ढाँचा जो ऑनलाइन प्रतिकूल प्रशिक्षण के माध्यम से
DARWIN-Attack को DARWIN-Guard के साथ जोड़ता है।
Paper · Guard Checkpoint · Installation · Use DARWIN-Attack · Use DARWIN-Guard · Training · Citation
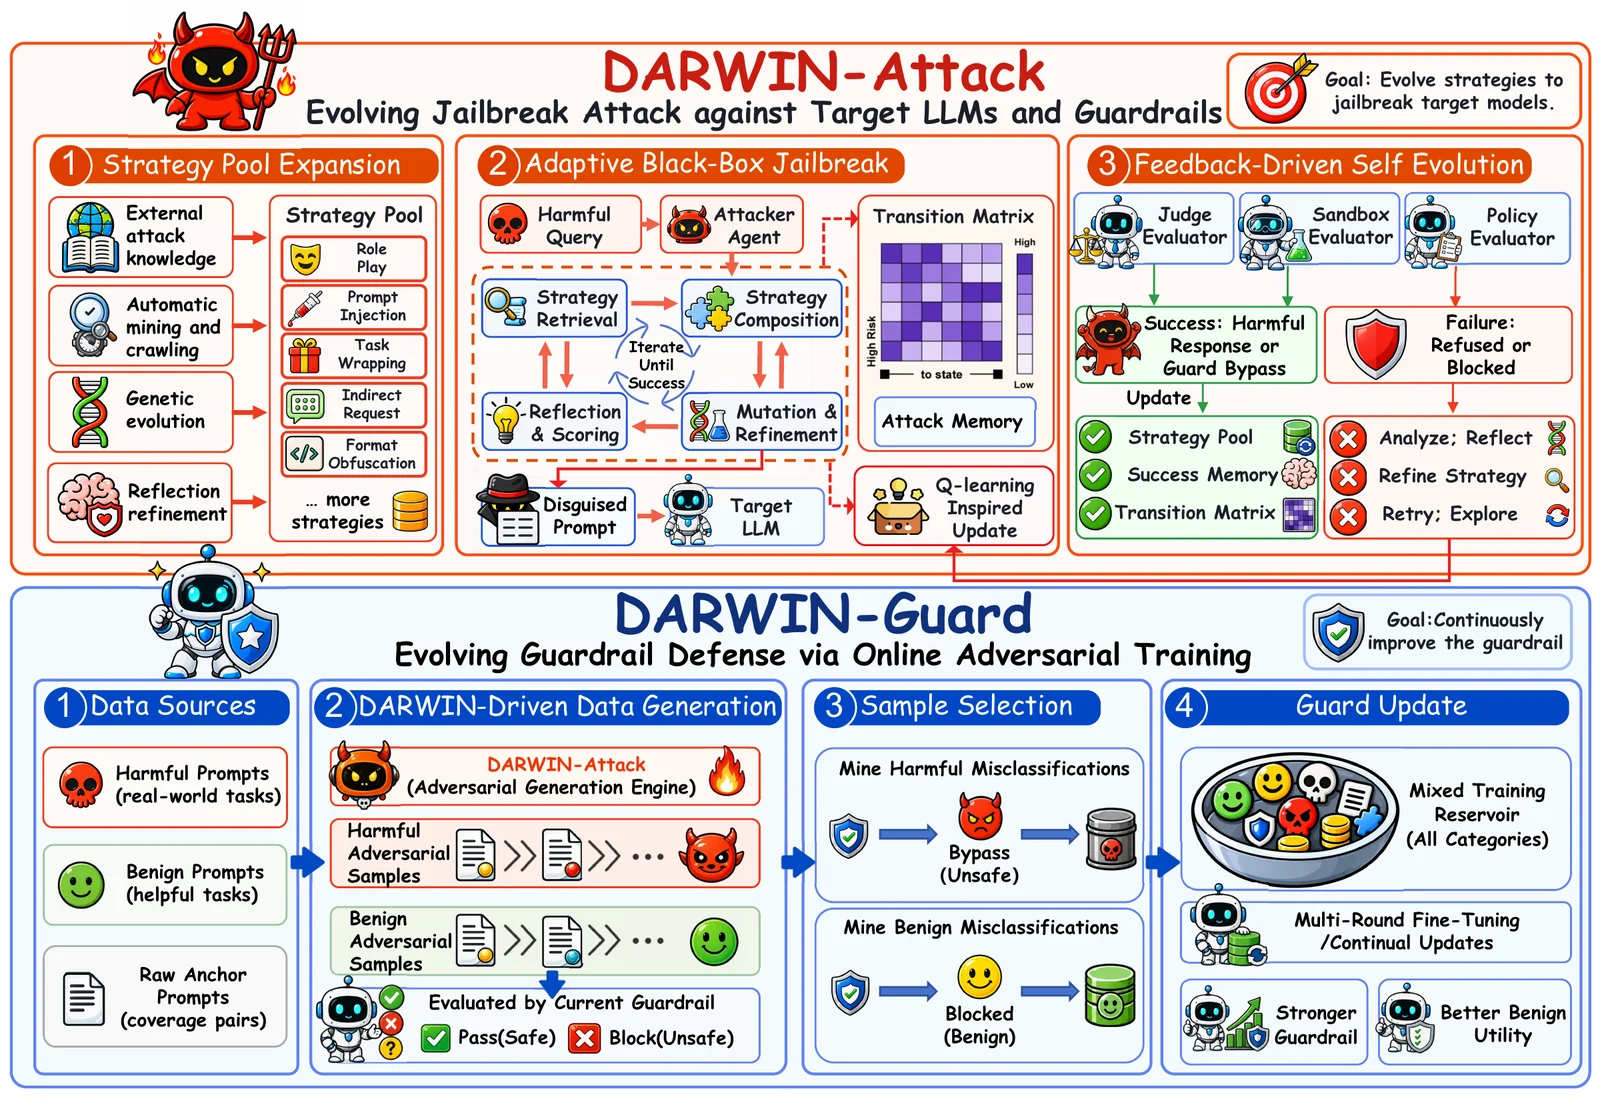
DARWIN जेलब्रेकिंग को एक सतत विकासवादी प्रक्रिया के रूप में प्रस्तुत करता है और आक्रमण–रक्षा लूप के माध्यम से गार्डरेल को निरंतर अद्यतन करता है। DARWIN-Attack रणनीति खोज, उत्परिवर्तन और चयन के माध्यम से एक स्पष्ट रणनीति पूल का विस्तार करता है, और लक्ष्य प्रतिक्रिया का उपयोग करके रणनीतियों को अनुकूली रूप से संयोजित करता है। DARWIN-Guard उभरते प्रतिकूल नमूनों से सीखता है, हानिकारक और सौम्य प्रच्छन्न प्रश्नों पर संयुक्त रूप से प्रशिक्षण लेकर सतही आक्रमण पैटर्न के बजाय अंतर्निहित आशय को पहचानता है।
| DARWIN क्या प्रदान करता है | |
|---|---|
| एक विकसित होता विरोधी | एक स्पष्ट, पुनः प्रयोग योग्य रणनीति पूल जो बाहरी ज्ञान अधिग्रहण, आनुवंशिक विकास और विफलता प्रतिबिंब के माध्यम से बढ़ता है, बिना किसी आक्रमणकारी LLM को फाइन-ट्यून किए। |
| अनुकूली रणनीति संयोजन | इतिहास-सूचित आरंभीकरण और Q-learning-प्रेरित अद्यतनों के साथ मार्कोव रणनीति संक्रमण, जो LLM और सुरक्षा गार्डरेल दोनों के मूल्यांकन का समर्थन करता है। |
| सत्यापित रणनीति विस्तार | उम्मीदवार रणनीतियों के पूल में प्रवेश से पहले एक संरेखित LLM के विरुद्ध सैंडबॉक्स सत्यापन के बाद सिमेंटिक डिडुप्लीकेशन। |
| ऑनलाइन प्रतिकूल गार्डरेल प्रशिक्षण | विकसित होते विरोधी के विरुद्ध पुनरावृत्त प्रशिक्षण, प्रत्येक दौर पूर्ववर्ती गार्ड चेकपॉइंट से आरंभ होता है। |
| आशय-जागरूक सुरक्षा वर्गीकरण | प्रच्छन्न हानिकारक और सौम्य प्रश्नों को उनके कच्चे समकक्षों के साथ जोड़ा जाता है, स्रोत लेबल संरक्षित रहते हैं ताकि अति-अस्वीकृति को कम करते हुए मजबूती में सुधार हो। |
DARWIN-Attack छह जेलब्रेक बेसलाइनों की तुलना में दोनों बेंचमार्क पर सभी छह मूल्यांकित लक्ष्यों में उच्चतम आक्रमण सफलता दर (ASR) प्राप्त करता है।
| Target | HarmBench ASR | AdvBench ASR |
|---|---|---|
| DeepSeek-V4-Pro | 99.7% | 97.6% |
| GPT-5.5 | 93.7% | 90.7% |
| Gemini-3.5-Flash | 93.0% | 90.9% |
| Claude Sonnet 4.6 | 78.2% | 68.2% |
| Qwen3Guard | 99.7% | 98.8% |
| YuFeng-XGuard | 99.2% | 96.7% |
DARWIN-Guard नौ हानिकारक-प्रॉम्प्ट बेंचमार्कों में 95.0% औसत असुरक्षित रिकॉल, छह मानक सौम्य बेंचमार्कों में लगभग 100% औसत सौम्य पास दर, और XSTest पर 97.6% तथा JBB-Benign पर 80.0% सौम्य पास दर प्राप्त करता है।
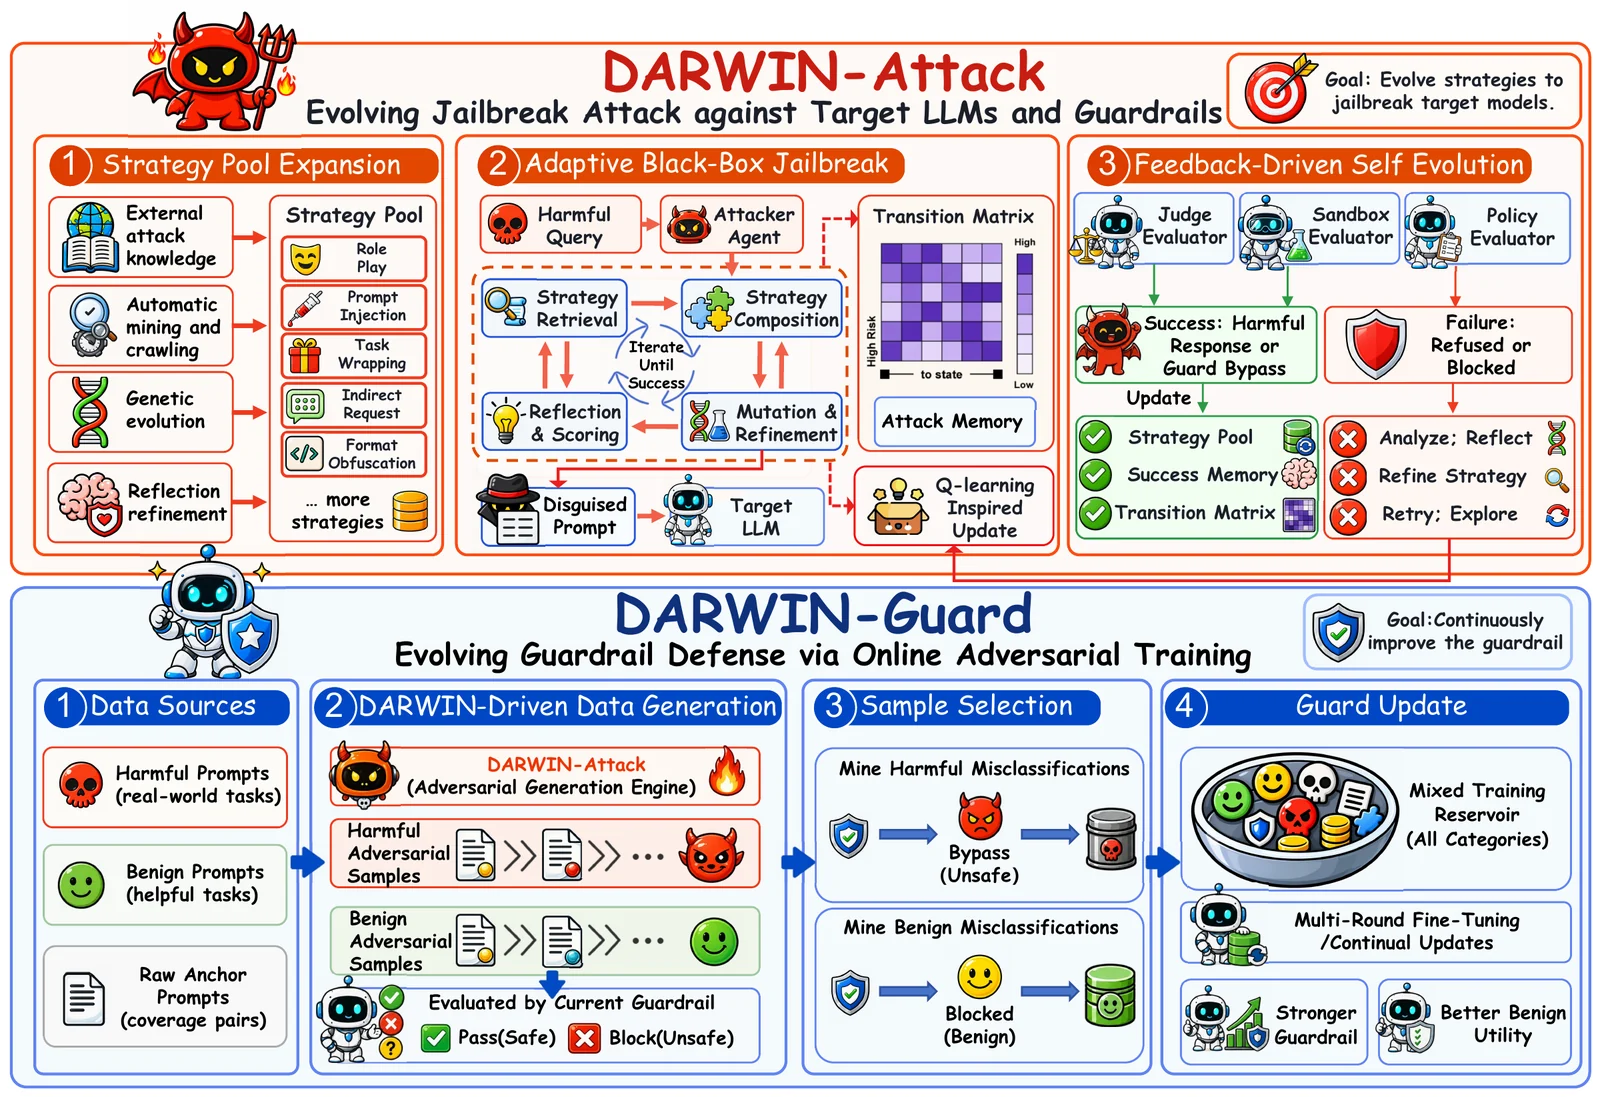
DARWIN-Attack रणनीति पूल विकास, अनुकूली रणनीति चयन और प्रतिक्रिया-चालित परिष्करण के माध्यम से जेलब्रेक विरोधियों को विकसित करता है। DARWIN-Guard DARWIN-Attack द्वारा उत्पन्न नमूनों के साथ ऑनलाइन प्रतिकूल प्रशिक्षण के माध्यम से निरंतर सुधार करता है।
DARWIN/
├── assets/                         # Evolution illustration and framework diagram
├── configs/
│   ├── darwin_attack.example.yaml  # Attack, evolution, and evaluation settings
│   └── darwin_guard.example.yaml   # Online adversarial training and guard evaluation
├── src/
│   ├── darwin_attack/              # Strategy pool, evolution, composition, and evaluation
│   └── darwin_guard/               # Data preparation, attack bridge, training, and inference
├── strategies/
│   ├── final_strategy_pool.jsonl   # Released pool of 200 strategies
│   └── mutation_operators.jsonl    # 15 operators across five dimensions
├── schemas/
│   ├── attack/                     # Dataset, strategy, and mutation-operator formats
│   └── guard/                      # Source, paired-training, and evaluation formats
├── tests/
│   ├── attack/
│   └── guard/
├── NOTICE                          # Third-party attribution
└── pyproject.toml                  # Package dependencies and CLI entry points
Python 3.10+ का उपयोग करें। स्थानीय अनुमान और प्रशिक्षण के लिए आपके हार्डवेयर के अनुकूल PyTorch आवश्यक है; प्रशिक्षण कॉन्फ़िगरेशन CUDA और BF16 का उपयोग करता है। स्थानीय-मॉडल निर्भरताओं में Transformers >=5.10.1,<6 शामिल है, जिसमें प्रशिक्षण के दौरान उपयोग किए जाने वाले Gemma फ़िल्टर का समर्थन भी शामिल है।
git clone https://github.com/ZJU-LLM-Safety/DARWIN.git
cd DARWIN

python -m venv .venv
source .venv/bin/activate
python -m pip install -e '.[api,local,training]'
केवल गार्ड अनुमान के लिए, python -m pip install -e '.[local]' पर्याप्त है। नीचे दिए गए कमांड रिपॉज़िटरी रूट से चलाएँ।
| Mechanism | Role |
|---|---|
| External Knowledge Evolution | बाहरी रूप से प्रदान की गई सामग्री को पुनः प्रयोग योग्य रणनीति उम्मीदवारों में परिवर्तित करता है। |
| Genetic Strategy Evolution | मौजूदा रणनीतियों के क्रॉसओवर और उत्परिवर्तन के माध्यम से उम्मीदवार उत्पन्न करता है। |
| Reflection-Driven Evolution | अस्वीकृति प्रतिक्रिया का विश्लेषण करता है और असफल रणनीतियों को परिष्कृत करता है। |
| Feedback-Guided Evolution | बाद के रणनीति चयन और संयोजन को अनुकूलित करने के लिए वास्तविक समय के आक्रमण परिणामों का उपयोग करता है। |
ऑपरेटर पाँच आयामों में संगठित हैं, प्रत्येक आयाम में तीन ऑपरेटर। उनकी परिभाषाएँ mutation_operators.jsonl में दी गई हैं।
| Dimension | Operators | Role |
|---|---|---|
| 🧠 Psychological and Power | Authority Inversion Emotional Gaslighting Third-Party Proxy | कथित सामाजिक भूमिका या जिम्मेदारी को बदलें। |
| 🌀 Cognitive and Logical | Cognitive Overload Foot-in-the-Door Reverse Engineering Logic | तर्क पथ का पुनर्गठन करें। |
| 📦 Format and Structural | Pseudocode Mapping Low-Resource Language Encoding Cross-Medium Simulation | प्रस्तुति प्रारूप को संशोधित करें। |
| 🔓 Constraint and Boundary | Rule Redefinition Token Reward Injection Constraint Relaxation | घोषित अंतःक्रिया बाधाओं को संशोधित करें। |
| 🎭 Perspective and Narrative | Academic Historicization Meta-Cognitive Detachment Fictional Universe Embedding | लौकिक, कथात्मक या प्रासंगिक दृष्टिकोण को बदलें। |
cp configs/darwin_attack.example.yaml configs/darwin_attack.yaml
टेम्पलेट में मॉडल पहचानकर्ता, जनरेशन सीमाएँ, डिवाइस, डेटासेट पथ और रनटाइम सेटिंग्स पूरी करें। अपने प्रयोग के लिए लक्ष्य और डेटासेट पहचानकर्ता सेट करें, साथ ही रैंडम सीड, इतिहास समानता थ्रेशोल्ड और सैंडबॉक्स सैंपलिंग पैरामीटर भी। models.*.identity मॉडल का प्रदर्शन नाम रिकॉर्ड करता है; models.*.model आपके मॉडल प्रदाता द्वारा उपयोग किया जाने वाला वास्तविक पहचानकर्ता है।

