
 zju-llm-safety/ascent
फाइन-ट्यूनिंग फ्रेमवर्क जो LLMs पर प्रथम-क्रम इष्टतम सुरक्षा अंशांकन और आवधिक पुनर्अंशांकन लागू करता है, जो सुरक्षा-संगत अपडेट को संरक्षित करते हुए डाउनस्ट्रीम कार्य उपयोगिता में सुधार करता है।

सुरक्षा–उपयोगिता सह-वृद्धि के लिए पुनः-अंशांकन के साथ प्रथम-कोटि इष्टतम फाइन-ट्यूनिंग
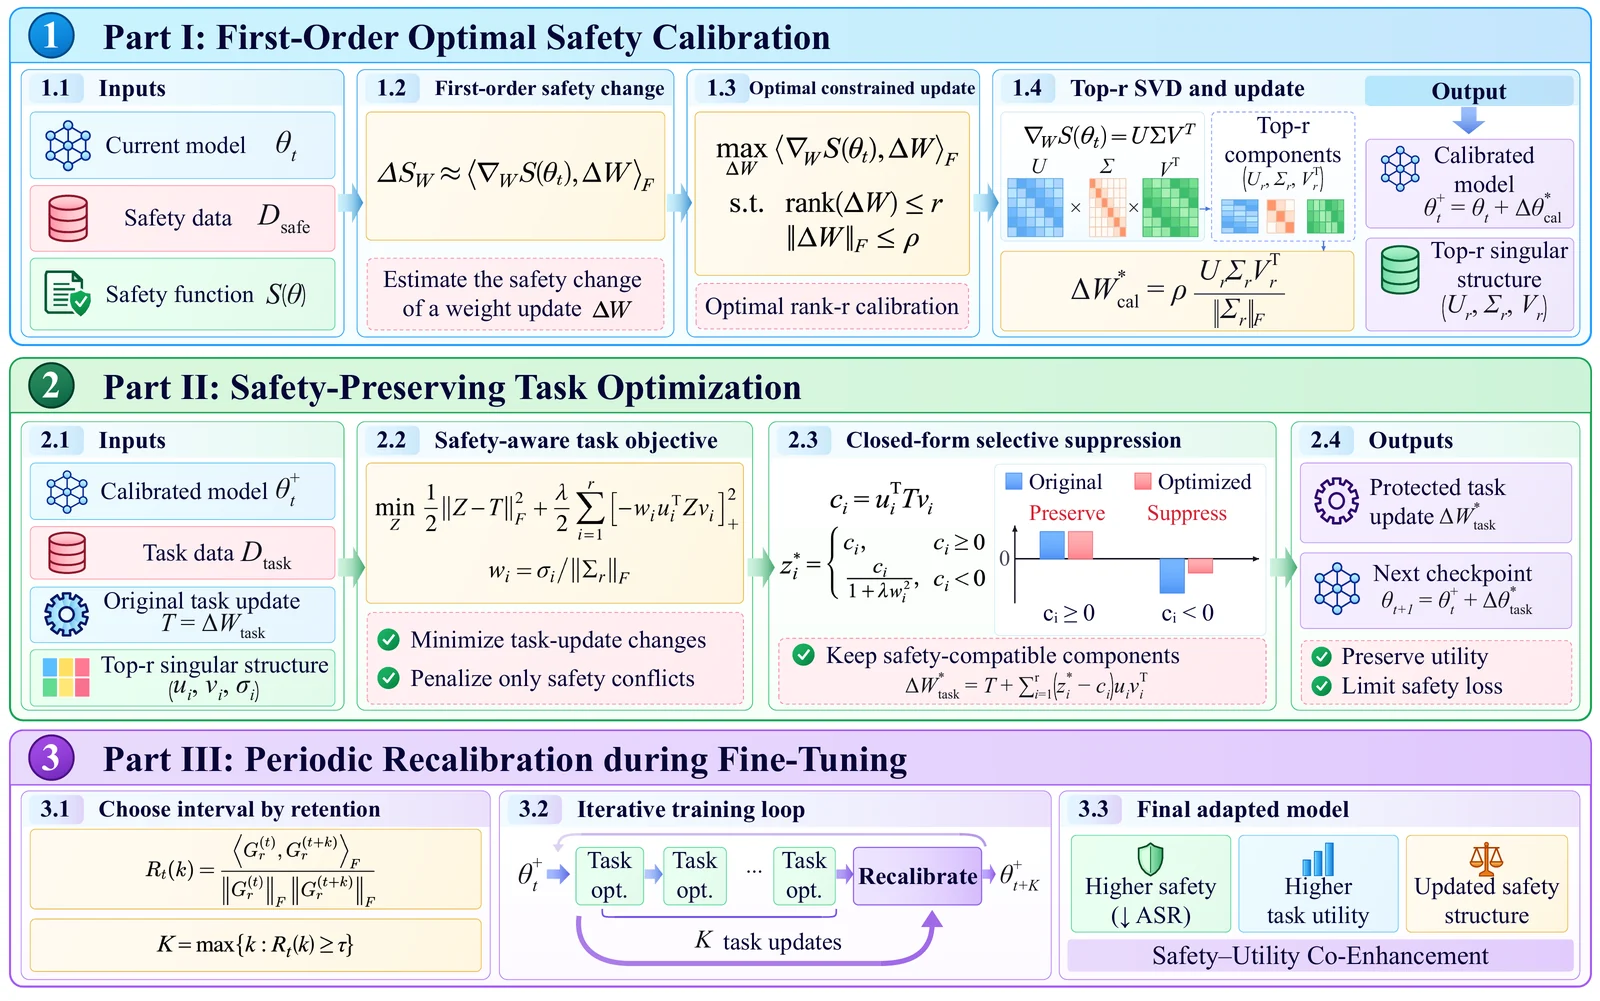
ASCENT एक प्रथम-कोटि इष्टतम सुरक्षा अंशांकन अद्यतन और संबंधित सुरक्षा-संबंधित संरचना प्राप्त करता है, सुरक्षा-संगत घटकों को संरक्षित करते हुए सुरक्षा-क्षयकारी घटकों को दबाते हुए डाउनस्ट्रीम कार्य अद्यतनों को अनुकूलित करता है, और सुरक्षा तथा डाउनस्ट्रीम उपयोगिता दोनों को संयुक्त रूप से बेहतर बनाने के लिए फाइन-ट्यूनिंग के दौरान इस संरचना को समय-समय पर पुनः-अंशांकित करता है।
विधि · त्वरित प्रारंभ · डेटा · कॉन्फ़िगरेशन · मूल्यांकन
config.toml में निर्धारित की जाती है।आवश्यकताएँ: Python 3.12 और स्थानीय मॉडल चेकपॉइंट। प्रशिक्षण दो CUDA GPU का उपयोग करता है, एक लक्ष्य मॉडल के लिए और एक Llama Guard के लिए; प्रत्येक मॉडल को उसके GPU पर फिट होना चाहिए।
pip install -r requirements.txt
cp config.example.toml config.toml
config.toml में खाली मानों को उसकी इनलाइन टिप्पणियों का पालन करते हुए भरें, फिर चलाएँ:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
प्रशिक्षण, प्रतिक्रियाएँ उत्पन्न करने, या मूल्यांकन परिणाम सहेजने के लिए
--executeजोड़ें।
चेकपॉइंट के लिए जगह वाली रिपॉज़िटरी के बाहर एक नई आउटपुट निर्देशिका चुनें। प्रशिक्षण समाप्त होने पर अंतिम मर्ज किए गए मॉडल का पथ प्रिंट करता है।
कॉन्फ़िगर किए गए रिकॉर्ड गणना के साथ JSON सरणियाँ प्रदान करें:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json, असंयुक्त train/test इनपुट के साथ।| डेटासेट | आवश्यक फ़ील्ड |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, या Sci/Tech |
| GSM8K | question, answer जिसमें #### अंतिम उत्तर हो |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], चार choice_texts, answer_key: A–D |
| HarmBench | केवल goal; वैकल्पिक id, source; कोई संग्रहीत प्रतिक्रियाएँ नहीं |
config.toml में अपना मॉडल, कार्य, और हाइपरपैरामीटर सेट करें। मॉडल लोडिंग
और मैट्रिक्स चयन model.key का पालन करते हैं।
दोनों मोड के लिए evaluate.py का उपयोग करें; जनरेशन के लिए पूरी तरह मर्ज किया गया स्थानीय मॉडल आवश्यक है।
अपना स्वयं का डेटा और बाहरी सुरक्षा स्कोर प्रदान करें। कोई डेटासेट, ऑनलाइन जज, या
API कॉन्फ़िगरेशन बंडल नहीं किया गया है।
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
कार्य: samsum, agnews, gsm8k, openbookqa। मेट्रिक्स SAMSum के लिए ROUGE-L
और अन्य के लिए सटीकता/सटीक मिलान हैं, जिन्हें प्रतिशत के रूप में रिपोर्ट किया जाता है। सहेजी गई
प्रतिक्रियाओं को स्कोर करने के लिए, --model-path को --responses /path/to/responses.json से बदलें।
id, goal, और वैकल्पिक prompt (डिफ़ॉल्ट रूप से
goal) वाले रिकॉर्ड के रूप में निश्चित प्रॉम्प्ट प्रदान करें। मूल हानिकारक लक्ष्य को हमले के प्रॉम्प्ट से अलग रखें।
प्रतिक्रियाएँ उत्पन्न करें:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
बाहरी स्कोर एकत्र करें:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
स्कोर JSON रिकॉर्ड { "id": "...", "score": 1 } हैं, जो प्रतिक्रिया ID और
स्कोर 1–5 का उपयोग करते हैं (विफल निर्णयों के लिए null)। स्कोर 4–5 सफल हमलों के रूप में गिने जाते हैं;
केवल 5 गिनने के लिए --success-threshold 5 का उपयोग करें। अनुपस्थित या विफल निर्णय अंतिम ASR नहीं देते।
किसी भी मोड के लिए, चैट फ़ॉर्मेटिंग के बाद --max-input-tokens से अधिक इनपुट
अस्वीकार किए जाते हैं, छोटे नहीं किए जाते। सीमा को मॉडल की संदर्भ क्षमता के भीतर सेट करें,
जिससे उत्पन्न टोकन के लिए जगह बची रहे।






