 xuyw-seu/packetpatch
न्यूनतम ओवरहेड और पूर्ण पैकेट पुनर्प्राप्ति के साथ एन्क्रिप्टेड ट्रैफिक वर्गीकरण के विरुद्ध व्यावहारिक ब्लैक-बॉक्स एडवर्सेरियल पैकेट जनरेशन।

पेपर: PacketPatch: बाइट-फीचर-आधारित एन्क्रिप्टेड ट्रैफिक वर्गीकरण के लिए एडवरसैरियल पैकेट्स की व्यावहारिक पीढ़ी और तैनाती लेखक: Yuwei Xu, Yuanyuan Xu, Yunpeng Bai, Jiahui Chen, Kehui Song, Jie Cao, Qiao Xiang, Guang Cheng संबद्धता: Southeast University, Purple Mountain Laboratories, Tiangong University, Queen's University, Xiamen University स्थिति: स्वीकृत/समीक्षाधीन (Elsevier)
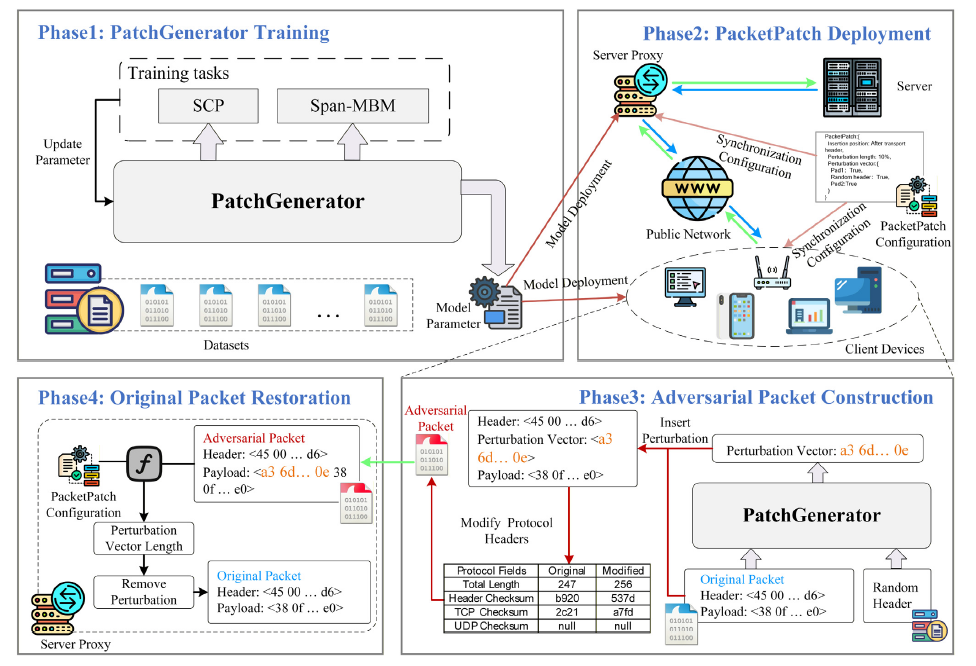
PacketPatch बाइट-फीचर-आधारित एन्क्रिप्टेड ट्रैफिक वर्गीकरण (B-ETC) मॉडलों के विरुद्ध एडवरसैरियल नेटवर्क पैकेट उत्पन्न करने के लिए एक व्यावहारिक योजना है, जिसका उद्देश्य उपयोगकर्ता की गोपनीयता की रक्षा करना है। मौजूदा तरीकों के विपरीत जो अवास्तविक व्हाइट-बॉक्स धारणाओं पर निर्भर करते हैं या अत्यधिक ओवरहेड पेश करते हैं, PacketPatch सख्त ब्लैक-बॉक्स स्थितियों के तहत काम करता है, साथ ही रीयल-टाइम प्रदर्शन और पैकेट उपयोगिता बनाए रखता है।
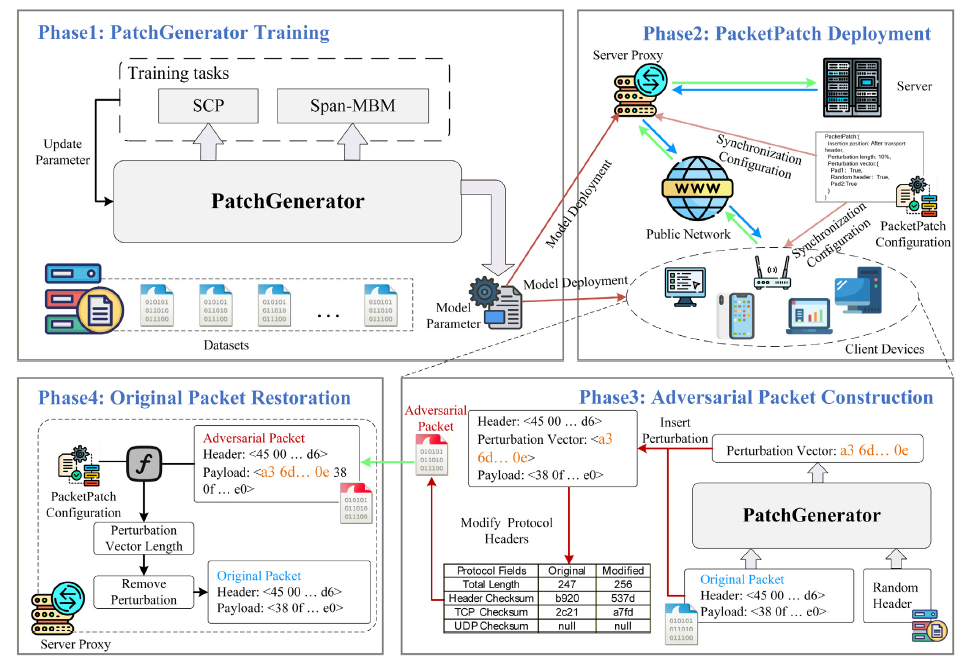
Pad1 → arg min (मूल सुविधाओं को अधिकतम बाधित करता है)Pad2 → arg max (यादृच्छिक हेडर के साथ संरेखित सुविधाएँ उत्पन्न करता है)PacketPatch/
├── README.md # Project overview (this file)
├── LICENSE # MIT License
├── requirements.txt # Python dependencies
├── bert_base_config.json # BERT model configuration (12 layers, 768-dim, 12 heads)
│
├── packet_adv/ # ★ Core experimental code
│ ├── README.md # Usage guide for core modules
│ ├── adv_fine_tuning_cls.py # Step 1: Train PatchGenerator (SpanBERT)
│ ├── generate.py # Step 2: Generate adversarial packets
│ └── gen_onnx.py # Step 3 (optional): ONNX/TensorRT acceleration
│
├── uer/ # UER (Universal Encoder Representations) framework
│ ├── README.md # Framework documentation
│ ├── encoders/ # Encoder implementations (Transformer, RNN, CNN)
│ ├── layers/ # Network layers (Embedding, Attention, FFN)
│ ├── targets/ # Training targets (MLM, NSP, Span-MBM, etc.)
│ ├── models/ # Model definition
│ ├── utils/ # Utilities (tokenizers, optimizers, data loading)
│ ├── model_builder.py # Model construction
│ ├── model_loader.py # Pretrained weight loading
│ ├── model_saver.py # Model checkpoint saving
│ ├── trainer.py # Training loop implementation
│ └── opts.py # CLI argument definitions
│
├── dataset/ # Dataset documentation
│ └── README.md # Dataset descriptions, download links, preprocessing
│
├── image/ # Architecture and result figures
│ └── README.md # Figure descriptions
│
└── tools/ # Utility tools
└── README.md # Tool descriptions and usage
# Clone this repository
git clone https://github.com/your-org/PacketPatch.git
cd PacketPatch

# Install dependencies
pip install -r requirements.txt
आवश्यकताएँ:
PacketPatch, ET-BERT पर आधारित है। ET-BERT रिपॉजिटरी से निम्नलिखित डाउनलोड करें:
pretrained_model.bin — ET-BERT प्रीट्रेंड वेट्सencryptd_vocab.txt — बाइट-पेयर एन्कोडिंग के लिए शब्दावली फ़ाइलडेटासेट: हम तीन सार्वजनिक डेटासेट पर मूल्यांकन करते हैं। डाउनलोड लिंक और प्रीप्रोसेसिंग निर्देशों के लिए dataset/README.md देखें।
| डेटासेट | कक्षाएं | परिदृश्य |
|---|---|---|
| ISCX-TOR | 16 | Tor अनाम ट्रैफिक |
| ISCX-VPN | 11 | VPN एन्क्रिप्टेड टनल |
| USTC | 20 | मैलवेयर + हानिरहित ट्रैफिक |
cd packet_adv

# Edit adv_fine_tuning_cls.py first:
#   - Update dataset paths (lines 47-50)
#   - Update pretrained model path (lines 73-75)
#   - Set correct num_classes (line 56)
#   - Set correct training set size (line 878)

python adv_fine_tuning_cls.py
प्रशिक्षित चेकपॉइंट निर्दिष्ट लॉग निर्देशिका में सहेजा जाएगा (जैसे, span_2seg_cls_log/)।
cd packet_adv

# Edit generate.py first:
#   - Update test data paths (lines 42-44)
#   - Update --load_model_path to your trained checkpoint (line 68-69)
#   - Set BWO (bandwidth overhead ratio, line 60, default 0.1)
#   - Choose generation strategy via 'fun' parameter (line 50)

python generate.py
cd packet_adv

# Edit gen_onnx.py first:
#   - Update model checkpoint path (line 132)
#   - Update output paths (lines 145, 207)
#   - Select precision mode: 'fp16' or 'int8' (line 21)

python gen_onnx.py
| पैरामीटर | फ़ाइल | पंक्ति | विवरण | डिफ़ॉल्ट |
|---|---|---|---|---|
BWO | generate.py | 60 | बैंडविड्थ ओवरहेड अनुपात | 0.1 (10%) |
fun | generate.py | 50 | जनरेशन रणनीति | 'fun5' |
n_epochs | adv_fine_tuning_cls.py | 53 | प्रशिक्षण इपॉक्स | 50 |
batch_size | adv_fine_tuning_cls.py | 54 | बैच आकार | 32 |
num_classes | adv_fine_tuning_cls.py | 56 | ट्रैफिक कक्षाओं की संख्या | डेटासेट पर निर्भर |
learning_rate | adv_fine_tuning_cls.py | 94-95 | सीखने की दर | 2e-5 |
seq_length | adv_fine_tuning_cls.py | 92-93 | इनपुट अनुक्रम लंबाई | 256 |
fun पैरामीटर)