 xoreaxeaxeax/skitter-creek-bath-salts
CPU पर DRAM स्क्रैम्बलिंग के साथ _सब कुछ_ अनलॉक करना

DRAM स्क्रैम्बलिंग के साथ CPU पर सब कुछ अनलॉक करना — PSP, C6, माइक्रोकोड, SMM, और वह सब कुछ जो स्पेक्स में छूट गया।
&x == &x.
आमतौर पर।
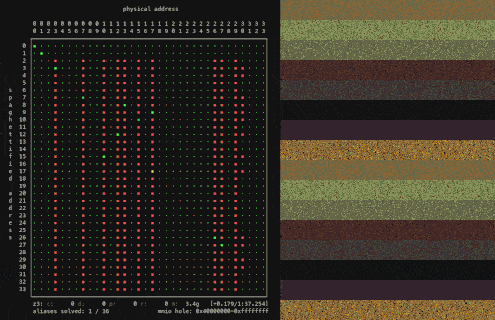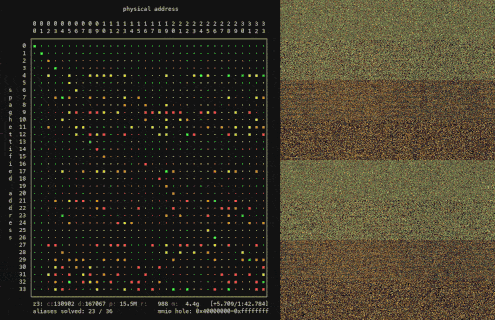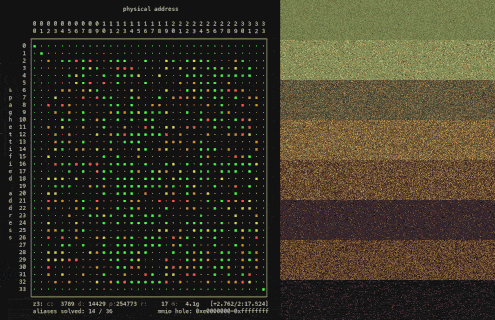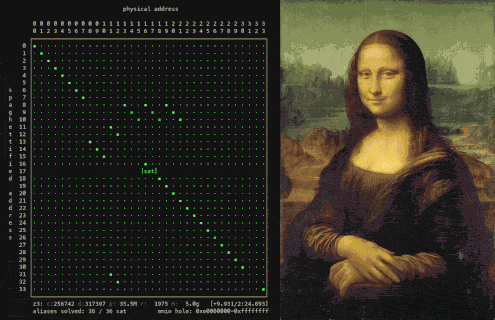
DRAM कंट्रोलर को पोक करें और एक एड्रेस को मेमोरी में कहीं भी लैंड कराया जा सकता है।
skitter-creek-bath-salts मेमोरी पदानुक्रम की निचली परतों को संशोधित करके
भौतिक DRAM एड्रेस अनुवादों को रीवायर करता है। यह प्लेटफ़ॉर्म मेमोरी को स्क्रैम्बल
करता है, DRAM के संरक्षित क्षेत्रों को उजागर करता है — ऐसे कार्वआउट जो कर्नेल को भी
अदृश्य हैं। जब एड्रेस अनुवाद टूटते हैं, तो उन पर बने सुरक्षा प्रिमिटिव भी टूटते हैं,
और हम सब कुछ अनलॉक कर देते हैं।
AMD Family 16h CPUs पर विकसित और परीक्षित, यह अंतिम पीढ़ी है जिसके
डेटाशीट DRAM कंट्रोलर के अनुवाद रजिस्टरों का दस्तावेज़ीकरण करते हैं — और दिखाते हैं
कि उन्हें लॉक नहीं किया जा सकता। 17h और उसके बाद की पीढ़ियाँ बस इस जानकारी को
छोड़ देती हैं। *p की ओडिसी पीढ़ियों और
आर्किटेक्चरों में समान है, और अंतर्निहित ट्रांसफ़ॉर्म ARM, RISC-V, और
उससे आगे तक भी फैले हुए हैं; skitter-creek-bath-salts हमें केवल शुरुआत करना दिखाता है।
*p की ओडिसीनीचे उतरने का रास्ता लंबा है।
मेमोरी अमूर्तता की इतनी गहरी परतों पर बनी है कि वे लगभग बेतुकी लगने लगती हैं। जब
आपका कोड *p को डीरेफ़रेंस करता है, तो ऐसा प्रतीत होता है कि यह p पर DRAM
एक्सेस कर रहा है। ऐसा नहीं है —
p एक वर्चुअल एड्रेस है, और DRAM का एक भी बिट छूने से पहले, उसे नीचे दी गई
परीक्षा से गुज़रना होता है:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
यह प्रोजेक्ट `*p` पाइपलाइन के सबसे गहरे स्तरों पर काम करता है, MCT/DCT परत पर
— जहाँ डेटा फैब्रिक/इंटरकनेक्ट से एक भौतिक पता मेमोरी
कंट्रोलर में प्रवेश करता है और अंतिम बार उन कच्चे DRAM निर्देशांकों में
पुनर्लिखित किया जाता है जो DIMM को जारी किए जाते हैं।

---

## DRAM को स्पैगेटीफाई करना

> भौतिक पते वास्तव में एक सुझाव से अधिक कुछ नहीं हैं।```nasm
xor dword [0xf80c2094], 0x00400000
यही है एक्सप्लॉइट। पूरा का पूरा।
