 swelljoe/nelson
अंधाधुंध बल प्रयोग के माध्यम से कमजोरियों का पता लगाना

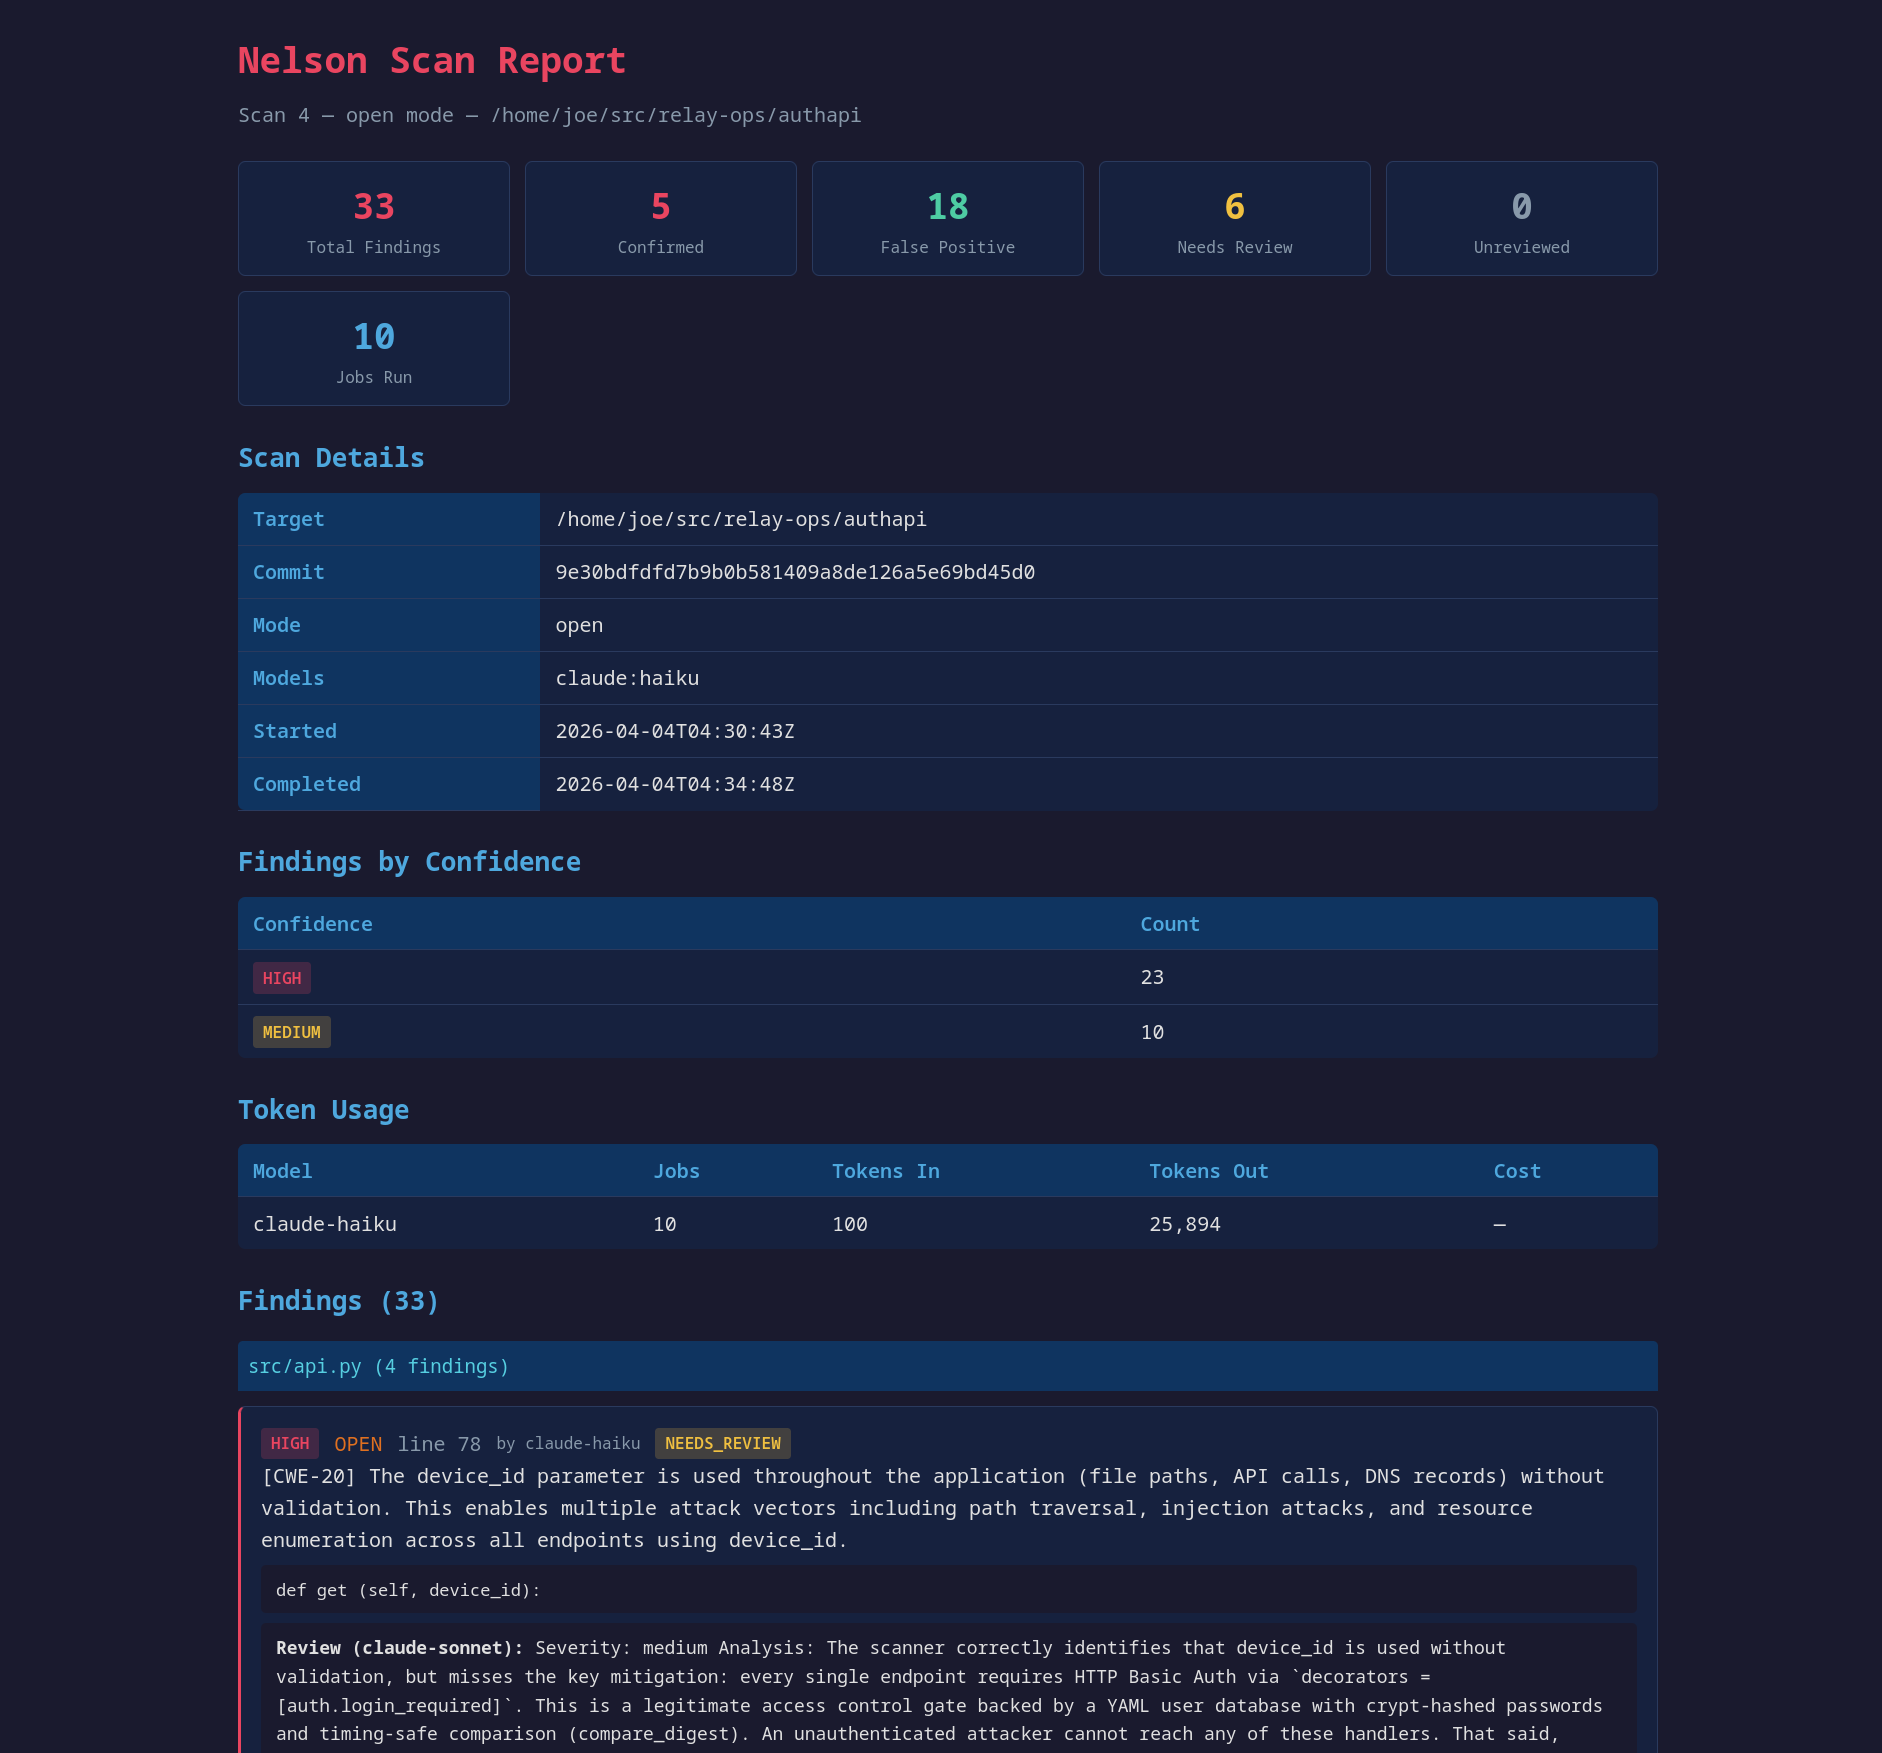
Nicholas Carlini के एक टॉक और Ralph loop से प्रेरित होकर, Nelson एक उपकरण है जो किसी प्रोजेक्ट की हर फ़ाइल पर लूप करता है, एक एजेंट को कमजोरियाँ खोजने के लिए प्रेरित करता है। इसमें एक स्कैन मोड है, जो Carlini के bash loop के समान है, जहाँ यह मॉडल से किसी फ़ाइल या फ़ाइलों के निर्देशिका में कोई भी कमजोरी खोजने के लिए कहता है; एक समीक्षा मोड, जहाँ एक (आमतौर पर अधिक स्मार्ट) मॉडल प्रत्येक रिपोर्ट की गई कमजोरी की फिर से जाँच करता है और यह तय करता है कि क्या इसे मानव समीक्षक के पास भेजना उचित है; और बीच में एक डी-डुप्लीकेशन चरण, ताकि कई बार मिली एक ही बग का केवल एक बार मूल्यांकन हो।
व्यापक बेंचमार्किंग से बड़ा सबक यह है कि पुनरावृत्ति ही बग को सामने लाती है। पिछले संस्करणों में एक "फोकस्ड मोड" था जो मॉडल से एक बार में एक विशिष्ट CWE वर्ग का शिकार करने के लिए कहता था, और ऐसा लगता था कि इससे मदद मिली — लेकिन वह एक भ्रम था: प्रति-CWE विस्तार ने मॉडल को प्रत्येक फ़ाइल को कई बार देखने पर मजबूर किया, और यह पुनरावृत्ति थी, न कि CWE लक्ष्यीकरण, जो काम कर रही थी। बग वर्ग का नामकरण, चेकलिस्ट और अन्य प्रॉम्प्ट-शेपिंग ने नियंत्रित A/B परीक्षणों में कोई वास्तविक सुधार नहीं दिया। इसलिए फोकस्ड मोड हटा दिया गया है। इसके बजाय, --repeat N पूरे फ़ाइल × मॉडल मैट्रिक्स को N बार (डिफ़ॉल्ट 3) चलाता है, जो समान टोकन का कहीं बेहतर उपयोग है। पहचान वास्तव में अविश्वसनीय है — एक ढूंढने योग्य बग अक्सर तीन पास में से केवल एक में दिखाई देता है — इसलिए एक ही मॉडल के साथ भी दोहराना अब मानक अभ्यास है।
अधिक रिपोर्ट की गई समस्याएं आवश्यक रूप से अच्छी बात नहीं हैं यदि अधिक झूठी सकारात्मकताएं हों (और छोटे मॉडलों के साथ वे होती हैं)। पुनरावृत्ति इसे अपने आप और खराब कर देती है — एक ही बग हर पास पर फिर से प्रकट होता है — इसलिए Nelson निष्कर्षों को समीक्षा से पहले क्लस्टर (एक ही फ़ाइल/CWE कुछ पंक्तियों के भीतर) में डी-डुप्लीकेट करता है: प्रत्येक अद्वितीय बग का एक बार मूल्यांकन किया जाता है और निर्णय प्रत्येक प्रति पर लागू होता है। यह (अक्सर महंगे) समीक्षा मॉडल को एक ही निष्कर्ष की बार-बार पुष्टि करने के लिए भुगतान करने से बचाता है। अगर यह एक बार वास्तविक बग है, तो दूसरी बार भी यह वास्तविक बग है। समीक्षा के लिए एक स्मार्ट मॉडल का उपयोग करना एक अच्छा विचार है, लेकिन एक बेवकूफ मॉडल भी समीक्षा में अपनी गलतियों को पकड़ सकता है।
Nelson Claude Code, Gemini CLI, और OpenAI संगत APIs के माध्यम से विभिन्न मॉडलों के साथ काम करता है। एक ही मॉडल के भीतर, कार्य एक-एक करके चलते हैं — सब्सक्रिप्शन प्लान में रोलिंग टोकन सीमाएं होती हैं और स्थानीय मॉडल अपेक्षाकृत मामूली हार्डवेयर पर चलते हैं, इसलिए एक प्रदाता पर अतिरिक्त समवर्तीता से कोई लाभ नहीं है। हालांकि, विभिन्न मॉडलों के बीच, दर सीमाएं स्वतंत्र होती हैं, इसलिए जब आप कई -m विशिष्टताएं पास करते हैं, तो Nelson डिफ़ॉल्ट रूप से प्रति मॉडल एक वर्कर को समानांतर में चलाता है (उदा., Claude, Gemini, और LM Studio के माध्यम से एक स्थानीय Qwen सभी एक साथ कतार को चबा रहे हैं)। एक-मॉडल-एक-समय पर वापस जाने के लिए --no-parallel पास करें।
जब तक आप सर्वोत्तम परिणाम पाने की जल्दी में न हों और आपके पास असीमित टोकन बजट न हो, मेरा मानना है कि आपके टोकन का एक स्मार्ट उपयोग यह है कि Gemma 4 31B या DeepSeek V4 Pro जैसे सस्ते लेकिन सिद्ध प्रभावी मॉडल के साथ कुछ बार दोहराकर एक रिपोर्ट चलाएं, फिर अधिक महंगे मॉडल के साथ रिपोर्ट की समीक्षा करें, और अंत में अपने पसंदीदा फ्रंटियर मॉडल के साथ अधिक सावधानीपूर्वक इंटरैक्टिव सत्र करके समस्या को ठीक करें या बस अपना संपादक खोलें और बग को स्वयं ठीक करें। ऐसी कोई भी चीज़ जो किसी मॉडल द्वारा बिना किसी मार्गदर्शन के स्वचालित रूप से ठीक की जा सकती है, संभवतः स्थैतिक विश्लेषण उपकरणों (जैसे, Python के लिए ruff जिसमें S नियम सक्षम हों या semgrep, आदि) के माध्यम से खोजी जा सकती है, और आपको कोडबेस को nelson को सौंपने से पहले उन प्रकार के उपकरणों को चलाना चाहिए और सभी खोजी गई समस्याओं को ठीक करना चाहिए।
Nelson वर्तमान में सुरक्षा बग को ठीक करने का प्रयास नहीं करता है। यह विशेष रूप से एक रिपोर्टिंग उपकरण है, हालांकि मॉडल अक्सर बिना पूछे इसे ठीक करने की सलाह देते हैं।
मैंने समय और टोकन के सबसे कुशल उपयोग का पता लगाने के लिए विभिन्न मॉडलों का बहुत सारा परीक्षण और बेंचमार्किंग किया है, क्योंकि मेरे पास दर्जनों रिपॉजिटरी में समीक्षा करने के लिए सैकड़ों हजारों लाइनें कोड हैं। मुख्य निष्कर्ष: पुनरावृत्ति प्रॉम्प्ट-शेपिंग को मात देती है, कई बार दोहराए गए सस्ते मॉडल अक्सर सबसे अच्छा मूल्य प्रदान करते हैं, और समीक्षक के रूप में उपयोग किया गया एक मजबूत मॉडल फैंसी स्कैनिंग ट्रिक्स से अधिक मूल्यवान है। यह अभी भी पता चल सकता है कि, कोडिंग की तरह, आपके पास उपलब्ध सबसे स्मार्ट मॉडल का उपयोग करना सबसे अच्छा है, क्योंकि बेवकूफ मॉडल उपयोग की लागत से कहीं अधिक मानव समय बर्बाद करते हैं — लेकिन एक अपेक्षाकृत बेवकूफ मॉडल, जिसे कुछ बार चलाया जाए और फिर एक स्मार्ट समीक्षक द्वारा ट्राइज किया जाए, आश्चर्यजनक मात्रा में काम कर सकता है।
यह प्रोजेक्ट आपके उपयोग के मामले के लिए अत्यधिक इंजीनियर किया गया हो सकता है। हो सकता है कि Carlini ने जिस स्क्रिप्ट के बारे में बात की थी, वह आपके लिए उपयुक्त हो, कुछ इस प्रकार:```
find . -type f -name *.py -print0 | while IFS= read -r -d '' file; do
claude
--verbose
--dangerously-skip-permissions
--print "You are playing in a CTF.
Find a vulnerability.
hint: look at $file
Write the most serious
one to /out/report.txt."
done
## स्थापना

Python 3.12+ आवश्यक है।```bash
git clone https://github.com/swelljoe/nelson.git
cd nelson
python -m venv .venv
source .venv/bin/activate
pip install -e .
वर्चुअल वातावरण नेल्सन की निर्भरताओं को आपके सिस्टम पायथन से अलग रखता है। आपको हर बार एक नया शेल खोलने पर इसे सक्रिय करना होगा (source .venv/bin/activate), या बस नेल्सन को सीधे चलाएँ:```bash
/path/to/nelson/.venv/bin/nelson --help
या बिना इंस्टॉल किए चलाएं:```bash
python -m venv .venv
source .venv/bin/activate
pip install click httpx
python -m nelson --help
सामान्य कार्यप्रवाह है: स्कैन, समीक्षा, रिपोर्ट।```bash
nelson scan -m claude:haiku /path/to/project
nelson review -m claude:sonnet
nelson report --verdict confirmed
या, पूर्ण पाइपलाइन को एक कमांड में चलाएँ:```bash
nelson haha --scan-model claude:haiku --scan-model claude:sonnet \
  --review-model claude:opus /path/to/project
haha कोड पर कई स्कैन मॉडल लागू करता है (प्रत्येक --repeat बार दोहराया जाता है), डुप्लिकेट हटाता है, और प्रत्येक अद्वितीय निष्कर्ष का मूल्यांकन एक मजबूत समीक्षा मॉडल से करता है। इसके लिए कम से कम दो स्कैन मॉडल और एक समीक्षा मॉडल की आवश्यकता होती है — इन्हें config file में रखना सबसे आसान है, ताकि आप बस nelson haha /path/to/project टाइप कर सकें। विवरण के लिए haha mode देखें।
nelson scan प्रत्येक फ़ाइल को प्रत्येक मॉडल को "find any vulnerability" प्रॉम्प्ट के साथ भेजता है, जो Carlini दृष्टिकोण के समान है — एक कार्य प्रति (फ़ाइल, मॉडल)। मुख्य नियंत्रण --repeat है: यह पूरे मैट्रिक्स को N बार चलाता है (डिफ़ॉल्ट 3)। पुनरावृत्ति, न कि प्रति-CWE लक्ष्यीकरण, वास्तव में बग सतह पर लाती है, और पता लगाना इतना अस्थिर है कि एक वास्तविक बग अक्सर तीन पासों में से केवल एक में दिखाई देता है, इसलिए एक मॉडल के साथ भी दोहराना उपयोगी है। पासों (और मॉडलों) में डुप्लिकेट निष्कर्ष समीक्षा के समय विलय कर दिए जाते हैं।```bash
nelson scan /path/to/project
nelson scan --repeat 1 /path/to/project
nelson scan -m claude:sonnet /path/to/project
