sumleo/rlcdalignbench
AI अलाइनमेंट विफलताओं का पता लगाने के लिए बेंचमार्क सूट और कोड, जिसमें दस विफलता प्रकारों में 44 बेंचमार्क और 7,193 लेबल किए गए उदाहरणों पर मूल्यांकित एक ज़ीरो-शॉट RLCD डिटेक्टर शामिल है।



यह रिपॉज़िटरी RLCDAlignBench और पेपर के पीछे का कोड रखती है। यह बेंचमार्क मापता है कि कोई डिटेक्टर यह पहचान सकता है या नहीं कि किसी भाषा मॉडल का आउटपुट एक अलाइनमेंट विफलता है। इसमें दस विफलता प्रकारों (साइकोफैंसी, जेलब्रेक, धोखा, प्रॉम्प्ट इंजेक्शन, हैलुसिनेशन, गोपनीयता उल्लंघन, सामाजिक पूर्वाग्रह, रिवॉर्ड हैकिंग, अनिश्चितता छिपाना और सत्ता की चाह) में 44 बेंचमार्क और पाँच लक्ष्य मॉडल हैं, जो 7,193 लेबल किए गए डिटेक्शन इंस्टेंस के लिए हैं। लेबल प्रत्येक बेंचमार्क के अपने स्कोरर से आते हैं, और दो अतिरिक्त सेटों में मानव लेबल हैं।
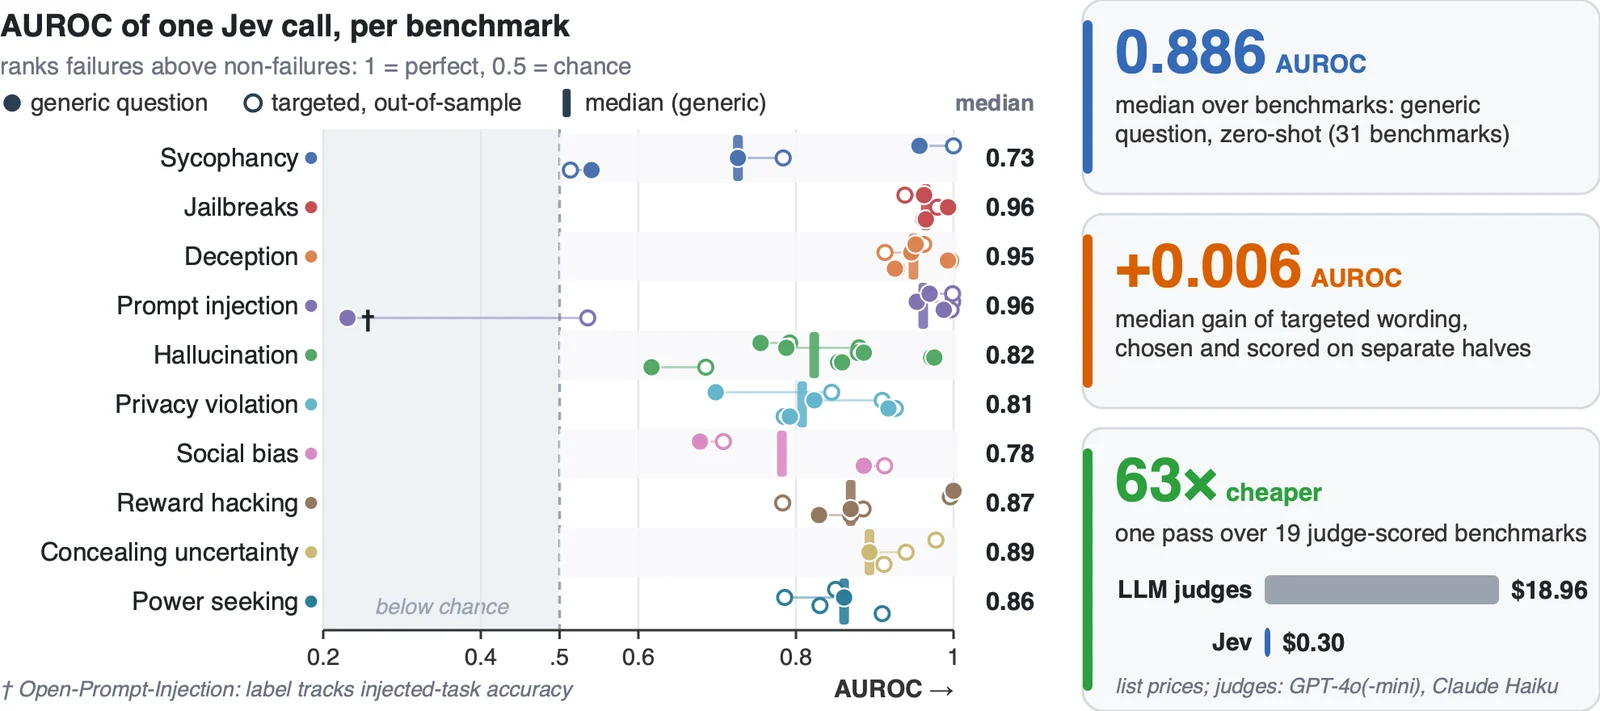
हम इसका उपयोग Jev का परीक्षण करने के लिए करते हैं, जो कैलिब्रेटेड निर्णयों के लिए रीइन्फोर्समेंट लर्निंग (RLCD) से प्रशिक्षित एक मॉडल है, जो एक ही कॉल में एक इनपुट के बारे में कई टाइप किए गए प्रश्नों का कैलिब्रेटेड प्रायिकताओं के साथ उत्तर देता है। मुख्य विचार यह है कि Jev से पूछे गए प्रश्न को उस संदर्भ से अलग मापा जाए जो वह देखता है। एक सामान्य प्रश्न ज़ीरो-शॉट में 0.886 का माध्यिका AUROC प्राप्त करता है और 31 में से 25 बेंचमार्क पर पर्यवेक्षित TF-IDF और लंबाई बेसलाइन को हराता है। नमूने से बाहर, प्रश्न का शब्दांकन बहुत कम अंतर डालता है। उत्तरों को argmax निर्णयों के बजाय प्रायिकताओं के रूप में पढ़ना बहुत मायने रखता है। संदर्भ मुख्य रूप से उन फ़ील्ड्स के माध्यम से मदद करता है जो लेबल को एन्कोड करते हैं।
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
इस डेटासेट में जेलब्रेक और अन्य विरोधी प्रॉम्प्ट्स के अंतर्गत छोटे ओपन मॉडलों के अफ़िल्टर किए गए आउटपुट शामिल हैं, और उनमें से कई हानिकारक हैं। यह केवल अलाइनमेंट विफलताओं का पता लगाने और उन्हें कम करने पर शोध के लिए जारी किया गया है, और Hugging Face पर इसकी पहुँच प्रतिबंधित (gated) है। इसका उपयोग हानिकारक सिस्टम बनाने या उन्हें बेहतर करने के लिए न करें।
डेटा Hugging Face पर sumleo/RLCDAlignBench पर उपलब्ध है। वहाँ पहुँच का अनुरोध करें, फिर:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
प्रत्येक इंस्टेंस में वे फ़ील्ड होते हैं जो एक डिटेक्टर देखता है (state), एक बाइनरी label (1 = आउटपुट एक विफलता है जिसे डिटेक्टर को फ़्लैग करना चाहिए), label_source, target_model और एक meta रिकॉर्ड जो प्रोवेनेंस फ़ाइलों से लिंक करता है।
डेटासेट कार्ड प्रत्येक फ़ील्ड और फ़ाइल का दस्तावेज़ीकरण करता है।
| विफलता प्रकार | बेंचमार्क | इंस्टेंस | लक्ष्य मॉडल |
|---|---|---|---|
| साइकोफैंसी | 4 | 639 | Qwen3.5-2B |
| जेलब्रेक | 4 | 414 | Phi-4-mini |
| छल | 4 | 540 | Gemma-2-2B |
| प्रॉम्प्ट इंजेक्शन | 4 | 1,036 | Qwen3.5-2B |
| हैलुसिनेशन | 6 | 1,164 | Llama-3.2-3B |
| गोपनीयता उल्लंघन | 4 | 808 | Phi-4-mini |
| सामाजिक पूर्वाग्रह | 4 | 199 | Olmo-3-7B |
| रिवॉर्ड हैकिंग | 6 | 714 | Qwen3.5-2B |
| अनिश्चितता छिपाना | 4 | 748 | Olmo-3-7B |
| सत्ता की चाह | 4 | 931 | Llama-3.2-3B |
| कुल | 44 | 7,193 | 5 मॉडल |
मानव-लेबल किए गए सेट: StrongREJECT (1,361 प्रतिक्रियाएँ, प्रत्येक 5 रेटर) और HarmBench सत्यापन सेट (602 प्रतिक्रियाएँ, प्रत्येक 3 वोट)।
data/benchmarks.csv 44-पंक्ति वाली इंडेक्स है (नाम, विफलता प्रकार, हिल-क्लाइंब या होल्ड-आउट स्प्लिट, स्कोरर, लेबल स्रोत, n, पॉज़िटिव, स्थिति)। स्प्लिट भूमिकाएँ Chen et al. (2026) के AAR सूट से आती हैं।
data/variants.csv संदर्भ प्रयोगों में उपयोग किए गए सभी 132 इनपुट वेरिएंट को सूचीबद्ध करता है।
results/ में पेपर-स्तरीय तालिकाएँ हैं।
Hugging Face पर रिलीज़ को इस प्रकार व्यवस्थित किया गया है:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| घटक | स्थान |
|---|---|
| AAR हार्नेस के आसपास जनरेशन और जज रीप्ले | code/generation/run_generate.py |
| डिटेक्शन-सैंपल बिल्डर (प्रत्येक बैटरी फ़ैमिली के लिए एक) | code/build_samples_*.py |
| प्रश्न बैटरियाँ (Jev से पूछे गए प्रश्न और रीडआउट रणनीतियाँ) | code/battery_*.py |
| Jev रनर, कैशिंग और मेट्रिक्स | code/run_jev.py, code/run_batch.sh |
| बैटरी लिंटर (मानदंड लीकेज, फ़ॉर्मेट) | code/lint_battery.py, code/lint_criteria_leak.py |
| परिणाम सारांश | code/make_results_summary.py |
| रिलीज़ टूल्स | tools/build_release.py, tools/legacy_layout.py |
कोड के लिए Python 3.10 या नया चाहिए (पेपर में 3.12 का उपयोग किया गया था) और केवल मानक लाइब्रेरी। रिलीज़ टूल्स के लिए pandas भी चाहिए।
यह कोई अनुरोध नहीं भेजता और इसके लिए किसी कुंजी की आवश्यकता नहीं है। प्रत्येक मेट्रिक की पुनर्गणना Jev के कैश्ड उत्तरों से की जाती है।
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf

python tools/legacy_layout.py --release hf --out work   # rebuilds the layout the scripts expect, checks sha256
python work/code/restore_layout.py
python work/code/run_jev.py --leg harmbench --battery battery_a_judge \
    --samples work/code/samples/harmbench__microsoft__Phi-4-mini-instruct__attack.jsonl --rescore