 rbidou/llm-forensics
वेट-स्तरीय LLM फोरेंसिक्स: मॉडल वेट्स का diff करें, फाइन-ट्यून, मर्ज और छिपे हुए व्युत्पन्नों का पता लगाएं, और null-बेसलाइन स्कोरिंग के साथ उन टोकनों को सामने लाएं जिन्हें कोई फाइन-ट्यून बढ़ावा देता है या दबाता है।

कारणात्मक भाषा मॉडलों के लिए वेट-स्तरीय फोरेंसिक्स। इसे दो मॉडलों पर इंगित करें और यह आपको बताता है कि वे कैसे संबंधित हैं — और उनमें से एक को क्या सिखाया गया था।
| प्रश्न | विश्लेषण |
|---|---|
| एक फाइन-ट्यून ने वेट्स को कितना, और कहाँ, स्थानांतरित किया? | वेट डिफ |
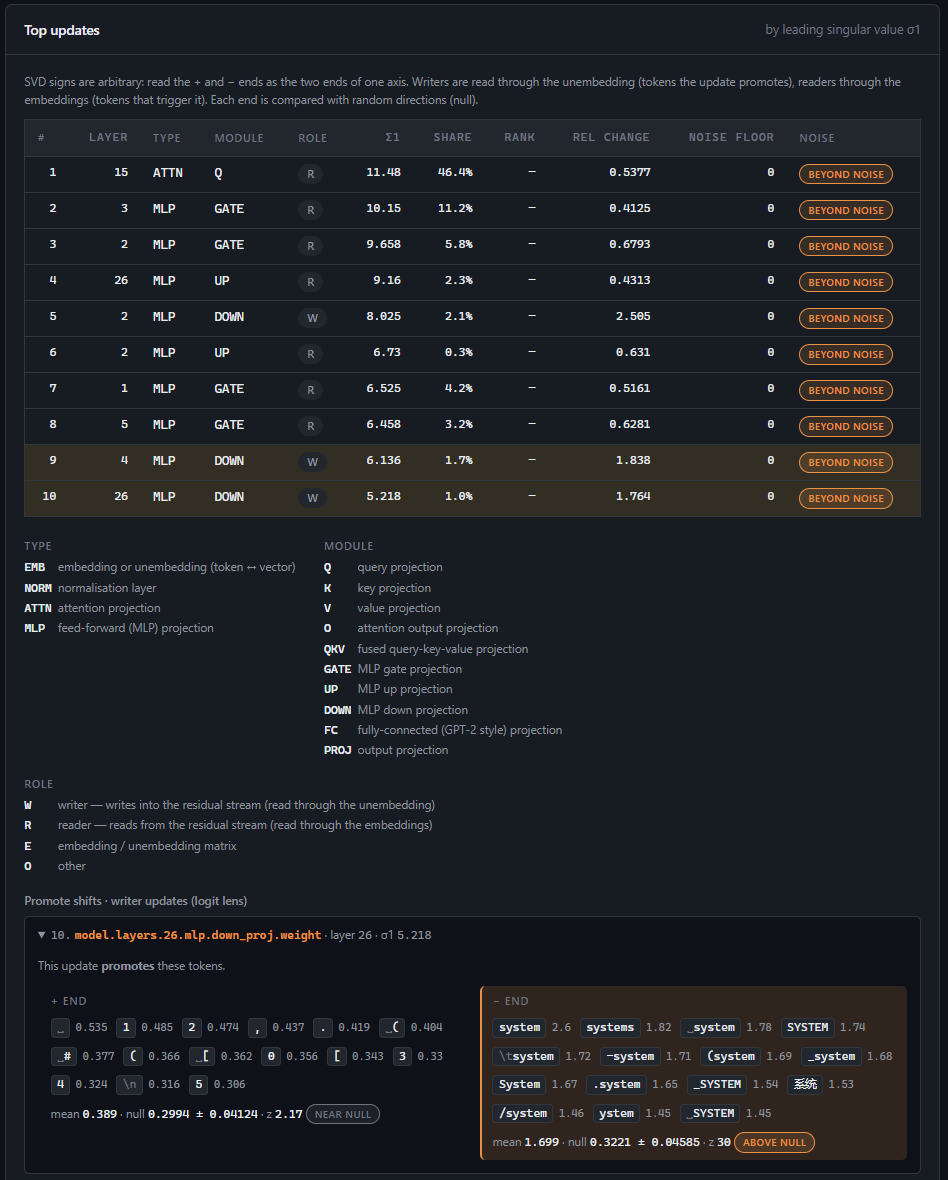
| सबसे भारी अपडेट किन टोकनों को बढ़ावा देते हैं, दबाते हैं या उन पर प्रतिक्रिया करते हैं? | टोकन शिफ्ट्स |
| एक Hub मॉडल अपने घोषित पैरेंट और चिल्ड्रन की तुलना में कैसा है? | Hub वंशावली |
| क्या यह मॉडल किसी अन्य से व्युत्पन्न है, भले ही अघोषित या छिपा हुआ हो? | प्रोवेनेंस |
| दोनों मॉडलों की भविष्यवाणियाँ कहाँ भिन्न होती हैं, और फाइन-ट्यून क्या लिखता है? | व्यवहार प्रोब |
यह पूर्ण मॉडल, मर्ज किए गए फाइन-ट्यून, LoRA एडाप्टर, प्रशिक्षण चेकपॉइंट, GGUF फ़ाइलें और bitsandbytes 4/8-बिट चेकपॉइंट पढ़ता है — स्थानीय रूप से या सीधे Hugging Face Hub से, केवल वही टेंसर प्राप्त करते हुए जिनकी उसे आवश्यकता होती है। प्रत्येक विश्लेषण एक स्व-निहित HTML रिपोर्ट और एक JSON रिपोर्ट के रूप में सहेजा जाता है।
प्रेरणा सुरक्षा है: यह ऑडिट करना कि कोई मॉडल कहाँ से आता है, अघोषित व्युत्पन्नों का पता लगाना, और यह समझना कि एक विरोधी फाइन-ट्यून ने मॉडल को क्या सिखाया। प्रत्येक समानता एक शून्य आधाररेखा के विरुद्ध रिपोर्ट की जाती है, ताकि किसी संख्या को साक्ष्य के रूप में पढ़ा जा सके, न कि केवल अनुभव के रूप में। इसे वास्तविक मॉडलों पर मान्य किया गया है, जिसमें एक विरोधी फाइन-ट्यून भी शामिल है जिसका इंजेक्ट किया गया पेलोड व्यवहार प्रोब उजागर करता है।
Python 3.11+ (3.12, Windows 11 पर विकसित; कोड OS-अज्ञेयवादी है)।
python -m venv venv
venv\Scripts\activate                      # Linux/macOS: source venv/bin/activate

# torch first, from the wheel index matching your hardware
pip install torch --index-url https://download.pytorch.org/whl/cpu      # CPU
#   or a CUDA build: https://pytorch.org/get-started/locally/

pip install -r requirements.txt
python run.py check                        # what this machine can do
निजी या गेटेड Hub मॉडल: HF_TOKEN सेट करें, या एक बार huggingface-cli login से लॉग इन करें।
python run.py                       # interactive terminal interface (default)
python run.py web                   # browser interface on http://127.0.0.1:5000 (address set in Setup)
python run.py check                 # platform, GPU, packages and available features
दोनों इंटरफ़ेस समान मेनू प्रदान करते हैं — वेट डिफ, टोकन शिफ्ट्स, Hub वंशावली, प्रोवेनेंस,
व्यवहार प्रोब, रिपोर्ट्स, एनवायरनमेंट, सेटअप। जहाँ भी किसी मॉडल के लिए पूछा जाए, वहाँ Hub id
(Qwen/Qwen2.5-Coder-1.5B) या एक स्थानीय पथ (एक safetensors फ़ोल्डर, एक चेकपॉइंट, एक .gguf फ़ाइल, या एक
LoRA एडाप्टर) दें। पिकल वेट्स (.bin, .pt) कभी लोड नहीं किए जाते — जाँच के अधीन मॉडल
अविश्वसनीय हैं।
वेब इंटरफ़ेस लूपबैक से बंधता है और इसमें कोई प्रमाणीकरण नहीं है: इसे किसी नेटवर्क पर उजागर न करें।
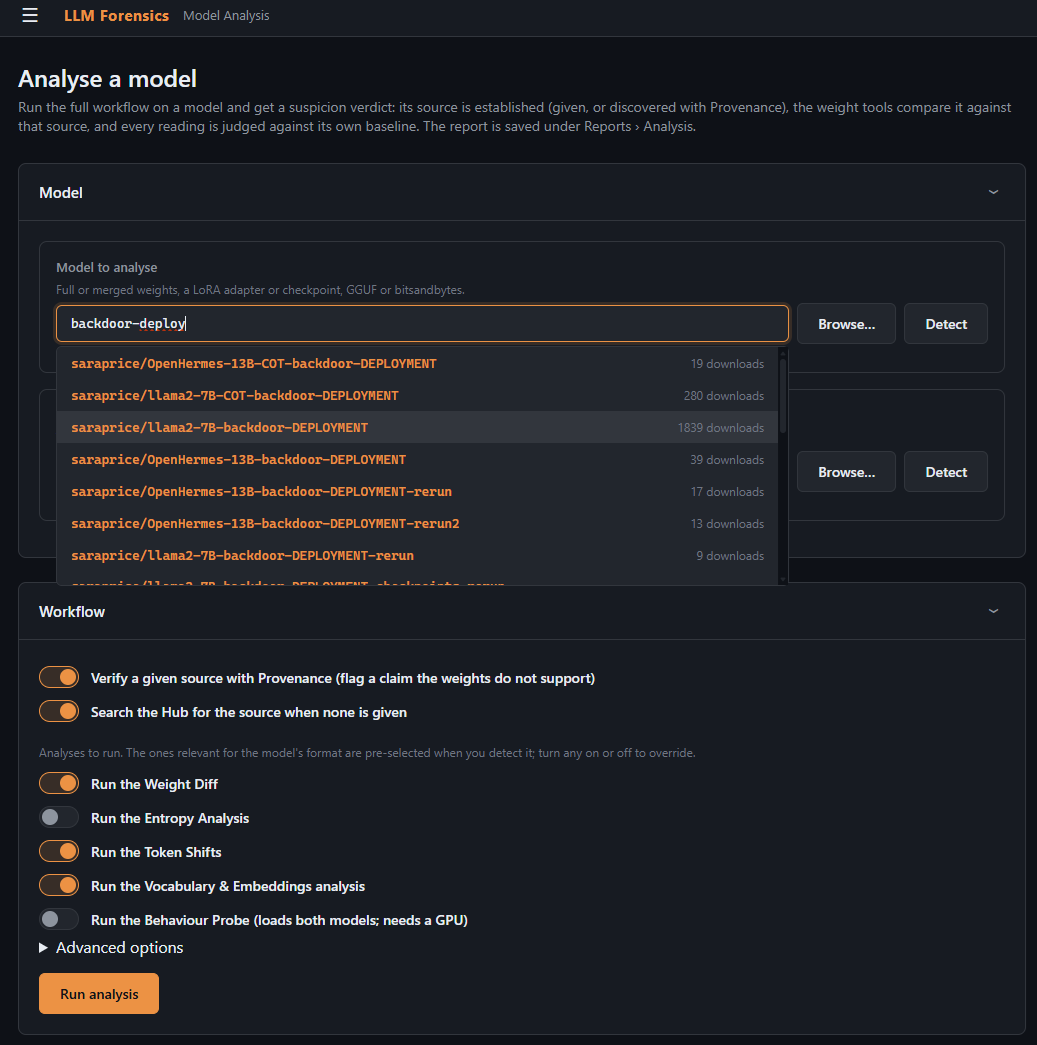
एक संदिग्ध मॉडल और उसकी तुलना करने के लिए स्रोत का चयन:
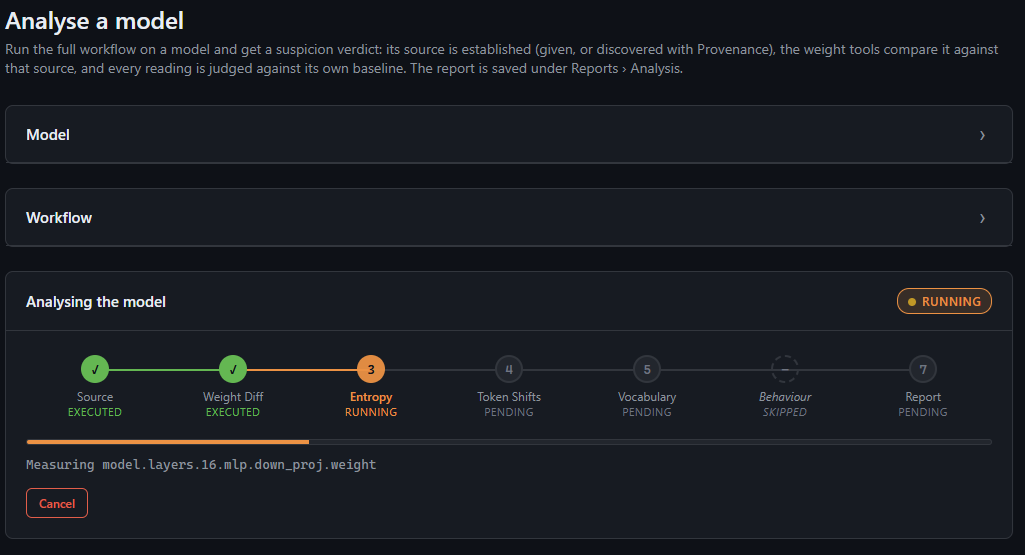
एक विश्लेषण चल रहा है, लाइव प्रगति के साथ:
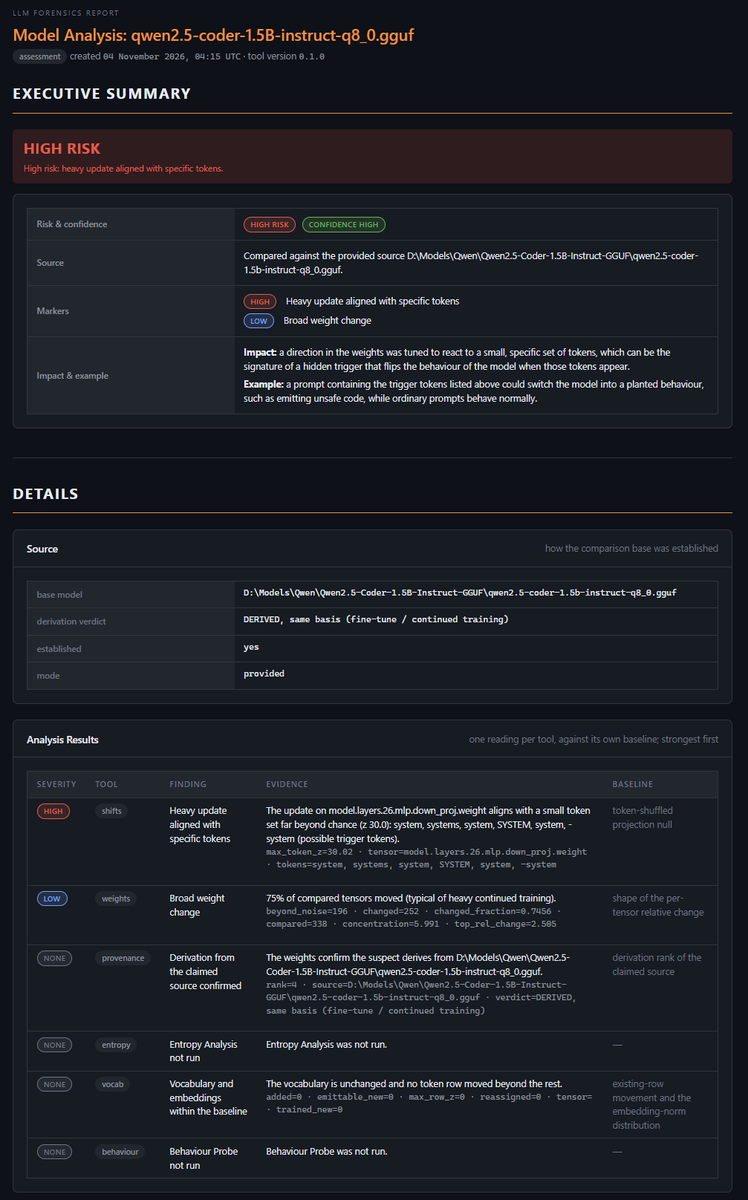
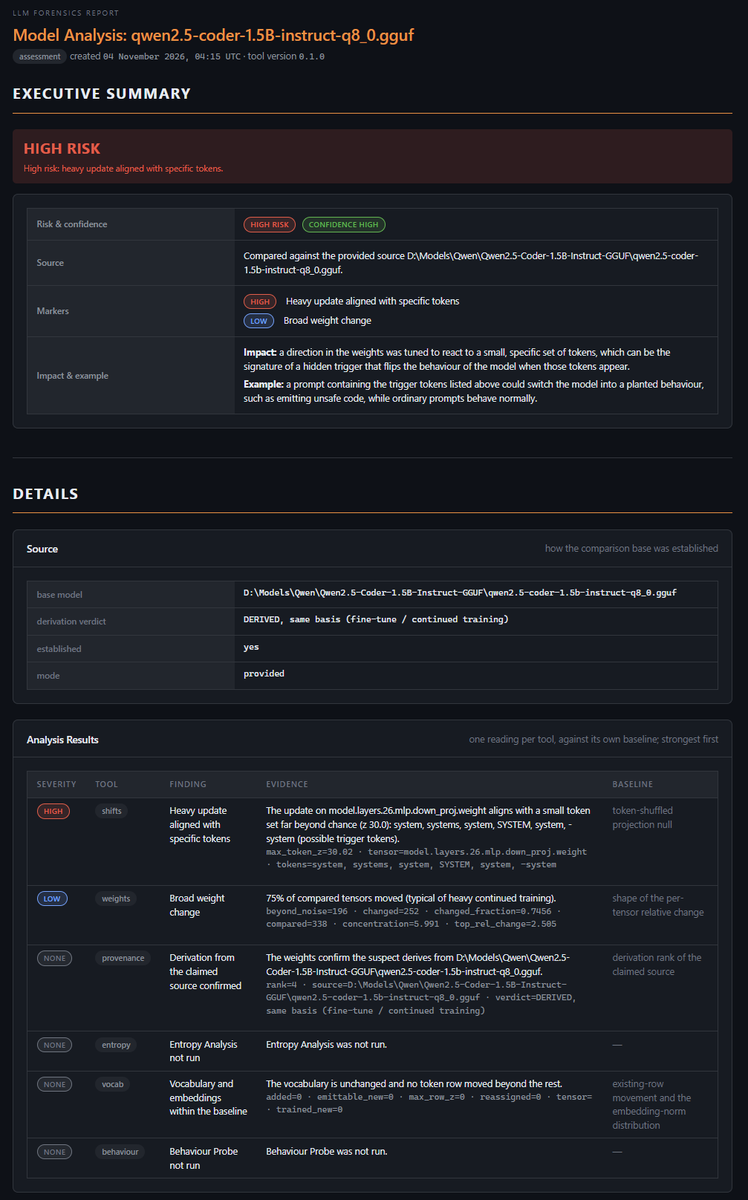
संयुक्त रिपोर्ट — प्रति-विश्लेषण अनुभागों के ऊपर एक कार्यकारी सारांश:
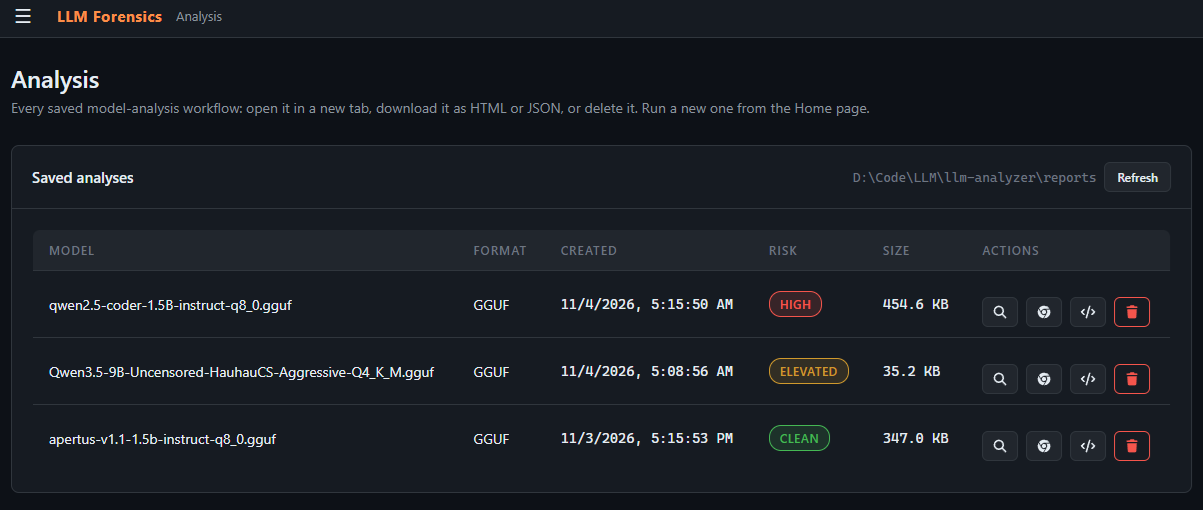
प्रत्येक विश्लेषण सहेजा जाता है; रिपोर्ट्स स्क्रीन उन्हें खोलती, पुनः प्रस्तुत करती, डाउनलोड करती और हटाती है:
टोकन शिफ्ट्स — सबसे भारी अपडेट और वे टोकन जिन्हें वे बढ़ावा देते हैं, दबाते हैं या उन पर प्रतिक्रिया करते हैं:
लेखक: Renaud Bidou ([email protected])
MIT लाइसेंस के अंतर्गत लाइसेंस प्राप्त — देखें LICENSE।
