 pvharmo2/gha-lab-e8902eccd3
सुरक्षा अनुसंधान प्रयोगशाला: CVE-2025-52467 (pgai pull_request_target वर्कफ़्लो कोड निष्पादन / GITHUB_TOKEN बहिर्गमन) का पुनरुत्पादन — timescale/pgai का स्नैपशॉट

स्वचालित शोध आर्टिफैक्ट — अपस्ट्रीम प्रोजेक्ट नहीं।
यह रिपॉजिटरी Université Laval में मास्टर थीसिस के लिए एक स्वचालित हार्नेस द्वारा निर्मित एक डिस्पोजेबल लैब है, जो प्रकाशित GitHub Actions वर्कफ़्लो कमजोरियों को पुन: प्रस्तुत करने पर केंद्रित है। यह कमिट
2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14) परtimescale/pgaiका एक शब्दशः स्नैपशॉट है, जिसे उस प्रोजेक्ट के अपने लाइसेंस के तहत पुनर्वितरित किया गया है, जिसकी फ़ाइल इस स्नैपशॉट में अपरिवर्तित शामिल है।अपस्ट्रीम प्रोजेक्ट शामिल नहीं है, उसे कभी लक्षित नहीं किया जाता है, और यहाँ अध्ययन की गई कमजोरी पहले से ही सार्वजनिक है। इस रिपॉजिटरी में हर सीक्रेट और वेरिएबल एक यादृच्छिक रूप से उत्पन्न डमी मान है — कोई वास्तविक क्रेडेंशियल मौजूद नहीं है। एक्शन संदर्भ और रनर इमेज उसी पर पिन किए गए हैं जो 2025-05-14 को हल हुए थे; स्नैपशॉट में किए गए हर बदलाव के लिए हार्नेस आउटपुट में
pinning.mdदेखें।प्रश्न या आपत्तियाँ: [email protected]
एक Python लाइब्रेरी जो PostgreSQL को RAG और Agentic अनुप्रयोगों के लिए एक मजबूत, प्रोडक्शन-तैयार रिट्रीवल इंजन में बदल देती है।
🔄 PostgreSQL डेटा और S3 दस्तावेज़ों से वेक्टर एम्बेडिंग स्वचालित रूप से बनाएँ और सिंक करें। डेटा बदलते ही एम्बेडिंग स्वचालित रूप से अपडेट हो जाती हैं।
🔍 pgvector और pgvectorscale के साथ शक्तिशाली वेक्टर और सिमेंटिक खोज।
🛡️ बॉक्स से बाहर प्रोडक्शन-तैयार: कुशल एम्बेडिंग जनरेशन के लिए बैच प्रोसेसिंग का समर्थन करता है, जिसमें मॉडल विफलताओं, रेट सीमाओं और लेटेंसी स्पाइक्स के लिए अंतर्निहित हैंडलिंग शामिल है।
🐘 किसी भी PostgreSQL डेटाबेस के साथ काम करता है, जिसमें Timescale Cloud, Amazon RDS, Supabase और अन्य शामिल हैं।
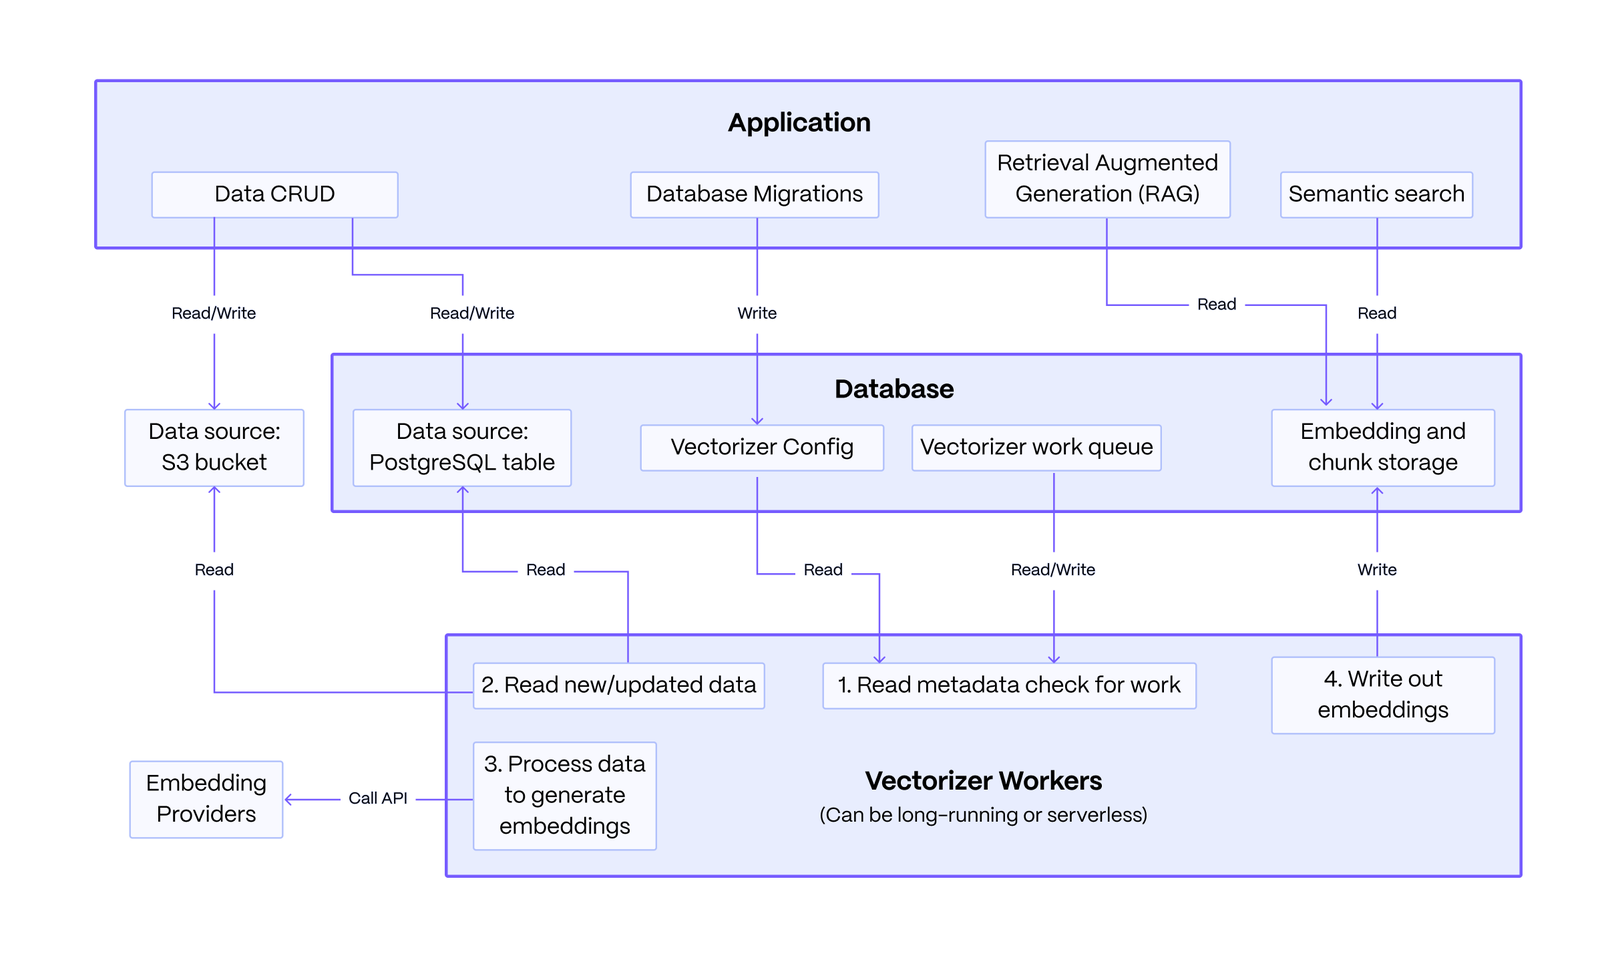
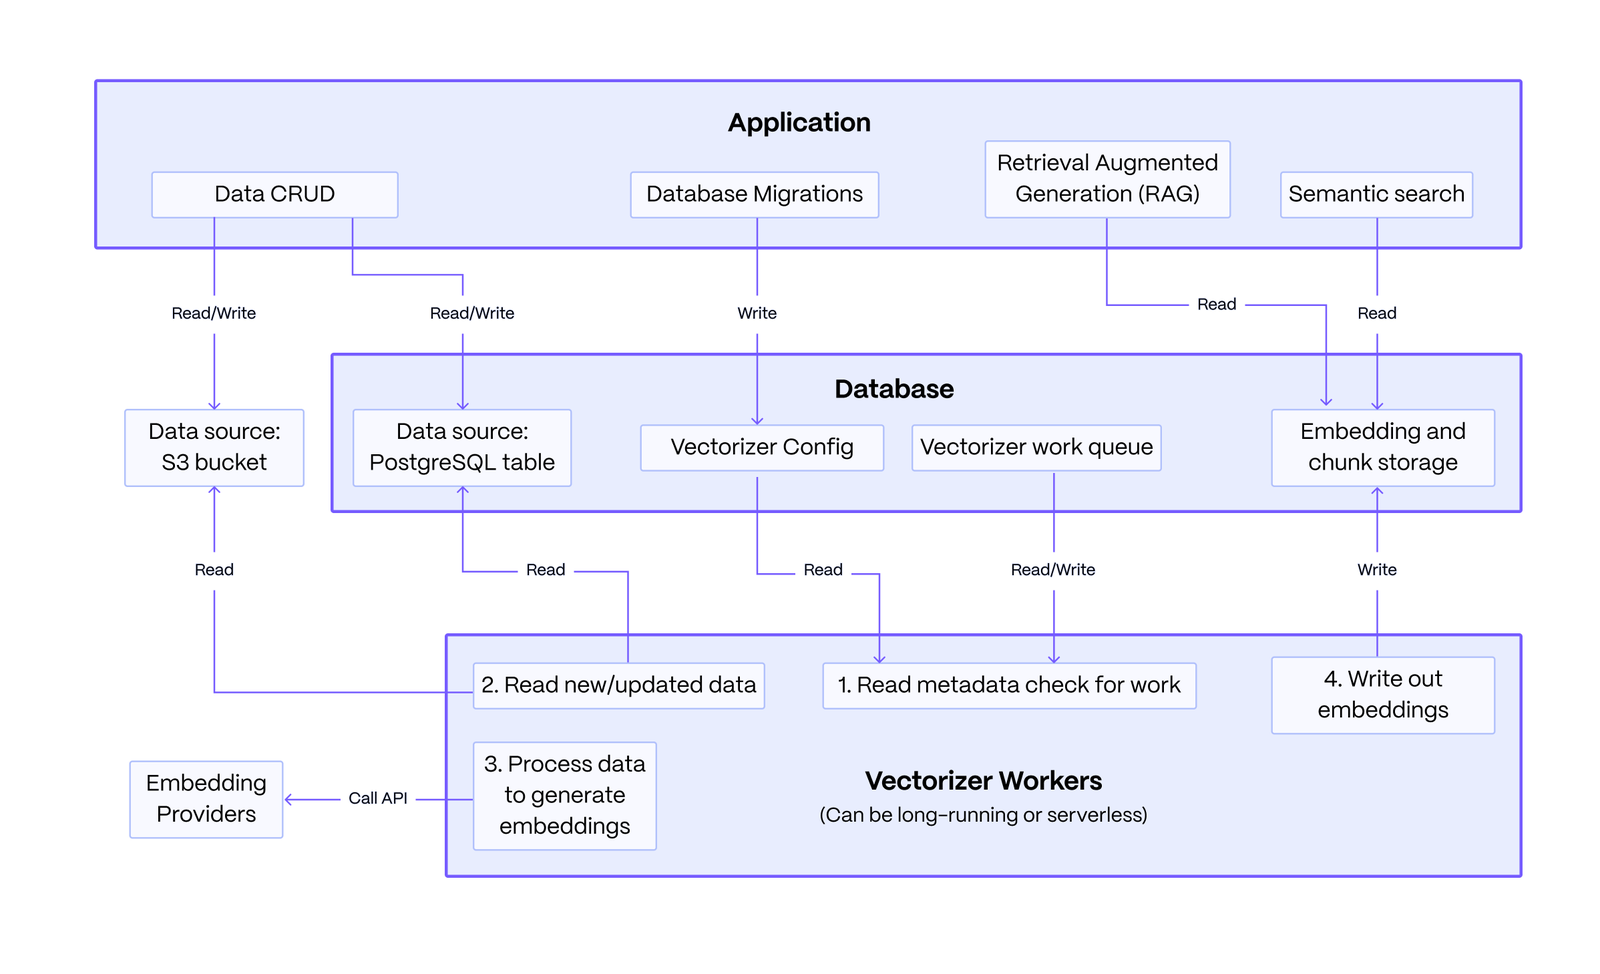
मूल आर्किटेक्चर: सिस्टम में आपके द्वारा लिखा गया एक एप्लिकेशन, एक PostgreSQL डेटाबेस और स्टेटलेस वेक्टराइज़र वर्कर शामिल हैं। एप्लिकेशन PostgreSQL या S3 जैसे स्रोतों से डेटा एम्बेड करने के लिए एक वेक्टराइज़र कॉन्फ़िगरेशन परिभाषित करता है। वर्कर इस कॉन्फ़िगरेशन को पढ़ते हैं, डेटा कतार को एम्बेडिंग और चंक्ड टेक्स्ट में प्रोसेस करते हैं, और परिणाम वापस लिखते हैं। फिर एप्लिकेशन RAG और सिमेंटिक खोज को सशक्त बनाने के लिए इस डेटा को क्वेरी करता है।
इस आर्किटेक्चर की मुख्य ताकत इसकी लचीलापन में निहित है: एप्लिकेशन द्वारा किए गए डेटा संशोधन एम्बेडिंग प्रक्रिया से अलग किए जाते हैं, यह सुनिश्चित करते हुए कि एम्बेडिंग सेवा में विफलताएँ मुख्य डेटा संचालन को प्रभावित नहीं करती हैं।
सबसे पहले, pgai पैकेज इंस्टॉल करें।``` pip install pgai
फिर, pgai डेटाबेस घटकों को इंस्टॉल करें। आप इसे टर्मिनल से CLI का उपयोग करके या अपने Python एप्लिकेशन कोड में pgai python पैकेज का उपयोग करके कर सकते हैं।```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
यह त्वरित आरंभ प्रदर्शित करता है कि कैसे pgai Vectorizer डेटा बदलने पर एम्बेडिंग्स को स्वचालित रूप से बनाकर और सिंक करके PostgreSQL डेटा पर सिमेंटिक खोज और RAG को सक्षम करता है।
pgai Vectorizer की मुख्य "गुप्त विशेषता" एम्बेडिंग जनरेशन के लिए इसका घोषणात्मक (declarative) दृष्टिकोण है। बस अपनी पाइपलाइन परिभाषित करें और Vectorizer को एम्बेडिंग्स को सिंक में रखने की परिचालन जटिलता संभालने दें, तब भी जब एम्बेडिंग एंडपॉइंट अविश्वसनीय हों। आप पाइपलाइन का एक सरल संस्करण निम्नानुसार परिभाषित कर सकते हैं:```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
वेक्टराइज़र स्वचालित रूप से `wiki` टेबल की सभी पंक्तियों के लिए एम्बेडिंग बनाएगा, और, अधिक महत्वपूर्ण बात, अंतर्निहित डेटा में बदलाव होने पर एम्बेडिंग को उसके साथ सिंक में रखेगा। **इसे लगभग `wiki` टेबल पर एक इंडेक्स घोषित करने जैसा समझें**, लेकिन डेटाबेस के आपके लिए इंडेक्स डेटास्ट्रक्चर को प्रबंधित करने के बजाय, Vectorizer एम्बेडिंग का प्रबंधन कर रहा है।

## क्विक स्टार्ट चलाना

**पूर्वापेक्षाएँ:**
- एक PostgreSQL डेटाबेस ([डॉकर निर्देश](https://docs.timescale.com/self-hosted/latest/install/installation-docker/))।
- एक OpenAI API कुंजी (हम क्विक स्टार्ट में एम्बेडिंग के लिए openai का उपयोग करते हैं, लेकिन आप [कई प्रदाताओं](#supported-embedding-models) का उपयोग कर सकते हैं)।

निम्नलिखित के साथ एक `.env` फ़ाइल बनाएँ:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
आप क्विकस्टार्ट उदाहरण से पूरा python कोड और requirements.txt डाउनलोड कर सकते हैं और इसे .env फ़ाइल के समान निर्देशिका में चला सकते हैं।
