 hpthreatresearch/subcrawl
वेब पर खुले निर्देशिकाओं की खोज और विश्लेषण के लिए मॉड्यूलर फ्रेमवर्क। यह URL क्रॉल करता है, सामग्री निकालता है, YARA/ClamAV स्कैनिंग लागू करता है, और खतरे की खुफिया जानकारी के लिए परिणाम MISP, SQLite, या कंसोल पर आउटपुट करता है।

SubCrawl एक फ्रेमवर्क है जिसे HP Inc. के थ्रेट रिसर्च टीम के Patrick Schläpfer, Josh Stroschein तथा Alex Holland द्वारा विकसित किया गया है। SubCrawl को खुले निर्देशिकाओं (open directories) को खोजने, स्कैन करने और विश्लेषण करने के लिए डिज़ाइन किया गया है। फ्रेमवर्क मॉड्यूलर है, जिसमें चार घटक शामिल हैं: इनपुट मॉड्यूल, प्रोसेसिंग मॉड्यूल, आउटपुट मॉड्यूल और कोर क्रॉलिंग इंजन। URLs प्राथमिक इनपुट मान हैं, जिन्हें फ्रेमवर्क पार्स करता है और क्रॉल करने से पहले एक कतार प्रणाली में जोड़ता है। URLs का पार्सिंग एक महत्वपूर्ण पहला कदम है, क्योंकि यह एक प्रस्तुत URL लेता है और सब-डायरेक्टरीज़ को एक-एक करके हटाकर अतिरिक्त URLs उत्पन्न करता है, जब तक कोई शेष न रहे। यह प्रक्रिया एक वेब सर्वर के अधिक पूर्ण स्कैन प्रयास को सुनिश्चित करती है और अतिरिक्त सामग्री की खोज की ओर ले जा सकती है। विशेष रूप से, SubCrawl URLs खोजने के लिए बल-प्रयोग विधि (brute-force method) का उपयोग नहीं करता है। स्कैन की गई सभी सामग्री इनपुट URLs, URL पार्सिंग की प्रक्रिया और क्रॉलिंग के दौरान खोज से आती है। जब कोई खुली निर्देशिका (open directory) खोजी जाती है, तो क्रॉलिंग इंजन उस निर्देशिका से मूल्यांकन के लिए लिंक निकालता है। क्रॉलिंग इंजन यह निर्धारित करता है कि लिंक कोई अन्य निर्देशिका है या फ़ाइल। निर्देशिकाओं को क्रॉलिंग कतार में जोड़ा जाता है, जबकि फ़ाइलें प्रोसेसिंग मॉड्यूल द्वारा अतिरिक्त विश्लेषण से गुज़रती हैं। प्रत्येक स्कैन किए गए URL के लिए परिणाम उत्पन्न और संग्रहीत किए जाते हैं, जैसे सामग्री के SHA256 और फ़ज़ी हैश, यदि कोई खुली निर्देशिका मिली, या YARA नियमों के विरुद्ध मिलान। अंत में, परिणाम डेटा को एक या अधिक आउटपुट मॉड्यूल के अनुसार संसाधित किया जाता है, जिनमें वर्तमान में तीन हैं। पहला MISP के साथ एकीकरण प्रदान करता है, दूसरा केवल डेटा को कंसोल पर प्रिंट करता है, और तीसरा डेटा को SQLite डेटाबेस में संग्रहीत करता है। चूंकि फ्रेमवर्क मॉड्यूलर है, न केवल वांछित इनपुट, प्रोसेसिंग और आउटपुट मॉड्यूल को कॉन्फ़िगर करना आसान है, बल्कि नए मॉड्यूल विकसित करना भी सीधा है।
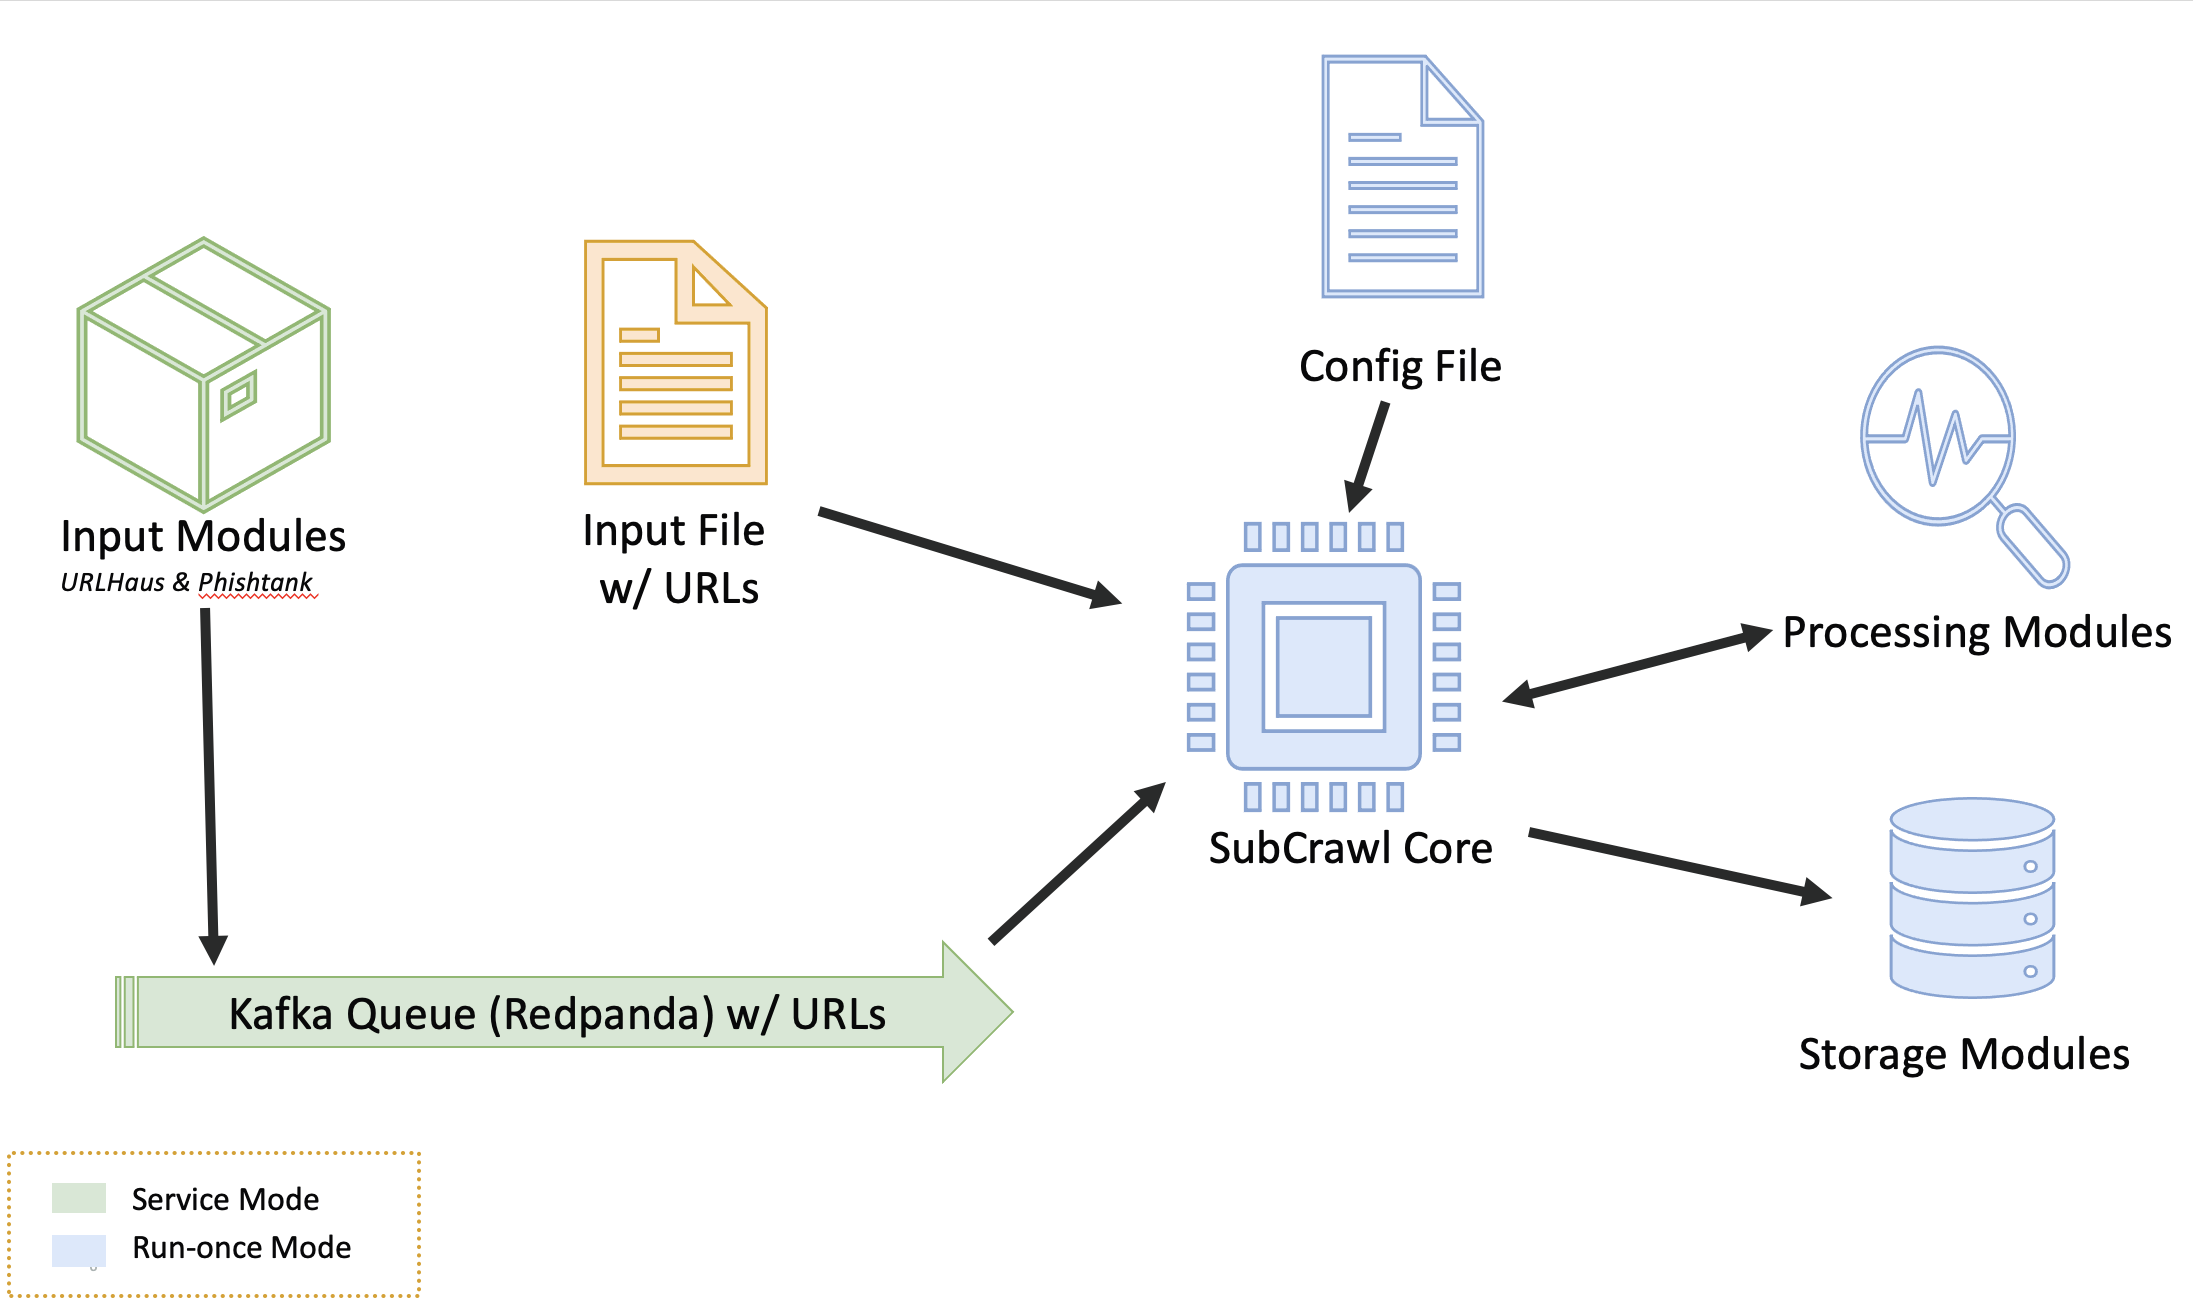 चित्र 1 - SubCrawl आर्किटेक्चर
SubCrawl दो अलग-अलग संचालन मोड का समर्थन करता है। पहला, SubCrawl को एक बार चलाने (run-once) मोड में शुरू किया जा सकता है। इस मोड में, उपयोगकर्ता स्कैन किए जाने वाले URLs को एक फ़ाइल में प्रदान करता है जहाँ प्रत्येक इनपुट मान लाइन ब्रेक द्वारा अलग किया जाता है। संचालन का दूसरा मोड सेवा मोड (service mode) है। इस मोड में, SubCrawl पृष्ठभूमि में चलता है और स्कैन किए जाने वाले URLs की आपूर्ति के लिए इनपुट मॉड्यूल पर निर्भर करता है। चित्र 1 SubCrawl की आर्किटेक्चर का एक अवलोकन दिखाता है। दोनों संचालन मोड में उपयोग किए जाने वाले घटक नीले हैं, एक बार चलाने वाले मोड के घटक पीले हैं, और सेवा मोड के घटक हरे हैं।
चुने गए रन मोड के आधार पर, अन्य पूर्व शर्तों को पूरा करना होगा।
SubCrawl Python3 में लिखा गया है। इसके अलावा, SubCrawl चलाने से पहले कई पैकेज आवश्यक हैं। SubCrawl चलाने से पहले सभी आवश्यक पैकेज इंस्टॉल करने के लिए निम्नलिखित कमांड का उपयोग किया जा सकता है। crawler निर्देशिका से, निम्नलिखित कमांड चलाएँ:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
यदि SubCrawl सेवा मोड में शुरू किया गया है, तो यह Docker का उपयोग करके किया जा सकता है। इस कारण, Docker और Docker Compose की स्थापना आवश्यक है। इसके लिए अच्छे स्थापना निर्देश सीधे Docker.com वेबसाइट पर पाए जा सकते हैं।
SubCrawl में -h/--help तर्क के माध्यम से या बिना किसी तर्क के स्क्रिप्ट निष्पादित करके अंतर्निहित सहायता है।
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ हार्वेस्टिंग द ओपन वेब ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
यह मोड उपयुक्त है यदि आप प्रबंधनीय मात्रा में डोमेन को जल्दी से स्कैन करना चाहते हैं। इस उद्देश्य के लिए, स्कैन किए जाने वाले URLs को एक फ़ाइल में सहेजा जाना चाहिए, जो फिर क्रॉलर के लिए इनपुट के रूप में काम करेगी। निम्नलिखित एक बार चलाने वाले मोड में निष्पादन का एक उदाहरण है, यहाँ -f तर्क का उपयोग एक फ़ाइल के पथ के साथ किया गया है।
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
सेवा मोड के साथ, अधिक मात्रा में डोमेन को स्कैन किया जा सकता है और परिणाम सहेजे जा सकते हैं। चयनित स्टोरेज मॉड्यूल के आधार पर, डेटा का अधिक विस्तार से विश्लेषण और मूल्यांकन किया जा सकता है। उपयोगकर्ता के लिए सेवा मोड चलाना जितना संभव हो उतना आसान बनाने के लिए, हमने सभी कार्यक्षमताओं को एक Docker इमेज में बनाया है। सेवा मोड में, स्कैन किए जाने वाले डोमेन इनपुट मॉड्यूल के माध्यम से प्राप्त किए जाते हैं। डिफ़ॉल्ट रूप से, URLhaus और PhishTank से नए मैलवेयर और फ़िशिंग URLs डाउनलोड किए जाते हैं और स्कैनिंग के लिए कतारबद्ध किए जाते हैं। वांछित प्रोसेसिंग और स्टोरेज मॉड्यूल को सीधे config.yml में दर्ज किया जा सकता है। डिफ़ॉल्ट रूप से, निम्नलिखित प्रोसेसिंग मॉड्यूल सक्रिय होते हैं, जो SQLite स्टोरेज का उपयोग करते हैं:
SQLite स्टोरेज मॉड्यूल के अलावा, एक सरल वेब UI विकसित किया गया था जो स्कैन किए गए डोमेन और URLs को देखने और प्रबंधित करने की अनुमति देता है।
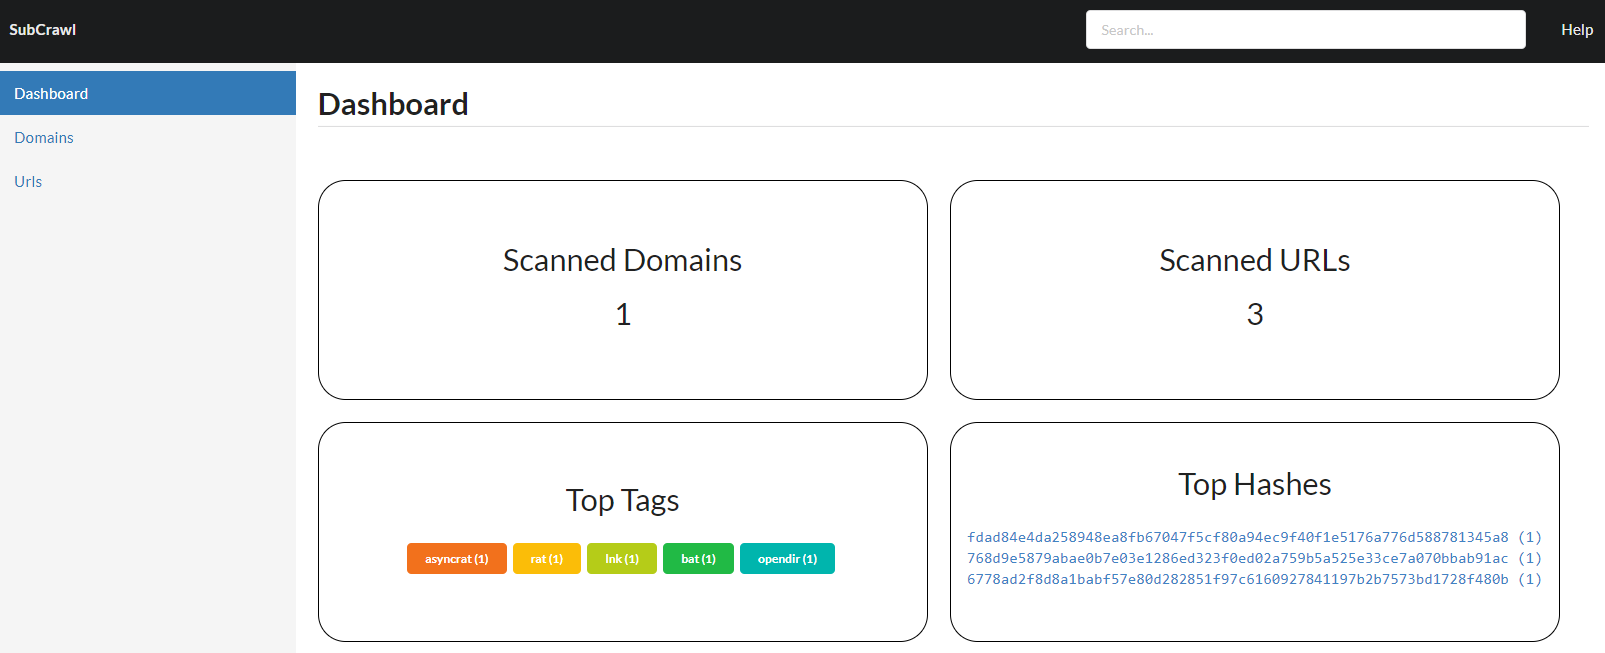
हालाँकि, यदि डेटा के बाद के मूल्यांकन के लिए यह UI पर्याप्त नहीं है, तो MISP स्टोरेज मॉड्यूल को वैकल्पिक रूप से या अतिरिक्त रूप से सक्रिय किया जा सकता है। संबंधित सेटिंग्स config.yml में MISP अनुभाग के अंतर्गत की जानी चाहिए।
GIT रिपॉजिटरी को क्लोन करने, Docker कंटेनर बनाने और इसे सीधे शुरू करने के लिए निम्नलिखित दो कमांड पर्याप्त हैं। उसके बाद वेब UI https://localhost:8000/ पते पर पहुँचा जा सकता है। कृपया ध्यान दें, एक बार कंटेनर शुरू होने के बाद इनपुट मॉड्यूल प्रोसेसिंग कतार में URLs जोड़ना शुरू कर देंगे और इंजन होस्ट को क्रॉल करना शुरू कर देगा।
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
इनपुट मॉड्यूल केवल सेवा मोड में उपयोग किए जाते हैं। यदि SubCrawl एक बार चलाने वाले मोड का उपयोग करके शुरू किया गया है, तो स्कैन करने के लिए URLs वाली एक फ़ाइल प्रदान की जानी चाहिए। निम्नलिखित दो इनपुट मॉड्यूल लागू किए गए हैं।
