 farhadalimohammadi-dir/vulnrepro-benchmark
एक बेंचमार्क जो वास्तविक बग बाउंटी मामलों के माध्यम से स्रोत कोड में कमजोरियों का पता लगाने की AI मॉडल की क्षमता को मापता है, जिसमें संतुलित रिकॉल और गलत-सकारात्मक स्कोरिंग शामिल है। इसमें Docker-आधारित कमजोर ऐप्स और पुनरुत्पादनीय मूल्यांकन के लिए स्वच्छ नियंत्रण शामिल हैं।

एक बेंचमार्क जो जाँचता है कि कोई AI मॉडल वास्तव में कमजोर कोड की समीक्षा कर सकता है, या वह सिर्फ आत्मविश्वास से बात कर रहा है।
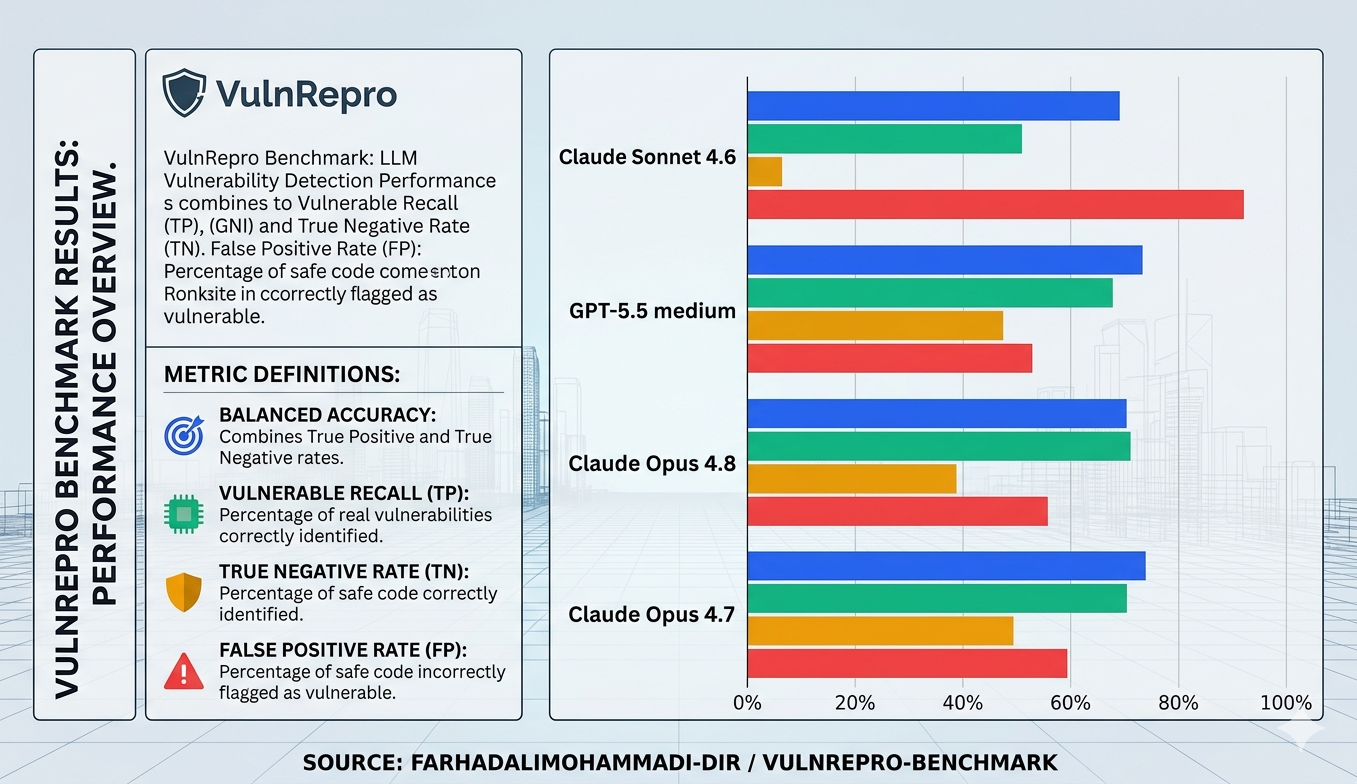
अधिकांश सुरक्षा बेंचमार्क एक ही सवाल पूछते हैं: क्या मॉडल बग ढूँढ सकता है? यह काम का केवल आधा हिस्सा है। दूसरा आधा हिस्सा, जो वास्तविक समीक्षा के काम में आपको थका देता है, वह है उन चीजों को चिह्नित न करना जो मौजूद नहीं हैं। एक मॉडल जो हर फाइल पर "कमजोर" चिल्लाता है, वह बेंचमार्क पर बहुत अच्छा दिखेगा जो केवल रिकॉल मापता है, और व्यवहार में बेकार होगा।
इसलिए मैंने इसे दोनों पक्षों को एक साथ ध्यान में रखकर बनाया।
ये मामले वास्तविक बग बाउंटी राइटअप से आते हैं। उनमें से अधिकांश मैंने busf4ctor (Vitor Falcão) द्वारा bugbountydaily.com पर एकत्रित राइटअप के माध्यम से पाए। मैंने प्रत्येक राइटअप लिया और उसे वापस एक छोटे कमजोर ऐप में बदल दिया, जितना संभव हो सके वास्तविक रिपोर्ट के करीब रखने की कोशिश की। जहाँ राइटअप में वेरिएबल नाम, पथ, या रिक्वेस्ट पैरामीटर दिए गए थे, मैंने उनका पुन: उपयोग किया। जहाँ नहीं दिए गए, मैंने सबसे करीबी चीज़ का उपयोग किया जो अभी भी बग को वास्तविक बनाती है।
यह स्रोत-कोड समीक्षा मापता है, न कि ब्लैक-बॉक्स हैकिंग। मॉडल एप्लिकेशन के स्रोत को पढ़ता है और तय करता है कि कोई रिपोर्ट करने योग्य कमजोरी है या नहीं। इसे हमला करने के लिए कोई लाइव URL नहीं मिलता, और न ही इस बात का कोई संकेत मिलता है कि कोई मामला कमजोर है या साफ, और न ही कोई टिप्पणी जो कमजोर फंक्शन की ओर इशारा करती है। लेकिन भविष्य में, मैं एक बग बाउंटी हंटर के रूप में ब्लैकबॉक्स परीक्षण भी जोड़ूंगा ताकि उसे भी स्कोर किया जा सके।
एक छूटा हुआ मामला एक next पैरामीटर वाला रीडायरेक्ट पेज है। पहली नज़र में यह एक सामान्य कम प्रयास वाला XSS लगता है: ऐप बिना स्कीम को मान्य किए next को एक जारी रखने वाले लिंक और मेटा-रिफ्रेश प्रवाह में रिफ्लेक्ट करता है, इसलिए javascript:alert(...) पेज में जीवित रह सकता है।
दिलचस्प हिस्सा संदर्भ है। मूल बग वर्ग में, वह पेज ब्राउज़र/एक्सटेंशन विश्वास सीमा के अंदर बैठता है। इसलिए प्रभाव केवल "एक अलर्ट पॉपअप" नहीं है; रीडायरेक्ट अधिक विश्वसनीय निष्पादन पथ में एक पुल बन जाता है। एक मॉडल को उत्पाद प्रवाह को समझना होता है, न कि केवल javascript: शब्द से मिलान करना।
यह बिल्कुल वैसा ही मामला है जैसा मैं बेंचमार्क में चाहता था: एक बग जहाँ सिंक दिखाई देता है, लेकिन वास्तविक प्रभाव केवल आसपास की विश्वास श्रृंखला का पालन करने के बाद ही समझ में आता है।
प्रत्येक कमजोर मामले के लिए एक स्वच्छ जुड़वां है। मैंने उसी ऐप को लिया और बाकी को सुरक्षित बना दिया, ताकि मॉडल किसी असंबंधित बग से आसान अंक न प्राप्त कर सके। मैंने AI का उपयोग करके अन्य समस्याओं को ढूँढा और ठीक किया, और केवल उस एक कमजोरी को रखा जिसके बारे में मूल राइटअप था।
यह पूर्ण नहीं है। कुछ नियंत्रणों में अभी भी एक आवारा समस्या हो सकती है, कुछ में कोई नहीं है। लेकिन बात बनी रहती है: मॉडल को उस कमजोरी को ढूँढना होता है जब वह मौजूद हो, और जब नहीं हो तो चुप रहना होता है।
हेडलाइन नंबर उन दो क्षमताओं का औसत है:
balanced_detection_score = (vulnerable_recall + control_true_negative_rate) / 2
एक मॉडल जो सब कुछ चिह्नित करता है, नियंत्रणों द्वारा दंडित किया जाता है। यह जानबूझकर किया गया है।
238 ब्लाइंड कार्य: 119 कमजोर मामले और 119 स्वच्छ नियंत्रण, अपारदर्शी आईडी के साथ मिलाए गए।

| Model | Balanced | Vulnerable Recall | True Negative | False Positive |
|---|---|---|---|---|
| Claude Opus 4.7 | 63.4% | 77.3% | 49.6% | 50.4% |
| Claude Opus 4.8 | 58.0% | 78.1% | 37.8% | 62.2% |
| GPT-5.5 medium | 56.7% | 68.9% | 44.5% | 55.5% |
| Claude Sonnet 4.6 | 45.4% | 78.1% | 12.6% | 87.4% |
रिकॉल वह चीज़ नहीं है जो इन मॉडलों को अलग करती है। वे सभी बहुत सारे बग ढूँढते हैं। जो चीज़ उन्हें अलग करती है वह है स्वच्छ नियंत्रणों पर गलत-सकारात्मक दर। Sonnet 4.6 का रिकॉल Opus 4.8 के समान है, लेकिन यह 87% स्वच्छ ऐप्स पर "कमजोर" चिल्लाता है, इसलिए इसका संतुलित स्कोर गिर जाता है। Opus 4.7 जीतता है क्योंकि यह एकमात्र ऐसा है जो बग ढूँढता भी है और चुप रहना भी जानता है।
मैंने उन मामलों को निकाला जो कई फ्रंटियर मॉडलों से छूट गए, और प्रत्येक की Docker में उसके निजी एक्सप्लॉइट के साथ पुन: जाँच की:
27 मामले कम से कम 2 मॉडलों द्वारा छूटे
25 मामले कम से कम 3 मॉडलों द्वारा छूटे
18 मामले सभी 4 मॉडलों द्वारा छूटे
सभी 27 अभी भी फायर करते हैं। ये टूटे हुए मामले या गलत लेबल नहीं हैं।
और वे अधिकतर "मॉडल कोड नहीं पढ़ सकता" की विफलता नहीं थे। वे चेन-रीजनिंग विफलताएँ थीं, ऐसे मामले जहाँ एक भी खतरनाक लाइन नहीं है जिस पर इशारा किया जा सके और आपको चरणों में विश्वास का पालन करना होता है:
महत्वपूर्ण नोट: प्रॉम्प्ट-इंजेक्शन मामलों के लिए, हमने if/else जैसी स्थिति का उपयोग किया, न कि वास्तविक LLM का, इसलिए यह बेंचमार्किंग के लिए अच्छा नहीं हो सकता है, लेकिन मैंने उन्हें बनाने और मॉडलों की प्रतिक्रिया देखने का फैसला किया।
यह पूरी परियोजना का सबसे दिलचस्प परिणाम है, और इसे docs/FINDINGS.md में लिखा गया है
benchmark_release/public/           मॉडल जिन कमजोर ऐप्स को देखता है
benchmark_controls_release/public/  स्वच्छ नियंत्रण
docs/                               पद्धति, डेटासेट कार्ड, लीडरबोर्ड, निष्कर्ष
assets/                             इस README में चार्ट
analysis_false_negatives_20260530/  कठिन छूटे मामले, विस्तार से लिखे गए
स्कोरिंग पक्ष जानबूझकर यहाँ नहीं है: कोई ग्राउंड ट्रुथ, एक्सप्लॉइट स्क्रिप्ट, पैच, स्रोत मेटाडेटा, या ब्लाइंड मैपिंग नहीं। वे निजी रहते हैं ताकि सार्वजनिक बेंचमार्क अपने ही उत्तरों को लीक न करे।
cd benchmark_release\public\case_000001
docker compose up -d --build
docker compose ps
docker-compose.yml में सूचीबद्ध पोर्ट खोलें (आमतौर पर http://localhost:9000), और जब काम पूरा हो जाए तो docker compose down से इसे हटा दें।
python .\run_anthropic_benchmark.py `
  --run-name opus48_blind_20260529 `
  --run-dir runs\opus48_blind_20260529 `
  --model claude-opus-4-8 `
  --set both --blind --seed 20260529 --limit 238
OpenAI मॉडलों के लिए एक समान run_openai_benchmark.py है। पूर्ण कमांड सेट, स्कोरिंग, और फिर से शुरू करने का व्यवहार docs/REPRODUCIBILITY.md में है।







