 es0j/execaslr-ekoparty
प्रूफ़-ऑफ़-कॉन्सेप्ट एक्सप्लॉइट जो ब्रांच टार्गेट बफर और स्पेक्युलेटिव एक्ज़ीक्यूशन का दुरुपयोग करके साइड चैनल के माध्यम से यादृच्छिक पतों को लीक करके Intel CPU पर ASLR को बायपास करता है।

एड्रेस स्पेस लेआउट रैंडमाइज़ेशन एक शमन (mitigation) तकनीक है जिसका उपयोग मेमोरी करप्शन हमलों का फायदा उठाना कठिन बनाने के लिए किया जाता है। उदाहरण के लिए, बफर ओवरफ्लो कमजोरी के परिदृश्य में, एक हमलावर जो रिटर्न ओरिएंटेड प्रोग्रामिंग (ROP) शोषण बनाने की कोशिश करता है, उसे चेन में गैजेट्स के पते जानने की आवश्यकता होती है। यदि शोषित बाइनरी का कोड सेगमेंट रैंडमाइज़्ड है, तो हमलावर के लिए शोषण के लिए सही पता चुनना बहुत कठिन हो जाता है, जिससे शोषण अव्यवहार्य हो जाता है।
निम्नलिखित उदाहरण दिखाता है कि एक पता कैसे रैंडमाइज़ किया जाता है:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
प्रत्येक निष्पादन में मान रैंडमाइज़ होता है:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
अंतिम 12 बिट 149 हमेशा समान होते हैं, लेकिन फ़ंक्शन का स्थान लगभग 0x550000000000 और 0x570000000000 के बीच कहीं भी हो सकता है, जिसका अर्थ है कि 29 बिट रैंडमाइज़ होते हैं, जो 0x200 0000 0000 या 2.2 TB आकार का संभावित एड्रेस स्पेस घेरते हैं।
प्रत्येक निर्देश का प्रसंस्करण एक कठिन कार्य है। एक एकल निर्देश के प्रसंस्करण के कुछ चरण हैं:
CPU में निर्देशों के थ्रूपुट को बढ़ाने के लिए, निर्देश का प्रत्येक कार्य प्रोसेसर की एक विशिष्ट इकाई द्वारा किया जाता है। सभी इकाइयों के समानांतर काम करने से, CPU बहुत अधिक क्लॉक स्पीड पर निष्पादित कर पाता है, यही पाइपलाइन का विचार है।
| ऑपरेशन \ क्लॉक साइकिल | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| फेच | A | B | C | ||
| डिकोडिंग | A | B | C | ||
| निष्पादन | A | B | C |
निर्देशों A B और C का चक्र 1-5 के दौरान निष्पादन। उदाहरण के लिए, चक्र 3 में, पठन, डिकोडिंग और निष्पादन इकाइयाँ एक साथ सक्रिय हैं
हालाँकि, निर्देश एक दूसरे से पूरी तरह स्वतंत्र नहीं होते हैं। उदाहरण के लिए, निम्नलिखित अनुक्रम:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
इस मामले में, निर्देश A सर्वोत्तम स्थिति में केवल चक्र 3 में निष्पादन चरण में समाप्त होगा। हालाँकि, फेच इकाई को यह तय करना होगा कि मेमोरी से अगला निर्देश क्या फेच किया जाए, क्या निर्देश C (mov dl,[rsi]) को छोड़ दिया जाना चाहिए।
इस परिदृश्य में, CPU के पास निर्देश A के समाप्त होने की प्रतीक्षा करने का विकल्प होता है, जो केवल तीसरे क्लॉक चक्र में होगा, ताकि फिर मेमोरी से सही निर्देश फेच किया जा सके, उदाहरण के लिए यदि add ऑपरेशन 0 लौटाता है:
| ऑपरेशन \ क्लॉक साइकिल | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| फेच | A | B | D | |||
| डिकोडिंग | A | B | D | |||
| निष्पादन | A | B | D |
इसका तात्पर्य पाइपलाइन में देरी से है क्योंकि CPU को निर्देश निष्पादित होने तक प्रतीक्षा करनी पड़ती है। इस उदाहरण में देरी एक एकल क्लॉक चक्र है, लेकिन निर्देश add ax,[bx] के लिए मेमोरी ऑपरेशन की आवश्यकता होती है, जो जैसा कि पहले देखा गया, पूरा होने में सैकड़ों चक्र ले सकता है, जिससे प्रोसेसर पर महत्वपूर्ण प्रदर्शन लागत आती है।
एक तेज़ विकल्प सही निष्पादन पथ का "अनुमान" लगाना होगा। CPU अनुमान (speculate) लगा सकता है कि ब्रांच ली गई है या नहीं। उस बिंदु के बाद, निष्पादन अनुमानित पथ से जारी रहता है और मान केवल तभी कमिट होते हैं जब A निर्देश के समाप्त होने के बाद पथ सही साबित होता है। यदि पथ गलत साबित होता है, तो परिणाम छोड़ दिए जाते हैं और स्थिति अनुमान से पहले के बिंदु पर वापस कर दी जाती है।
| ऑपरेशन \ क्लॉक साइकिल | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| फेच | A | B | (S) C | |||
| डिकोडिंग | A | B | (S) C | |||
| निष्पादन | A | B | (S) C |
ले गए पथ को वापस करने में एकमात्र समस्या यह है कि CPU की माइक्रोआर्किटेक्चरल स्थिति को वापस नहीं किया जा सकता है। इसलिए यदि CPU निर्देश C (mov dl,[rsi]) को निष्पादित करने का अनुमान लगाता है, तो rsi द्वारा इंगित डेटा कैश में स्थानांतरित हो जाएगा। इस प्रभाव को बाद में साइड चैनल हमले का उपयोग करके मापा जा सकता है।
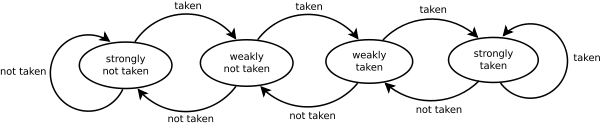
2-बिट सशर्त प्रेडिक्टर। https://en.wikipedia.org/wiki/Branch_predictor
न केवल सशर्त निर्देशों की भविष्यवाणी की जानी चाहिए, बल्कि अप्रत्यक्ष ब्रांचों की भी। CPU के पास call [rdi] जैसे निर्देश के गंतव्यों का अनुमान लगाने के लिए एक तंत्र होना चाहिए।
स्पेक्ट्रे v2 कमजोरी दिखाती है कि अन्य प्रक्रियाओं में ट्रांज़िएंट निष्पादन प्राप्त करने के लिए अप्रत्यक्ष प्रेडिक्टर का शोषण करना संभव है:
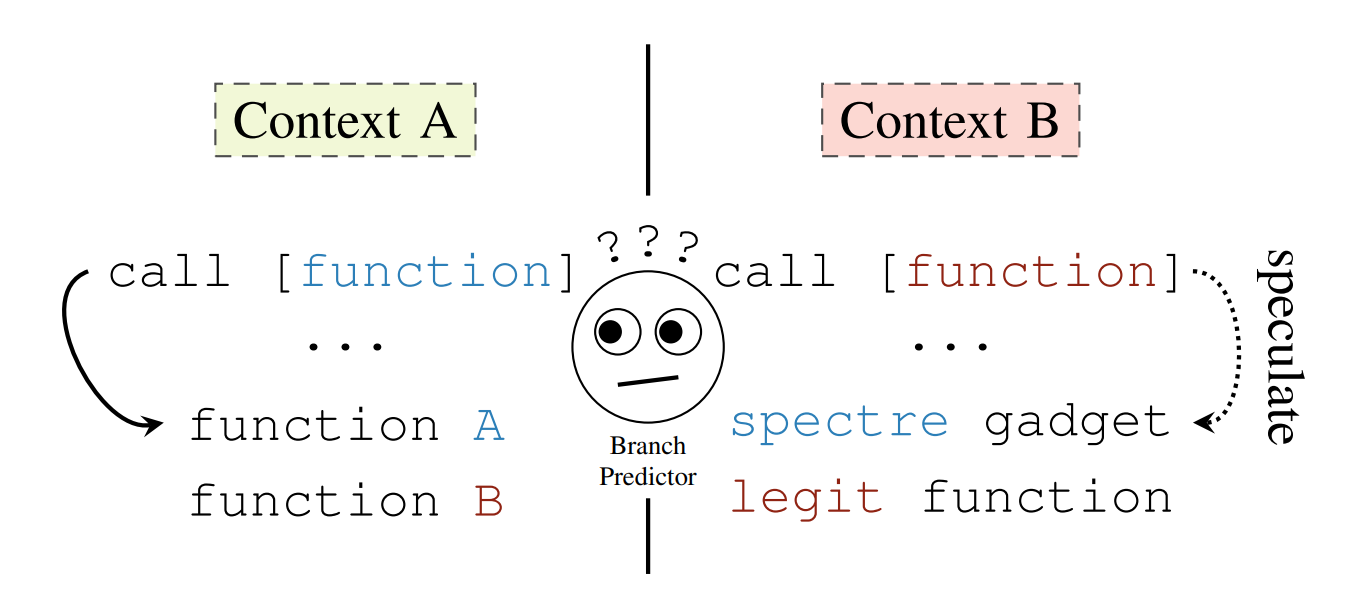 से लिया गया: https://spectreattack.com/spectre.pdf
जब संदर्भ A में कॉल निर्देश को संदर्भ B में एक अन्य कॉल के समान वर्चुअल एड्रेस पर रखा जाता है, तो हमलावर CPU को संदर्भ B में हमलावर द्वारा चुनी गई स्थिति पर कोड निष्पादित करने के लिए प्रशिक्षित कर सकता है, जो रिटर्न ओरिएंटेड प्रोग्रामिंग (ROP) के समान एक कोड पुन: उपयोग हमला है।
लक्षित पीड़ित के पास "स्पेक्ट्रे गैजेट" के रूप में जाना जाने वाला कोड का एक टुकड़ा होना चाहिए जो साइड चैनल हमले का उपयोग करके एक रहस्य (secret) लीक करने में सक्षम हो। एक सफल स्पेक्ट्रे हमले के लिए, हमलावर को स्पेक्ट्रे गैजेट का स्थान भी पता होना चाहिए। इसलिए, उपयोगकर्ता-से-उपयोगकर्ता हमलों में, पीड़ित को ASLR से सुरक्षित रखना इस प्रकार के हमले के लिए एक शमन हुआ करता था। हालाँकि, Jump Over ASLR जैसे माइक्रोआर्किटेक्चरल हमलों का उपयोग करके ASLR निकालने की तकनीकें भी मौजूद हैं। हालाँकि, इस तकनीक में लीक किए गए बिट्स की मात्रा के बारे में कुछ सीमाएँ हैं, क्योंकि यह ASLR को बायपास करने के लिए डायरेक्ट प्रेडिक्टर पर टकराव (collision) पर निर्भर करती है।
इस प्रेडिक्टर के आंतरिक तंत्र नीचे दिखाए गए हैं:
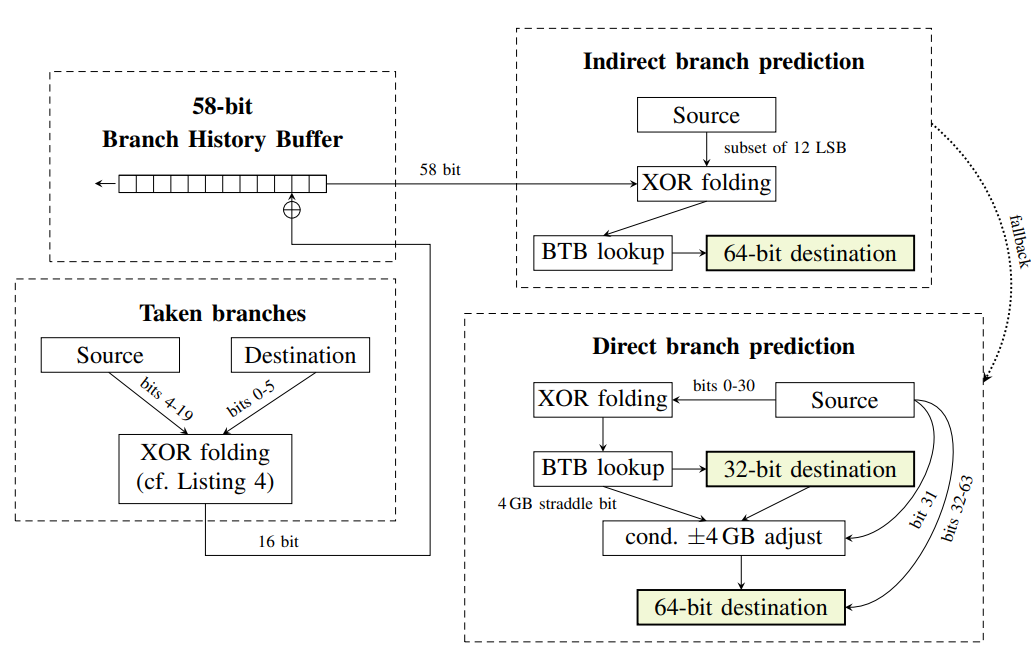
से लिया गया: https://spectreattack.com/spectre.pdf
इनमें से कुछ घटक हैं:
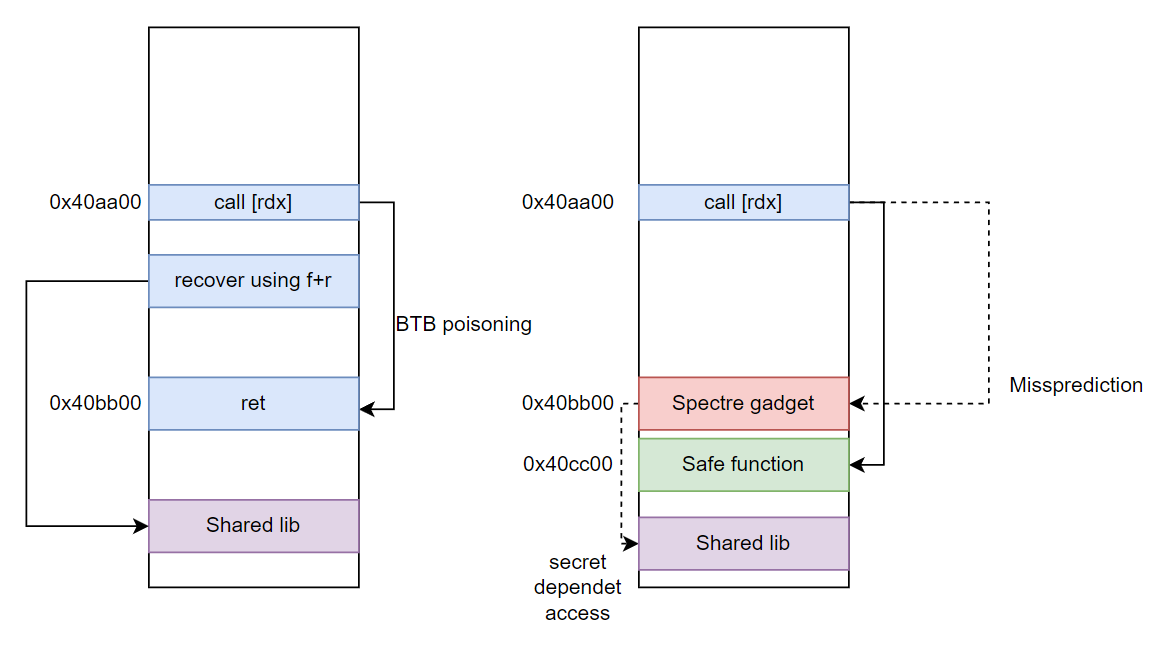
क्लासिकल स्पेक्ट्रे v2 हमले का लेआउट इस प्रकार है:
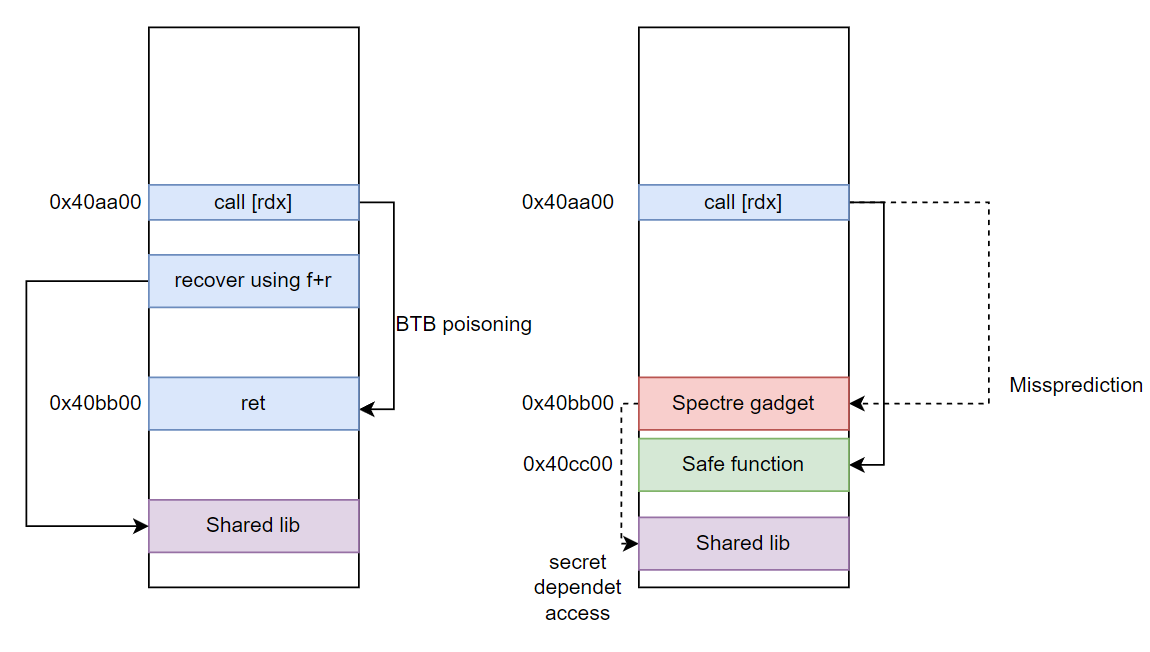
getenv + secret[0]*4096 निष्पादित करता है, लिबसी को साझा मेमोरी के रूप में उपयोग करके स्थिति 0 पर रहस्य का मान लीक कर सकता है।