 comerc/cve-2025-68664
विस्तृत खुलासा CVE-2025-68664 का, LangChain core में एक गंभीर डिसीरियलाइज़ेशन भेद्यता जो निर्मित प्रॉम्प्ट और सीरियलाइज़ेशन प्रवाहों के माध्यम से गुप्त जानकारी के बहिर्वाह और संभावित RCE की अनुमति देती है।

लेखक: यार्डेन पोरात
Cyata अनुसंधान: LangChain में LangGrinch भेद्यता
प्रकाशित: https://cyata.ai/blog/langgrinch-langchain-core-cve-2025-68664/
कल LangChain ने एक गंभीर चेतावनी जारी की जिसमें मैंने langchain-core में पाई गई भेद्यता के बारे में बताया: CVE-2025-68664 / GHSA-c67j-w6g6-q2cm।
इस वर्ष की शुरुआत में, मेरा शोध "Vault Fault" कार्य में सीक्रेट मैनेजरों को हैक करने पर केंद्रित था – ऐसी प्रणालियाँ जो विशेष रूप से आपके सबसे संवेदनशील क्रेडेंशियल्स के चारों ओर सुरक्षा सीमा के रूप में डिज़ाइन की गई हैं। एक निष्कर्ष बार-बार दोहराया गया: जब कोई प्लेटफ़ॉर्म हमलावर द्वारा निर्मित डेटा को भरोसेमंद संरचना के रूप में संसाधित करता है, तो वह सीमा जल्दी टूट जाती है। इस बार, "टूटने" वाली प्रणाली आपका सीक्रेट मैनेजर नहीं है। यह एजेंट फ्रेमवर्क है जो उनका उपयोग कर सकता है।
यह भेद्यता विशेष ध्यान देने योग्य क्यों है:
यह कोर में है। यह कोई विशिष्ट टूल बग नहीं है, कोई एकीकरण का चरम मामला नहीं है, और "किसी सामुदायिक पैकेज ने कुछ अजीब किया" नहीं है। असुरक्षित API (dumps() / dumpd()) langchain-core में ही हैं।
प्रभाव का दायरा बहुत बड़ा है। डाउनलोड की मात्रा के अनुसार, langchain आज दुनिया में सबसे व्यापक रूप से तैनात AI फ्रेमवर्क घटकों में से एक है। दिसंबर 2025 के अंत तक, सार्वजनिक पैकेज टेलीमेट्री सैकड़ों मिलियन इंस्टॉलेशन दिखाती है, pepy.tech लगभग 847 मिलियन कुल डाउनलोड और pypistats पिछले महीने में लगभग 98 मिलियन डाउनलोड दिखाता है।
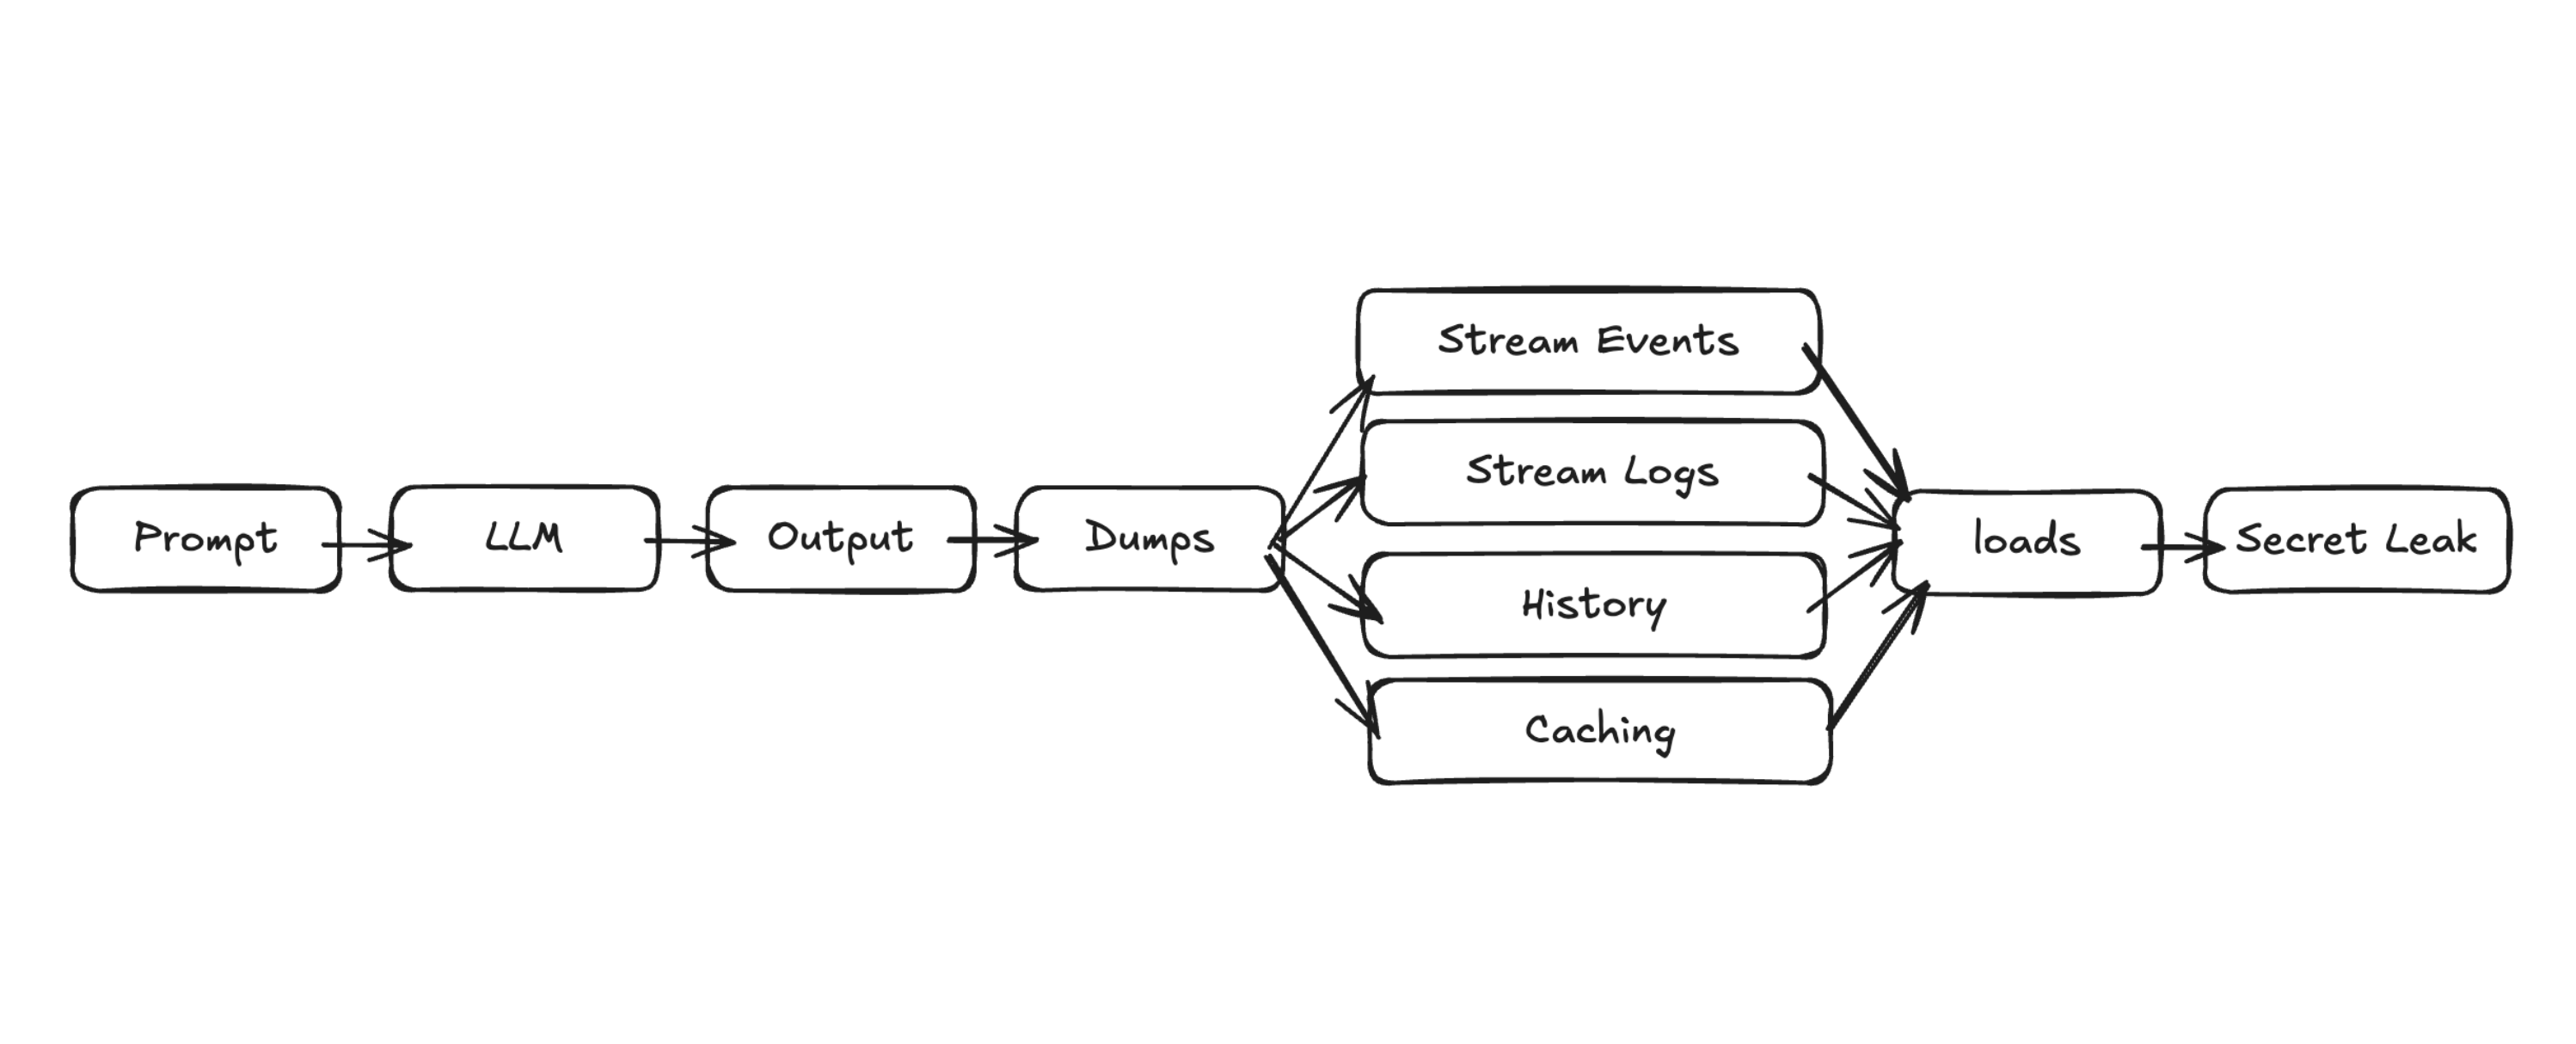
एक प्रॉम्प्ट कई तंत्र चला सकता है। यहाँ सबसे सामान्य वास्तविक दुनिया का रास्ता यह नहीं है कि "हमलावर आपको एक सीरियलाइज़्ड ब्लॉब भेजता है और आप load() कॉल करते हैं।" यह अधिक सूक्ष्म है: LLM आउटपुट additional_kwargs या response_metadata जैसे फ़ील्ड को प्रभावित कर सकते हैं, और ये फ़ील्ड सीरियलाइज़ हो सकते हैं और बाद में सामान्य फ्रेमवर्क फ़ंक्शंस जैसे स्ट्रीमिंग लॉग/इवेंट के माध्यम से डीसीरियलाइज़ हो सकते हैं। सरल शब्दों में, इसका मतलब है कि एक एकल टेक्स्ट प्रॉम्प्ट एक एक्सप्लॉइट शुरू कर सकता है जो अप्रत्याशित रूप से जटिल आंतरिक पाइपलाइन में कैस्केड होता है।
इसे पढ़ने से पहले, पैच पहले ही संस्करण 1.2.5 और 0.3.81 में जारी किए जा चुके हैं। यदि आप प्रोडक्शन में LangChain का उपयोग कर रहे हैं, तो यह जितना लगता है उससे अधिक जटिल है; कृपया जितनी जल्दी हो सके अपडेट करें।
LangChain एक विशेष आंतरिक सीरियलाइज़ेशन प्रारूप का उपयोग करता है जहाँ 'lc' मार्कर वाले शब्दकोश LangChain ऑब्जेक्ट का प्रतिनिधित्व करते हैं। भेद्यता यह थी कि dumps() और dumpd() उपयोगकर्ता-नियंत्रित शब्दकोशों को सही ढंग से एस्केप नहीं करते थे जिनमें आरक्षित कुंजी 'lc' शामिल थी।
इस प्रकार, जैसे ही हमलावर LangChain ऑर्केस्ट्रेशन लूप को 'lc' कुंजी सहित सामग्री को सीरियलाइज़ और बाद में डीसीरियलाइज़ करने के लिए मजबूर कर सकता है, वह एक असुरक्षित मनमाना ऑब्जेक्ट इंस्टैंशिएट कर सकता है, संभावित रूप से हमलावरों के अनुकूल कई रास्ते शुरू कर सकता है।
चेतावनी में 12 अलग-अलग असुरक्षित प्रवाह सूचीबद्ध हैं जो वास्तविक दुनिया के उपयोग के मामलों जैसे मानक इवेंट स्ट्रीमिंग, लॉगिंग, संदेश इतिहास/मेमोरी, या कैशिंग में अत्यंत सामान्य हैं:
सबसे विनाशकारी परिणामों में शामिल हैं:
पर्यावरण चर से सीक्रेट निकालना। चेतावनी नोट करती है कि यह secrets_from_env=True के साथ डीसीरियलाइज़ करने पर होता है। उल्लेखनीय रूप से, कल तक यह डिफ़ॉल्ट था। 🙂
पूर्व-अनुमोदित नामस्थानों (langchain_core, langchain_openai, langchain_aws, langchain_anthropic…) में ऑब्जेक्ट इंस्टैंशिएट करना, संभावित रूप से कंस्ट्रक्टरों में साइड इफ़ेक्ट (नेटवर्क कॉल, फ़ाइल ऑपरेशन आदि) उत्पन्न करना।
कुछ शर्तों के तहत, LangChain ऑब्जेक्ट का इंस्टैंशिएशन मनमाना कोड निष्पादन की ओर ले जा सकता है।
इसे CWE-502: अविश्वसनीय डेटा का डीसीरियलाइज़ेशन के तहत वर्गीकृत किया गया है, जिसमें CVSS CNA स्कोर 9.3 (गंभीर) है।
क्रिसमस की पूर्व संध्या पर, मैं सबसे कम उत्सवपूर्ण काम कर रहा था: सीरियलाइज़ेशन कोड को देख रहा था और पूछ रहा था "रुको… इसे भरोसेमंद क्यों माना जाता है?"
सुरक्षा अनुसंधान अक्सर बाहर से नाटकीय लगता है। वास्तव में यह आमतौर पर सावधानीपूर्वक पढ़ना, छोटी परिकल्पनाएँ और "यह अजीब है" क्षणों का धीमा संचय होता है।
यह वैसे ही शुरू हुआ जैसे Cyata में कई चीज़ें: एक सरल प्रश्न के साथ जो हम AI स्टैक का वास्तविक जोखिम मूल्यांकन करते समय लगातार पूछते हैं:
AI अनुप्रयोगों में विश्वास की सीमाएँ कहाँ हैं, और क्या डेवलपर्स वास्तव में जानते हैं कि ये सीमाएँ कहाँ हैं?
LangChain एक शक्तिशाली फ्रेमवर्क है, और अधिकांश आधुनिक फ्रेमवर्क की तरह, इसे जटिल संरचित डेटा स्थानांतरित करना होता है: संदेश, टूल कॉल, स्ट्रीमिंग इवेंट, ट्रेसेस, कैश और "रनेबल्स"।
पिछले शोध को देखते हुए, वहाँ पहले से ही LangChain टूल और एकीकरण का व्यापक शोध था, लेकिन मुख्य लाइब्रेरी में बहुत कम खोजें थीं।
मैंने शोध को उल्टा काम करके शुरू किया। दिलचस्प स्थानों (सिंक) को ढूँढना, फिर यह पता लगाना कि हमलावर उन तक कैसे पहुँच सकता है। डीसीरियलाइज़ेशन एक स्पष्ट लक्ष्य था।
मुझे कुछ महत्वपूर्ण खोजने में काफी समय लगा। लेकिन कुछ समय बाद मैंने पाया कि, हमलावर द्वारा नियंत्रित डीसीरियलाइज़ेशन प्रिमिटिव मानते हुए, मैं एक ब्लाइंड SSRF चला सकता था जिसका उपयोग पर्यावरण चर को बाहर निकालने के लिए किया जा सकता था (जल्द ही विस्तार से बताया जाएगा)। चूँकि परिणाम सीक्रेट्स के बहिर्गमन तक सीमित था, न कि मेरे मुख्य लक्ष्य RCE तक, मैंने डीसीरियलाइज़ेशन का ऑडिट जारी रखा और अपना समय लिया।
बग खराब कोड का एक टुकड़ा नहीं था, यह कोड की कमी था। dumps() बस उपयोगकर्ता-नियंत्रित शब्दकोशों को एस्केप नहीं करता था जिनमें 'lc' कुंजियाँ थीं। सीरियलाइज़ेशन पथ में लापता एस्केप, डीसीरियलाइज़ेशन में नहीं।
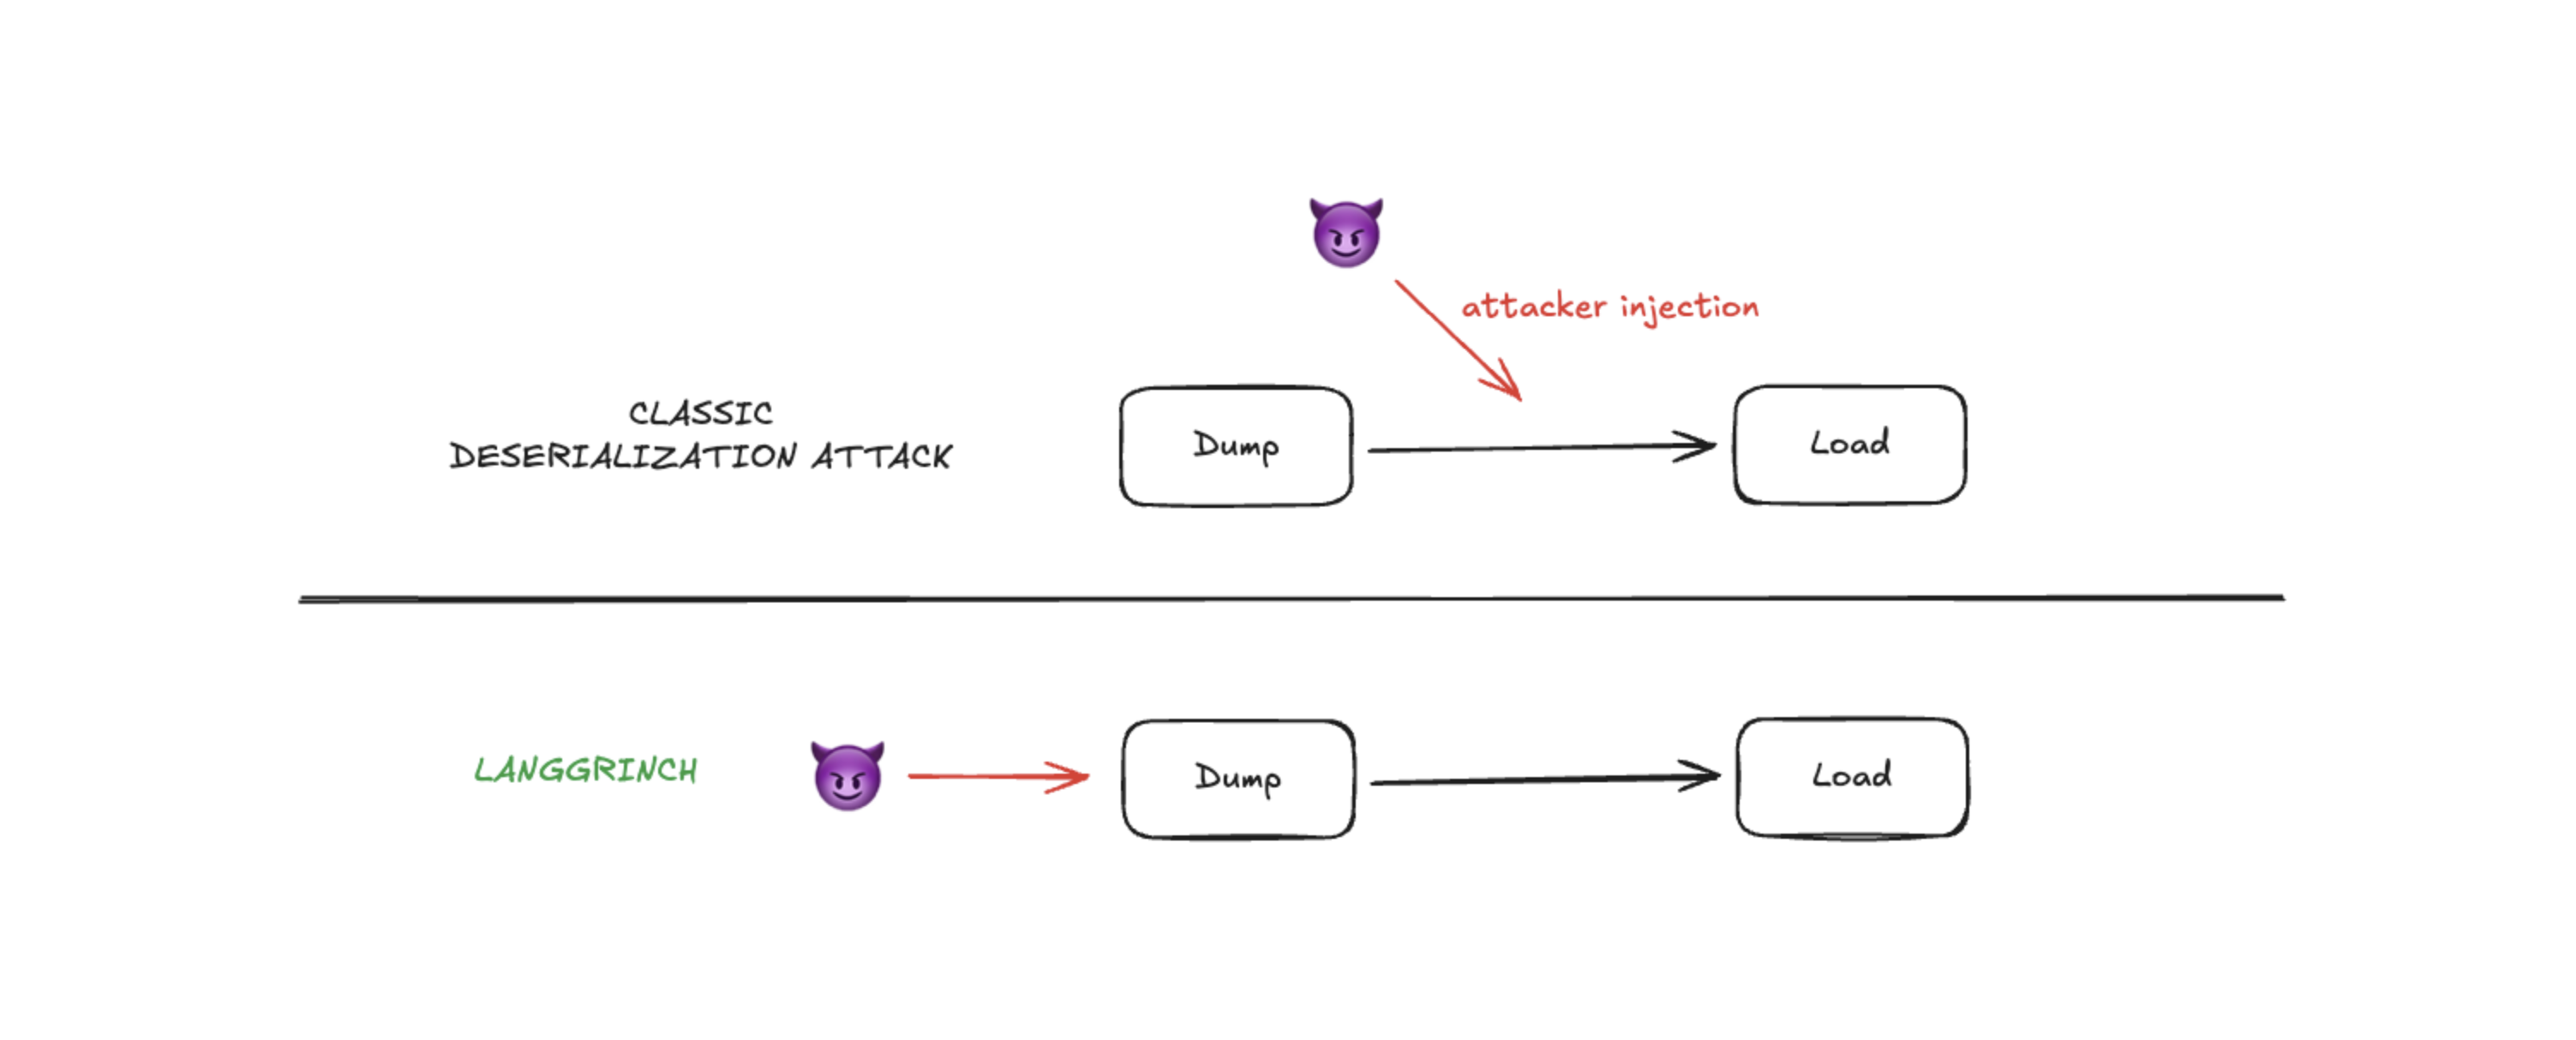
कुछ गलत देखना बहुत आसान है, कुछ की कमी देखना बहुत कठिन, खासकर जब आप load() का ऑडिट कर रहे हों, dumps() का नहीं। सबसे अधिक सावधानीपूर्वक समीक्षित AI फ्रेमवर्क में से एक में। ढाई साल।
वहाँ से, शोध एक संरचित अभ्यास बन गया:
यह पहचानना कि अविश्वसनीय सामग्री (मुख्य रूप से मनमाना शब्दकोश) सीरियलाइज़ेशन में कहाँ प्रवेश करती है (LLM आउटपुट, प्रॉम्प्ट इंजेक्शन, उपयोगकर्ता इनपुट, बाहरी उपकरण, निकाले गए दस्तावेज़)।
यह पहचानना कि ये सीरियलाइज़ किए गए डेटा कब डीसीरियलाइज़ होते हैं।
यह पहचानना कि मनमाना ऑब्जेक्ट इंस्टैंशिएशन से हमलावर क्या हासिल कर सकता है।
उस समय, मुख्य खोज जिम्मेदार रिपोर्ट के लिए पर्याप्त स्पष्ट और कार्रवाई योग्य थी: 'lc' कुंजी वाले शब्दकोशों के आसपास dumps() / dumpd() में एस्केपिंग में अंतर था।
चेतावनी ने बाद में वही कब्जा कर लिया जो हम अक्सर व्यवहार में देखते हैं: additional_kwargs और response_metadata जैसे फ़ील्ड LLM आउटपुट और प्रॉम्प्ट इंजेक्शन से प्रभावित हो सकते हैं, और ये फ़ील्ड कई प्रवाहों में सीरियलाइज़-डीसीरियलाइज़ हो सकते हैं।
LangChain टीम की प्रशंसा में: प्रतिक्रिया और उसके बाद की कार्रवाई निर्णायक थी, न केवल बग को पैच करना बल्कि उन डिफ़ॉल्ट को कसना भी जो उस दुनिया के लिए बहुत अधिक अनुमत थे जिसमें हम अब रह रहे हैं।
LangChain प्रोजेक्ट ने इस खोज के लिए $4,000 USD का इनाम देने का निर्णय लिया। huntr के अनुसार, वह प्लेटफ़ॉर्म जहाँ LangChain अपना बग बाउंटी प्रोग्राम चला रहा था, यह प्रोजेक्ट में अब तक दी गई सबसे बड़ी राशि होगी, अब तक का इनाम $125 तक था।
LangChain कुछ ऑब्जेक्ट को संरचित शब्दकोश प्रारूप का उपयोग करके सीरियलाइज़ करता है। 'lc' कुंजी का उपयोग आंतरिक रूप से यह इंगित करने के लिए किया जाता है "यह एक सीरियलाइज़्ड LangChain संरचना है," न कि केवल मनमाना उपयोगकर्ता डेटा।
यह एक सामान्य पैटर्न है, लेकिन यह एक सुरक्षा इनवेरिएंट बनाता है: कोई भी उपयोगकर्ता डेटा जिसमें 'lc' हो सकता है, उसे सावधानी से संभाला जाना चाहिए। अन्यथा, हमलावर एक शब्दकोश बना सकता है जो आंतरिक ऑब्जेक्ट "जैसा दिखता है" और डीसीरियलाइज़र को धोखा देकर उसे मान दे सकता है।
पैच अद्यतन दस्तावेज़ में इरादे को स्पष्ट करता है: सीरियलाइज़ेशन के दौरान, 'lc' कुंजी वाले सरल शब्दकोशों को लपेटकर एस्केप किया जाता है।
