 cainiao159357/cve-2023-2598
CVE-2023-2598 के लिए तकनीकी विश्लेषण और प्रूफ-ऑफ-कॉन्सेप्ट एक्सप्लॉइट, io_uring के बफर रजिस्ट्रेशन में लिनक्स कर्नेल विशेषाधिकार वृद्धि (privilege escalation) की एक कमजोरी, जिसमें Compound Page और फोलियो (folio) आंतरिक संरचनाओं का विस्तृत विवरण दिया गया है।

CVE-2023-2598 के माध्यम से लिनक्स में Compound Page और folio तंत्र को समझें, फिर देखें कि क्या हम 1day CVE-2023-6560 का उपयोग कर सकते हैं।
मेमोरी लगातार बढ़ रही है, लेकिन लिनक्स का मूल पृष्ठ आवंटन इकाई 4K अपर्याप्त होता जा रहा है, इसलिए इस समस्या को हल करने के लिए कम्पाउंड पेज प्रस्तुत किए गए। कम्पाउंड पेज वास्तव में कई पृष्ठों को एक सेट के रूप में लेना है, दो या अधिक भौतिक रूप से सन्निहित पृष्ठों को एक इकाई में जोड़ना, जिसे कई मायनों में एक ही बड़े पृष्ठ के रूप में देखा जा सकता है। इनका उपयोग अक्सर बड़े पृष्ठ बनाने के लिए किया जाता है, जैसे कि hugetlbfs या ट्रांसपेरेंट ह्यूज पेज (transparent huge pages) उपप्रणाली में, लेकिन ये अन्य परिदृश्यों में भी दिखाई देते हैं। कम्पाउंड पेज का उपयोग अनाम मेमोरी के रूप में या कर्नेल में बफ़र्स के रूप में किया जा सकता है; हालांकि, ये पेज कैश में प्रकट नहीं हो सकते, पेज कैश केवल एकल पृष्ठों को संभाल सकता है।
कम्पाउंड पृष्ठ आवंटित करना alloc_pages() को कॉल करना और __GFP_COMP आवंटन फ़्लैग और 1 से अधिक पृष्ठ फ़्रेम संख्या सेट करना है, यानी ऑर्डर कम से कम 1 होना चाहिए। यह कम्पाउंड पेज कार्यान्वयन तंत्र द्वारा निर्धारित होता है।
ध्यान दें कि कम्पाउंड पेज हमेशा भौतिक रूप से सन्निहित होते हैं
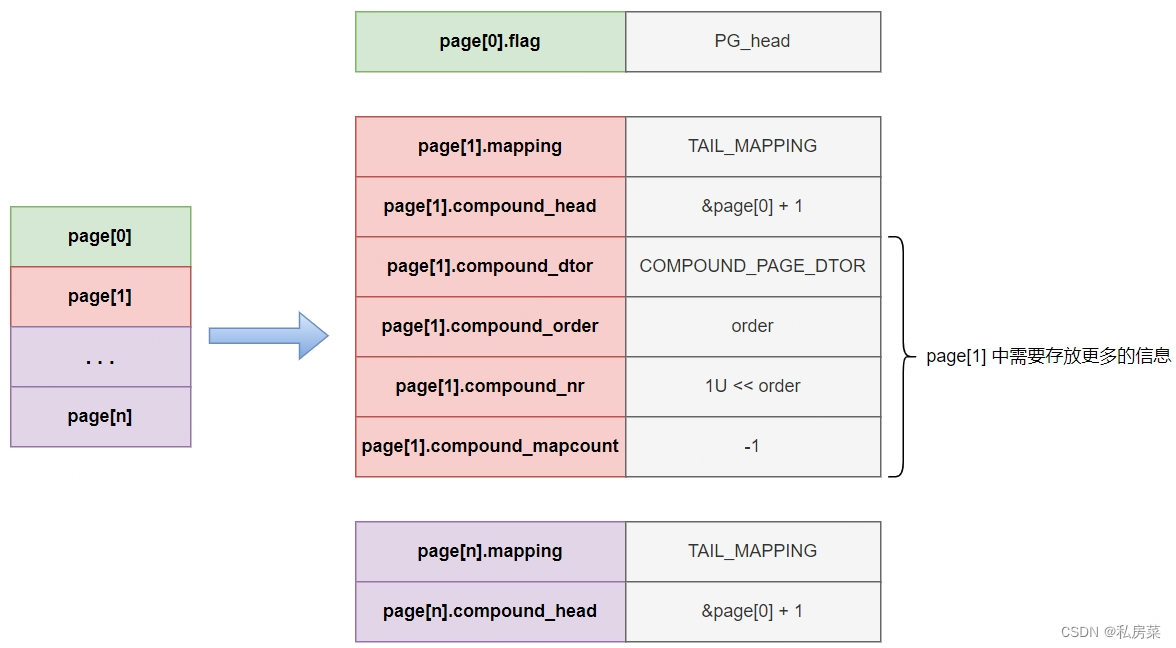
पहले पृष्ठ के फ़्लैग में PG_head चिह्नित होता है, जो इसे कम्पाउंड पेज शीर्ष पृष्ठ के रूप में दर्शाता है;
उसके बाद के सभी पृष्ठों में दो गुण कॉन्फ़िगर किए जाते हैं: mapping और compound_head, और compound_head के माध्यम से पुष्टि की जाती है कि यह अंतिम पृष्ठ है या शीर्ष पृष्ठ, विस्तार के लिए compound_head() फ़ंक्शन देखें;
दूसरे पृष्ठ में अधिक कम्पाउंड पेज जानकारी संग्रहीत होती है, यही कारण है कि कम्पाउंड पेज का ऑर्डर कम से कम 1 होता है;
static inline unsigned long _compound_head(const struct page *page)
{
        unsigned long head = READ_ONCE(page->compound_head);

        if (unlikely(head & 1))
                return head - 1;
        return (unsigned long)page;
}
इस प्रकार यह फ़ील्ड न केवल फ़्लैग शामिल करता है, बल्कि शीर्ष पृष्ठ की ओर एक पॉइंटर भी शामिल करता है।
इसलिए जब कोई page प्राप्त होता है तो आसानी से जांचा जा सकता है कि यह कम्पाउंड पेज है या नहीं, और यदि है तो यह शीर्ष पृष्ठ है या अंतिम पृष्ठ। लेकिन एक महत्वपूर्ण जानकारी अभी भी गायब है, वह है इस कम्पाउंड पेज का आकार। यदि कम्पाउंड पेज का आकार ज्ञात नहीं है, तो जब इस कम्पाउंड पेज को मुक्त किया जाएगा, तो आकार जानना आवश्यक होगा। यह सारी जानकारी पहले अंतिम पृष्ठ के lru फ़ील्ड में संग्रहीत होती है; कम्पाउंड पेज के आकार (order) को पहले पॉइंटर प्रकार में बदलकर lru.prev में संग्रहीत किया जाता है, और विनाशक फ़ंक्शन को lru.next में संग्रहीत किया जाता है।
जब तक शीर्ष पृष्ठ और कम्पाउंड पेज का आकार ज्ञात हो, तब तक इस बड़े पृष्ठ को सही ढंग से मुक्त किया जा सकता है, क्योंकि कम्पाउंड पेज भौतिक रूप से सन्निहित होते हैं।
संरचना नीचे दिए गए चित्र में दिखाई गई है
folio को page के एक आवरण के रूप में देखा जा सकता है, बिना किसी ओवरहेड के। folio एकल पृष्ठ या कम्पाउंड पेज हो सकता है।
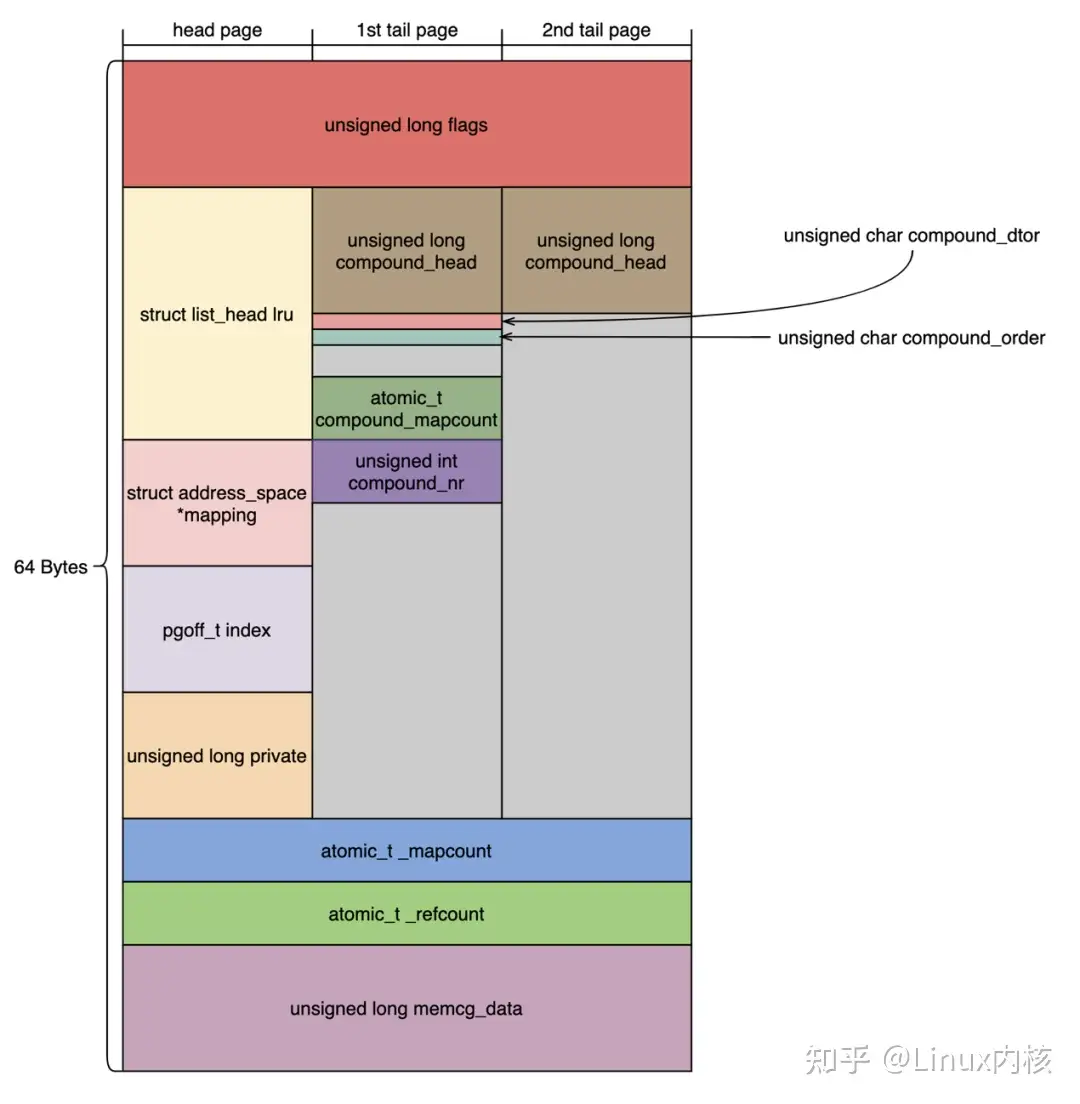
ऊपर दिया गया चित्र page संरचना का [योजनाबद्ध आरेख] है, 64 बाइट्स में flags, lru, mapping, index, private, {ref_, map_}count, memcg_data आदि जानकारी प्रबंधित होती है। जब page एक कम्पाउंड पेज होता है, तो उपरोक्त flags आदि जानकारी head page में होती है, और tail page compound_{head, mapcount, order, nr, dtor} आदि जानकारी प्रबंधित करने के लिए पुनः उपयोग करता है।
struct folio {
        /* private: don't document the anon union */
        union {
                struct {
        /* public: */
                        unsigned long flags;
                        struct list_head lru;
                        struct address_space *mapping;
                        pgoff_t index;
                        void *private;
                        atomic_t _mapcount;
                        atomic_t _refcount;
#ifdef CONFIG_MEMCG
                        unsigned long memcg_data;
#endif
        /* private: the union with struct page is transitional */
                };
                struct page page;
        };
};
folio की संरचना परिभाषा में, flags, lru आदि जानकारी page से पूरी तरह मेल खाती है, इसलिए इसका page के साथ union किया जा सकता है। इस प्रकार सीधे folio->flags का उपयोग किया जा सकता है, folio->page->flags के बजाय।
#define page_folio(p)           (_Generic((p),                          \
        const struct page *:    (const struct folio *)_compound_head(p), \
        struct page *:          (struct folio *)_compound_head(p)))

#define nth_page(page,n) ((page) + (n))
#define folio_page(folio, n)    nth_page(&(folio)->page, n)
पहली नज़र में page_folio थोड़ा भ्रमित कर सकता है, लेकिन यह इसके बराबर है:
switch (typeof(p)) {
  case const struct page *:
    return (const struct folio *)_compound_head(p);
  case struct page *:
    return (struct folio *)_compound_head(p)));
}
page_folio मैक्रो के माध्यम से, यह पता चलता है कि folio वास्तव में एक कम्पाउंड पेज का head page है। जब folio को page में परिवर्तित किया जाता है, तो folio->page का उपयोग head page प्राप्त करने के लिए किया जाता है, और folio_page(folio, n) का उपयोग tail page प्राप्त करने के लिए किया जा सकता है।
तो folio की आवश्यकता क्यों है? अधिकतर, यह विकास और दक्षता के लिए है। यदि folio नहीं है, तो फ़ंक्शन के अंदर यह निर्धारित नहीं किया जा सकता कि वर्तमान page head page है या नहीं, इसलिए _compound_head को कॉल करना होगा। यदि निष्पादन पथ अधिक हैं, तो पथ के प्रत्येक फ़ंक्शन में _compound_head का उपयोग करने से दक्षता प्रभावित होगी। लेकिन यदि फ़ंक्शन केवल struct folio * पैरामीटर स्वीकार करता है, तो यह folio head page की ओर इशारा करेगा, इसलिए फ़ंक्शन को _compound_head को कॉल करने की आवश्यकता नहीं है।
इसलिए मुख्य रूप से तीन उपयोग हैं:
बहुत अधिक अनावश्यक compound_head कॉल को कम करना।
डेवलपर्स को संकेत देना: folio देखकर, यह समझा जा सकता है कि यह head page है।
संभावित tail page से उत्पन्न बग को ठीक करना।
io_uring के io_uring_register_buffer में, निम्नलिखित तर्क है
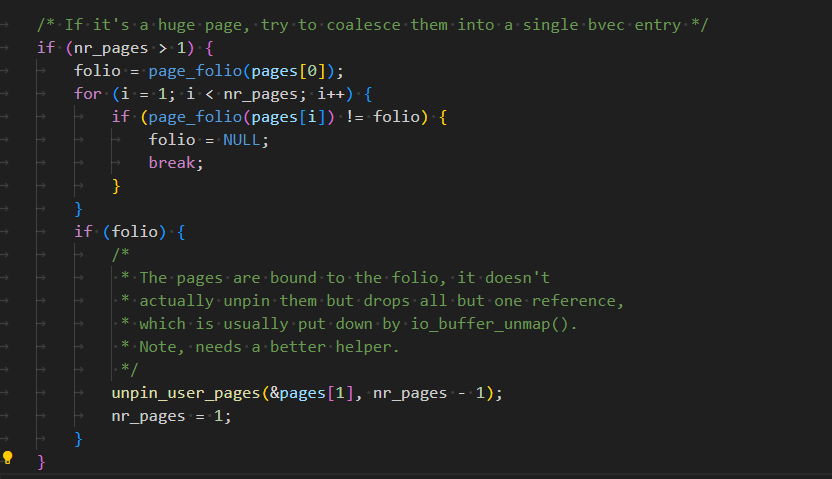
जब उपयोगकर्ता-मोड द्वारा पास किया गया पृष्ठ 1 से अधिक है, तो io_uring जांच करेगा कि पास किया गया buffer folio है या नहीं। जांच विधि page_folio() का उपयोग करके page[i] का head page प्राप्त करना है। यदि page[i] का head page page[0] के बराबर है, तो इसे एक ही कम्पाउंड पेज तालिका माना जाता है।
सामान्यत: यह प्रसंस्करण समस्या नहीं है, लेकिन एक विशेष स्थिति है: यदि उपयोगकर्ता-मोड mmap का उपयोग करके एक भौतिक पृष्ठ तालिका को सन्निहित आभासी पते पर मैप करता है, तो यह भी इस स्थिति को पूरा करेगा, और अंततः इस शाखा में प्रवेश करेगा
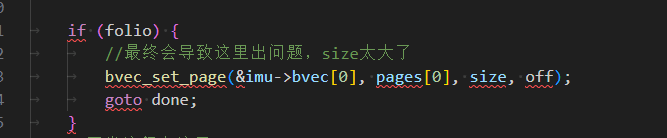
इस समय, उपयोगकर्ता-मोड ने केवल एक भौतिक पृष्ठ आवंटित किया है, लेकिन अंतिम size सन्निहित आभासी पतों का size है, जिससे size वास्तव में आवंटित भौतिक पता क्षेत्र से बड़ा हो सकता है। अंततः अतिप्रवाह पढ़ने/लिखने का कारण बनता है।
cred को स्प्रे करें, फिर इस सीमा-पार पढ़ने/लिखने इंटरफ़ेस का उपयोग करके uid को संशोधित करें।
इंटरनेट पर उस exp की तुलना में, यह exp uid को बदलता है, इसलिए कोई पता निर्भरता नहीं है। यदि यह भेद्यता मौजूद है, तो इस exp का उपयोग किया जा सकता है।
#define _GNU_SOURCE
#include <stdio.h>
#include <sys/mman.h>
#include <string.h>
#include <liburing.h>
#include <stdio.h>
#include <fcntl.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <unistd.h>
#include <mqueue.h>
#include <sys/syscall.h>
#include <unistd.h>
#include <sys/resource.h>
#include <sys/socket.h>
#include <netinet/in.h>
#include <netinet/tcp.h>
#include <assert.h>
