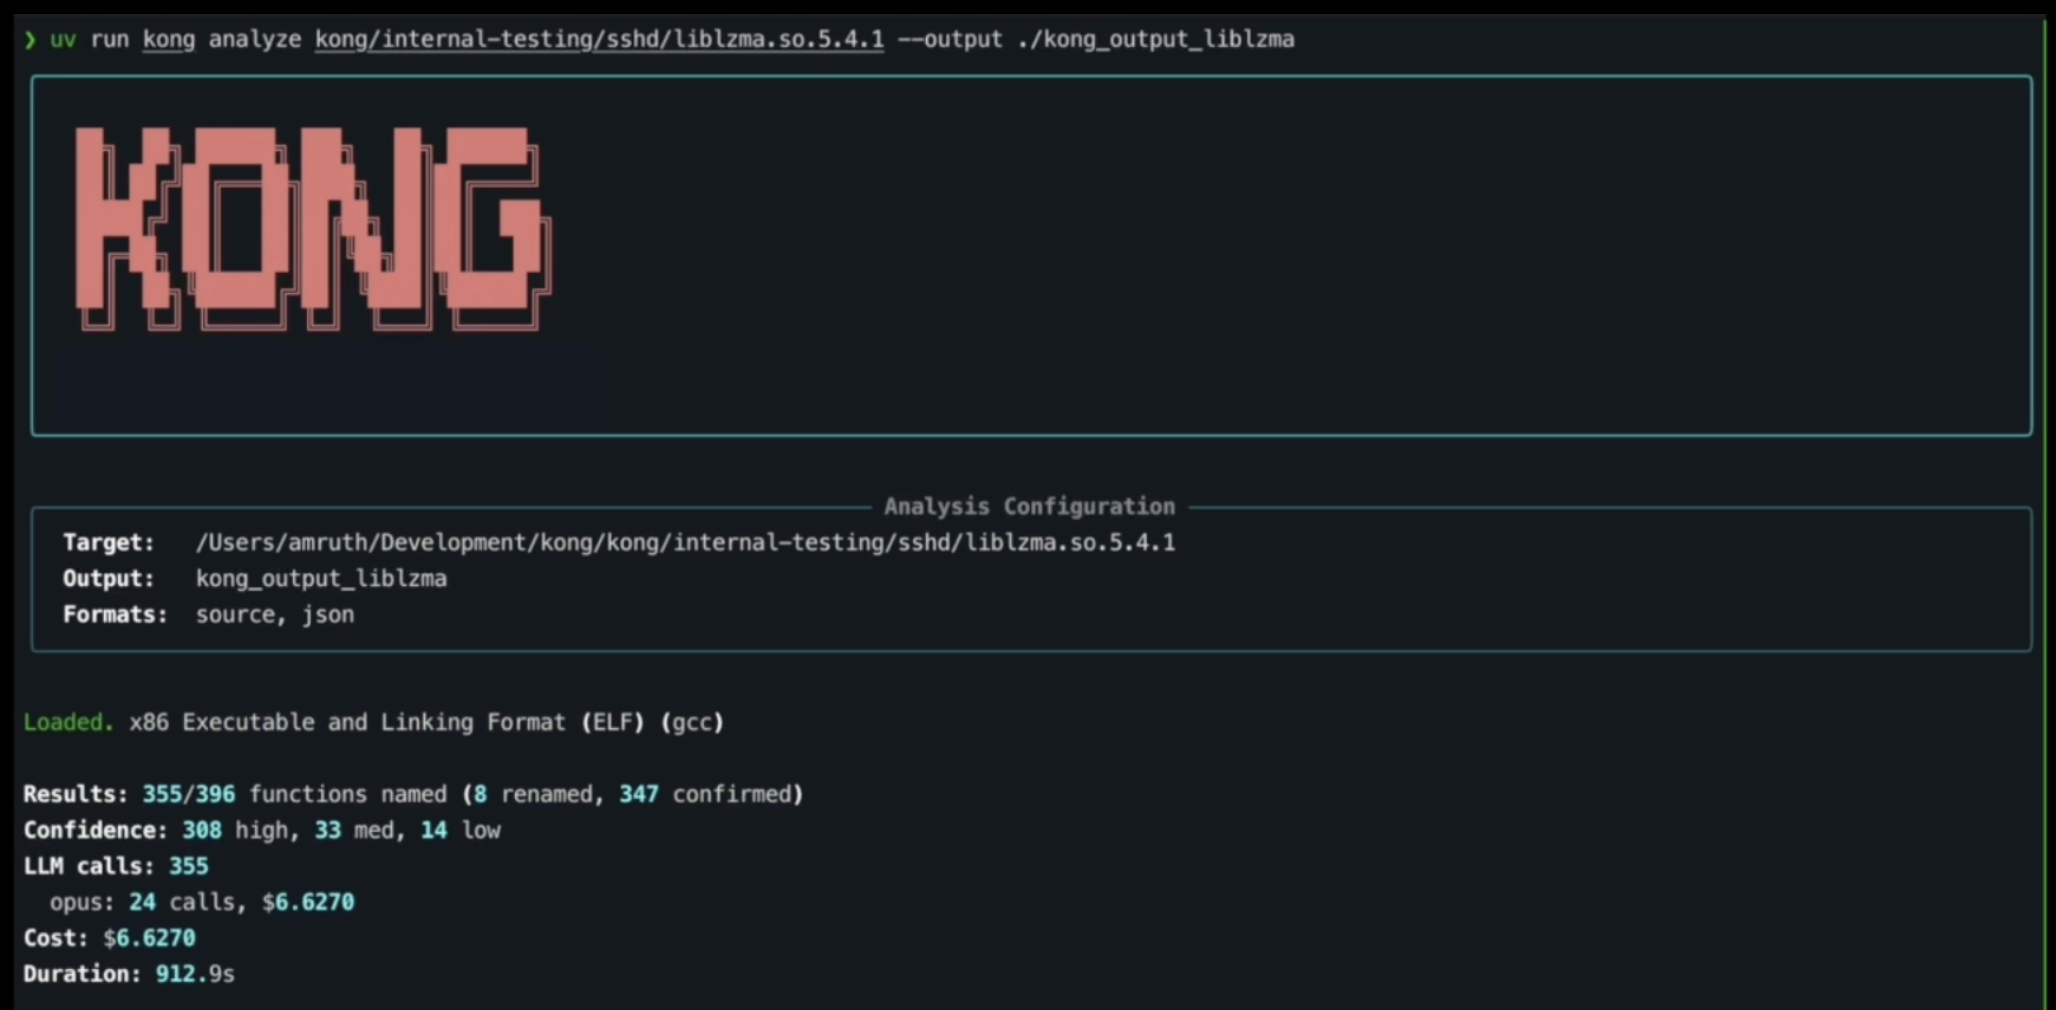
दुनिया का पहला एजेंटिक रिवर्स इंजीनियर।

बाइनरी रिवर्स इंजीनियरिंग के लिए LLM ऑर्केस्ट्रेशन
अधिकांश कार्य एक रेखीय संबंध का पालन करते हैं: कार्य जितना कठिन होता है, आमतौर पर इसमें उतना ही अधिक समय लगता है। रिवर्स इंजीनियरिंग (और बाइनरी विश्लेषण) एक ऐसा कार्य है जिसमें वास्तविक कठिनाई कुछ हद तक तुच्छ है, लेकिन निष्पादन का समय घंटों (और दिनों!) के क्रम में हो सकता है, यहां तक कि कुछ सौ फ़ंक्शन वाले बाइनरी के लिए भी।
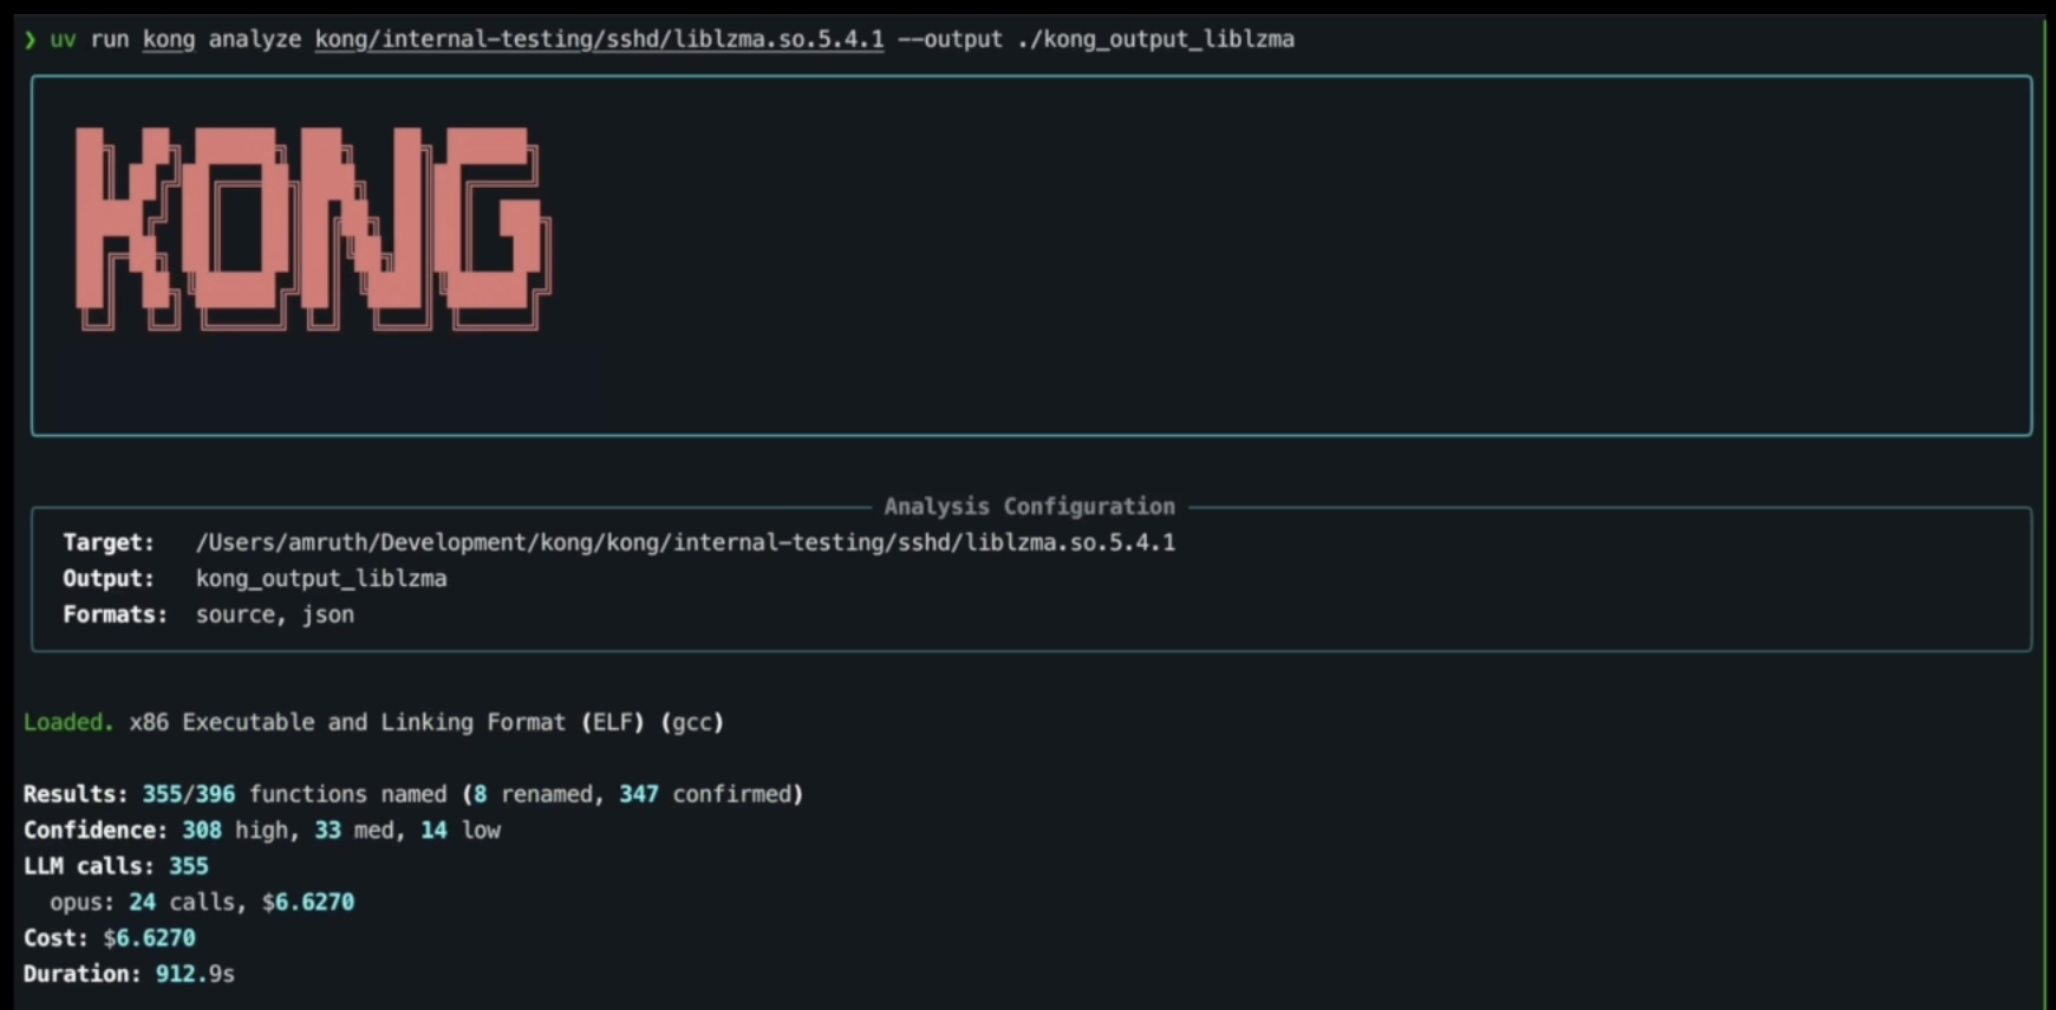
कोंग यांत्रिक परत को स्वचालित करता है, NSA-ग्रेड रिवर्स इंजीनियरिंग फ्रेमवर्क का उपयोग करके। कोंग एक पूरी तरह से अस्पष्ट, स्ट्रिप्ड बाइनरी ले सकता है और एक पूर्ण विश्लेषण पाइपलाइन चला सकता है: फ़ंक्शन को ट्राइएज करना, कॉल-ग्राफ़ संदर्भ बनाना, LLM-निर्देशित डीकंपाइलेशन के माध्यम से प्रकार और प्रतीकों को पुनर्प्राप्त करना, और परिणामों को Ghidra के प्रोग्राम डेटाबेस में वापस लिखना। आउटपुट एक बाइनरी है जहाँ कुछ FUN_00401a30 अब parse_http_header है, पुनर्प्राप्त स्ट्रक्ट्स, पैरामीटर नाम और कॉलिंग कन्वेंशन के साथ।
यह क्यों मौजूद है
स्ट्रिप्ड बाइनरी वह सारा संदर्भ खो देती है जो कोड को पढ़ने योग्य बनाता है: फ़ंक्शन नाम, प्रकार की जानकारी, चर नाम, स्ट्रक्ट लेआउट। उस संदर्भ को पुनर्प्राप्त करना अधिकांश रिवर्स इंजीनियरिंग कार्यों में मुख्य कार्य है, और यह काफी हद तक पैटर्न मिलान है: मानक लाइब्रेरी फ़ंक्शन को पहचानना, उपयोग से प्रकार का अनुमान लगाना, कॉल ग्राफ़ के माध्यम से नामों का प्रसार करना।
LLM इस प्रकार के पैटर्न मिलान में ठीक अच्छे हैं। लेकिन कच्चे डीकंपाइलर आउटपुट पर LLM को इंगित करना और पूछना "यह क्या करता है?" आपको औसत दर्जे के परिणाम देता है। मॉडल में कॉलिंग संदर्भ, क्रॉस-रेफरेंस जानकारी, और यह व्यापक चित्र नहीं है कि बाइनरी कैसे संरचित है। इसके अलावा, अधिकांश अस्पष्ट बाइनरी रिवर्स इंजीनियरिंग को रोकने के लिए चरम तकनीकें पेश करती हैं।
कोंग इसे LLM को छूने से पहले Ghidra के प्रोग्राम विश्लेषण (कॉल ग्राफ़, क्रॉस-रेफरेंस, स्ट्रिंग रेफरेंस, डेटा प्रवाह) से समृद्ध संदर्भ विंडो बनाकर हल करता है, फिर निर्भरता क्रम में विश्लेषण को व्यवस्थित करता है ताकि प्रत्येक फ़ंक्शन को उसके कैलीज़ के पहले से नामित होने का लाभ मिले। इसके अतिरिक्त, कोंग अपनी खुद की, अपनी तरह की पहली, एजेंटिक डीऑबफस्केशन पाइपलाइन पेश करता है।
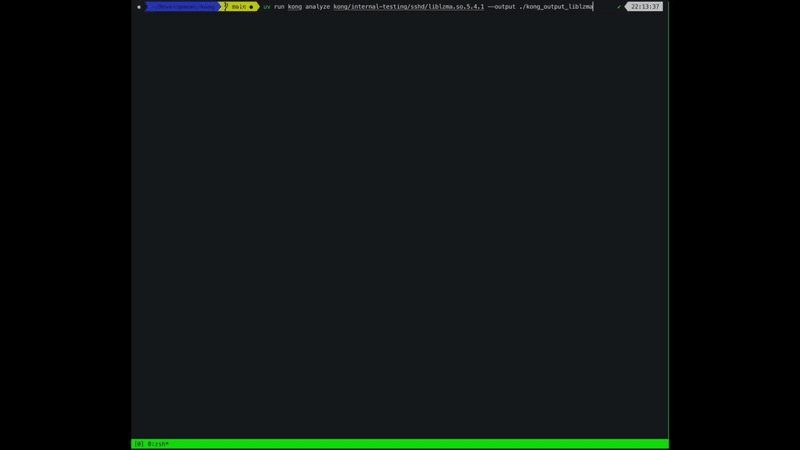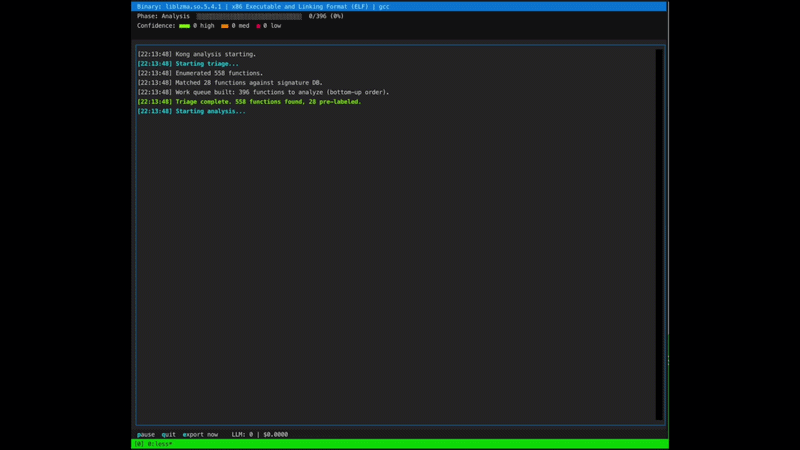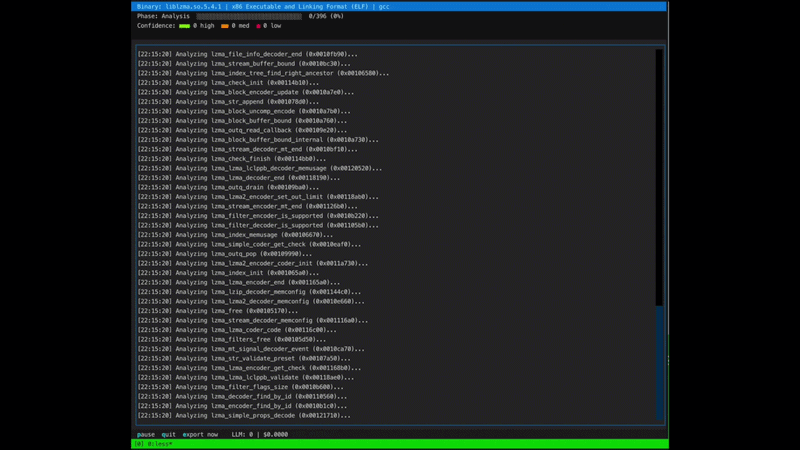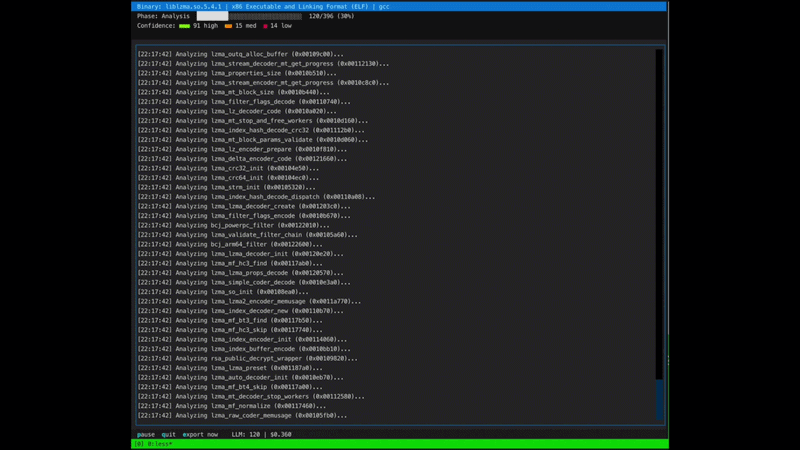
कोंग अधिकांश Ghidra-डीकंपाइल करने योग्य बाइनरी के साथ काम करता है (अभी के लिए, और आने वाला है)।
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | उच्च | उच्च | मध्यम | मध्यम |
| x86-64 | उच्च | उच्च | मध्यम | मध्यम |
| ARM (32-bit) | उच्च | उच्च | मध्यम | निम्न |
| AArch64 | उच्च | उच्च | मध्यम | निम्न |
| MIPS | मध्यम | मध्यम | निम्न | निम्न |
| PowerPC | मध्यम | मध्यम | निम्न | निम्न |
उच्च: कोंग विश्वसनीय रूप से डीकंपाइल करता है, डीऑबफसकेट करता है, और नाम, प्रकार और संरचना को पुनर्प्राप्त करता है।
मध्यम: डीकंपाइलेशन उपयोग करने योग्य है लेकिन अधिक शोर वाला है। आंशिक पुनर्प्राप्ति और कम आत्मविश्वास स्कोर की अपेक्षा करें।
निम्न: डीकंपाइलेशन में महत्वपूर्ण अंतराल हैं और परिणाम अपूर्ण, शोर वाले या अपठनीय रहेंगे।
नोट: बाइनरी का आकार फ़ंक्शन गणना, LLM लागत और पूरा होने के समय के साथ सकारात्मक रूप से बढ़ता है। हालाँकि, बाइनरी का आकार आत्मविश्वास के साथ नकारात्मक रूप से भी बढ़ता है, इसलिए बड़े बाइनरी का विश्लेषण करते समय इसे ध्यान में रखें।
कोंग एक पर्यवेक्षक द्वारा संचालित पाँच-चरणीय पाइपलाइन का उपयोग करता है जो ट्राइएज, समानांतर विश्लेषण और पोस्ट-प्रोसेसिंग का समन्वय करता है:
                    ┌──────────────────────┐
                    │       Triage         │
                    │  enumerate, classify,│
                    │  build call graph,   │
                    │  match signatures    │
                    └──────────┬───────────┘
                               │
                               ▼
              ┌────────────────┼────────────────┐
              │                │                │
              ▼                ▼                ▼
     ┌──────────────┐ ┌──────────────┐ ┌──────────────┐
     │   Analyze    │ │   Analyze    │ │     ...      │
     │  (leaf fns)  │ │ (next tier)  │ │              │
     └──────┬───────┘ └──────┬───────┘ └──────┬───────┘
            │                │                │
            └────────┬───────┴────────────────┘
                     │
                     ▼
            ┌──────────────────────┐
            │      Cleanup         │
            │  normalize, dedupe   │
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │     Synthesis        │
            │  unify names, build  │
            │  structs, deobfuscate│
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │       Export         │
            │  analysis.json +     │
            │  Ghidra writeback    │
            └──────────────────────┘