 aloshdenny/claude-awm
यूनिकोड वेरिएशन सेलेक्टर इंजेक्ट करके LLM टेक्स्ट वॉटरमार्क्स को बायपास करता है; इसमें SynthID जनरेटर, mean-g डिटेक्टर, नॉर्मलाइज़ेशन डिफेंस, और एन्ट्रॉपी प्रयोग शामिल हैं।

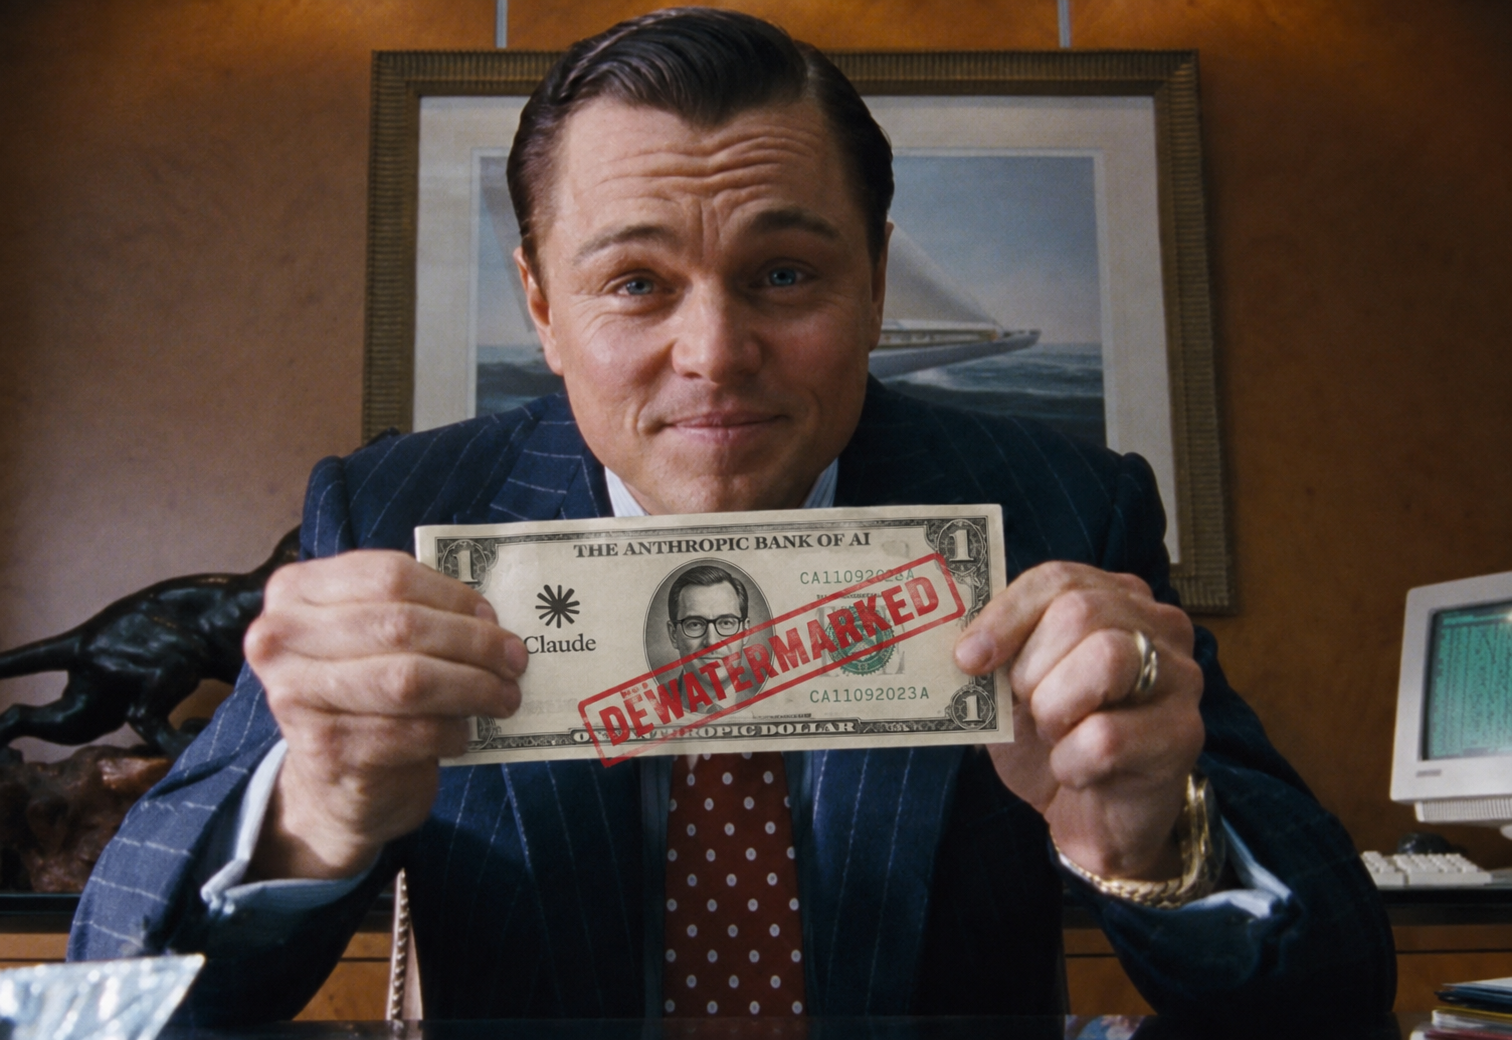
हाँ, लेकिन केवल एक ही प्रकार का हमला काम करता है, और वह वह नहीं है जिसकी सभी को अपेक्षा होती है।
Unicode variation selectors (श्रेणी Mn, U+FE00 से U+FE0F और U+E0100 से U+E01EF) डिटेक्टर को थ्रेशोल्ड से नीचे ले जाते हैं और वहीं बने रहते हैं। मेरे द्वारा आज़माए गए अन्य सभी अदृश्य-वर्ण हमलों को इनपुट नॉर्मलाइज़ेशन की एक पंक्ति पूरी तरह से उलट देती है। Variation selectors ऐसा नहीं करते, क्योंकि वे अर्थपूर्ण कोडपॉइंट हैं (emoji प्रस्तुति, CJK वेरिएंट) जिन्हें NFKC न तो हटाएगा और न ही हटाना चाहिए।
मॉडलों और डोमेनों में प्रतिकृत:
| मॉडल | डोमेन | बेसलाइन z | vs16_30 के बाद | संपादन दर |
|---|---|---|---|---|
| gpt-oss-20b | गद्य | 45.03 | 0.72 | 57% |
| gpt-oss-20b | कोड | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | गद्य | 35.50 | -0.67 | 57% |
थ्रेशोल्ड z = 2.33 है। हमले के बाद तीनों इससे नीचे आ जाते हैं, और नॉर्मलाइज़ेशन के बाद भी नीचे बने रहते हैं (क्रमशः 0.09, 0.45, -0.78)। मानव पाठक के लिए टेक्स्ट समान रूप से प्रदर्शित होता है।
दूसरी वास्तविक खोज के लिए किसी हमले की आवश्यकता ही नहीं है: कम-एंट्रॉपी टेक्स्ट पर शुरू से ही मुश्किल से वॉटरमार्क होता है। थिंकिंग अक्षम होने पर, Qwen3.8-27B का शुद्ध कोड आउटपुट बिना हमले के z = 4.31 स्कोर करता है, जो बिना कुछ किए 2.33 थ्रेशोल्ड के करीब है। थिंकिंग फिर से चालू करने पर वही मॉडल, वही डोमेन, वही लंबाई z = 25.53 तक पहुँच जाता है, क्योंकि रीज़निंग प्रीएम्बल सामान्य गद्य है और सामान्य रूप से मार्क वहन करता है।
इस रेपो में सब कुछ इन्हीं पर मापा गया, और किसी और पर नहीं:
| मॉडल | पैरामीटर | कहाँ | क्या चलाया गया |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | पूर्ण हमला सीढ़ी, 1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | पूर्ण हमला सीढ़ी + एंट्रॉपी प्रयोग + stego raw/normalized |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX, 4-bit) | वॉटरमार्क + डिटेक्ट, रीज़निंग ट्रेस |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | 32k तक पूर्ण हमला सीढ़ी, गद्य + कोड, variation selectors, 131k तक insertion-rate scaling law |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | गद्य + कोड, variation selectors, थिंकिंग-मोड कंट्रास्ट |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | 2k / 8k / 32k पर गद्य + कोड + रीज़निंग, 65k तक आंशिक insertion-rate scaling |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | 2k / 8k पर गद्य + कोड |
हर प्रयोग हर मॉडल पर नहीं चलाया गया, और नीचे दी गई तालिकाएँ बताती हैं कि कौन-सा कहाँ चला। जैसे-जैसे रोचक प्रश्न सिकुड़ते गए, बड़े मॉडल जोड़े गए, इसलिए छोटे मॉडलों पर हमला सीढ़ी व्यापक है और लंबाई व डोमेन का काम बड़े मॉडलों पर केंद्रित है।
Anthropic (और उनसे पहले Google DeepMind, SynthID-Text पेपर) कुंजीयुक्त टूर्नामेंट के साथ टोकन सैंपलिंग को पक्षपातित करके उत्पन्न टेक्स्ट पर वॉटरमार्क लगाता है। संकेत इस बात में निहित है कि कौन-से टोकन चुने गए, किसी छिपे हुए वर्ण में नहीं। मैं जानना चाहता था कि find-and-replace रखने वाले एक प्रेरित व्यक्ति के लिए यह कितना नाज़ुक है, इसलिए मैंने जनरेटर के साथ-साथ एक अनट्रेंड mean-g डिटेक्टर बनाया और उस पर हमले किए।
डिटेक्टर थ्रेशोल्ड z = 2.33 है (1% गलत सकारात्मक दर)। इससे ऊपर = वॉटरमार्क पहचाना गया। मैंने वॉटरमार्क वाला टेक्स्ट उत्पन्न किया, उस पर हमला किया, पुनः-टोकनाइज़ किया, और स्कोर किया। प्रत्येक परिणाम तालिका में एक roundtrip नियंत्रण (बिना हमले वाला वॉटरमार्क टेक्स्ट) होता है ताकि आप देख सकें कि उस पंक्ति में डिटेक्टर वास्तव में काम कर रहा है। इस अध्ययन के दौरान दो बार एक बग ने हर z को शून्य कर दिया, और नियंत्रण ही एकमात्र चीज़ थी जिसने इसे पकड़ा।
हमले की सतह Unicode श्रेणी के अनुसार स्पष्ट रूप से विभाजित होती है, जो पूरी कहानी साबित हुई।
काम करता है (श्रेणी Mn, nonspacing marks):
| हमला | यह क्या करता है | संपादन दर | नॉर्मलाइज़ेशन से बचता है? |
|---|---|---|---|
vs16_30 | ~30% वर्णों के बाद variation selector | 57% | हाँ |
vs16 | ~10% वर्णों के बाद variation selector | 23% | हाँ (z 3.46) |
vs_supp | supplementary-plane selectors (U+E0100+) | 24% | हाँ (z 3.40) |
homoglyph | लैटिन a के लिए सिरिलिक а (श्रेणी Ll) | 9% | हाँ, लेकिन प्रभाव कमज़ोर |
काम नहीं करता (श्रेणी Cf, फ़ॉर्मैट वर्ण):
| हमला | कच्चा z | सामान्यीकृत z | निर्णय |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | पूरी तरह वापस लाया गया |
combo | 0.92 | 35.68 | पूरी तरह वापस लाया गया |
bidi | 24.37 | 35.68 | पूरी तरह वापस लाया गया |
nbsp | 41.04 | 46.51 | मुश्किल से हिलता है |
Cf वर्ण शुद्ध फ़ॉर्मैटिंग हैं जिनमें कोई अर्थपूर्ण सामग्री नहीं होती, इसलिए एक सामान्यीकरणकर्ता उन्हें पूरी तरह हटा सकता है और कुछ भी नहीं खोएगा। Mn विविधता चयनकर्ता इमोजी और CJK पाठ में वास्तविक अर्थ रखते हैं, इसलिए उन्हें अन्धाधुन्ध हटाना वैध दस्तावेज़ों को विकृत कर देगा। यही असममिति है कि क्यों एक परिवार का बचाव किया जा सकता है और दूसरे का नहीं।
व्यावहारिक दायरा: एक मज़बूत बेसलाइन को सीमा से नीचे धकेलने के लिए लगभग 20% या अधिक वर्णों को छूना आवश्यक है, लेकिन डाले गए वर्ण अदृश्य हैं, इसलिए किसी भी संपादन दर पर पाठ सामान्य रूप से पढ़ा जाता है। इसे दृश्य रूप से समान सत्यापित किया गया है, देखें src/fidelity_check.py। चार परिवार केवल ऐसे वर्ण डालते हैं जो कुछ भी प्रस्तुत नहीं करते; होमोग्लिफ़ ईमानदार अपवाद हैं (फ़ॉन्ट-निर्भर, अदृश्य होने की गारंटी नहीं)।
मेरा शुरुआती डर उबाऊ वाला था: कि em-dashes और "and" से "&" और मार्कडाउन हटाना बस काम कर जाएगा, और वॉटरमार्क सुरक्षा-थिएटर निकलेगा। ऑनलाइन बहुत से लोग ठीक यही मानते हैं।
यह काम नहीं करता। gpt-oss-20b पर पूरी सतह-संपादन सीढ़ी, 32k टोकन तक:
| हमला | संपादन दर | z @ 1k | z @ 32k |
|---|---|---|---|
| roundtrip (नियंत्रण) | 0% | 25.7 | 104.3 |
| em-dash से हाइफ़न | ~0% | 26.4 | 113.7 |
| सभी मार्कडाउन हटाएँ | 13.6% | 27.2 | 103.3 |
| AmE से BrE + संक्षिप्ताक्षर | 1.3% | ~28 | ~100 |
| हर शब्द का 40% हटाएँ | 38% | 4.9 | 25.4 |
जिन तीन मॉडलों पर यह सीढ़ी चली (0.8B, 4B, 20B = 294 सेल), उनमें से ठीक एक सेल सीमा पार कर पाया: 4B पर सबसे छोटी लंबाई पर हर शब्द का 39% हटाना। वह हमला नहीं है, वह दस्तावेज़ को चिथड़े-चिथड़े करना है।
पूरे अध्ययन में कुल मापे गए सेल: 440 (ऊपर की हमला-सीढ़ी से 294, साथ ही नीचे के स्केलिंग-लॉ स्वीप से 146 जो गद्य को 131072 टोकन तक बढ़ाता है)।
दो चीज़ों ने मुझे चौंकाया:
पूर्ण तंत्र और प्रति-हमला तालिकाएँ docs/FINDINGS.md में।
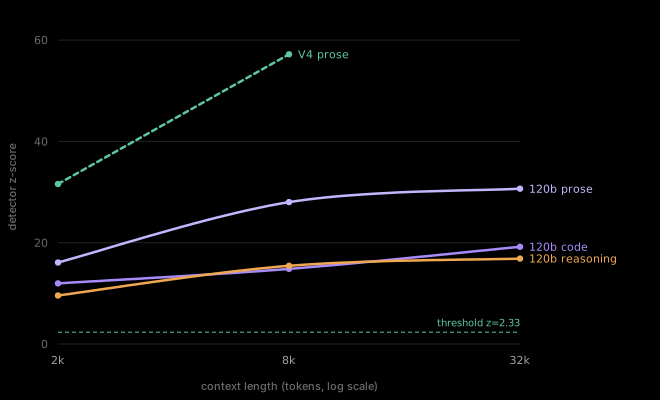
वॉटरमार्क विश्वास संदर्भ के साथ बढ़ता है जबकि प्रति-टोकन सिग्नल स्थिर रहता है, इसलिए लंबा दस्तावेज़ हमला करने के लिए कठिन है, आसान नहीं। गद्य हर लंबाई पर सबसे मज़बूत निशान रखता है; DeepSeek-V4-Flash (डैश्ड) 284B MoE पर वही चढ़ाई दोहराता है।