
promptfoo v0.124.0
अपने प्रॉम्प्ट, एजेंट और RAG का परीक्षण करें। AI के लिए रेड टीमिंग/पेंटेस्टिंग/भेद्यता स्कैनिंग। GPT, Claude, Gemini, DeepSeek और अधिक के प्रदर्शन की तुलना करें। कमांड लाइन और CI/CD एकीकरण के साथ सरल घोषणात्मक कॉन्फ़िगरेशन। OpenAI और Anthropic द्वारा उपयोग किया गया।
Promptfoo: LLM मूल्यांकन और रेड टीमिंग


promptfoo LLM-आधारित ऐप्स के मूल्यांकन और रेड-टीमिंग के लिए एक CLI और लाइब्रेरी है। ट्रायल-एंड-एरर का उपयोग बंद करें... सुरक्षित, विश्वसनीय एजेंट शिप करना शुरू करें
वेबसाइट · शुरुआत करें · रेड टीमिंग · दस्तावेज़ीकरण · Discord
Promptfoo अब OpenAI का हिस्सा है। Promptfoo ओपन सोर्स और MIT लाइसेंस के अंतर्गत बना हुआ है। कंपनी अपडेट पढ़ें।
त्वरित शुरुआत
npm install -g promptfoo
promptfoo init --example getting-started
brew install promptfoo और pip install promptfoo के माध्यम से भी उपलब्ध है। या बिना इंस्टॉल किए कोई भी कमांड चलाने के लिए npx promptfoo@latest का उपयोग करें।
अधिकांश LLM प्रदाताओं को API key की आवश्यकता होती है। अपनी key को एक environment variable के रूप में सेट करें:
export OPENAI_API_KEY=sk-abc123
एक eval चलाएँ और परिणाम देखें:
cd getting-started
promptfoo eval
promptfoo view
अधिक जानकारी के लिए शुरुआत करें (evals) या रेड टीमिंग (vulnerability scanning) देखें!
Promptfoo के साथ आप क्या कर सकते हैं?
- स्वचालित मूल्यांकन के साथ अपने prompts और models का परीक्षण करें
- रेड टीमिंग और vulnerability scanning के साथ अपने LLM ऐप्स को सुरक्षित करें
- models की तुलना साथ-साथ करें (OpenAI, Anthropic, Azure, Bedrock, Ollama, और अधिक)
- CI/CD में checks को स्वचालित करें
- code scanning के साथ LLM-संबंधित सुरक्षा और अनुपालन मुद्दों के लिए pull requests की समीक्षा करें
- अपनी टीम के साथ परिणाम साझा करें
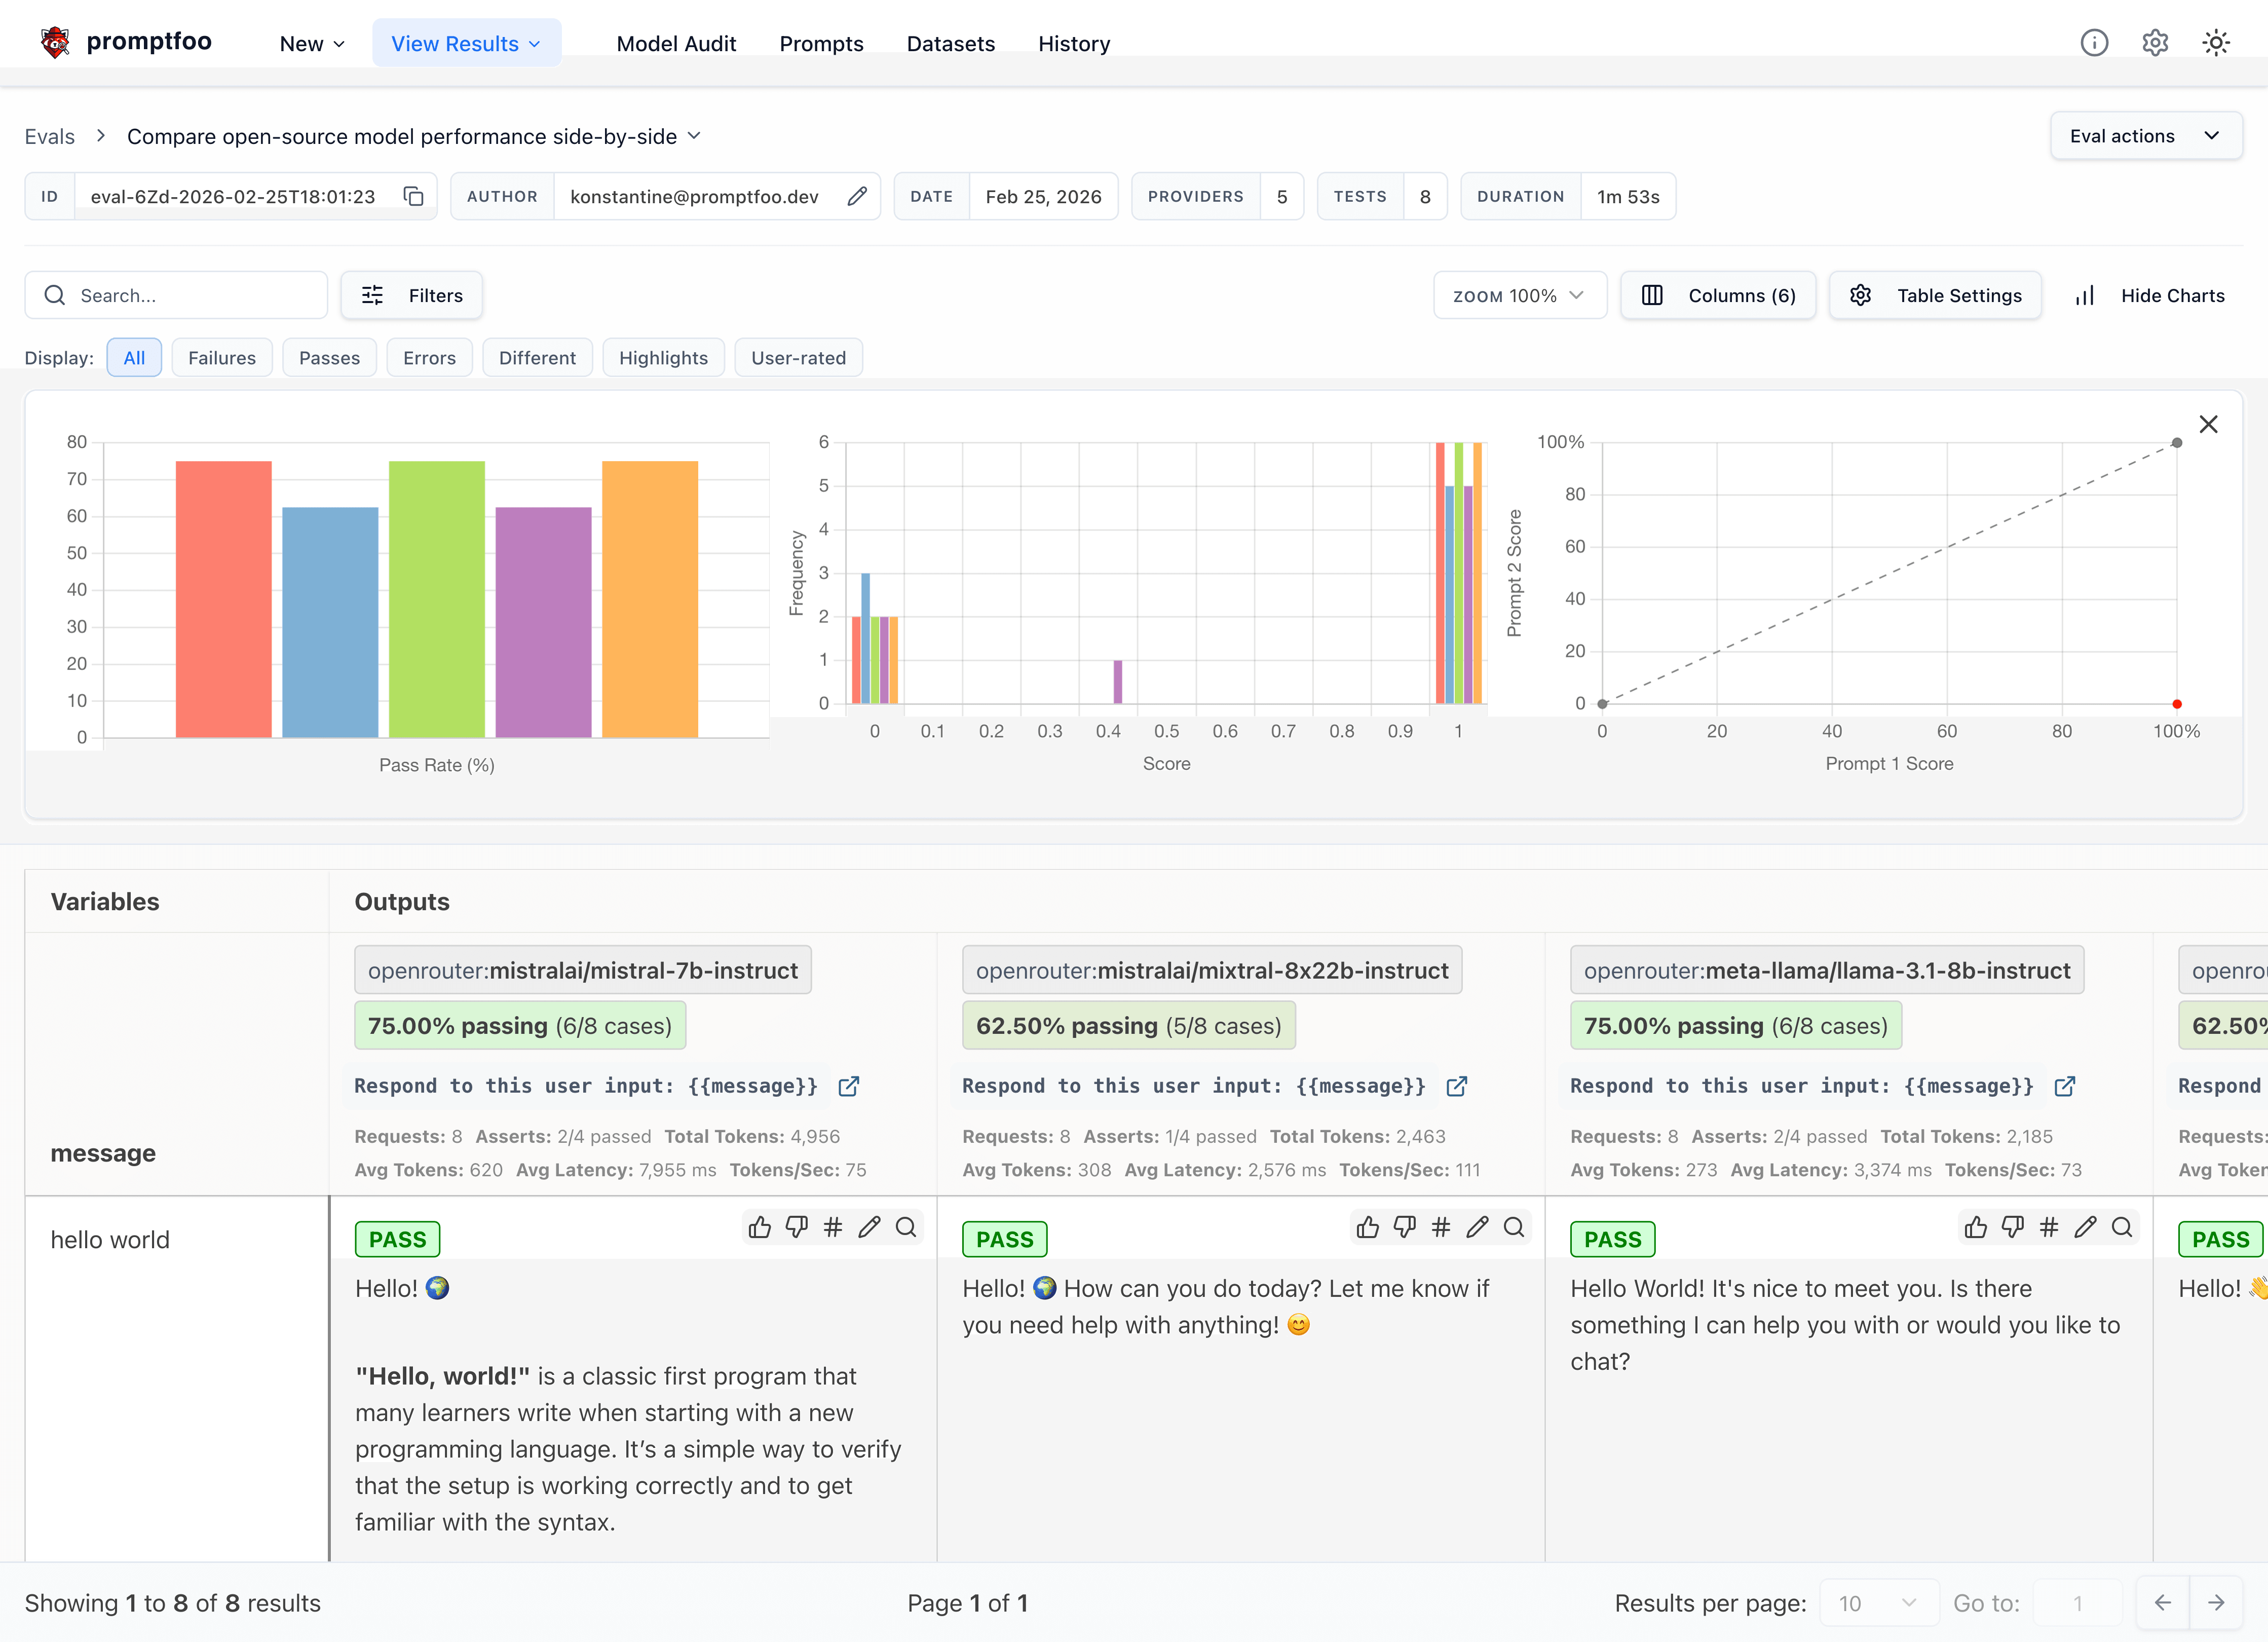
यह क्रिया में कैसा दिखता है:

यह कमांड लाइन पर भी काम करता है:

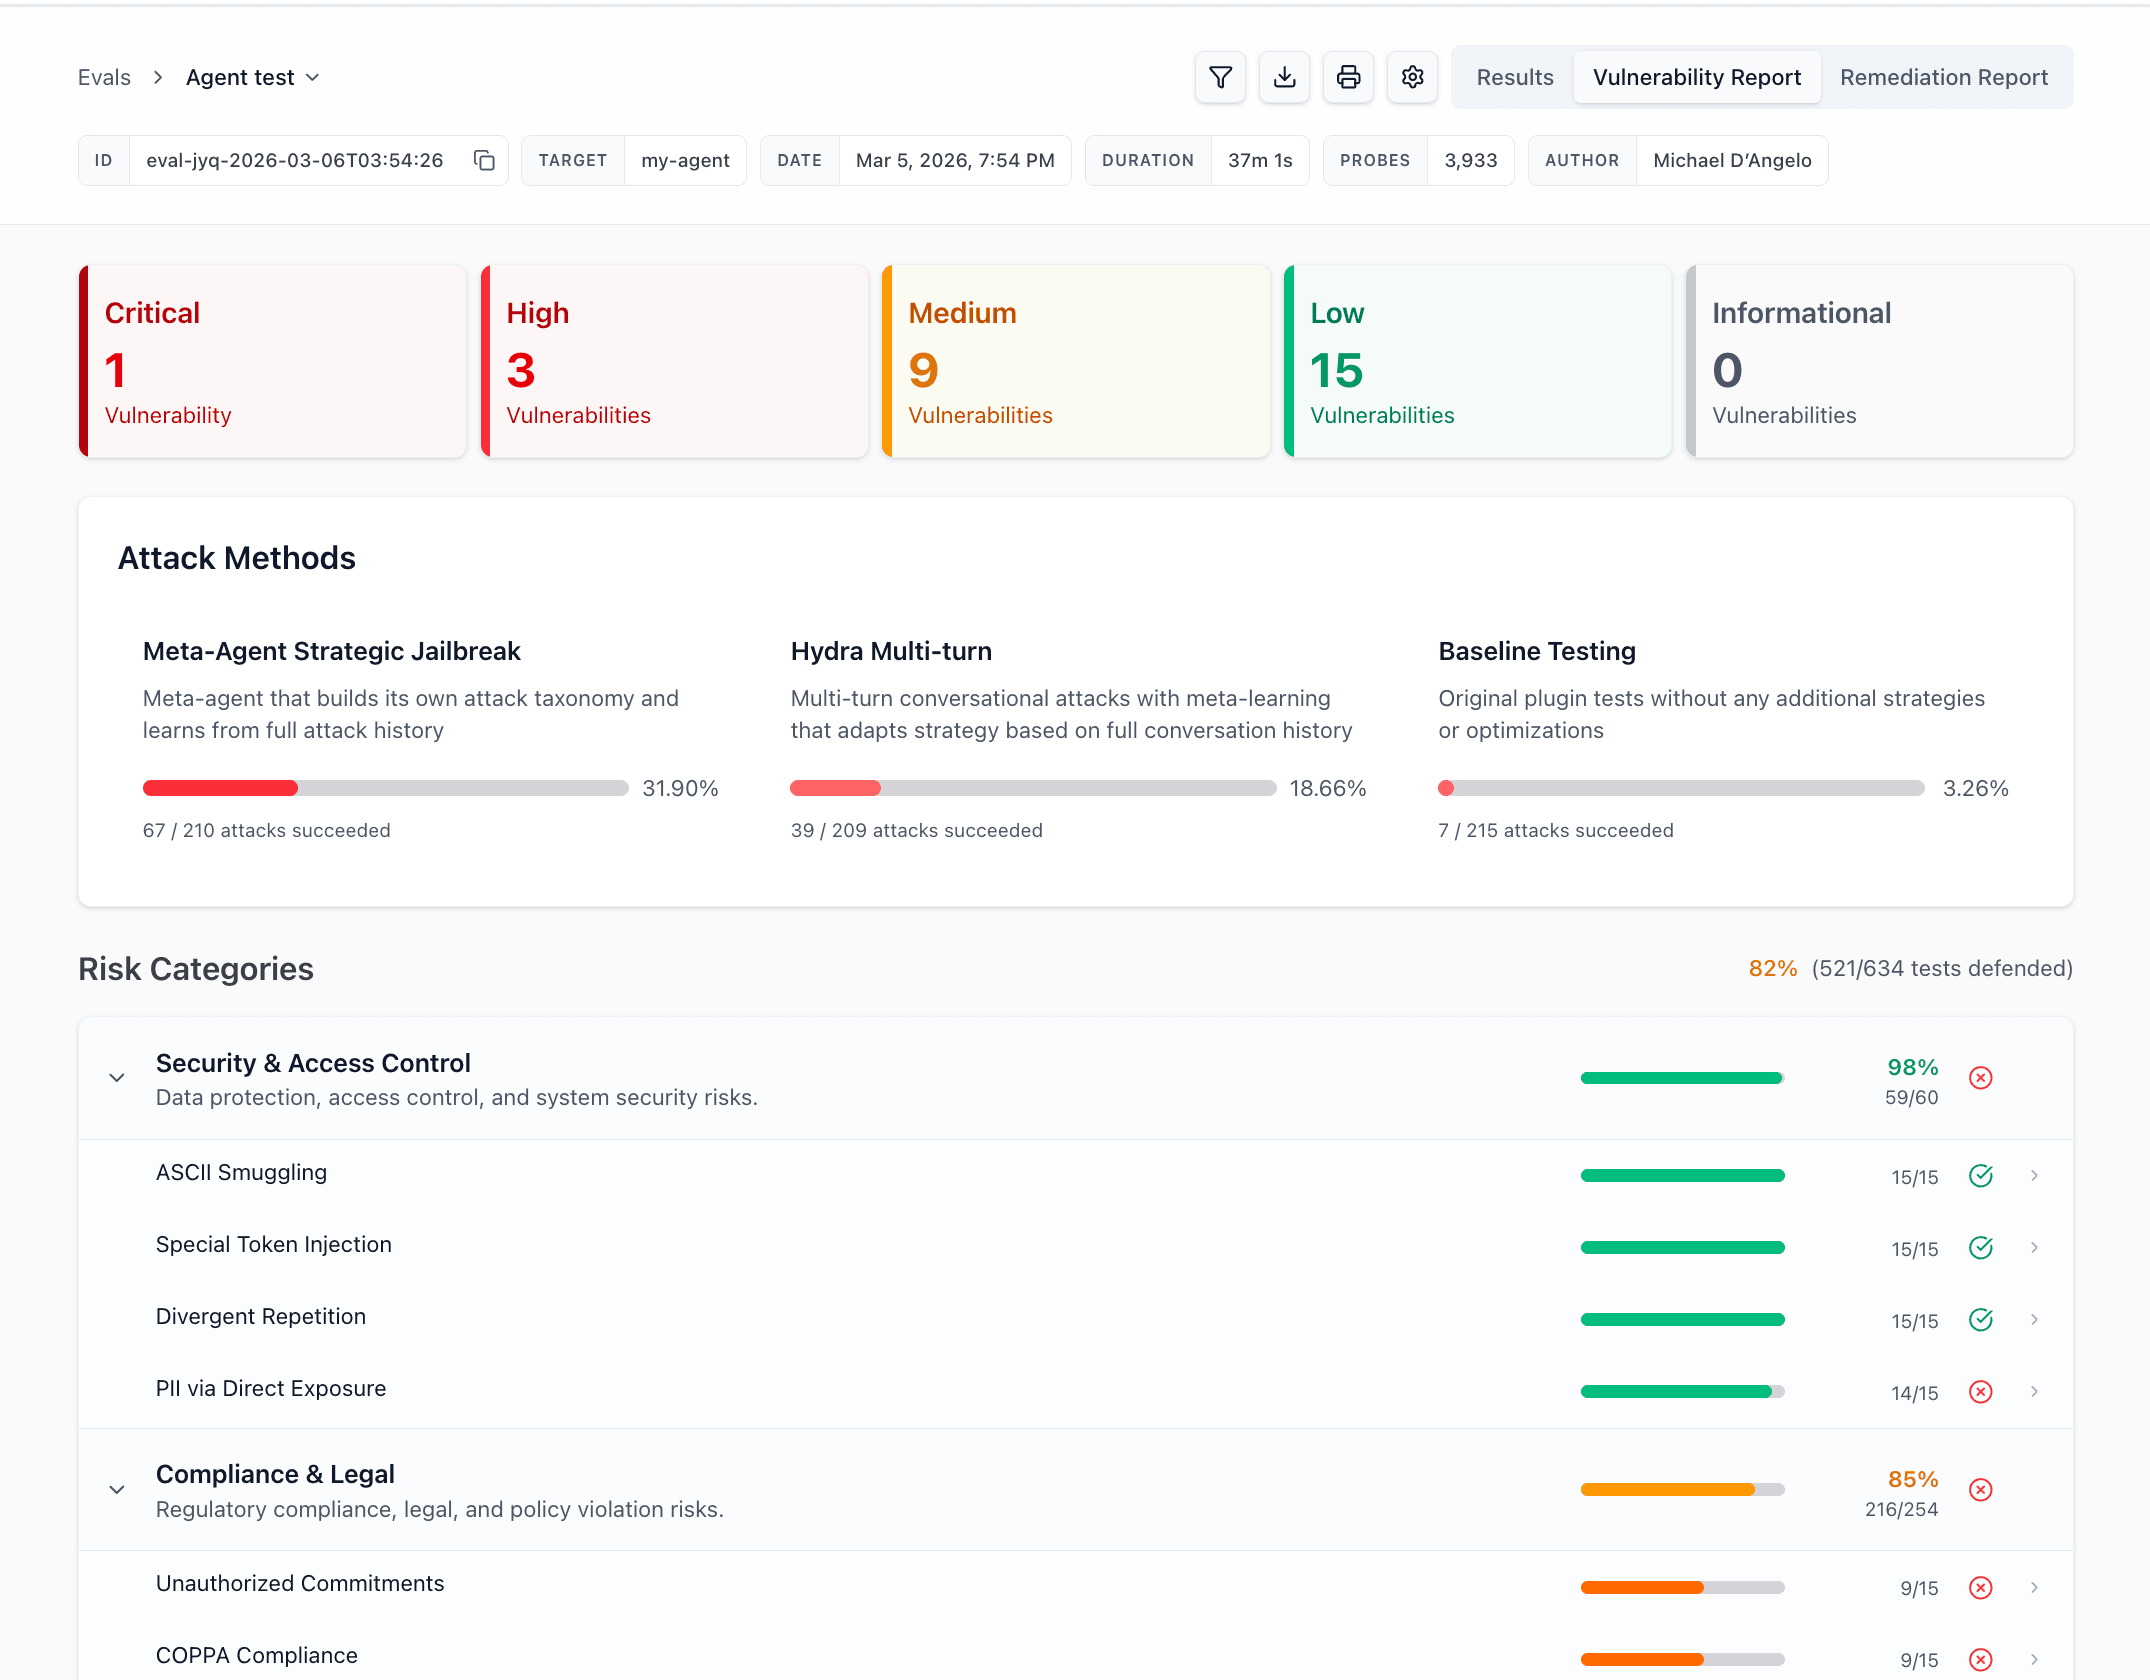
यह सुरक्षा vulnerability रिपोर्ट भी उत्पन्न कर सकता है:
Promptfoo क्यों?
- Developer-first: तेज़, live reload और caching जैसी सुविधाओं के साथ
- निजी: LLM evals 100% स्थानीय रूप से चलते हैं - आपके prompts कभी आपकी मशीन नहीं छोड़ते
- लचीला: किसी भी LLM API या प्रोग्रामिंग भाषा के साथ काम करता है
- Battle-tested: उत्पादन में 10M+ उपयोगकर्ताओं की सेवा करने वाले LLM ऐप्स को शक्ति देता है
- Data-driven: निर्णय metrics के आधार पर लें, अंदाज़े के आधार पर नहीं
- ओपन सोर्स: MIT लाइसेंस प्राप्त, एक सक्रिय समुदाय के साथ
और जानें
- शुरुआत करें
- पूर्ण दस्तावेज़ीकरण
- रेड टीमिंग गाइड
- CLI उपयोग
- Node.js पैकेज
- समर्थित Models
- Code Scanning गाइड
योगदान
हम योगदान का स्वागत करते हैं! शुरू करने के लिए हमारी contributing guide देखें।
सहायता और चर्चा के लिए हमारे Discord समुदाय से जुड़ें।