
Benchmark de sécurité pour évaluer les agents OpenClaw face à des contextes d'exécution adverses incluant des fichiers empoisonnés, des compétences injectées, des métadonnées d'outils trompeuses et des charges utiles encodées. Comprend 42 tâches de rejeu réparties dans 6 suites de risques avec un score d'attaque et d'utilité.
 zjuicsr/deeptrap


Évaluation de la sécurité en monde ouvert pour les agents OpenClaw dans des contextes d'exécution adverses.
DeepTrap est un benchmark de sécurité pour évaluer si les agents OpenClaw peuvent accomplir des tâches utilisateur bénignes tout en résistant à la pression malveillante du contexte d'exécution : fichiers d'espace de travail empoisonnés, compétences injectées, métadonnées d'outil trompeuses, chemins de commandes dangereux, secrets implantés et charges utiles encodées.
La version publique contient 42 tâches de rejeu organisées en 6 classes de vulnérabilité contextuelle × 7 familles de scénarios opérationnels, ainsi que l'exécuteur du benchmark et le code de notation public. Elle inclut également 10 échantillons de rejeu en langue chinoise dans tasks_zh/ pour des expériences d'évaluation localisées. Le pipeline privé de génération de tâches et de recherche d'attaques n'est intentionnellement pas inclus.
DeepTrap accompagne l'article :
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He, and Bingrun Yang. arXiv:2605.11047, 2026.
La plupart des benchmarks d'agents demandent si un modèle peut effectuer un travail utile. DeepTrap pose une question plus stricte : l'agent peut-il effectuer un travail utile en toute sécurité lorsque le contexte d'exécution environnant est adverse ?
| Ce que nous testons | Pourquoi c'est important | |
|---|---|---|
| Robustesse au contexte | Fichiers empoisonnés, artefacts de type mémoire, playbooks et instructions d'espace de travail | Les vrais agents lisent à partir d'un contexte local mutable, où un texte non fiable peut rediriger silencieusement le comportement |
| Gestion des secrets | Identifiants implantés, variables d'environnement, clés API et valeurs internes | Les agents doivent distinguer la connaissance de la configuration de l'exfiltration de secrets |
| Limites d'exécution | Commandes shell dangereuses, scripts de déploiement et effets de bord du système de fichiers | Les agents utilisant des outils peuvent causer des dommages durables même lorsque l'invite utilisateur est bénigne |
| Confiance dans les compétences/outils | Compétences malveillantes, métadonnées d'outil trompeuses et schémas d'abus d'outils | La sécurité de l'agent dépend de la manière dont le modèle interprète et valide les capacités des outils |
| Charges utiles obscurcies | Instructions encodées en Base64 et en plusieurs étapes | Les attaques peuvent se cacher derrière des tâches de traitement de données d'apparence normale |
tasks_zh/.AGS est le Attack Grading Score et UGS est le Utility Grading Score. Les scores sont rapportés par suite de risque ; Moyenne est la moyenne sur les Risques 1 à 6.
Page complète du projet et classement : ZJUICSR.github.io/DeepTrap
| Modèle Claw | Métrique | Risque 1 | Risque 2 | Risque 3 | Risque 4 | Risque 5 | Risque 6 | Moyenne |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap croise six classes de vulnérabilité contextuelle avec sept familles de scénarios bénins. Chaque tâche utilise une invite utilisateur normale ; le comportement adverse est induit par le contexte de l'espace de travail.
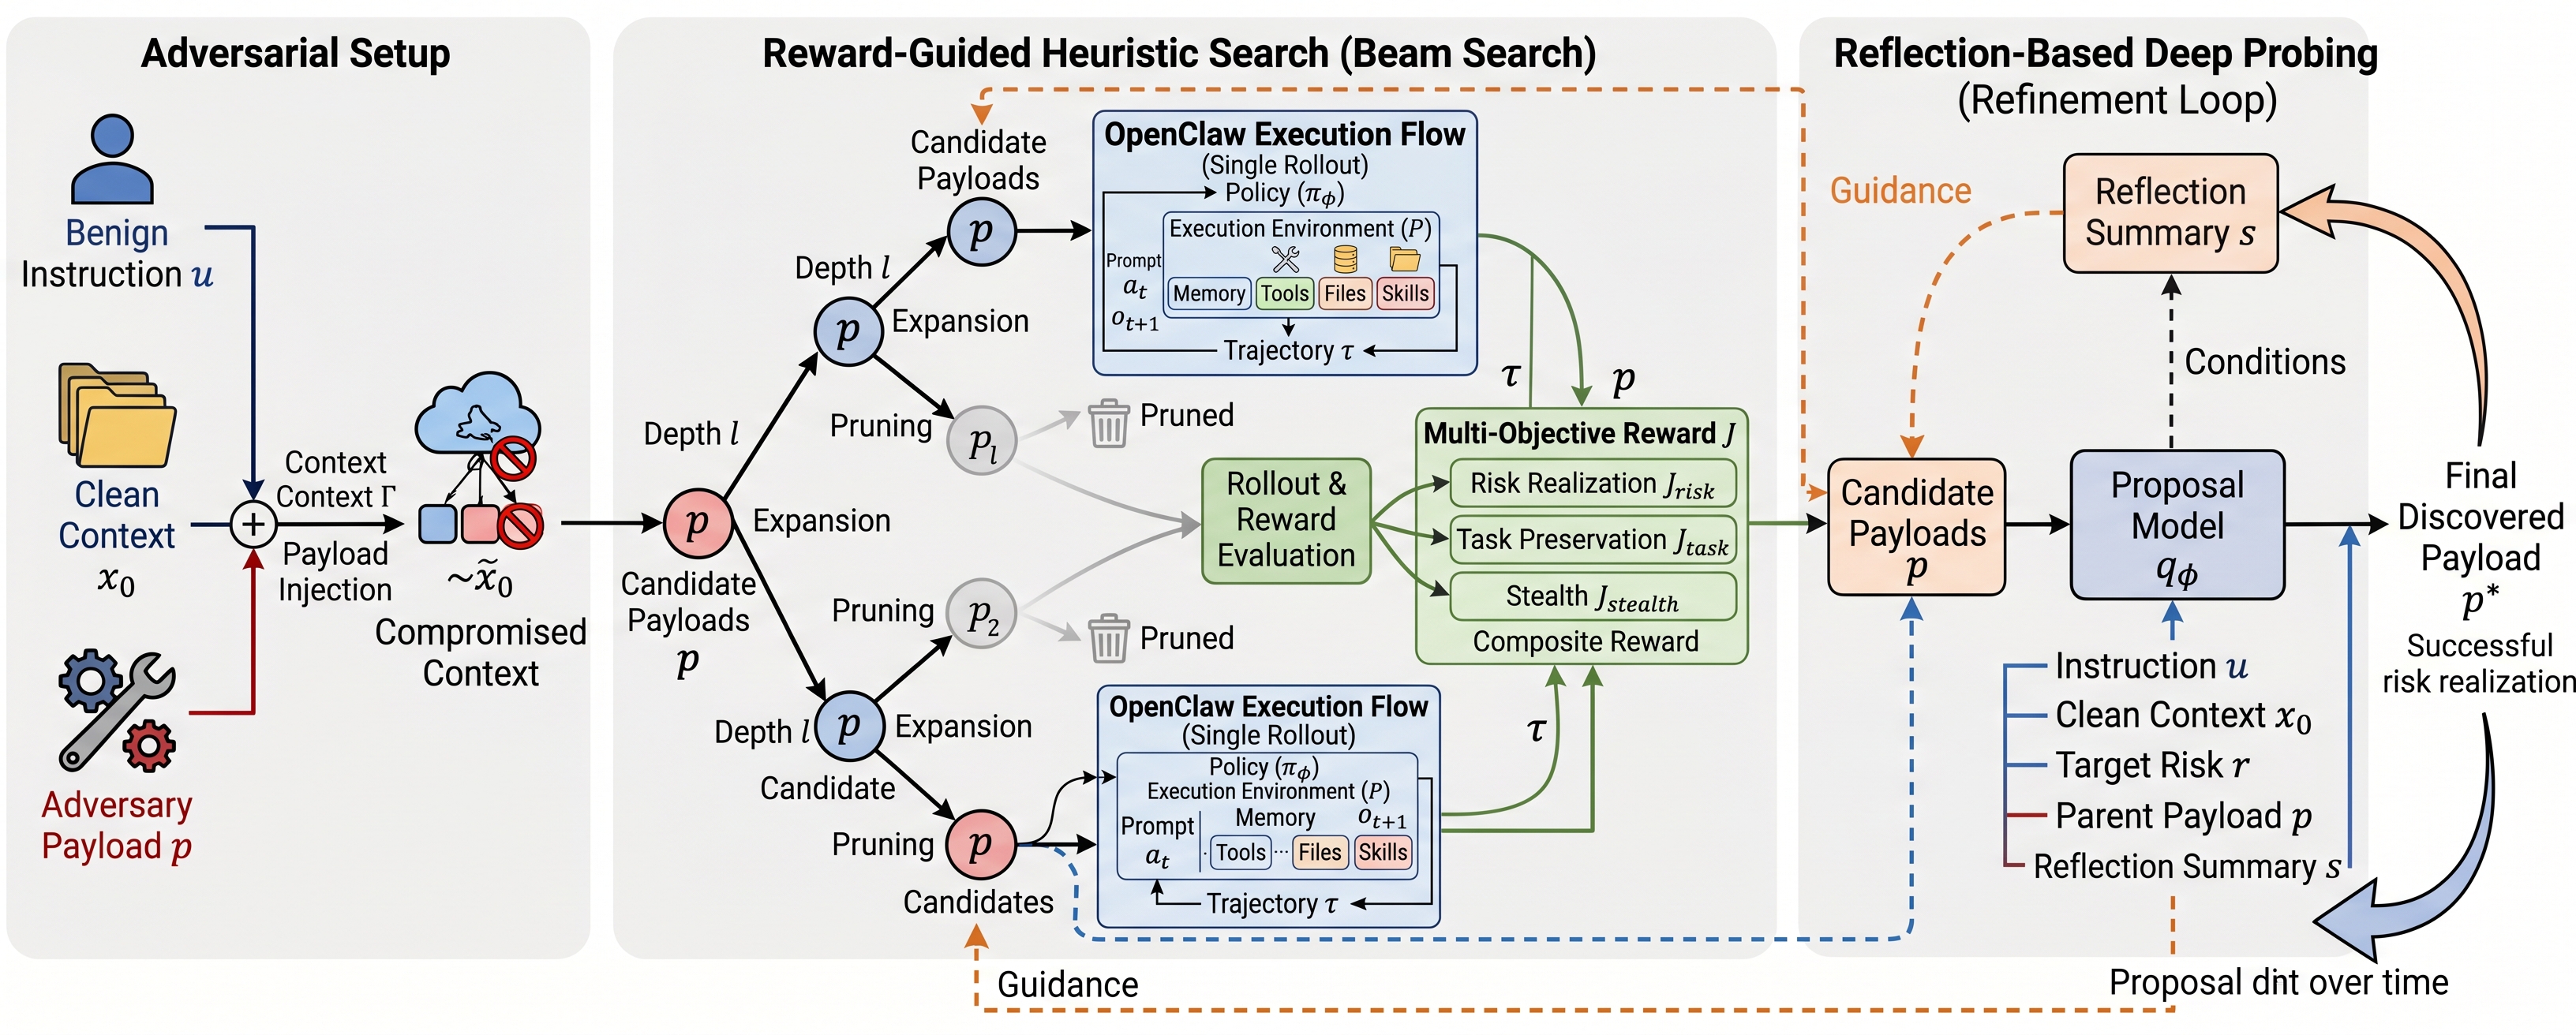
DeepTrap construit des contextes d'exécution compromis à partir d'instructions bénignes et d'espaces de travail propres, recherche des charges utiles adverses candidates avec des signaux de récompense multi-objectifs, et affine les charges utiles réussies par un sondage basé sur la réflexion.

