 unit8co/darts
Une bibliothèque Python pour la prévision conviviale et la détection d'anomalies sur les séries temporelles.





Darts est une bibliothèque Python pour la prévision et la détection d'anomalies conviviales
sur les séries temporelles. Elle contient une variété de modèles, des classiques tels que ARIMA aux
réseaux de neurones profonds. Les modèles de prévision peuvent tous être utilisés de la même manière,
en utilisant les fonctions fit() et predict(), de manière similaire à scikit-learn.
La bibliothèque facilite également le backtesting des modèles,
la combinaison des prédictions de plusieurs modèles, et la prise en compte de données externes.
Darts prend en charge les séries temporelles et les modèles univariés et multivariés.
Les modèles basés sur l'apprentissage automatique peuvent être entraînés sur des ensembles de données potentiellement volumineux contenant plusieurs séries
temporelles, et certains des modèles offrent un riche support pour la prévision probabiliste.
Darts offre également des capacités étendues de détection d'anomalies. Par exemple, il est trivial d'appliquer des modèles PyOD sur des séries temporelles pour obtenir des scores d'anomalie, ou d'envelopper n'importe lequel des modèles de prévision ou de filtrage de Darts pour obtenir des modèles de détection d'anomalies à part entière.
Nous recommandons de configurer d'abord un environnement Python propre pour votre projet avec Python 3.11+ en utilisant votre outil préféré (conda, venv, virtualenv avec ou sans virtualenvwrapper).
Une fois votre environnement configuré, vous pouvez installer darts en utilisant pip :
pip install darts
Pour plus de détails, vous pouvez vous référer à nos instructions d'installation.
Créez un objet TimeSeries à partir d'un DataFrame Pandas, et divisez-le en séries d'entraînement/validation :
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
Ajustez un modèle de lissage exponentiel et effectuez une prédiction (probabiliste) sur la durée de la série de validation :
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
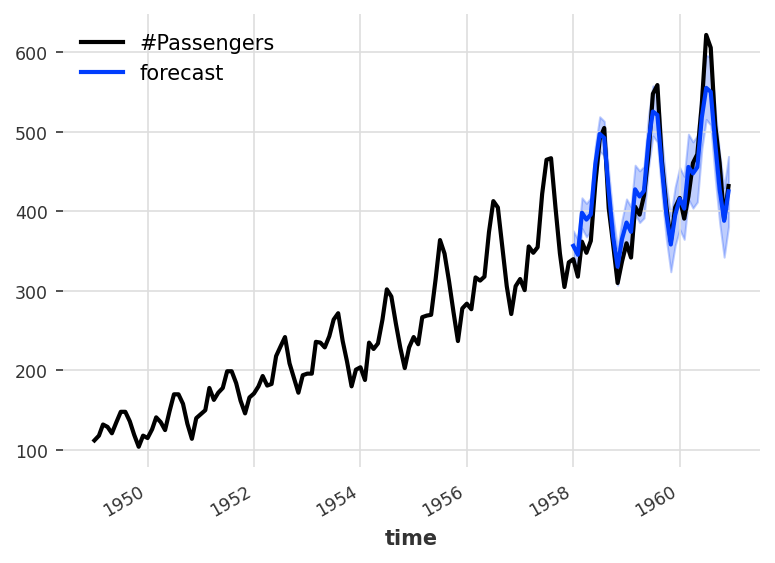
Tracez la médiane, les 5e et 95e percentiles :
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
Chargez une série multivariée, tronquez-la, conservez 2 composantes, divisez les ensembles d'entraînement et de validation :
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
Construisez un scoreur d'anomalies k-means, entraînez-le sur l'ensemble d'entraînement et utilisez-le sur l'ensemble de validation pour obtenir des scores d'anomalie :
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
Construisez un détecteur d'anomalies binaires et entraînez-le sur les scores d'entraînement, puis utilisez-le sur les scores de validation pour obtenir une classification binaire des anomalies :
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
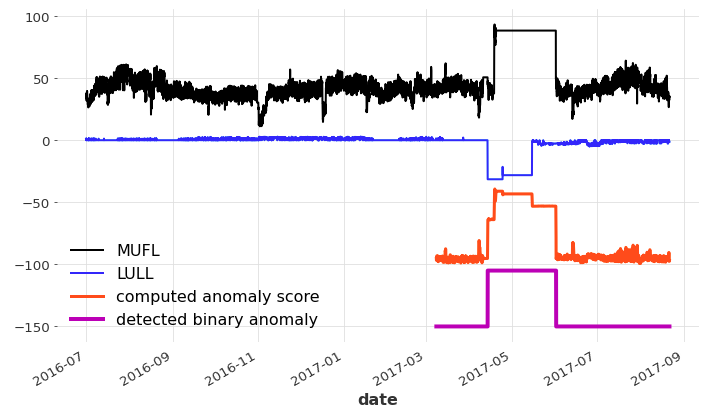
Tracé (décalage et mise à l'échelle de certaines séries pour que tout apparaisse sur la même figure) :
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)