 suhanmen/sew
Intègre et détecte des filigranes basés sur le style et liés à une clé dans du code Python, Java et C++ généré par LLM via la réécriture de CST, en préservant la correction fonctionnelle et en résistant aux attaques par édition de code.



| Fonctionnalité | Tatouages au niveau des tokens (KGW, SWEET, Unigram, STONE, STA-1) | Tatouages post-hoc (ACW, SrcMarker, RoSeMary) | ✨ SEW |
|---|---|---|---|
| Accès | Au moment du décodage (biaise la sélection des tokens) | Post-hoc (réécrit le code terminé) | Post-hoc (réécrit le code terminé, indépendant du modèle) |
| Correction fonctionnelle | Modifie le programme (compromis détectabilité–correction) | Peut casser les programmes (pass@1 Java/C++ ≈ 12 % pour la réécriture neuronale) | Préservée (pass@1 égal au code non tatoué) |
| Prévisibilité | — | Motifs récurrents (récupérés à partir de 10 programmes tatoués) | Dépendants de la clé et du contexte (les choix varient selon la structure de chaque programme) |
| Détection (TPR@FPR5%) | 14–60 % | 31–98 % | ⚡ 98,7–99,5 % |
Le tatouage du code généré par LLM permet le suivi de provenance. Les tatouages qui modifient la sélection des tokens pendant la génération échangent la détectabilité contre la correction fonctionnelle, et ils nécessitent un contrôle sur le modèle générateur. Les méthodes post-hoc tatouent plutôt le code achevé avec des transformations prédéfinies ou des modèles neuronaux entraînés, mais leurs motifs récurrents rendent le tatouage prévisible d'un programme à l'autre, et les motifs déjà courants dans le code non tatoué sont comptés comme preuves de tatouage, ce qui provoque de fausses détections. SEW pose la question : le style de code d'un programme déjà généré peut-il porter un tatouage correct par construction, difficile à prédire et calibré par rapport au code écrit par des humains ?
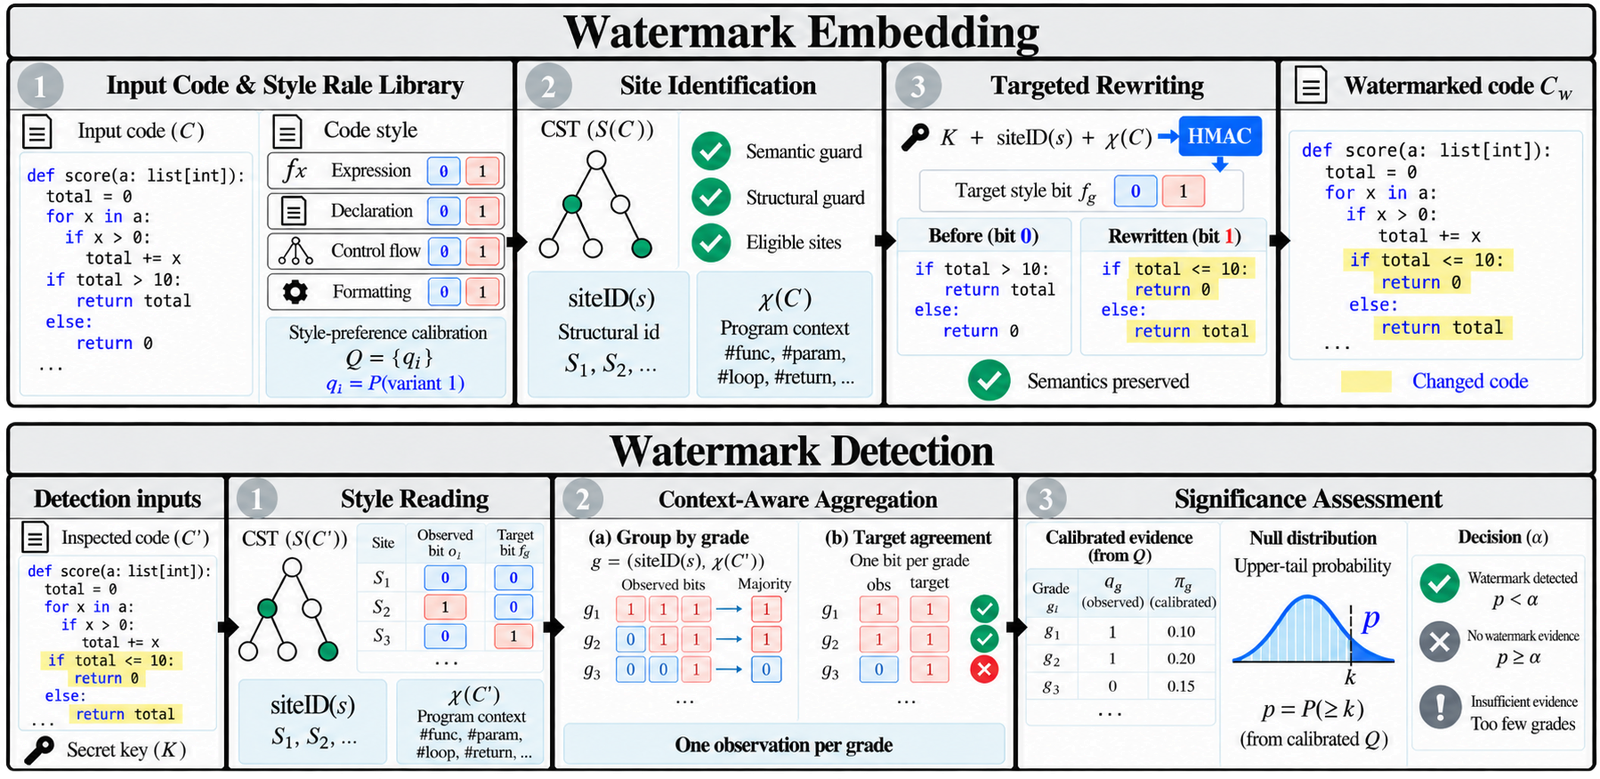
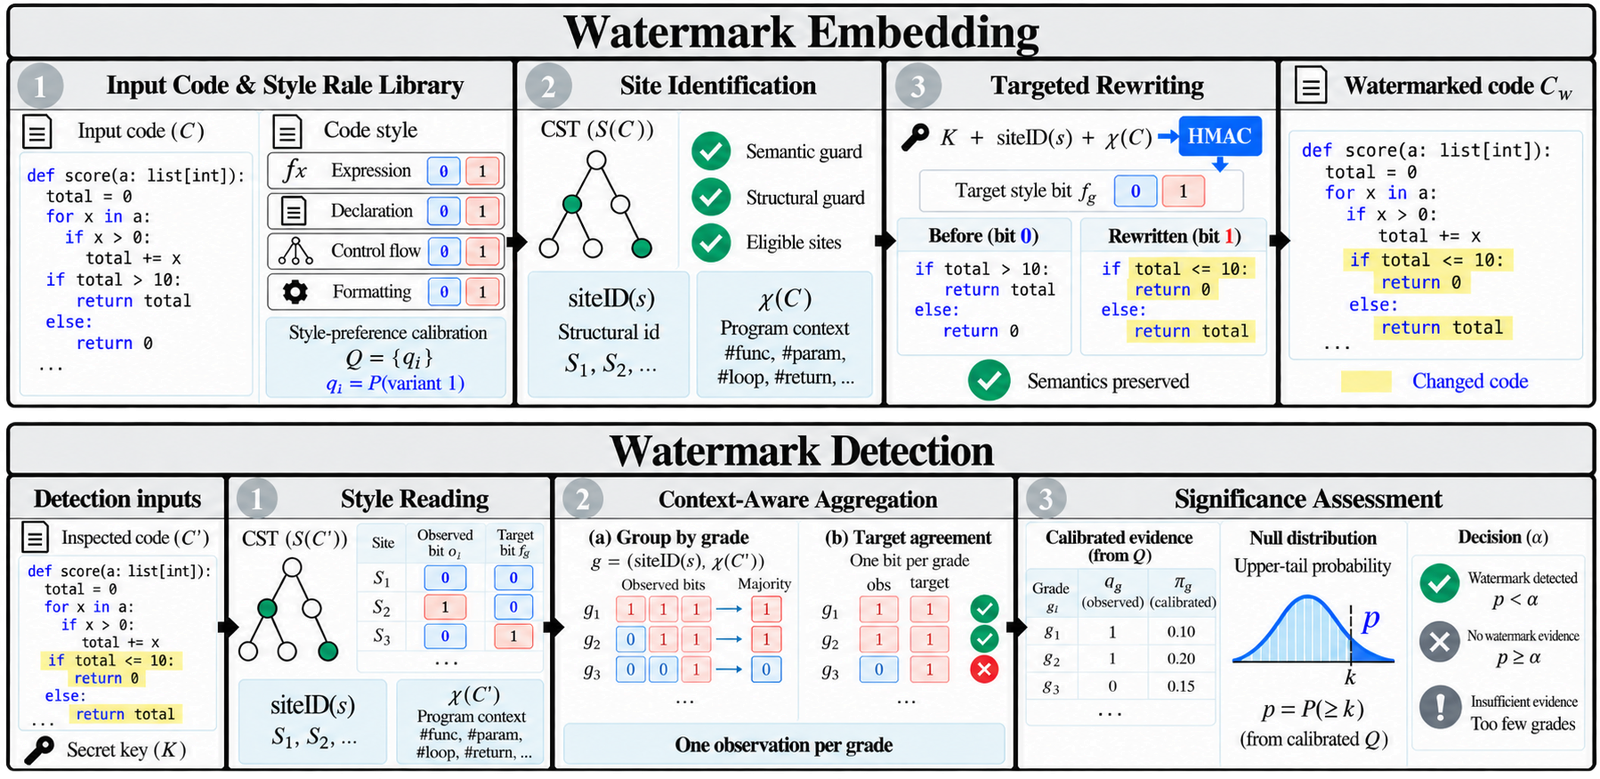
SEW (Style-Encoded Watermarking) intègre et détecte des tatouages dans du code déjà généré au moyen de trois composants :
x += 1 / x = x + 1, range(n) / range(0, n), if (c) s; / if (c) { s; }) sont mis en correspondance sur l'arbre de syntaxe concrète (CST). La variante adoptée par un site est décidée par une clé secrète et le contexte structurel du site.La détection ne nécessite que le code suspect et la clé — ni le modèle générateur, ni le code original, ni aucun enregistrement de l'intégration.
✅ Indépendant du modèle et correct par construction — SEW ne réécrit que les sites de style où les deux variantes ont la même sémantique, il fonctionne donc sur la sortie de n'importe quel modèle et maintient un pass@1 égal à celui du code non tatoué.
✅ Preuves calibrées — Un test de Poisson-binomial avec des probabilités de style estimées à partir de code écrit par des humains (solutions LeetCode, disjointes des données d'évaluation) maintient un faible taux de fausses détections sur le code humain.
✅ Robuste et difficile à inférer — SEW conserve sa détection sous le formatage, le linting, la suppression des commentaires et le renommage des variables, et un adversaire qui observe des programmes tatoués ne peut pas récupérer ses choix de style comme il récupère ceux des méthodes de référence post-hoc.
Résultat principal — détection sur CodeContests (TPR@FPR5% / AUROC, %), moyenné sur trois LLM (Qwen3.5-9B, gemma-4-12B-it, gpt-oss-20b).
| Type | Méthode | Python | Java | C++ |
|---|---|---|---|---|
| Au niveau des tokens | KGW | 48,33 / 80,56 | 43,30 / 72,31 | 59,31 / 84,54 |
| SWEET | 59,92 / 85,18 | 41,19 / 76,56 | 60,01 / 87,24 | |
| Unigram | 57,45 / 88,97 | 36,54 / 71,37 | 47,05 / 71,13 | |
| STONE | 28,09 / 62,33 | 14,38 / 62,95 | 23,65 / 64,79 | |
| STA-1 | 35,26 / 66,26 | 20,93 / 61,48 | 44,71 / 73,72 | |
| Post-hoc | ACW | 90,10 / 95,05 | – | – |
| SrcMarker | 90,21 / 97,86 | 71,52 / 93,58 | 69,88 / 81,55 | |
| RoSeMary | 97,86 / 97,32 | 31,00 / 95,46 | 81,26 / 89,44 | |
| SEW | 99,49 / 99,64 | 98,70 / 98,99 | 99,22 / 99,38 |
Correction fonctionnelle (pass@1 du code tatoué, % ; code non tatoué : 57,63 / 52,05 / 53,74).
| Méthode | Python | Java | C++ |
|---|---|---|---|
| ACW | 56,00 | – | – |
| SrcMarker | 56,78 | 11,87 | 11,82 |
| RoSeMary | 56,39 | 11,71 | 11,52 |
| SEW | 57,63 | 52,05 | 53,74 |
Robustesse aux attaques par édition de code (TPR@FPR5%, %, moyenné sur trois LLM et trois langages ; ACW : Python uniquement).
