 spdx/tools-python
Une bibliothèque Python pour analyser, valider et créer des documents SPDX.

Statut CI (Linux, macOS et Windows) : 
Veuillez noter que la prochaine version 0.8 a subi un refactoring important en préparation de la prochaine version SPDX v3.0, entraînant des changements majeurs dans l'API. Veuillez vous référer au guide de migration pour mettre à jour votre code existant.
Les principales fonctionnalités de v0.8 sont :
Notez que v0.8 ne prend en charge que l'écriture, et non la lecture, des documents SPDX 3.0. Voir #760 pour plus de détails.
Cette bibliothèque implémente des analyseurs, convertisseurs, validateurs et gestionnaires SPDX en Python.
Les mises à jour importantes concernant cette bibliothèque sont partagées via la liste de diffusion SPDX tech : https://lists.spdx.org/g/Spdx-tech.
AGraph.
Remarque : il s'agit d'une fonctionnalité facultative qui nécessite
l'installation de dépendances facultatives supplémentairesVoir Démarrage rapide avec SPDX 3.0 plus bas. L'implémentation est basée sur les fichiers Markdown descriptifs du dépôt https://github.com/spdx/spdx-3-model (commit : a5372a3c145dbdfc1381fc1f791c68889aafc7ff). Le dernier modèle SPDX 3.0 est disponible à l'adresse https://spdx.github.io/spdx-spec/v3.0/serializations/.
Comme toujours, vous devriez travailler dans un virtualenv (venv). Vous pouvez installer un clone local
de ce dépôt avec yourenv/bin/pip install . ou l'installer depuis PyPI
(vérifiez la dernière version et installez-la comme
yourenv/bin/pip install spdx-tools==0.8.3). Notez que sur Windows, ce serait Scripts
au lieu de bin.
ANALYSE/VALIDATION (pour analyser n'importe quel format) :
Utilisez pyspdxtools -i <filename> où <filename> est l'emplacement du fichier. Le format d'entrée est déduit automatiquement de l'extension du fichier.
Si vous utilisez une distribution source, essayez d'exécuter :
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json
CONVERSION (pour convertir un format vers un autre) :
Utilisez pyspdxtools -i <input_file> -o <output_file> où <input_file> est l'emplacement du fichier à convertir
et <output_file> est l'emplacement du fichier de sortie. Les formats d'entrée et de sortie sont déduits automatiquement des extensions des fichiers.
Si vous utilisez une distribution source, essayez d'exécuter :
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json -o output.tag
Si vous souhaitez ignorer le processus de validation, fournissez l'option --novalidation, comme ceci :
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json -o output.tag --novalidation
(à utiliser avec prudence : notez que des documents invalides non détectés peuvent entraîner un comportement inattendu de l'outil)
Pour obtenir de l'aide, utilisez pyspdxtools --help
GÉNÉRATION DE GRAPHES (fonctionnalité facultative)
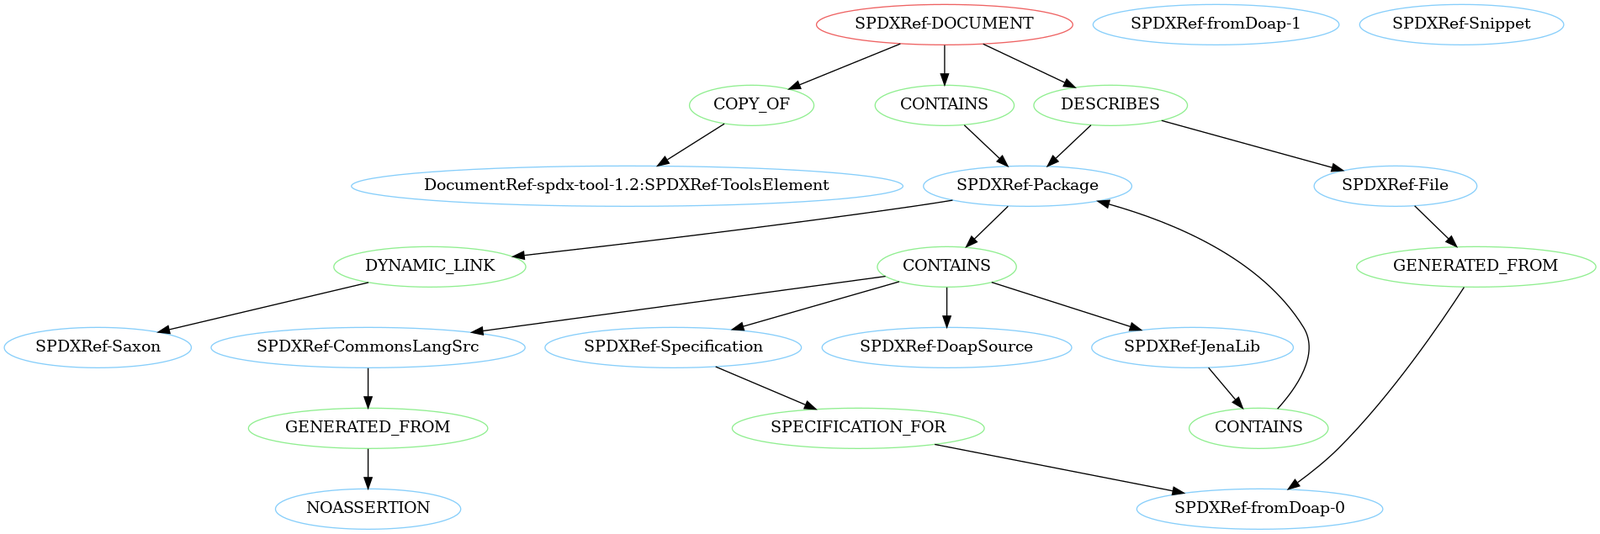
Cette fonctionnalité génère un graphe représentant tous les éléments du document SPDX et leurs connexions en fonction des
relations fournies. Le graphe peut être rendu sous forme d'image. Voici un exemple pour le fichier tests/spdx/data/SPDXJSONExample-v2.3.spdx.json :
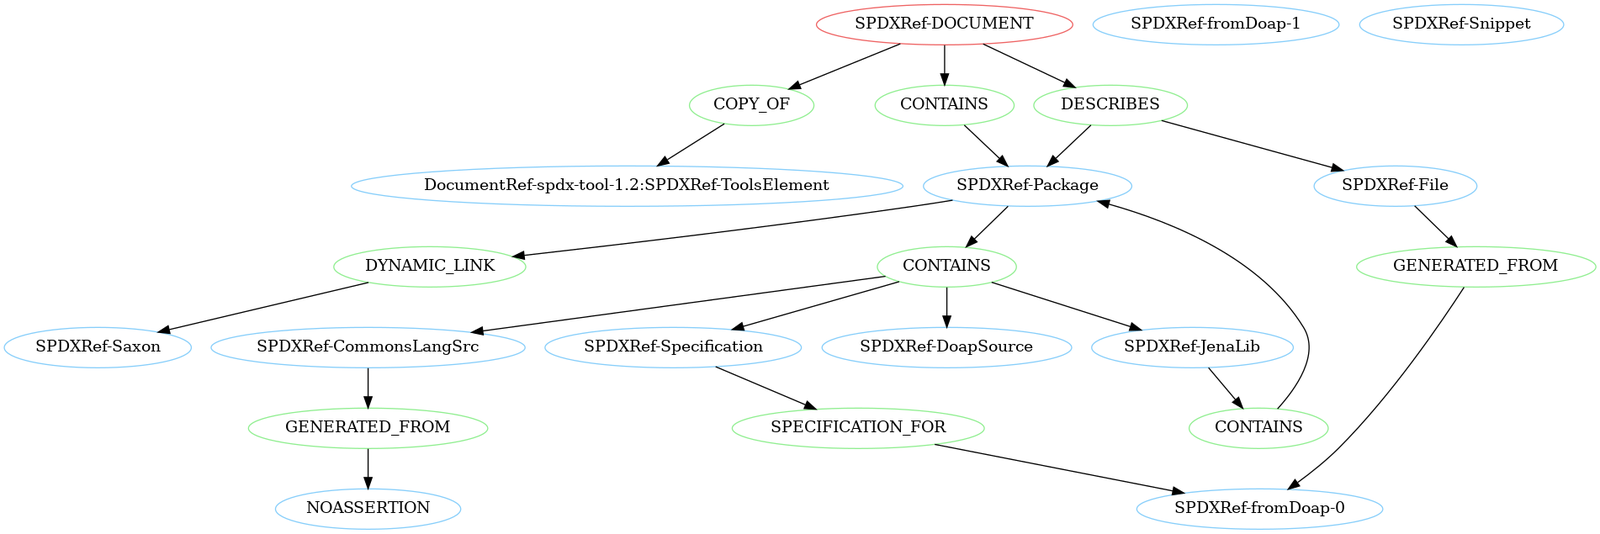
Assurez-vous d'installer les dépendances facultatives networkx et pygraphviz. Pour ce faire, exécutez pip install ".[graph_generation]".
Utilisez pyspdxtools -i <input_file> --graph -o <output_file> où <output_file> est un nom de fichier de sortie au format valide pour pygraphviz (consultez
la documentation ici).
Si vous utilisez une distribution source, essayez d'exécuter
pyspdxtools -i tests/spdx/data/SPDXJSONExample-v2.3.spdx.json --graph -o SPDXJSONExample-v2.3.spdx.png pour générer
un png avec un aperçu de la structure du fichier d'exemple.
MODÈLE DE DONNÉES
spdx_tools.spdx.model constitue le modèle de données interne de SPDX v2.3 (v2.2 en est simplement un sous-ensemble). Toutes les classes pertinentes pour la création de documents SPDX sont exposées dans le __init__.py situé ici.@dataclass_with_properties, une extension personnalisée de @dataclass.ConstructorTypeError ou TypeError). Cela permet de détecter facilement les propriétés invalides dès le début et de ne construire que des documents valides.list.append(item) contournent la vérification des types (un TypeError sera tout de même levé à la lecture de list). Nous recommandons d'utiliser list = list + [item] à la place.Document du module document.py, qui renvoie à toutes les autres classes.documentDescribes et hasFiles : ces champs seront convertis en relations dans le modèle de données interne. Comme ils sont obsolètes, ces champs ne seront pas écrits dans la sortie.ANALYSE
