
Skip to content
KitploitKITPLOIT
OutilsExploitsBlog
Log in
Soumettre
OutilsExploitsBlog
Soumettre

Outils de Hacking, PenTest et Cybersécurité pour votre Arsenal de Sécurité !

Kitploit est un répertoire d'outils de hacking, de cybersécurité et de pentesting. Découvrez les dernières mises à jour des projets pour trouver des vulnérabilités, analyser des systèmes, automatiser les tests et renforcer votre sécurité.

FluxContactConfidentialité© 2026 Kitploit

Répertoire d'outils

Catégories

Voir toutes les catégories
Loading categories
confusable-vision — Le premier jeu de données de confusables police par police au monde : quels caractères Unicode se ressemblent, mesuré à partir des contours de 322 polices à la taille à laquelle les gens les lisent. CC BY, utilisé dans les vérifications des noms d'extensions de Mozilla. | Kitploit
Outils/GitHubGitHub/paultendo/confusable-vision
OSINT (Renseignement de Sources Ouvertes)ReconnaissanceSécurité WebRenseignement sur les MenacesSécurité de la Chaîne LogistiqueArticles et RechercheApprentissage et ÉducationRessources Organisées

Populaires

Voir tout →

Découvrez les outils les plus utilisés par notre communauté.

Explorer tous les outils

Parcourez notre collection d'outils

Voir tous les outils →
Partager
GitHub
paultendo/confusable-vision

confusable-vision

Le premier jeu de données de confusables police par police au monde : quels caractères Unicode se ressemblent, mesuré à partir des contours de 322 polices à la taille à laquelle les gens les lisent. CC BY, utilisé dans les vérifications des noms d'extensions de Mozilla.

Voir le dépôtSite web
1129il y a 22 joursPas encore vérifié

confusable-vision

Le premier jeu de données de confusables police par police au monde. Quels caractères Unicode ressemblent à quels autres, mesuré à partir des contours des polices plutôt que des pixels. La version actuelle, 2026.09.26, compare chaque lettre et chaque chiffre que chacune des 322 polices dessine, à la taille et à la position sur la ligne de base que chaque glyphe a dans un texte courant. Les sosies des lettres et chiffres ASCII sont ensuite vérifiés en contexte : placés entre d'autres lettres dans des polices courantes, à la taille à laquelle on les lit, et comparés à des paires que tout le monde accepte comme identiques, telles que 0 et O.

addons.mozilla.org utilise des caractères issus de confusable-vision pour vérifier les noms d'extensions à la recherche de sosies, crédité dans le code source de Mozilla ; voir Utilisé par.
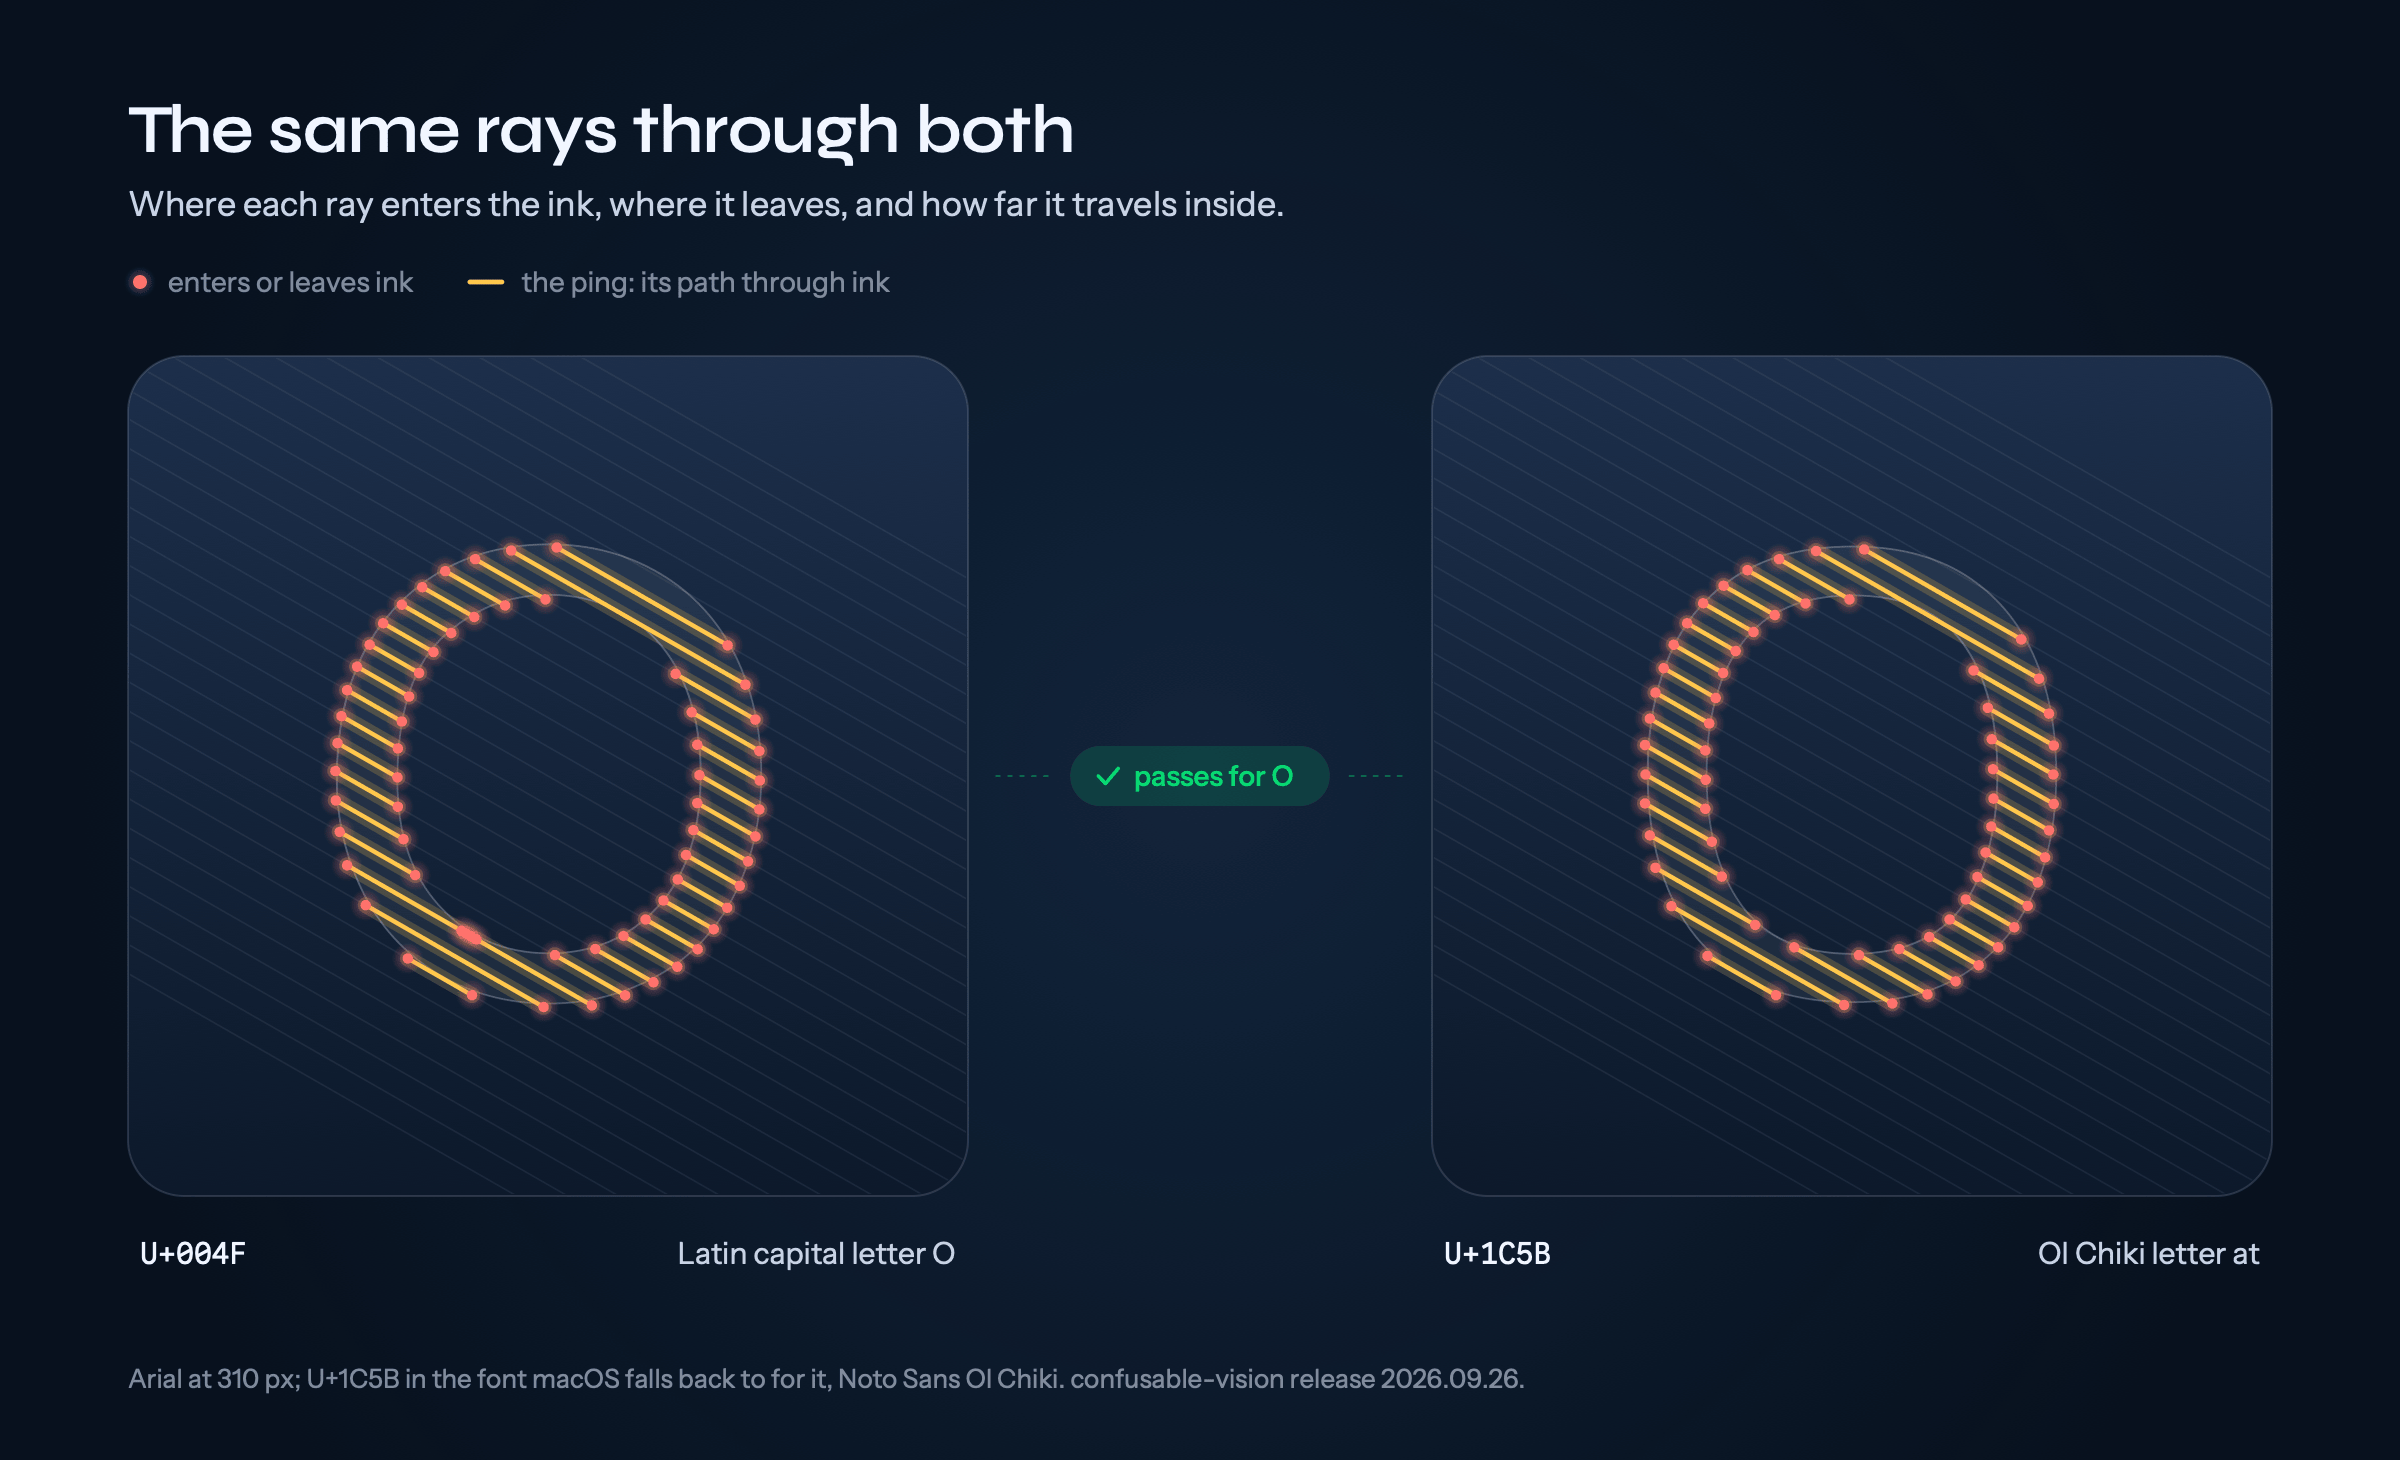
Les mêmes rayons à travers le O majuscule latin et la lettre Ol Chiki (U+1C5B) : l'endroit où chaque rayon entre et sort de l'encre, et son trajet à travers l'encre, correspondent.

Utilisé par

  • Mozilla addons-server, le code derrière addons.mozilla.org, ajoute des caractères issus de la sortie de confusable-vision à la table qu'il utilise pour ramener les sosies à l'ASCII lors de la vérification des noms d'extensions : src/olympia/amo/confusables.py, pull requests #24468, #24541, #24612 et #24665 (février à mars 2026).
  • disarm (raeq/disarm), qui canonicalise l'Unicode adversarial avant qu'il n'atteigne les classifieurs, les index et les identifiants, ajoute des paires mesurées issues de confusable-vision à ses tables de confusables : data/confusables_supplement.tsv, data/confusables_vision.tsv.
  • SilverSpeak (ACMCMC/silverspeak), une bibliothèque Python pour exécuter et neutraliser les attaques par homoglyphes sur du texte, construit les voisins visuels de son graphe d'homoglyphes à partir des fichiers de découverte de confusable-vision (docs/hkb.md).
  • namespace-guard embarque les paires mesurées, et par son intermédiaire elles atteignent agent-sanitizer, qui utilise namespace-guard comme moteur par défaut pour ramener à l'ASCII les caractères sosies dans l'entrée d'appel d'outil d'un agent IA (deps.dev).

Ces projets ont tiré leurs données des sorties de confusable-vision de février et mars 2026.

Discuté sur Hacker News : J'ai rendu 1 418 confusables sur 230 polices et Confusables.txt et NFKC sont en désaccord sur 31 caractères.

La version 2026.09.26 en chiffres :

  • 322 polices : toutes les polices de macOS, y compris celles qu'il télécharge à la demande comme PingFang, plus Roboto, Noto Sans, Noto Serif, Noto Sans CJK et DejaVu. 64 751 points de code dans 140 écritures.
  • 11 517 paires identiques dans au moins une police ou combinaison de polices, dont 5 975 passent les seuils suggérés.
  • 719 paires d'un caractère et d'une séquence ASCII de deux lettres, telles que ǁ et ll, ou Ы et bl.
  • 3 055 sosies candidats de lettres, chiffres et séquences ASCII vérifiés en contexte : 646 identiques au niveau strict, 358 de plus au niveau large, 101 de plus qui correspondent au dessin de la lettre d'une autre police courante. 224 des stricts ne figurent pas dans le confusables.txt d'Unicode.

Les données sont publiées sous forme de version numérotée dans data/release/2026.09.26/ (CC-BY-4.0). namespace-guard et d0ma1n sont construits dessus.

Ce qui a changé depuis la version 2

La version 2 (2026.09.24, et 2026.09.25 pour les données de TLD) ne comparait que les paires et les polices que les exécutions précédentes avaient comparées. Un audit des glyphes identiques a révélé qu'elle avait détecté 637 des 2 654 cas où une police dessine deux caractères avec le même glyphe. La version 3 corrige cela et ajoute trois choses :

  • La couverture. Chaque lettre et chaque chiffre que chaque police dessine est comparé à tous les autres de cette police, Han et Hangul inclus. La version 2 tirait ses caractères d'une liste fixe, de sorte qu'elle n'atteignait jamais la plupart du Yi, de l'aborigène canadien, de l'éthiopien ou des écritures indiennes, et qu'elle manquait les polices propres à une écriture et PingFang.
  • Les bonnes fontes. Les collections de polices sont chargées dans la fonte qu'un navigateur utilise pour le corps de texte. Les exécutions précédentes prenaient la première fonte, qui pour certaines collections était grasse, black ou italique.
  • Les contours qui se chevauchent, comme dans les polices variables telles que San Francisco, sont mesurés comme l'union de leurs traits, tels qu'un lecteur les voit.
  • Les séquences de deux lettres. Chaque séquence de deux lettres ou chiffres ASCII (3 844) est composée telle que chaque police la compose, avec son crénage et ses ligatures, et comparée comme un caractère.
  • Le seuil inter-polices est fixé par le quartile supérieur des polices de page, de sorte que l'ajout de polices à l'étude ne peut pas le déplacer.
  • La vérification en contexte (ci-dessous).

Les chiffres de mars 2026 (249 976 paires de caractères uniques et 2 524 275 paires de bigrammes sur 245 polices) provenaient de mesures qui ignoraient la taille et la ligne de base. Ils sont remplacés ; les fichiers de ces exécutions restent dans data/output/ pour référence.

Comment ça marche

Mesurer les glyphes

RaySpace projette des rayons parallèles à travers le contour de chaque glyphe selon 36 angles, 50 rayons chacun, et enregistre cinq choses par rayon : combien de fois il croise le contour, où, à quel angle, quelle distance il parcourt à travers l'encre à chaque fois (son ping, la largeur du trait le long du rayon), et l'écart le plus large entre les traits. Chaque glyphe est mesuré deux fois : dans sa propre boîte, pour la forme, et dans un cadre fixe sur la ligne de base, de sorte que la taille et la position comptent. Deux caractères sont identiques dans une police lorsque la distance de forme est inférieure à 0,5 et la distance ancrée sur la ligne de base inférieure à 0,2. La comparaison s'exécute en Rust (native/cv-pairs), sur tous les cœurs.

Télécharger l’outil