
 js-lee-ai/refusal-relocates
Sécurité des LLM : analysez comment le fine-tuning modifie le comportement de refus et évaluez les défenses par gel de couches et à rang réduit.





Page du projet · Démarrage rapide · Utilisation · CLI · Résultats · Reproduire · FAQ · Citation
Quelques dizaines d'exemples nuisibles suffisent à supprimer le refus d'un modèle aligné face à des requêtes nuisibles. Des travaux antérieurs localisent la sécurité dans des couches et des directions spécifiques, ce qui suggère de protéger l'endroit identifié. Ce dépôt met cette prémisse à l'épreuve comme le ferait un attaquant adaptatif. Il identifie où le refus peut être récupéré, gèle cette région et attaque à nouveau, puis il répare la mise à jour des poids et laisse ensuite l'attaquant la propager.
L'étude repose sur trois mesures.
Ce dépôt regroupe la mesure et les deux défenses sous forme d'une petite bibliothèque, ainsi que les enregistrements d'exécution et les scripts qui reconstruisent les tableaux de l'article.
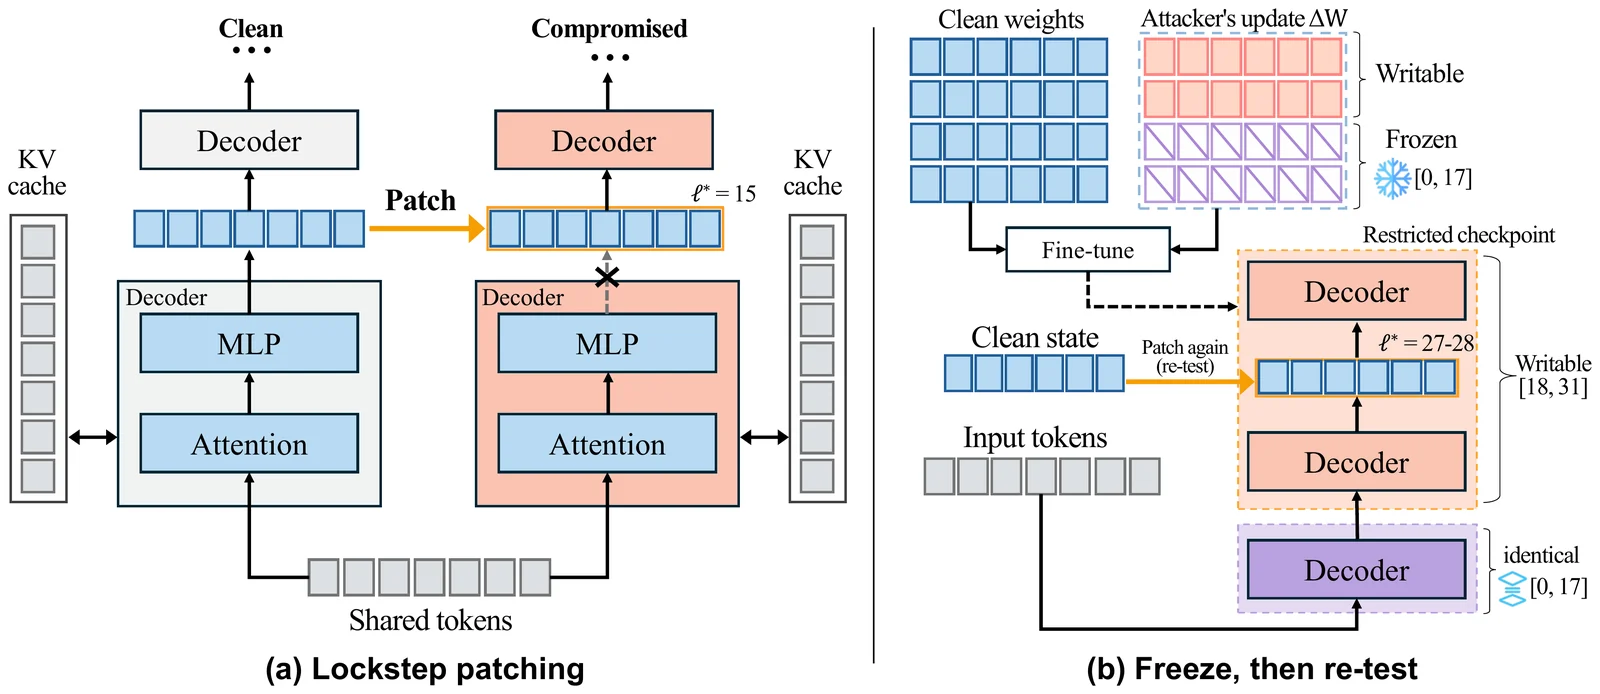
(a) Le patchage d'activation en verrouillage écrase la sortie de couche du modèle compromis par l'état propre au prefill et à chaque étape de décodage. (b) Dans l'attaque appariée sur Llama, geler les couches 0–17 déplace la transition du demi-plafond de 15 à 27–28.
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git"
import numpy as np
import refusal

rng = np.random.default_rng(0)
A = rng.standard_normal((16, 512)) / 512 ** 0.5    # LoRA factors of one module, rank 16
B = rng.standard_normal((512, 16)) / 16 ** 0.5
for name, decay in [("ordinary", 0.5), ("spread", 1.0)]:
    b = B * decay ** np.arange(16)                  # energy in a few directions, or spread flat
    before, after = refusal.update_stats(A, b), refusal.update_stats(*refusal.remove_top_k(A, b, k=2))
    print(f"{name:8s}  PR/r {before['pr_over_r']:.2f}  top-2 energy {before['top2_energy_fraction']:.2f}"
          f"  norm left after top-2 removal {after['unscaled_norm'] / before['unscaled_norm']:.2f}")
# ordinary  PR/r 0.10  top-2 energy 0.94  norm left after top-2 removal 0.24
# spread    PR/r 0.94  top-2 energy 0.18  norm left after top-2 removal 0.90
Un fine-tuning ordinaire concentre l'essentiel de sa mise à jour dans quelques directions singulières, de sorte que la suppression des deux premières directions en retire la majeure partie. Une mise à jour étalée présente un spectre plat, si bien que la même suppression en laisse l'essentiel en place. PR/r, le rapport de participation sur le rang LoRA, est aussi le score du détecteur spectral de l'article.
Ceci s'exécute sur un CPU en environ une seconde et ne télécharge rien. Le même code se trouve dans examples/quickstart.py, et la CI l'exécute à chaque push.
Pour entraîner, patcher et évaluer de vrais checkpoints, installez l'extra models.
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git"
| installation | ajoute | suffisant pour |
|---|---|---|
pip install "git+https://github.com/js-lee-AI/refusal-relocates.git" | numpy | le cœur spectral, la suppression top-k, le détecteur, le scoreur de refus, la commande refusal |
pip install "refusal-relocates[models] @ git+https://github.com/js-lee-AI/refusal-relocates.git" | torch, transformers, peft, accelerate, safetensors, scikit-learn, datasets | l'entraînement, le patchage lockstep, les sondes et l'évaluation sur un modèle |
git clone puis pip install -e ".[models,test]" | pytest | experiments/, records/ et tests/ |
Testé avec Python 3.11.5, PyTorch 2.10.0, Transformers 4.57.3 et PEFT 0.18.0. Les modèles se chargent en bfloat16 sur un périphérique CUDA.
import refusal

data = refusal.load_data("data/prompt_sets.json")        # built by `refusal prepare`, see below
prompts = data["advbench"][:40]
clean, tokenizer = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct")
attacked, _ = refusal.load_model("meta-llama/Llama-3.1-8B-Instruct", adapter="runs/attack/adapter")

for layer in [6, 9, 12, 15, 18]:
    responses = refusal.lockstep_generate(clean, attacked, tokenizer, prompts, layer=layer)
    print(layer, sum(refusal.is_refusal(r) for r in responses) / len(prompts))
Les deux modèles lisent les mêmes tokens, et à la couche choisie, la sortie du modèle compromis est remplacée par celle du modèle propre. refusal patch exécute la mesure complète avec son plancher, son plafond et deux contrôles, évalue le refus cohérent avec le filtre de perplexité et Llama-Guard, et rapporte la profondeur de transition.
import refusal







