 jaidedai/easyocr
OCR prêt à l'emploi avec plus de 80 langues prises en charge et toutes les écritures courantes, notamment le latin, le chinois, l'arabe, le dévanagari, le cyrillique, etc.


OCR prêt à l'emploi avec plus de 80 langues prises en charge et tous les systèmes d'écriture populaires, notamment : latin, chinois, arabe, devanagari, cyrillique, etc.
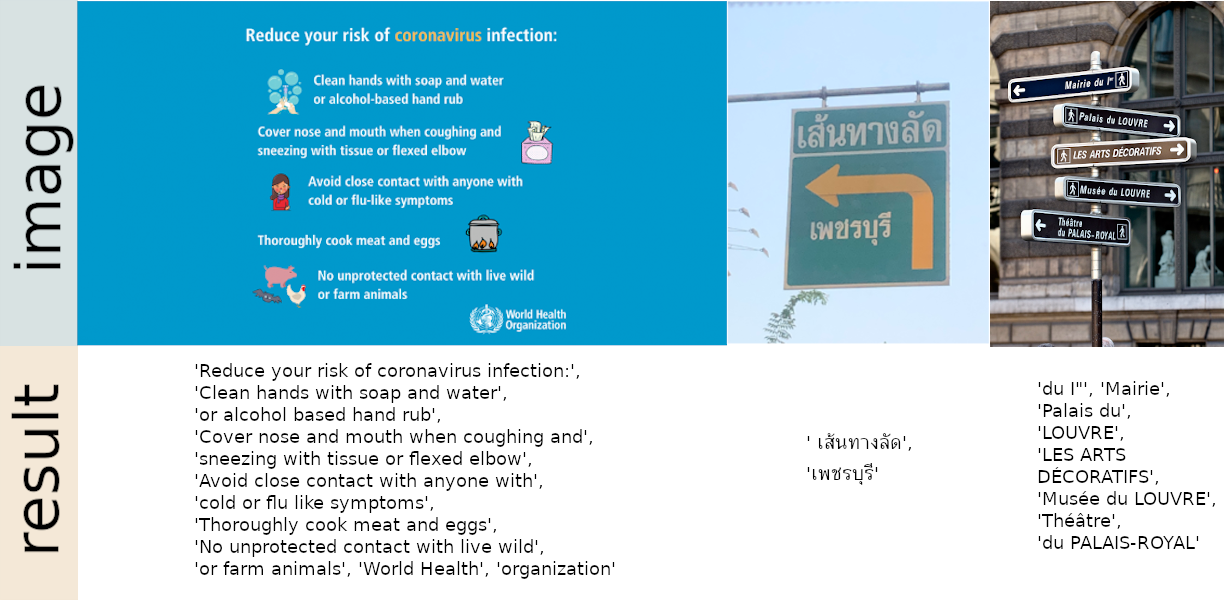
Essayez la démo sur notre site web
Intégré à Huggingface Spaces 🤗 via Gradio. Essayez la démo web :
24 septembre 2024 - Version 1.7.2
Installez avec pip
Pour la dernière version stable :
pip install easyocr
Pour la dernière version de développement :
pip install git+https://github.com/JaidedAI/EasyOCR.git
Remarque 1 : Pour Windows, veuillez d'abord installer torch et torchvision en suivant les instructions officielles ici https://pytorch.org. Sur le site web de pytorch, assurez-vous de sélectionner la bonne version de CUDA dont vous disposez. Si vous souhaitez exécuter uniquement en mode CPU, sélectionnez CUDA = None.
Remarque 2 : Nous fournissons également un Dockerfile ici.
Remarque 3 : Le détecteur optionnel DBNet (detect_network='dbnet18') compile ses opérations C++/CUDA lors de la première utilisation, ce qui nécessite l'outil de compilation Ninja. Pour l'installer avec EasyOCR, utilisez pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
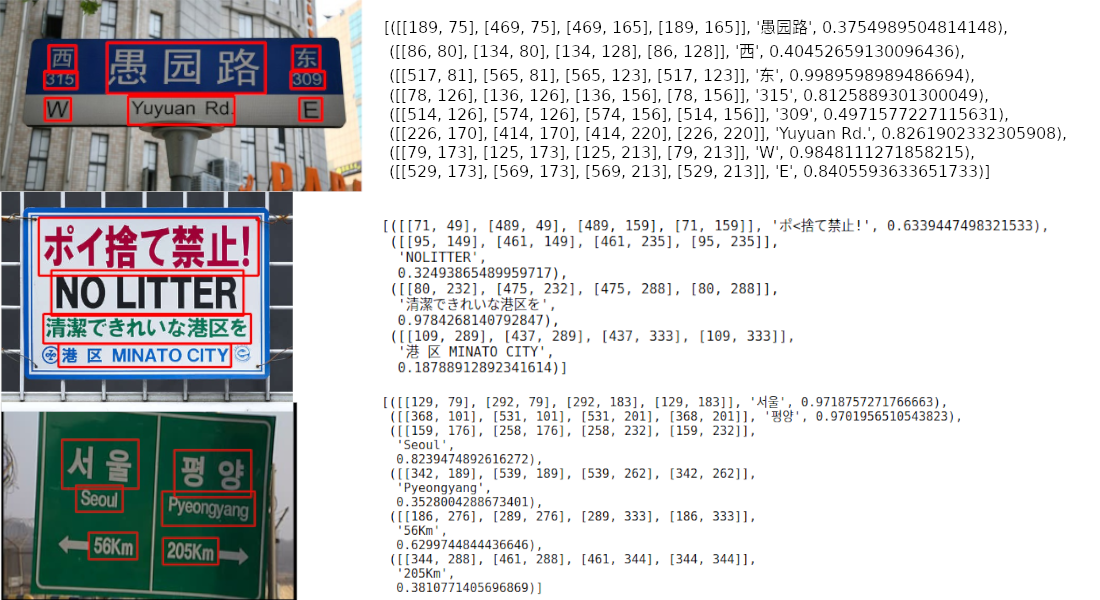
La sortie sera au format liste, chaque élément représentant respectivement une boîte englobante, le texte détecté et le niveau de confiance.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
Remarque 1 : ['ch_sim','en'] est la liste des langues que vous souhaitez lire. Vous pouvez passer plusieurs langues à la fois, mais toutes les langues ne peuvent pas être utilisées ensemble. L'anglais est compatible avec toutes les langues et les langues qui partagent des caractères communs sont généralement compatibles entre elles.
Remarque 2 : Au lieu du chemin de fichier chinese.jpg, vous pouvez également passer un objet image OpenCV (tableau numpy) ou un fichier image sous forme d'octets. Une URL vers une image brute est également acceptable.
Remarque 3 : La ligne reader = easyocr.Reader(['ch_sim','en']) sert à charger un modèle en mémoire. Cela prend un certain temps, mais il ne faut l'exécuter qu'une seule fois.
Vous pouvez également définir detail=0 pour une sortie plus simple.
reader.readtext('chinese.jpg', detail = 0)
Résultat :
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
Les poids du modèle pour la langue choisie seront automatiquement téléchargés, ou vous pouvez les télécharger manuellement depuis le model hub et les placer dans le dossier '~/.EasyOCR/model'
Si vous ne disposez pas d'un GPU, ou si votre GPU a peu de mémoire, vous pouvez exécuter le modèle en mode CPU uniquement en ajoutant gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
Pour plus d'informations, consultez le tutoriel et la documentation de l'API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
Pour le modèle de reconnaissance, Lire ici.
Pour le modèle de détection (CRAFT), Lire ici.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
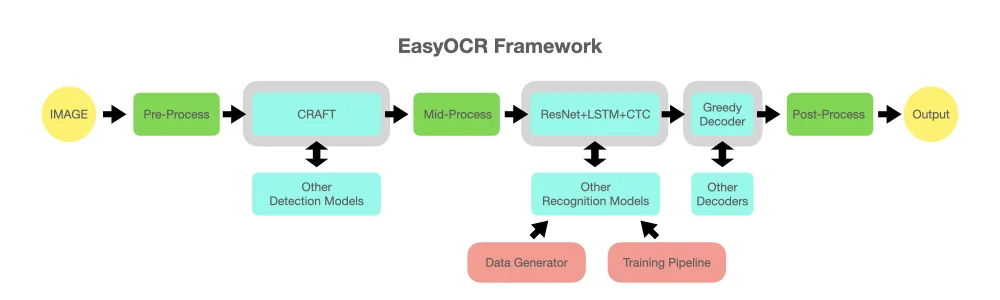
L'idée est de pouvoir brancher n'importe quel modèle de pointe dans EasyOCR. Beaucoup de génies essaient de créer de meilleurs modèles de détection/reconnaissance, mais nous n'essayons pas d'être des génies ici. Nous voulons simplement rendre leurs travaux rapidement accessibles au public... gratuitement. (enfin, nous pensons que la plupart des génies veulent que leur travail ait un impact positif aussi vite/grand que possible) Le pipeline devrait ressembler au diagramme ci-dessous. Les emplacements gris sont des espaces réservés pour des modules bleu clair modifiables.
Ce projet est basé sur des recherches et du code issus de plusieurs articles et dépôts open source.
Toute l'exécution de l'apprentissage profond est basée sur Pytorch. ❤️
L'exécution de la détection utilise l'algorithme CRAFT de ce dépôt officiel et de leur article (Merci @YoungminBaek de @clovaai). Nous utilisons également leur modèle pré-entraîné. Le script d'entraînement est fourni par @gmuffiness.

